如果你的 API 費用按 token 計算,Gemini 4 Neon 何時採用,關鍵不只在模型本身,還在日曆:接下來 11 天 Carbon 比較便宜,但從 12 月 1 日起,Neon 每 token 便宜 25%。Google 於 2026 年 11 月 18 日推出Gemini 4 Neon,每 100 萬個輸入 token 收費 $3、輸出 token 收費 $15,支援 100 萬 token context window,且沒有免費方案。
11 月 30 日的價格翻轉,會直接改變選擇
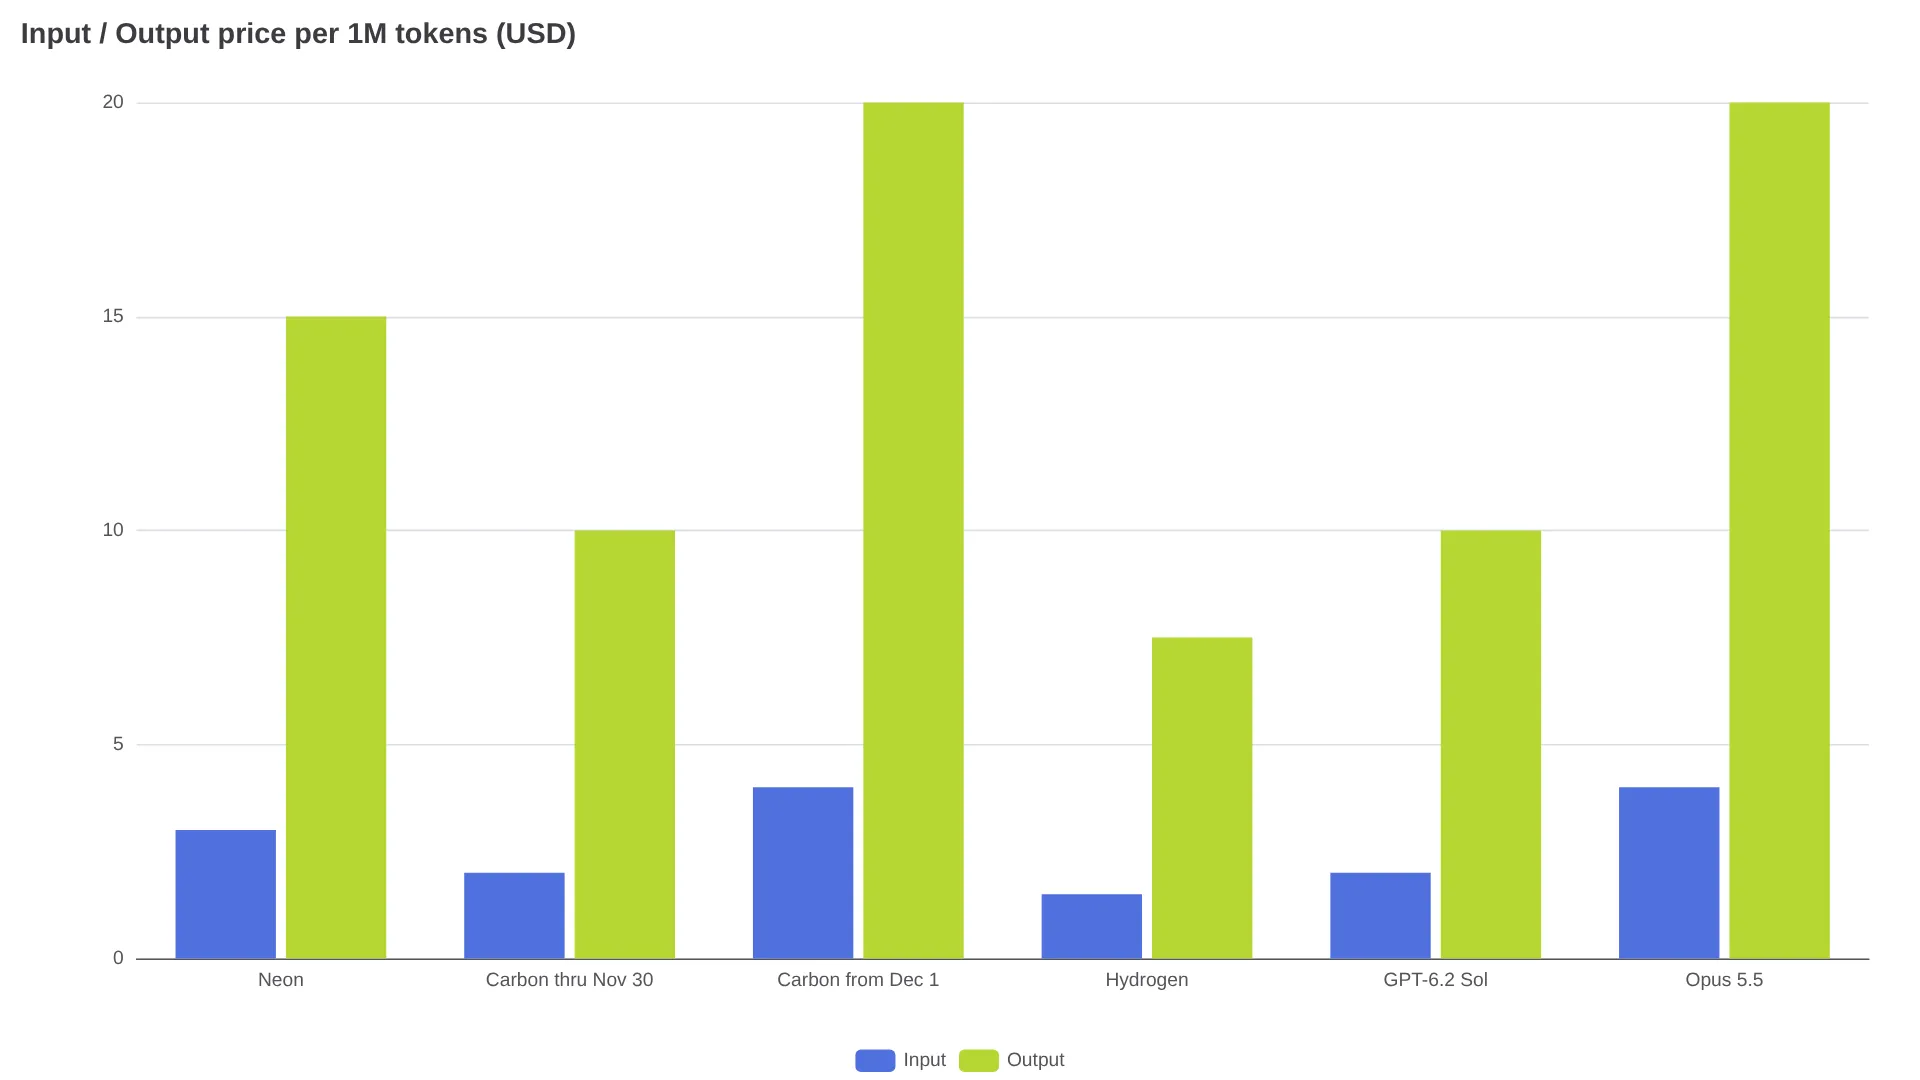
Gemini 4 Neon 的 API 定價,得放進時間表裡看。2026 年 11 月 30 日以前,Gemini 4 Carbon 處於上市促銷期,每 100 萬 token 的輸入/輸出價格是 $2/$10;12 月 1 日起,Carbon 和 Argon 都會調整為 $4/$20。相較之下,Neon 的 $3/$15 會便宜整整 25%(價格比較)。也就是說,在 11 月 30 日前,Neon 反而比促銷價 Carbon 貴 50%。
Google 另一種比較方式,是看完成任務的成本:官方宣稱,在高思考等級下,Neon 的單任務成本比 Carbon 低 32%;在 xhigh 下,則至少比未具名的競爭對手省 36%(上市分析)。不過實際預算仍應以公開的 $3/$15 token 價格為準,因為這些單任務數字是 Google 提供的說法,沒有交代明確的比較基準。
Gemini 4 系列裡的 Neon,定位在哪裡?
Gemini 4 Neon 是系列中的中間選項:推理深度高於 Hydrogen,品質接近 Carbon,但執行速度更快,這是OpenRouter 的模型定位。Carbon 原本是前沿程式設計的預設選擇,Argon 則是主打數學與科學工作的旗艦推理模型;Hydrogen 是每 100 萬 token $1.50/$7.50、面向大量工作負載的主力型號(價格索引)。Neon 提供 low、medium、high、xhigh 四種推理等級,預設為 high(供應商規格)。
根據Google 公告與上市整理,Neon 上市時可用於以下平台:
| 平台 | Neon 存取方式 |
|---|---|
| Gemini API | 付費開發者可用,模型 ID 為 gemini-4-neon(型號清單) |
| AI Studio/Gemini app/Antigravity | 付費方案,以及 Google AI Pro 和 Ultra |
不過,Antigravity 裡的 Neon 標示要小心解讀。Antigravity 討論串中的使用者回報,在部分工作階段裡,編排器入口實際上仍可能解析到 Carbon 的 system prompt;其中一則回覆直接總結為「its just the orchestrator. not neon」(討論串)。在 Google 公開 build ID 對應關係前,計算費用時應以 API 模型 ID 為準,不要只看 UI 標籤。
$3/$15 的價格,實際買到什麼?
標準價格為每 100 萬 token:輸入 $3.00、輸出 $15.00、快取輸入 $0.15(官方公告)。完整 1,048,576 token context 都採用同一價格,沒有分層計費(價格檢查)。第三方索引列出的 Batch 價格為 $1.50/$7.50、Flex 為 $1.50/$7.50、Priority 為 $5.40/$27.00(規格與供應商表格),但 Neon 上市時,Google 的一般定價頁面尚未公布 Batch、Flex、Priority。除非該頁面更新,否則先把 Neon 視為只有 Standard 方案。
計算公式很簡單:成本 = 新鮮輸入 token ÷ 100 萬 × $3 + 快取輸入 token ÷ 100 萬 × $0.15 + 包含思考 token 的輸出 token ÷ 100 萬 × $15。
以下三條計費規則,會讓實際帳單和表面價格產生明顯差異(上市分析與價格參考):
- 思考 token 會算在輸出裡。由於輸出每 100 萬 token 收 $15,通常是帳單的主要來源。
- 快取只會以隱式方式運作,prompt 至少要有 4,096 token;符合條件的快取輸入可享 95% 折扣。不支援明確的
cachedContents快取,也沒有快取寫入費。 - 同步輸出上限為 65,536 token(規格)。需要更長輸出時,必須改用背景執行。
少於 4,096 token 的短 prompt 完全吃不到快取優惠(價格參考)。例如一個輸入只有 1,200 token 的客服機器人,根本無法使用 $0.15 的快取輸入價格。
兩種實際工作負載,帳單會是多少?
以下以固定 token 數量估算,不包含重試,也沒有把推理長度的變動算進去。重點在於輸出占比。所有模型都使用相同的快取比例,並套用上市價格表中的各自牌價。
程式設計工作階段:50 次呼叫,每次 80,000 個輸入 token,其中 90% 來自快取;每次輸出 2,500 token,包含思考 token。總計為 400,000 個新鮮輸入 token、360 萬個快取 token,以及 125,000 個輸出 token。
| 模型 | 工作階段成本 |
|---|---|
| Gemini 4 Neon $3/$15 | $3.62(新鮮輸入 $1.20 + 快取 $0.54 + 輸出 $1.88 = $3.615) |
| Carbon,11 月 30 日前 $2/$10 | $2.41 |
| Carbon,12 月 1 日起 $4/$20 | $4.82 |
| Hydrogen $1.50/$7.50 | $1.81 |
| GPT-6.2 Sol $2/$10 | $2.41 |
大規模客服:每天 10,000 段對話、連續 30 天;每段對話包含 6,000 個輸入 token,其中 75% 符合快取條件,並產生 500 個輸出 token。總計為 4.5 億個新鮮輸入 token、13.5 億個快取 token,以及 1.5 億個輸出 token。
| 模型 | 每月成本 |
|---|---|
| Gemini 4 Neon $3/$15 | $3,802.50(其中 $2,250 為輸出成本) |
| Carbon,11 月 30 日前 $2/$10 | $2,535.00 |
| Carbon,12 月 1 日起 $4/$20 | $5,070.00 |
| Hydrogen $1.50/$7.50 | $1,901.25 |
| GPT-6.2 Sol $2/$10 | $2,535.00 |
Neon 的 token 價格是 Hydrogen 的 2 倍,也比 $2/$10 的 Sol 貴 50%。因此,Neon 必須用更少 token 完成任務,或減少重試次數,才有機會在單任務成本上勝出。文中引用的基準數據——Intelligence Index 61、排名第 3,以及 Coding Agent Index 排名第 1——都是供應商提供的結果,不能直接證明 Neon 在真實工作負載中會有更低的任務成本(基準測試整理)。
Token 價格,和你的使用配額是兩回事
App 裡顯示的使用百分比,不能直接換算成 API 美元成本。一位 Pro 使用者表示,在長 context 的 Neon 工作階段中,每則訊息只消耗 1–2%:
Also tried switching existing conversations with long context to Neon and seeing 1-2% usage per message, looks like this one might actually be usable on the Pro plan! — u/biblecrumble(討論串)
App 配額會受到五小時使用區間、思考等級和工具呼叫影響;API 計費則會計入所有處理過的 token,包括思考 token,另外每次 Search grounding 查詢也會獨立計費(上市分析)。API 工作負載請依照上面表格用美元估算;訂閱方案還能用多少,則應以自己在 high 與 xhigh 下的實測結果判斷。
切換只要改一行,但還有三個地方要修
如果原本使用 Carbon、Argon 或 Hydrogen,只要把模型 ID 改成 gemini-4-neon 就能遷移(上市分析)。不過,以下三個細節仍可能讓請求失敗(上市分析):
- 明確設定
thinking_level。Neon 預設為 high。 - 移除
cached_content欄位。Neon 不支援明確快取。 - 移除
temperature、top_p、top_k。超出範圍的值會回傳 HTTP 400,其他值則會被忽略。
另外,請將 max_output_tokens 調高至接近 65,536;如果輸出很長,則改用背景執行。
現在就切換,還是先把 Carbon 用到最後?
| 情境 | 建議 |
|---|---|
| 11 月 30 日前要上線,且需要最強推理能力 | 先留在 $2/$10 的 Carbon,同時平行測試 Neon |
| 12 月要部署正式環境 agent,且需要長 context | $3/$15 的 Neon 值得列入首選,但切換前先驗證任務成功率與重試次數 |
| 大量、簡單的聊天工作 | 繼續使用 $1.50/$7.50 的 Hydrogen;在這組模型裡,只有它提供免費方案(價格索引) |
| 目前牌價最低的前沿模型 | 如果技術堆疊能使用 OpenAI,選 $2/$10 的 GPT-6.2 Sol |
| 需要 Batch 的正式價格依據 | 先等,Neon Batch 尚未公布 |
常見問題
Gemini 4 Neon API 要多少錢?
每 100 萬 token 的輸入價格為 $3、輸出價格為 $15、快取輸入價格為 $0.15,依據Google公布的定價。
Context 和輸出上限是多少?
輸入上限為 1,048,576 token;同步輸出上限為 65,536 token。
有免費方案嗎?
沒有。Neon 僅提供付費使用;Hydrogen 仍保留免費方案。
Batch、Flex 或 Priority 可以使用嗎?
Google 在上市時尚未公布這些方案;第三方清單列出 Batch/Flex 為 $1.50/$7.50,Priority 為 $5.40/$27.00,實際編列預算前請先確認。
快取怎麼運作?
僅支援隱式快取,最低需要 4,096 token;符合條件的快取輸入可享 95% 折扣。
模型 ID 是什麼?
gemini-4-neon。
Neon、Hydrogen、Carbon 要選哪個?
大量且重視成本的工作選 Hydrogen;11 月 30 日前要最低的前沿模型 token 價格,選 Carbon;12 月 1 日起,若要進階推理,選 Neon,價格比 Carbon 的 $4/$20 低 25%。
一次 2,000 個輸入 token 加 500 個輸出 token,要多少錢?
按牌價計算為 $0.0135,尚未計入快取。思考 token 會算在輸出裡。