代理程式整合數百項工具時,真正吃掉 context 的往往不是工具名稱,而是每一份完整的參數 schema。Gemini API 的 Tool Retrieval將 schema 延後到真正要用工具時才載入,讓代理程式保有全部工具名稱,卻不必一開始就帶著所有參數定義。不過這不是單純的省 Token 開關:每次搜尋都會多跑一次模型推論;若幾乎每輪都要搜尋,總成本可能不減反增。
依 Google 公告,這項功能於 2026 年 11 月 19 日以預覽版形式推出,目前僅限 Interactions API。它新增 tool_search 工具,以及 defer_loading: true 旗標。延後載入的工具仍會提供名稱與描述,但參數 JSON 不會進入 context。功能本身沒有額外收費,仍依標準輸入、快取輸入與輸出費率計費。
200 項工具還沒呼叫,為何就可能先花掉 164,000 Token?
Prompt 成本的關鍵不只在工具數量,而是 schema 的大小;工具目錄一旦膨脹,schema 很容易反過來主宰整個 prompt。
一份整理 Google 文件的獨立技術分析提供了直觀對比:在一個擁有 200 項工具、但每次請求只會用到少數工具的函式庫中,不延後載入約需 164,000 個輸入 Token;啟用 Tool Retrieval 後約為 23,650 個。這是該分析採用的整數化示意,並非基準測試;重點在於,不會用到的 schema 不再持續占用成本。
另一個問題是準確性。context 裡若同時塞進數十份相似的 schema,模型就多了更多選錯工具的可能。Google 將 Tool Retrieval 定位為同時降低 Token 負載、改善工具選擇準確度的功能。不過目前沒有公布準確率數字,因此後半段更適合視為假設,並用自己的任務驗證。
Gemini Tool Retrieval 怎麼運作:tool_search 與 defer_loading
設定時只需加上兩段簡化的宣告:一個值為 {"type": "tool_search"} 的 tool_search 項目,以及每個延後載入工具上的 "defer_loading": true;完整請求格式可見文件分析。模型依然看得到每個延後載入工具的名稱與描述。根據這篇defer_loading 說明,若設定 short_description,模型看到的就是它;否則會看到完整描述的第一句。
伺服器端流程會在同一個請求中完成:
- 模型輸出
tool_search_call,例如要求取得issue_refund。 - API 回傳含完整 schema 的
tool_search_result。 - 模型輸出真正的
function_call(Google 的退款範例使用模型gemini-4-hydrogen,並帶入order_id: "A-1042"與amount: 40)。 - 你的程式執行工具後,回傳
function_result。
請在 interaction.steps 記錄所有過程。若載入了錯誤工具,優先查看 trace,通常能先發現名稱或描述寫得過於模糊。
伺服器端與用戶端:同一次請求,或多一次往返
| 模式 | 由誰搜尋 | 需要建立的索引 | 額外往返次數 | 適合情境 |
|---|---|---|---|---|
| 伺服器端(預設) | Gemini | 無 — 「無需建立或託管索引。」 | 無,在同一次請求內完成 | 大型且大致固定的工具函式庫;完整 MCP servers |
用戶端("execution": "client") | 你的應用程式 | 自行維護的 registry 或 embedding index | 每次搜尋一次 | 逐使用者權限、私有 registry、對話途中新增的工具 |
依文件分析,伺服器端擷取不需要託管索引,並會在同一份回應內完成;若在 mcp_server 工具上設定 defer_loading: true,該 server 提供的所有工具都會延後載入。
用戶端模式使用帶有 "execution": "client" 的 tool_search(範例名稱是 search_tools,並要求一個必填的 query 字串)。你的應用程式透過 function_result 回傳匹配結果,接著呼叫帶有 previous_interaction_id 的 client.interactions.create。依同一份分析,每個請求只能有一次 tool_search,兩種模式也不能混用。
若授權依使用者而定,或整合項目會在對話途中出現,應選用戶端模式:根據引用分析,伺服器端搜尋共用目錄本身不會自動套用逐使用者的權限篩選。同一份分析也指出,用戶端模式支援在未預先宣告全部工具的情況下,於對話中途加入工具。
Gemini Tool Retrieval 的計費:先付 26 Token,之後再跑一次完整推論
Google 在其公告中明確表示:「Tool Retrieval has no separate charge.」Tool Retrieval 沒有獨立費用;但根據這份Token 經濟分析,仍有四類用量需要計算:
tool_search會為每個請求加入一小段固定的輸入 Token。- 該分析估計,每個延後載入工具的名稱與描述約占 26 Token。
- 每次伺服器端搜尋都會針對當前 context 額外執行一次模型推論;依該分析,會以約等於 prompt 輸入量扣除快取命中後的用量,透過
total_tool_use_tokens計費。 - 每個已載入的 schema,之後都會在整段對話中持續以輸入計費,且無法卸載。
| 工作負載(引用分析的示意估算) | 未使用擷取 | 使用擷取 | 結論 |
|---|---|---|---|
| 200 項工具,每個任務只用少數工具 | ~164,000 Token | ~23,650 Token | 節省 |
| 10 項工具、30k context,幾乎每輪都搜尋 | ~68,000 Token | ~92,830 Token | 成本更高 |
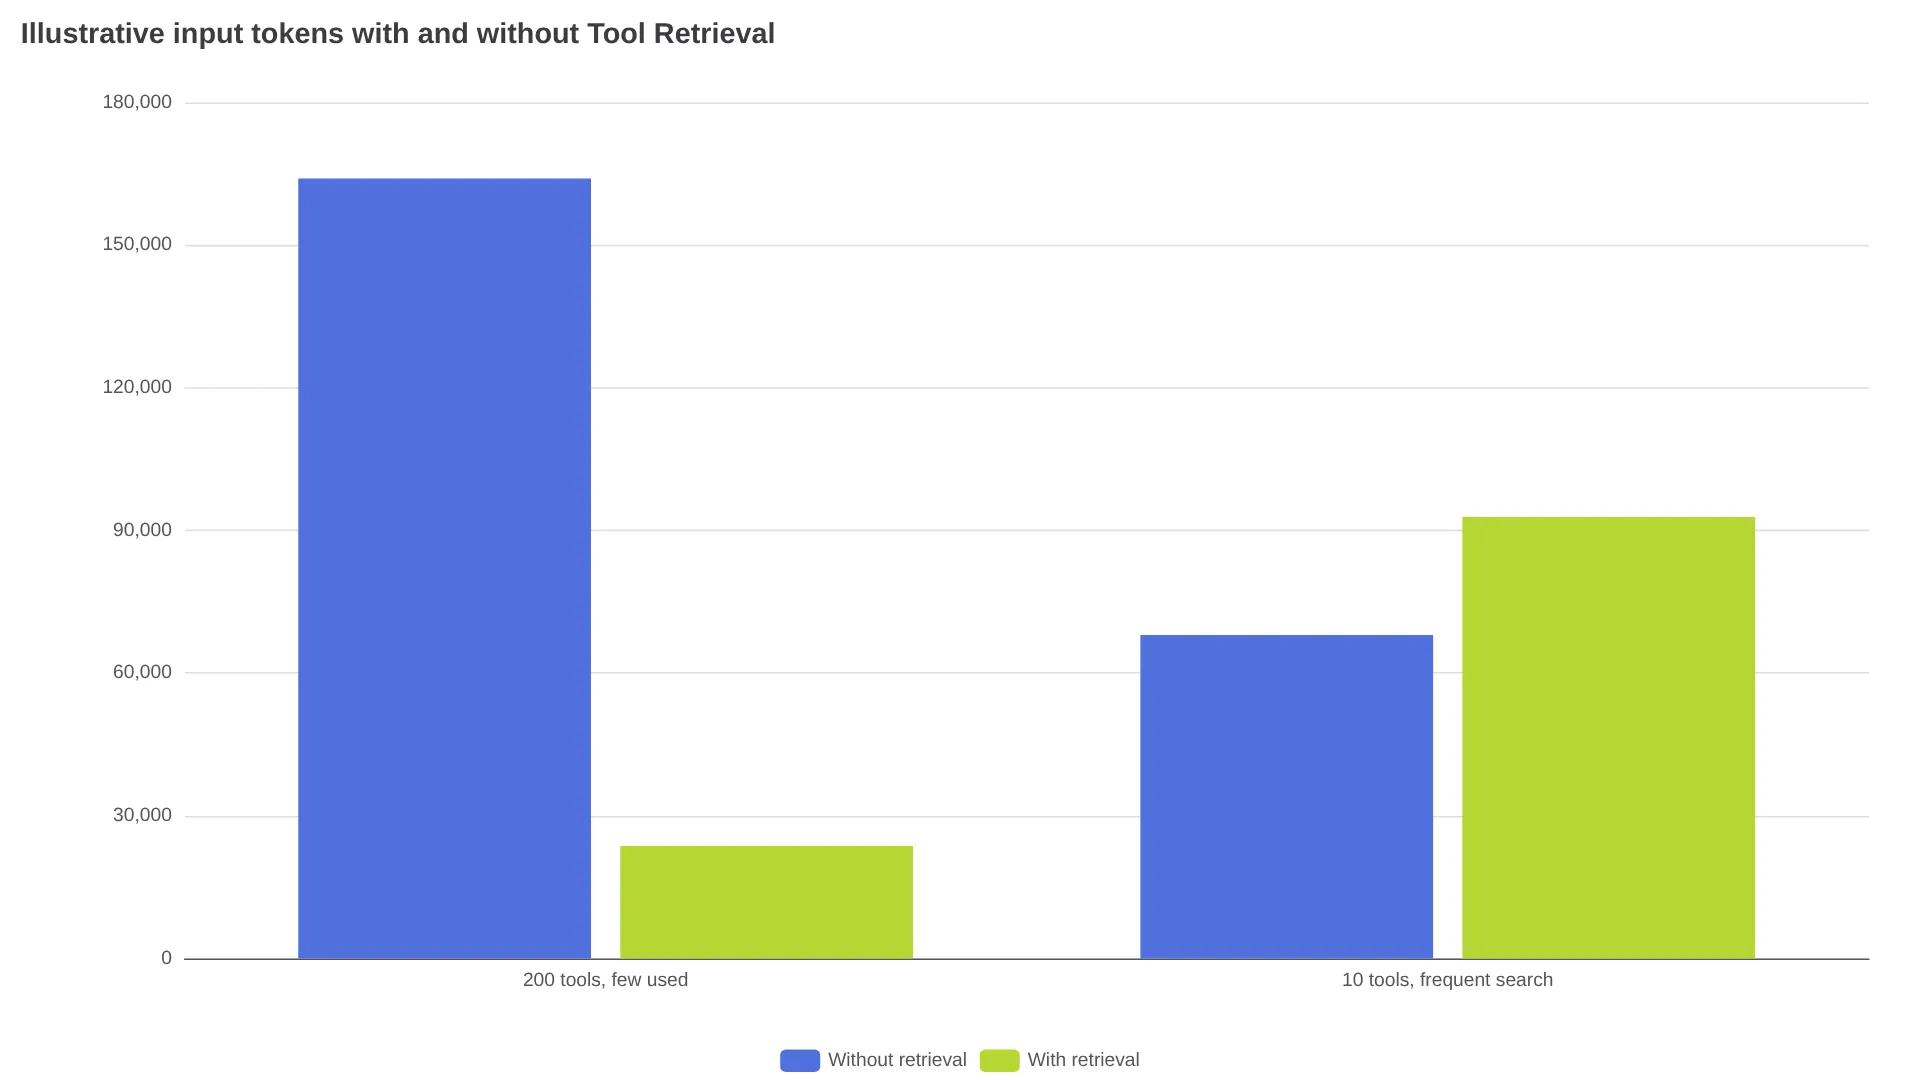
Google 在同一份公告中的建議很直接:「Measure it against your own traffic.」請依自己的實際流量衡量。
「在伺服器端模式中……每次伺服器端搜尋都會針對目前的 context 額外執行一次模型推論……因此,大型工具函式庫且每個任務只用少數工具時可能受益;工具少、對話長又頻繁搜尋時,成本反而可能更高。」 — @tekroch
延後載入可能讓快取前綴更穩定,但也可能使 prompt 低於快取大小門檻;根據引用分析,除了輸入 Token,也應一併追蹤快取命中率。
什麼時候該延後載入,什麼時候該維持常駐?
工具函式庫不大時,先測量靜態載入的表現;搜尋頻率與 schema 大小,比任何單一工具數量門檻都重要。若是大型目錄、每個任務僅使用 1–3 項工具,可在伺服器端延後載入長尾工具,並讓高頻工具維持非延後載入狀態,也就是大多數請求都會用到的工具。若工具依使用者而異,或會在對話中途出現,請採用用戶端模式,並將每次查找所需的一次往返納入預算。
引用的實作筆記列出三個需要預先處理的失敗情境:
- 不要延後載入系統指令或其他工具輸出中直接點名的工具;模型可能未搜尋就直接呼叫它,導致下一輪失敗。
- 延後載入的函式在請求中仍必須帶上完整的
parameters;只有名稱與描述可能回傳空白且無法呼叫的 schema。 - 無狀態應用程式每一輪都必須原封不動回傳
tool_search_call、tool_search_result、signatures,以及完整的tools陣列。
描述品質決定擷取結果:模型在看見 schema 前,是根據名稱與描述挑選工具。像「依日期範圍搜尋客戶發票」就容易被找到;「發票小幫手」則容易與其他工具混淆。根據這篇安全性分析,延後載入不是安全邊界:延後載入的 MCP 名稱與描述仍會作為 prompt 輸入而可見,已載入工具則會以你授與的權限執行。
預覽版目前還不具備什麼?
這仍是預覽版,僅支援 Interactions API 的 v1beta 介面。不支援 generateContent;依文件分析,在不支援的模型上使用 defer_loading 會回傳 HTTP 400。
實際支援的模型範圍也比標題宣傳得更窄:公告表示支援 Gemini 3.6 以上、包含所有 Gemini 4 模型;但引用分析指出,目前線上文件列出的模型為 gemini-4-hydrogen、gemini-4-argon、gemini-3.8-flash 與 gemini-3.6-flash。不要假設同系列模型一定可用,請先在文件中確認你的目標模型。目前尚未公布 GA 日期。依發布報導所述,Anthropic 已在 2025 年 11 月以 beta 推出相同的 defer_loading 概念;Google 的差異在於伺服器端 MCP 延後載入與用戶端模式。
| 你的工具函式庫型態 | 建議模式 | 第一步 |
|---|---|---|
| 規模小且穩定 | 靜態載入 | 加入複雜度前,先測量 schema Token |
| 50–200 項工具,每個任務僅用少數工具 | 伺服器端延後載入 | 延後載入長尾工具,保留熱門工具常駐 |
| 逐使用者工具或對話中途加入的工具 | 用戶端擷取 | 建立具權限感知能力的搜尋機制 |
| 每輪都會使用所有工具 | 靜態載入 | 搜尋額外成本很可能超過節省 |
先針對一小段長尾工具上線,再以相同任務比較啟用與未啟用延後載入時的輸入 Token、total_tool_use_tokens、延遲與任務成功率。
FAQ
Tool Retrieval 能搭配 generateContent 使用嗎?
不能。僅限 v1beta 的 Interactions API。
哪些模型支援?
公告稱 Gemini 3.6 以上、包含 Gemini 4 都支援;但引用分析表示,目前線上文件的範圍較窄,包含 gemini-4-hydrogen 與 gemini-3.6-flash 等模型。請依你的確切模型查閱文件。
它會讓帳單變高嗎?
會。引用分析中的 10 項工具示意工作負載,在幾乎每輪都搜尋時,Token 用量會從 ~68,000 增至 ~92,830。