 AIREITER
一個能讀取檔案、執行測試並反覆修正的 Coding Agent,處理一個已解決的問題通常會消耗 50,000 到 200,000 個 Token。以 GPT-5.6 Sol 每百萬輸出 Token 30 美元的價格計算,光是輸出就可能讓單一任務花掉 1.50 到 6 美元。DeepSeek V4 Pro 的輸出定價則是每百萬 Token 0.87 美元,成本大約只有 1/34;不過,它在多步驟工作的可靠度,還沒有像 Claude 或 GPT 那樣經過同等深度的獨立基準測試。以下將從公開 Coding Benchmark、已驗證的 API 價格、Context 限制與 Agent 工作流程適配度,逐一比較 6 款模型。
2026 年 Coding Agent 六強陣容
以下各模型的基準數據,均搭配官方或排行榜來源;API 價格則已於 2026 年 8 月完成確認。如果指定排名模型沒有公開分數,本文會引用最接近的可用版本,並明確標示為替代參考。
1. Claude Opus 5:品質上限
Claude Opus 5 延續 Claude 家族在官方 SWE-bench Verified 排行榜上的領先地位。前一代 Claude 4.5 Opus 在 mini-SWE-agent 測試框架下拿到 76.8%,可作為 Opus 5 預期級別的參考;但目前尚未公布 Opus 5 專屬的 SWE-bench Verified 分數。Opus 5 支援 1 百萬 Token Context,最大輸出為 128K Token,價格是每百萬輸入 Token 5 美元、輸出 Token 25 美元,也是本文主流選項中最昂貴的一款。若是多檔案重構,一次失敗所浪費的人力時間遠高於 Token 費用,Opus 5 值得優先考慮;但拿來處理大量例行修改,就不太划算。
2. GPT-5.6 Sol:終端機任務專家
GPT-5.6 Sol(模型 ID 為 gpt-5.6-sol)的價格是每百萬輸入 Token 5 美元、輸出 Token 30 美元,Context Window 為 1.05 百萬 Token。根據 xAI 公布的基準比較,GPT-5.6 Sol Max 在 Terminal-Bench v3.0 以 34.6% 領先(Grok 4.6 為 26%),並在 DeepSWE v1.1 拿到 73%。這兩項測試特別貼近以終端機為核心的 Agent 循環。代價是,Sol 的輸出價格高達每百萬 Token 30 美元,是本次陣容中最貴的模型。OpenAI 另外公布 Sol 的 SWE-bench Pro 分數為 64.6%,Terra(中階版本)則為 63.4%;如果想使用較便宜的 OpenAI 模型處理要求沒那麼高的任務,這組數據很有參考價值。
3. Grok 4.6:長時間 Agent 的高性價比選擇
Grok 4.6 於 2026 年 8 月 12 日發布,定位就是長時間執行的 Agent 工作流程。根據 xAI 的公告,它在 Artificial Analysis Intelligence Index 以 61 分與 GPT-5.6 Sol Max 並列;在 CursorBench v3.2(69.9% 對 67.2%)、FrontierCode v1.1(61.3% 對 60.6%)及 APEX-Agents(57.5% 對 56.7%)則超越對手。Grok 4.6 的價格是每百萬輸入 Token 2 美元、輸出 Token 6 美元,在基準表現接近 GPT-5.6 Sol Max 的同時,輸出成本約只有後者的五分之一。它的弱點在於純終端機執行能力:Terminal-Bench v3.0 只有 26%,明顯落後 Sol Max 的 34.6%。如果你的 Agent 主要在 IDE(Cursor、Grok Build)中工作,而不是以終端機為核心,Grok 4.6 是這份清單中品質與價格平衡最好的選項。「fast」版本則會把價格提高至 $4/$12,以換取更低延遲;Context Window 為 500K Token。
4. DeepSeek V4 Pro:低成本主力
DeepSeek V4 Pro 是目前能透過 API 使用的前沿級模型中最便宜的一款:每百萬輸入 Token 0.435 美元、輸出 Token 0.87 美元,使用快取輸入時更降至每百萬 0.003625 美元。它提供 1 百萬 Token Context Window,以及 384K Token 最大輸出,足以應付整個 Repository 等級的任務。不過,目前沒有公開的多步驟 Agent Benchmark,能在相同測試框架深度下比較 DeepSeek V4 Pro 與 Claude 或 GPT,因此若要用它處理複雜重構,正式採用前應先在自己的環境驗證長時間工作中的 Tool Call 可靠度。對預算有限的團隊,或作為模型路由架構中的第一道處理模型,它的經濟效益相當突出;至於最棘手的多檔案重構,可靠度若比 Token 成本更重要,仍應準備升級到其他模型。
5. Gemini 3.1 Pro:超大 Context 的程式碼閱讀器
Google 的 Gemini 3.1 Pro Preview,在提示低於 200K Token 時的價格為每百萬輸入 Token 2 美元、輸出 Token 12 美元;超過這個門檻後,價格會升至 $4/$18。它最突出的能力是 Context 容量:Gemini 的 2 百萬 Token Context Window 是本文列出的模型中最大的一個,適合一次載入整個程式碼庫、進行全 Repository 閱讀。作為 3.1 Pro 預期級別的替代參考,Gemini 3 Flash 在 Tembo 的2026 年 6 月快照中,SWE-bench Verified 分數達到 75.8%,僅次於 Claude 4.5 Opus。不過,Gemini 在長時間 Agent 循環中的 Tool Calling 一致性,還沒有像 Claude 或 GPT 一樣經過同等深度的 Benchmark;部署多步驟工作流程前,最好先放進自己的測試框架驗證。
6. Kimi K3:可自架的 Agent 選項
Moonshot AI 的 Kimi K3 在同一份 2026 年 6 月快照中,SWE-bench Verified 分數為 70.8%,低於開放權重模型中的 GLM-5(72.8%)與 MiniMax M2.5(75.8%)。它採用開放權重,對於程式碼不能離開內部網路的團隊,可以選擇自行部署。Moonshot 也提供 K3 的託管 API,但具體價格取決於部署設定。若本地 Agent 環境配備足夠的 GPU,K3 搭配 OpenCode 這類輕量級 Harness,便能在不產生按 Token 計費的 API 成本下,提供相當不錯的 Coding Agent 能力。
API 定價與每個完成任務的成本
只看每 Token 價格,頂多了解一半。真正該關心的是完成一個任務要花多少錢:也就是讓 Agent 循環實際解決一個 GitHub Issue,總共會消耗多少成本。
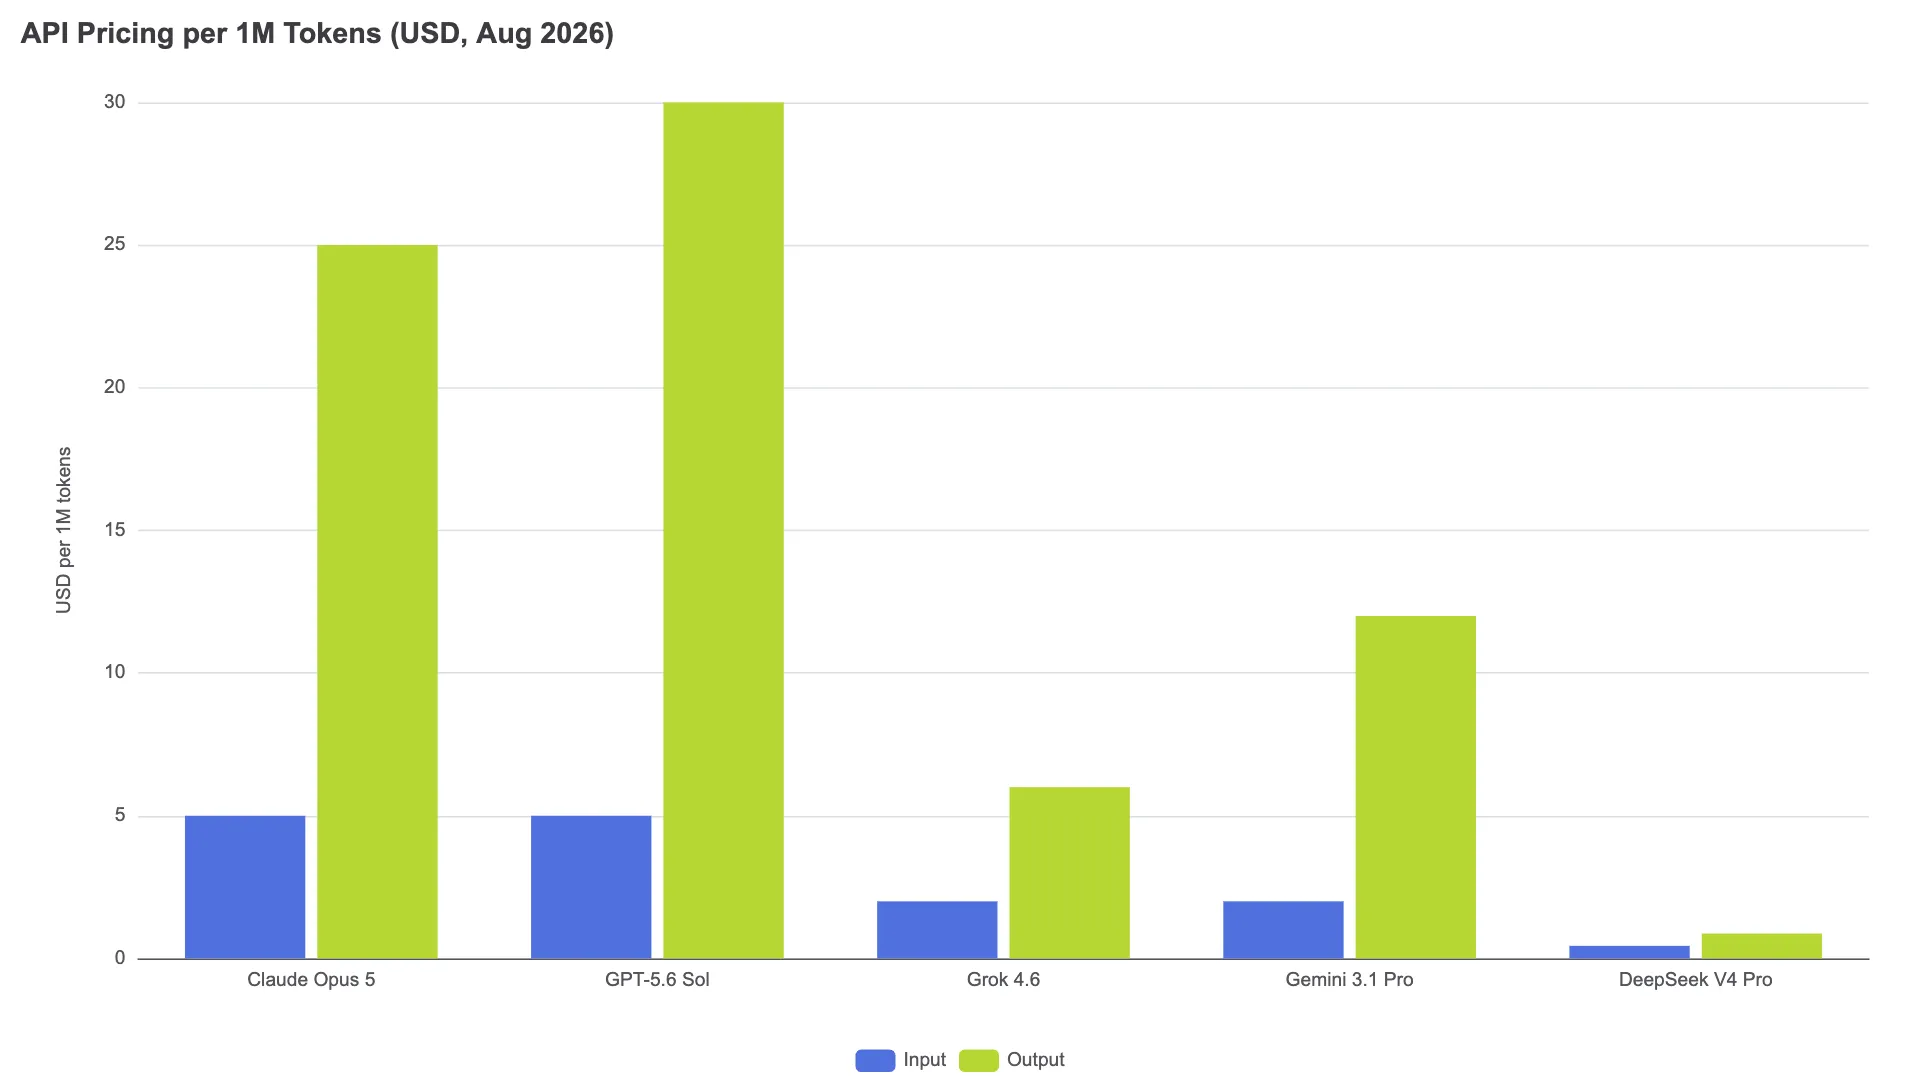
一個典型的 Agent 循環——讀取檔案、制定計畫、修改程式碼、執行測試、修正錯誤——每解決一個 Issue,大約會消耗 50K–200K Token,其中輸出約占總 Token 的 30–50%。這些數字是參考 Tembo 等來源對 Agent 循環的分析所得出的業界估算;實際用量仍會受 Repository 大小、測試套件長度與 Harness 效率影響。以下以總量 125K Token 的中間值計算(75K 輸入、50K 輸出),列出各模型完成一個 Issue 的成本:
| 模型 | 輸入成本 | 輸出成本 | 每個任務總成本 |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3 沒有列入這張表,因為成本完全取決於使用 Moonshot 的託管 API,還是用自有 GPU 自行部署;它沒有一個可直接比較的統一定價。Grok 4.6 每個任務 0.45 美元,正好落在甜蜜點:Artificial Analysis Intelligence Index 分數與 GPT-5.6 Sol Max 相同,但單一任務成本約只有 Sol 的四分之一。
以上估算不包含重試、快取 Token 折扣、Tool Call 額外開銷與基礎架構成本。如果某個模型需要更多重試,或每個任務都要人工修正,它在實際使用上的成本就會高於單看 Token 價格所得出的數字。這也是模型路由有機會勝過單押一款模型的原因:例行工作交給 DeepSeek 或 Grok,遇到困難的重構再升級到 Opus。
不同 Coding Agent 工作流程的最佳選擇
沒有任何一款模型能適合所有工作流程。以下是各種 Agent 任務最適合搭配的模型。
快速循環與例行修改。 高頻率、低風險的工作,例如解釋錯誤、加入小型函式、建立測試 Stub 或更新文件,可以使用 Gemini 3.5 Flash(每百萬 Token $1.50/$9)或 Claude Sonnet 5。
深度重構與架構調整。 如果任務涉及多檔案修改、跨模組相依性,或是錯誤判斷可能造成數小時除錯工作的架構決策,Claude Opus 5 仍是首選。它在指令遵循精準度,以及長時間工作中維持 Context 一致性的能力,正是主要差異所在。
長時間自主 Agent。 Grok 4.6 本來就是為這類情境設計。根據 xAI 的公告,它的開發重點是維持長時間的 Agent 執行軌跡,並加入自我檢查行為。每個任務 0.45 美元,讓你能放心讓它執行更久,不必像 GPT-5.6 Sol 每個任務 1.88 美元那樣承受較大的成本壓力。但如果工作流程高度依賴終端機,GPT-5.6 Sol 在 Terminal-Bench 的 34.6% 領先表現,會是更穩妥的選擇。
低預算與自架部署。 對重視成本的團隊來說,透過 API 使用 DeepSeek V4 Pro 是預設選項,每個任務只要 $0.077。若組織不能把程式碼傳送到外部 API,則可自行部署 Kimi K3(SWE-bench Verified 70.8%)或 MiniMax M2.5(75.8%)這類開放權重模型。以 SWE-bench Verified 來看,開放權重模型與封閉權重領先者之間的差距,已縮小到幾個百分點之內。
別忽略 Harness:Agent 工具可能限制模型上限
Agent 使用的 Harness——不論是 Claude Code、Codex CLI、Cursor,還是 OpenCode 這類開源工具——會控制 4 件模型本身無法決定的事:Context 管理(何時壓縮、保留哪些內容)、工具定義與路由、錯誤復原模式,以及審查與核准流程。正如 Tembo 的分析所指出,在 mini-SWE-agent 這類受控 Harness 下得到的 Benchmark 分數,不一定能反映模型在另一套設定中的實際問題解決率。因此,相較於把模型與 Harness 的增益混在一起的廠商自發布分數,固定 Harness 後進行的 Benchmark,更適合用來比較模型本身。
在更換模型之前,先檢查你的 Harness。確認 Agent 是否有效壓縮 Context、工具定義是否清楚,以及遇到錯誤時能否合理重試,而不是陷入無限循環。
常見問題
哪個 LLM 最適合 Coding Agent,價格也最低?
DeepSeek V4 Pro 的價格是每百萬輸入 Token 0.435 美元、輸出 Token 0.87 美元,是最便宜的前沿級選項;每解決一個 Agent 任務的成本約為 0.08 美元。
如何在自己的 Repository 上測試 Coding Agent 模型?
從實際待辦清單中挑選 20–30 個具代表性的 Issue,涵蓋 Bug 修正、功能開發與重構。使用你選定的同一套 Harness,讓每個模型處理完全相同的任務,並追蹤 3 項指標:解決率(Agent 產生的 Patch 是否能通過測試?)、每個任務的 Token 用量,以及完成所需時間。這種針對自有 Repository 的評估,通常比任何公開 Benchmark 都更能預測實際表現。