 AIREITER
如果只是想盡快把決策模型接進產品,託管 API 仍是最簡單的路:每百萬輸入 Token 僅 $0.04。不過,隨著新的開放權重檢查點推出,本機推論也已具備實用性;只是 3B 與 600M 兩款模型的品質差距相當明顯。
Liquid d1 三種選項,不能直接視為同一款模型
Liquid AI 目前有三個值得比較的選擇:專有的託管 d1 服務、開放權重的 d1-3B,以及實驗性開放權重模型 d1-omni-600M。Liquid AI 並未表示託管模型與任一可下載檢查點完全相同,因此效能測試與延遲數據都必須明確對應到實際測試的模型。
| 選擇 | 取得方式與價格 | 輸入類型 | 公開的 Context | 適合情境 |
|---|---|---|---|---|
託管 d1 | Liquid API;每 1M 輸入 Token $0.04,不收輸出 Token 費用 | 透過 Liquid 直接支援文字與圖片 | Vercel 列為 66K | 快速整合、推論帳單幾乎可忽略、不必維運模型 |
d1-3B | 可下載權重;沒有逐 Token 模型費 | 文字、JSON 與圖片 | 32,768 Token | 最佳本機品質、視覺任務、生產環境評估 |
d1-omni-600M | 可下載的實驗性權重;沒有逐 Token 模型費 | 文字加圖片,或文字加音訊 | 16,384 Token | 小型部署、語音指令實驗、資源受限的邊緣裝置 |
三者的定位都是回答結構化問題,而非撰寫文章或自由生成文字。noul 回傳「是」的機率,choice 回傳指定選項的機率分布,score 則依有序評分量表回傳機率加權後的位置。它們適合路由、內容審核、檢查、防護機制與評分,不能取代聊天模型或程式碼模型。
建議很直接:概念驗證先用託管 d1;若資料必須留在本地,或延遲不能承受網路跳轉,選擇 d1-3B;除非音訊或模型體積是決定性條件,否則應把 d1-omni-600M 視為實驗性選項。
API 計費與本機成本,該怎麼比較?
Liquid AI d1 API 的價格為每百萬輸入 Token $0.04。服務回傳的是決策結果,不是生成文字,因此不收輸出 Token 費用。處理 1 億輸入 Token,在未計入任何 gateway 費用前是 $4;10 億輸入 Token 則是 $40。
在 $0.04/M Token 的價格下,單看推論成本,自架幾乎很難勝出。本機部署應是為了隱私、離線使用、裝置端延遲、客製化或長期高使用率,而不是單純想省 Token 費。
兩個開放檢查點都沒有官方的託管逐 Token 報價。評測時它們的 Hugging Face 頁面也未顯示推論供應商,因此不能把託管 d1 的價格當成 d1-3B 或 d1-omni-600M 的價格。
託管服務也會將圖片計入輸入。Liquid AI 指定每個 32×32 像素區塊為 1.5 Token,所以一張 1024×1024 圖片在問題文字之前就會佔用 1,536 Token。以 $0.04/M 計算,圖片部分約為 $0.00006144;每個問題都會作為獨立 Prompt 計費,並包含其關聯圖片。
開放權重不代表毫無限制,也不代表零成本
兩個儲存庫使用的都是 Liquid AI 的 lfm1.0 授權,不是 Apache 2.0 或 MIT。Liquid AI 的一般定價條款指出,年營收低於 1,000 萬美元的公司可免費商業使用其可下載模型;規模更大的組織應確認當前商業條款,不要只因「open-weight」這個詞就自行推定授權範圍。
評估本機預算時,還要納入 GPU 或裝置採購、閒置容量、監控、更新與人力時間。託管方案的帳單是低額變動成本;本機成本大多是固定成本。
d1-3B 看品質,omni 看體積
官方開放 d1 公告指出,d1-3B 的 Decision Index v0.2.1 分數為 48.57,d1-omni-600M 為 15.95。Liquid AI 以官方評分器測試兩者,但這些結果並非官方排行榜提交成績。
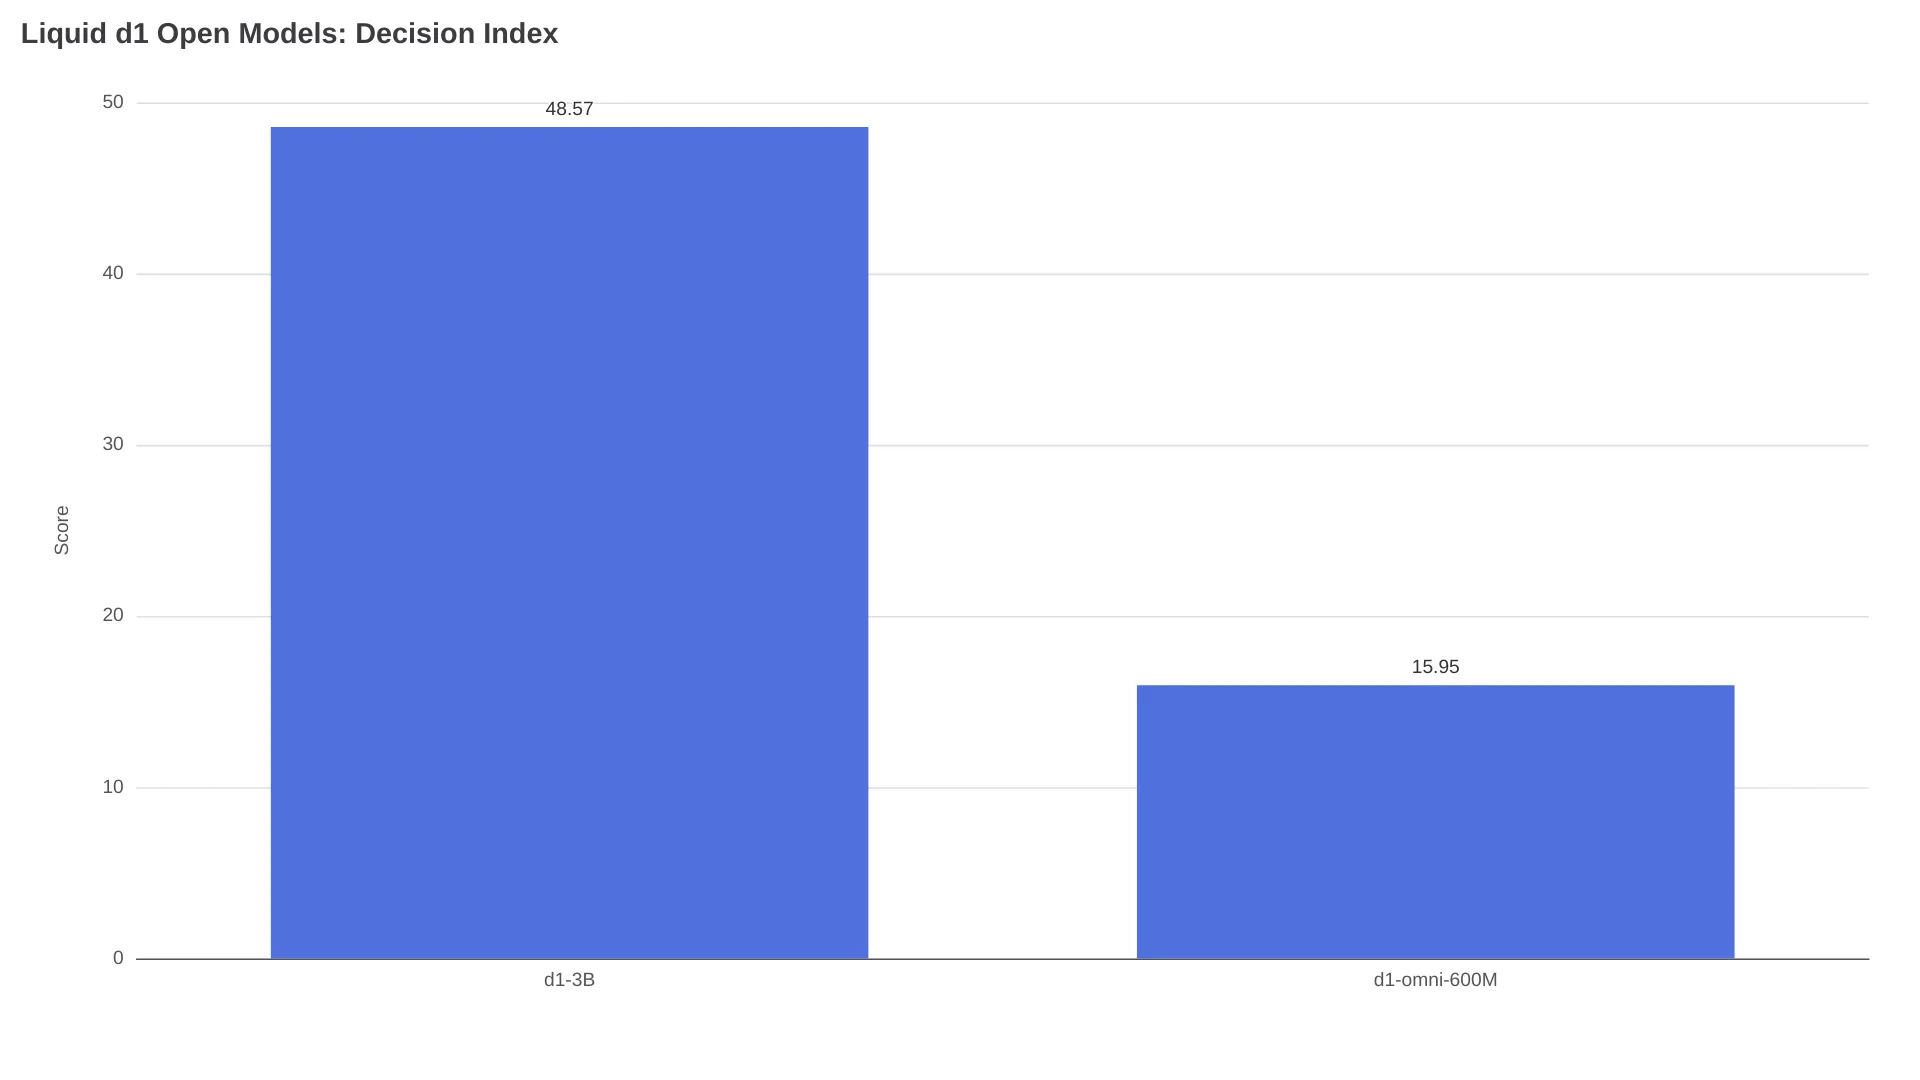
較小的模型並非全面落後。Liquid AI 公布的七項公開文字基準平均分中,d1-3B 為 82.9,d1-omni-600M 為 78.4。Omni 在 Civil Comments 領先,分數為 95.8 對 93.0,也在 PAWS-X 以 79.5 對 76.9 勝出;其餘五項列出的任務則由 3B 領先。但 Decision Index 的差距大得多,表示即使 600M 在少數分類切片表現突出,仍不能把它視為 3B 的通用替代品。
| 規格 | d1-3B | d1-omni-600M |
|---|---|---|
| 詳細參數量 | 3.12B | 587M |
| 全精度儲存庫/權重體積 | 儲存庫 6.27 GB;權重 6.25 GB | F32 模型,約 0.6B 參數 |
| Context | 32,768 | 16,384,由各模態共用 |
| 圖片時的文字額度 | 納入模型 Context | 有圖片時,state 與問題文字會限制在 896 Token |
| 音訊 | 不支援 | 一段 16 kHz 單聲道音檔,最長 30 秒 |
| 圖片與音訊同時輸入 | 不適用 | 不支援;會觸發 ValueError |
| 官方速度表 | 有 | 沒有;屬早期研究版本 |
d1-omni-600M 模型卡表示,模型是以 float32 訓練。Float16 在 243 筆文字、214 筆圖片與 416 筆音訊資料上維持相同的首選答案;bfloat16 則使 0.8% 的文字資料列與 1.7% 的音訊資料列改變首選答案。因此,dtype 不只是最佳化開關,而是需要驗證的變因。
本機部署上手很快,但驗證工作才是長尾
兩張模型卡都提供單一 state 使用的 system_one,以及適合打包請求的 system_one_batch。最精簡的 d1-3B 路徑需要 Transformers 5.14 以上版本、PyTorch、TorchVision、Pillow,以及儲存庫提供的自訂程式碼。
- 安裝文件列出的相依套件:
pip install "transformers>=5.14" torch torchvision pillow- 啟用遠端儲存庫程式碼來載入模型:
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- 傳送具名決策,而不是聊天 Prompt:
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])
trust_remote_code=True 代表儲存庫內的 Python 程式會在服務程序中執行。上正式環境前,應固定到已審閱的 commit,而不是載入持續變動的 branch。d1-3B 儲存庫也連結了供 llama.cpp、Ollama 與 LM Studio 相容執行環境使用的量化版本;社群量化產物的供應鏈風險與準確度,是不同於官方 BF16 權重的另一項決策。
d1-3B 模型卡列出的 warm-call 時間顯示:RTX 4090 上一個問題為 8 ms、Apple M5 Pro 為 30 ms、Jetson Orin Nano 為 50 ms。若 state 長度為 3.4K Token,在相同裝置上的時間分別是 102 ms、640 ms 與 1,640 ms。GPU 數字是 20 次執行的中位數;4090 的 8 ms 成績使用了編譯後的 CUDA graphs,新的輸入形狀則會產生編譯或核心選擇額外成本。
目前沒有官方的 d1-omni-600M 速度表。一個瀏覽器移植版本回報,四項決策每則留言約需 180 ms:
「我還沒在其他機器測過,只有在我的 MBP M4 Pro 上測。」— Reddit 上的 u/FinancialAd1961
這個單一裝置結果只能證明可在瀏覽器中運行,不能代表各瀏覽器、GPU、量化版本或 Batch Size 下的效能。
API 接入最省事,但模型身分仍不可混為一談
直接使用託管服務時,模型名稱是 d1,端點為 https://api.liquid.ai/decisions/v1/systemone。Vercel 使用的是 liquid/d1;其頁面列出 66K Context 與相同的 $0.04/M 輸入價格。Liquid 在 10 月 5 日的公告表示,當時 Vercel 與 OpenRouter 僅支援文字,而直接的 Liquid API 可接受圖片。
開放檢查點以本機 Python 方法提供相同的決策概念,但介面相似不等於行為相同。它們的機率值可能差異大到足以讓個案跨越自動化門檻。每一個經評估的分支,都應記錄確切模型 ID、revision、dtype、機率與門檻。
因此,遷移流程應分成四步:
- 從真實的生產資料分布建立標記資料集,包含模糊案例與高成本錯誤。
- 以完全相同的 state、問題 schema 與 criteria 測試每個候選模型。
- 根據偽陽性與偽陰性的成本選擇門檻,不要只看整體基準分數。
- 在允許執行具破壞性、財務、存取控制或安全相關動作前,先讓勝出的模型進行 shadow 測試。
Liquid d1 到底該選哪一個?
對多數團隊而言,託管 API 是預設建議。它的 Token 價格低到小型試點不值得為此啟動本機服務專案,而且能避開驅動程式、量化、暖機與容量管理等工作。
| 需求 | 建議選擇 | 原因 |
|---|---|---|
| 最快上線路徑 | 託管 d1 | 受管理端點與明確的輸入計費 |
| 資料不能離開裝置或網路 | d1-3B | 最強的開放檢查點,可於本機執行 |
| 已公開的開放模型決策品質最佳 | d1-3B | Decision Index 為 48.57,對比 15.95 |
| 音訊指令分類 | d1-omni-600M | 此處唯一支援音訊的選項,但最長 30 秒 |
| 實驗用途下的最小體積 | d1-omni-600M | 587M 參數,但沒有官方延遲表 |
| 開放式說明或生成動作 | 都不適合 | 在決策階段後加入生成式模型 |
除非 600M 的體積或音訊路徑不可或缺,否則應選 d1-3B 而非 omni。五倍的參數縮減確實有吸引力,但無法抹去 32.62 分的 Decision Index 差距,也改變不了 omni 仍屬實驗性版本的事實。
Liquid AI d1 常見問題
Liquid AI d1 免費嗎?
託管 d1 服務的價格是每百萬輸入 Token $0.04,沒有輸出 Token 費用。開放檢查點可免費下載且沒有逐 Token 費用,但仍適用 LFM 1.0 商業條款,也要負擔本機運算成本。
d1-3B 與 d1-omni-600M 是託管 d1 API 使用的模型嗎?
Liquid AI 尚未說明任一檢查點與託管 d1 完全相同。應把它們視為關聯產品,分別擁有不同模型 ID、Context、基準成績與部署方式。
可以透過 Ollama 執行 Liquid d1 嗎?
d1-3B 模型頁面連結了供 llama.cpp、Ollama、LM Studio 與相容應用程式使用的量化版本。若要取代官方 Transformers 路徑,請先驗證量化者、來源 revision、決策 API 支援度與準確性。
d1-3B 支援音訊嗎?
不支援。d1-3B 可接受文字、JSON 與圖片。d1-omni-600M 可接受文字加圖片,或文字加一段最長 30 秒的音檔,但同一個請求不能同時接受圖片與音訊。
本機執行 d1 需要多少 VRAM?
Liquid 為 d1-3B 提供 6.25 GB 的 BF16 權重檔,但沒有給出一個通用的 VRAM 需求。執行期額外負擔、圖片編碼器狀態、Context 長度、Batch Size、精度與量化方式都會改變總量;應量測目標設定,而不要把檔案大小直接等同於尖峰 VRAM 用量。
不論選擇哪種方案,在自動化會帶來實質影響的決策前,都應先用已標記的生產資料驗證機率門檻。
延伸閱讀:託管 Liquid AI d1 API 評測更詳細說明直接端點、圖片計費與型別化請求契約。