 AIREITER
一個總參數達 594B、每個 token 實際只啟用 17B 的模型,看起來像是不用付出代價就能換來旗艦級效能。不過,Inkling 2 Small 雖然每 100 萬個輸入 token 只要 $0.30,現階段仍只能透過 Tinker 使用,而且在程式撰寫方面敗給 DeepSeek-V4.1-Flash-1017,因此實際購買理由沒有發表文章所暗示的那麼廣泛。本次評估根據產品發布報告與 Tinker 價格資訊整理,尚未能進行獨立的延遲與輸出測試。
Inkling 2 Small 到底是什麼?
Inkling 2 Small 是 Thinking Machines Lab 第二代小型混合專家(Mixture-of-Experts)模型,於 2026 年 11 月 5 日發表。它採用 594B 總參數與 17B 啟用參數的架構,支援文字與圖片輸入,並能調整推理強度,鎖定長時間、多步驟的代理工作流程(Thinking Machines Lab)。
| 規格 | Inkling 2 Small |
|---|---|
| 架構 | 混合專家(Mixture-of-Experts) |
| 總參數/啟用參數 | 594B/17B |
| 輸入模態 | 文字 + 圖片(不支援音訊) |
| 推理控制 | 可調整推理強度(基準測試採用 0.99/xhigh) |
| 視覺編碼器 | 292M 參數、20x20 patch、2x2 pooling |
| 數值格式 | NVIDIA GB300 NVL72 上的 NVFP4 |
| 訓練上下文 | 搭配壓縮功能支援 256K token(基準測試軌跡最長達 1M) |
| Artificial Analysis Index | 31(依發布公告) |
雖然總權重規模達 594B,Tinker 仍以小型模型的價格提供 Inkling 2 Small。
現在怎麼試用:只能用 Tinker,權重下週才會來
目前 Inkling 2 Small 只能透過 Thinking Machines Lab 的 Tinker 平台使用,包括 Playground、微調與取樣功能。可下載的模型權重尚未推出;官方承諾下週以 Apache 2.0 授權釋出完整 checkpoint,但前提是完成外部安全測試與紅隊測試(Thinking Machines Lab)。
這代表目前有三件事需要注意:
- 發布公告只提供 Tinker 存取方式,沒有宣布官方 Hugging Face 或 GGUF 版本,也未在公告中提供第三方服務商的使用管道。
- 早期 checkpoint 曾透過 OpenCode 以 Fledge-Alpha 名稱公開測試(Thinking Machines Lab),因此社群中標示為 Fledge-Alpha 的測試紀錄,指的就是這個模型家族。
- 如果你打算自行架設,現在還不必急著準備:目前引用的發布資料沒有提供吞吐量或首 token 延遲數據,也尚未公布官方 VRAM 建議或量化方案。
Tinker 收費多少?真正值得看的比較在這裡
在 256K 上下文下,Inkling 2 Small 的無伺服器推理價格為每 100 萬個輸入 token $0.30、每 100 萬個快取輸入 token $0.03,以及每 100 萬個輸出 token $1.00。這是 Thinking Machines Lab 三款託管模型中,無伺服器輸出與快取輸入價格最低的一款(Thinking Machines Lab)。
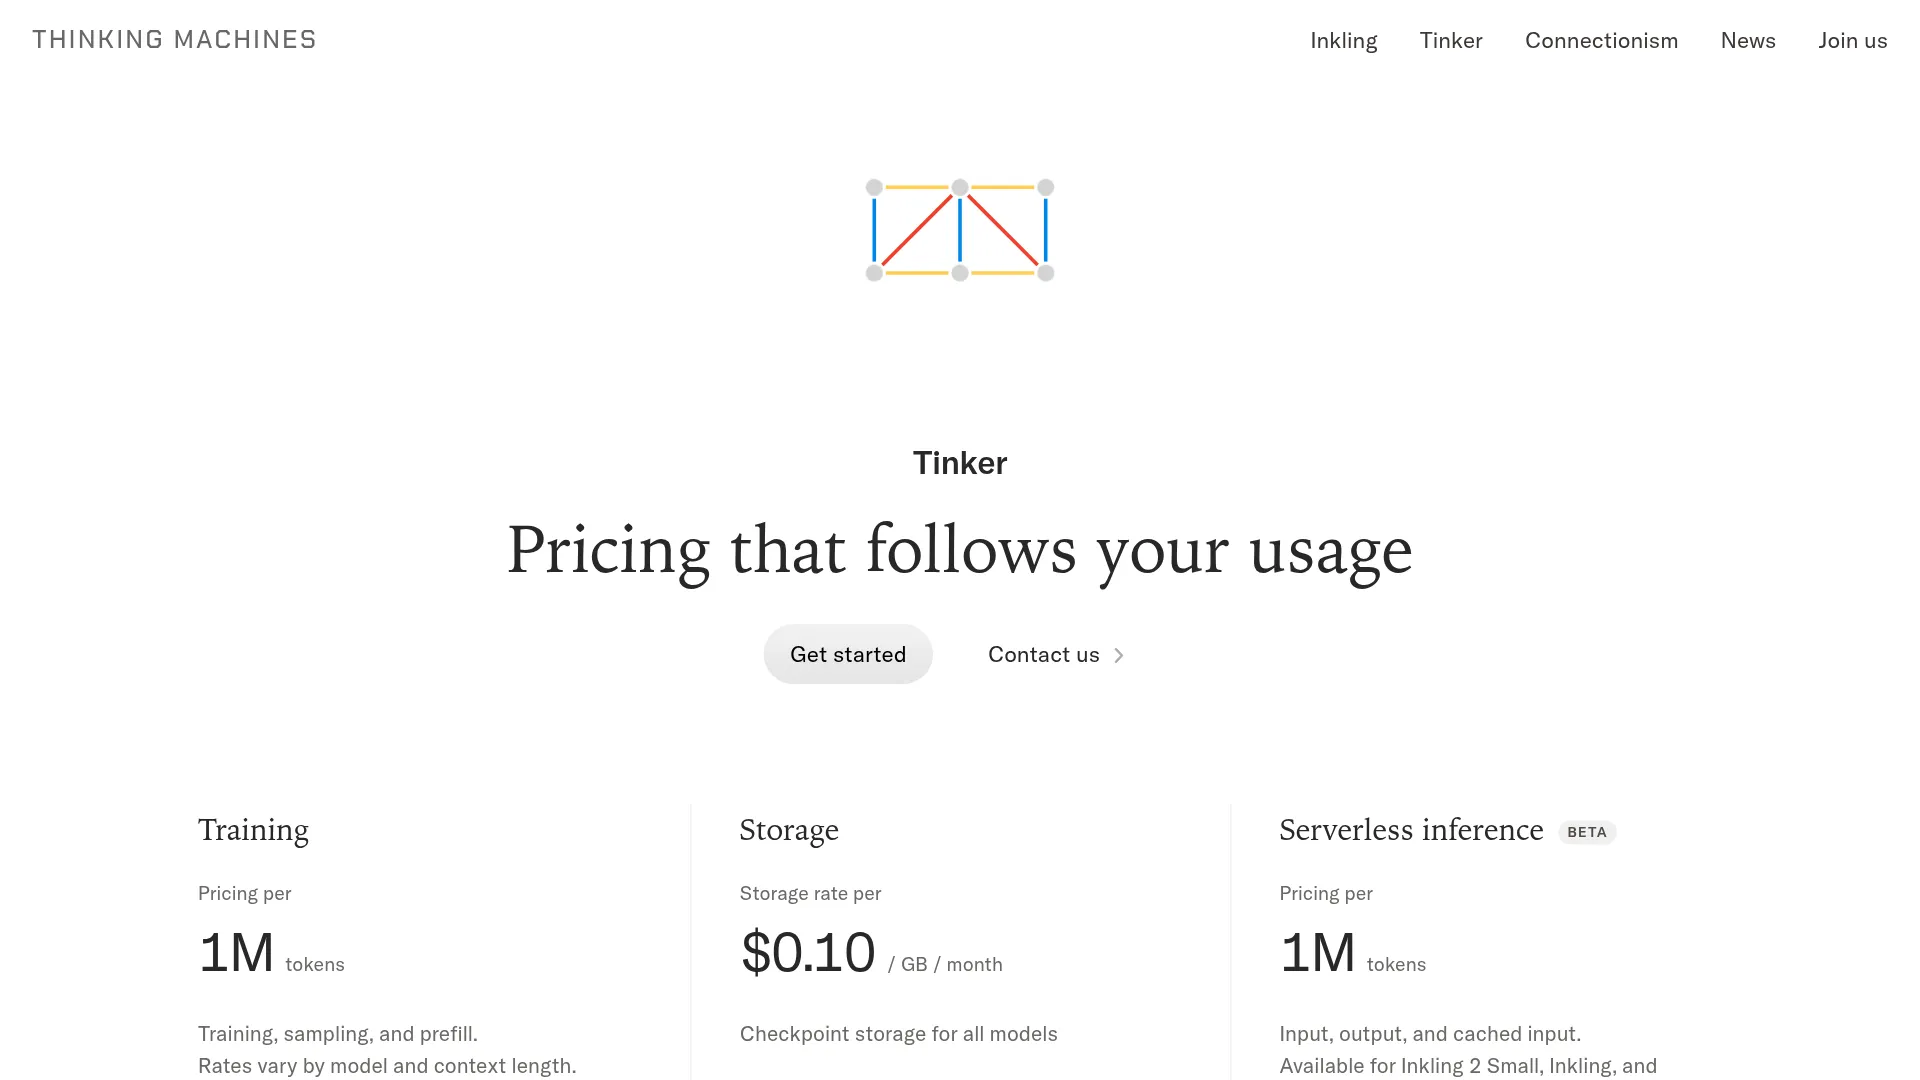
| 模型(無伺服器、256K) | 輸入/1M | 快取/1M | 輸出/1M |
|---|---|---|---|
| Inkling 2 Small | $0.30 | $0.03 | $1.00 |
| Inkling-Small(第 1 代) | $0.30 | $0.06 | $1.20 |
| Inkling(旗艦版) | $1.00 | $0.17 | $4.05 |
若快取命中率為 80%,每 100 萬個輸入 token 的成本約為 $0.084(200K x $0.30 加上 800K x $0.03)。需要長時間壓縮的 rollout 最能受惠:供應商表示,在這套訓練機制下,rollout token 數的中位數為 43K,p99 則達 1.5M(Thinking Machines Lab)。
基準測試:它在哪些項目領先,又在哪些地方輸給 DeepSeek Flash?
以下分數來自供應商的成績報告,內容同時列出勝出的項目與落敗的項目(Thinking Machines Lab)。
| 基準測試 | Inkling 2 Small | 表中最佳對手 |
|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% DeepSeek-V4.1-Flash-1017 |
| DeepSWE v1.1 | 72.1% | 77.0% DeepSeek-V4.1-Flash-1017 |
| SWEBench Pro v2 Hard | 86.3% | 88.2% Kimi K3 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% DeepSeek-V4.1-Flash-1017 |
| HLE-Diamond | 28.7% | 在這組模型中領先(Kimi K3 為 26.9%) |
| LongBench v2 | 70.6% | 在這組模型中領先(Kimi K3 為 69.0%) |
| AA-Omniscience(分數/不產生幻覺) | 16.1/73.3% | 這組模型中最高的不產生幻覺分數 |
| DesignArena Web snapshot | 1,340(第 3 名) | 1,366 Muse Wonder(領先) |
| JobBench/Vals Legal/Vals Finance | 70.5%/73.9%/61.5% | 在表中列出的各組中領先 |
| Terminal Bench Science | 5.7% | 12.9% DeepSeek-V4.1-Flash-1017 |
LongBench v2 的 70.6% 支持它在長上下文處理上的主張,而 HLE-Diamond 的 28.7% 則顯示它在高難度推理項目中的領先表現。企業相關測試方面,CoreCraft(71.8%)與 DAYJOB Finance(14.3%)和 JobBench、Vals 一樣,在各自列出的比較組別中領先。不過仍有幾點限制:DiligenceBench 的 58.1% 落後 Muse Spark Open 的 59.0%;kernel autoresearch 為 6.02x,低於 Claude Opus 5.5 的 18.80x;實驗室也承認模型存在回答過於冗長、組織不均、工具選擇不夠理想,以及過度拒答等問題(FORTRESS 為 20.4,GLM-5.3 為 3.2)。
Inkling-Small 之後改了什麼?
總參數從 276B 增至 594B,超過一倍;啟用參數則由 12B 增至 17B。模型的幻覺表現有所改善,但音訊輸入被移除。新模型只接受文字與圖片,而第一代支援 16 kHz WAV(Thinking Machines Lab)。
從供應商數據來看,第二代的事實性表現更好,但兩代採用的指標並不完全相同。第一代在 SimpleQA Verified 的成績約為 20.6%,Omniscience 分數則為負值(eesel AI)。Inkling 2 Small 的不產生幻覺率為 73.3%,在該組模型中領先,但實驗室仍提醒模型有回答冗長與過度拒答的問題(Thinking Machines Lab)。
第一代的自行架設回報只能當作背景,不能視為 v2 的證據:
「我在 Unsloth Studio 裡試了一下,使用 Q4K_XL。它在多語言對話方面表現非常好。」— u/VotZeFuk,第一代 Inkling-Small 發布討論串(Reddit)
第一代的 89 GB 2-bit 最低需求來自社群製作的 Unsloth 版本(eesel AI);v2 的總參數達 594B,在權重與相關方案正式推出前,實際需求仍是未知數。
你的代理工作流程該呼叫 Inkling 2 Small 嗎?
是否該把工作路由給它,關鍵不在總體基準排名,而在你的工作負載型態。
| 你的工作負載 | 要呼叫 Inkling 2 Small 嗎? | 原因 |
|---|---|---|
| 需要視覺回饋的長時間程式代理 | 透過 Tinker 試用 | 壓縮訓練與視覺迭代循環正好符合這類工作流程 |
| 搭配檢索的企業研究、金融與法律文件撰寫 | 先試用 | 在供應商表格中的 JobBench、Vals Legal/Finance、DAYJOB Finance 領先;仍應使用你的文件驗證 |
| 摘要類任務的微調 | 試用(僅有供應商測試) | 在供應商進行的 200 步測試中,75 步就達到第一代的最終品質(Thinking Machines Lab) |
| 只追求最低錯誤率的 SWE-bench 類程式撰寫 | 不要,改用 DeepSeek-V4.1-Flash-1017 | DeepSWE 為 72.1% 對 77.0%,FrontierCode 為 25.4% 對 28.5% |
| 沒有檢索或防護機制的純事實問答 | 不要,現在還不行 | Omniscience 總分 16.1,落後最佳對手;仍應搭配 RAG 與信心路由 |
| 需要多供應商故障轉移 | 不要,先等等 | 目前只有單一供應商的 Tinker 管道,尚未宣布第三方使用方式 |
它的對齊分數比前代改善(內部不當行為為 14.9,相較 66.8 至 75.2,分數越低越好),但仍落後 GPT-6.1 Sol 的 0.8(Thinking Machines Lab)。
Inkling 2 Small 常見問題
Inkling 2 Small 已經開放權重了嗎?
還沒有。截至 2026 年 11 月 5 日,它仍是只能在 Tinker 使用的封閉權重模型;官方承諾在完成安全測試後,於下週推出 Apache 2.0 權重。
它和 Inkling-Small 有什麼不同?
參數規模從 276B/12B 提升至 594B/17B,不再支援音訊輸入,不產生幻覺率為 73.3%,每 100 萬個輸出 token 的價格則從 $1.20 降至 $1.00。
API 每 100 萬個 token 要多少錢?
在 Tinker 無伺服器、256K 上下文下,輸入每 100 萬個 token $0.30、快取輸入 $0.03、輸出 $1.00。
可以在本機執行嗎?
目前還不行;權重、執行方案與 VRAM 建議都尚未公布。
延伸閱讀:DeepSeek-V4.1-Flash-1017 程式撰寫評測與 Kimi K3.1 Pro API 價格指南。