 AIREITER
若你想用長上下文模型跑程式開發或 agent 工作流,Kimi K3.1 Pro 的 API 價格相當有競爭力:提供 100 萬 token 上下文,每 100 萬未快取輸入 token 為 $2、輸出 token 為 $10。以本文整理的上市首週實際工作負載來看,按量計費的 API 明顯比 $39 訂閱方案省得多。
Kimi K3.1 Pro 到底是什麼模型?
Kimi K3.1 Pro 是 Moonshot AI 首款 K3.1 系列模型,於 2026 年 10 月 23 日推出,定位為 Kimi K3 的後訓練升級版。Moonshot 將它描述為 3T 級 mixture-of-experts 模型,鎖定長時間程式開發、3D 與 CAD 工具流程、財務文件分析,以及多步驟 agent 任務。
它的上下文窗口為 1,048,576 token,但這是輸入、推理 token 與輸出共用的總額度,並不是 100 萬輸入再加 100 萬輸出。透過 Moonshot 產品可輸入文字、圖片與影片;API 則會回傳文字、程式碼和工具呼叫,而 Blender、遊戲引擎、PDF 工具等外部軟體負責產出視覺成果。模型的推理功能無法關閉,可用 reasoning_effort 設定 low、high 與 max,預設為 max。
Moonshot 承諾會在 11 月 4 日前釋出開放權重,但 TheQuery 在 10 月 24 日的查核尚未確認可下載的 checkpoint 或最終授權條款,ArtificialWatch 也將授權狀態列為未知。在 checkpoint 與授權正式發布前,應先以託管 API 為主要使用方式。
標準版與 Highspeed:費率怎麼算?
在 Kimi API platform 上,標準版 Kimi K3.1 Pro 的未快取輸入為每 100 萬 token $2,輸出為 $10。Kimi K3.1 Pro Highspeed 的計量 token 費率則剛好翻倍,輸入 $4、輸出 $20,但快取輸入讀取仍維持每 100 萬 token $0.20。ArtificialWatch 與 AI/ML API 定價表也列出相同的 $2/$10 與 $4/$20 組合。
| 項目(每 100 萬 token) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| 未快取輸入 | $2.00 | $4.00 |
| 輸出(含推理) | $10.00 | $20.00 |
| 快取輸入讀取 | $0.20 | $0.20 |
| 快取寫入,保存 5 分鐘 | $2.00 | $4.00 |
| 快取寫入,保存 1 小時 | $4.00 | $8.00 |
真正影響帳單的,往往不是表面上的單價,而是三項計費細節。第一,所有上下文長度採單一費率,預設快取保存時間是五分鐘;在這段期間重複使用 prompt 前綴,輸入成本會從 $2.00 降至 $0.20。第二,推理 token 按輸出費率計價,因此長 agent 軌跡若使用 max 推理強度,可能會成為成本大宗。第三,API 費用與 Kimi 會員、Kimi Code 訂閱完全分開;而 TheQuery 對 Batch API 指南的查核發現其中未列出 K3.1 Pro,因此不要先假設它適用批次折扣。
以固定 token 數量試算,成本其實很低:100,000 個未快取輸入 token 為 $0.20,加上 10,000 個輸出 token 的 $0.10,合計僅 $0.30;但這還不包含快取寫入、工具使用、重試與稅金。
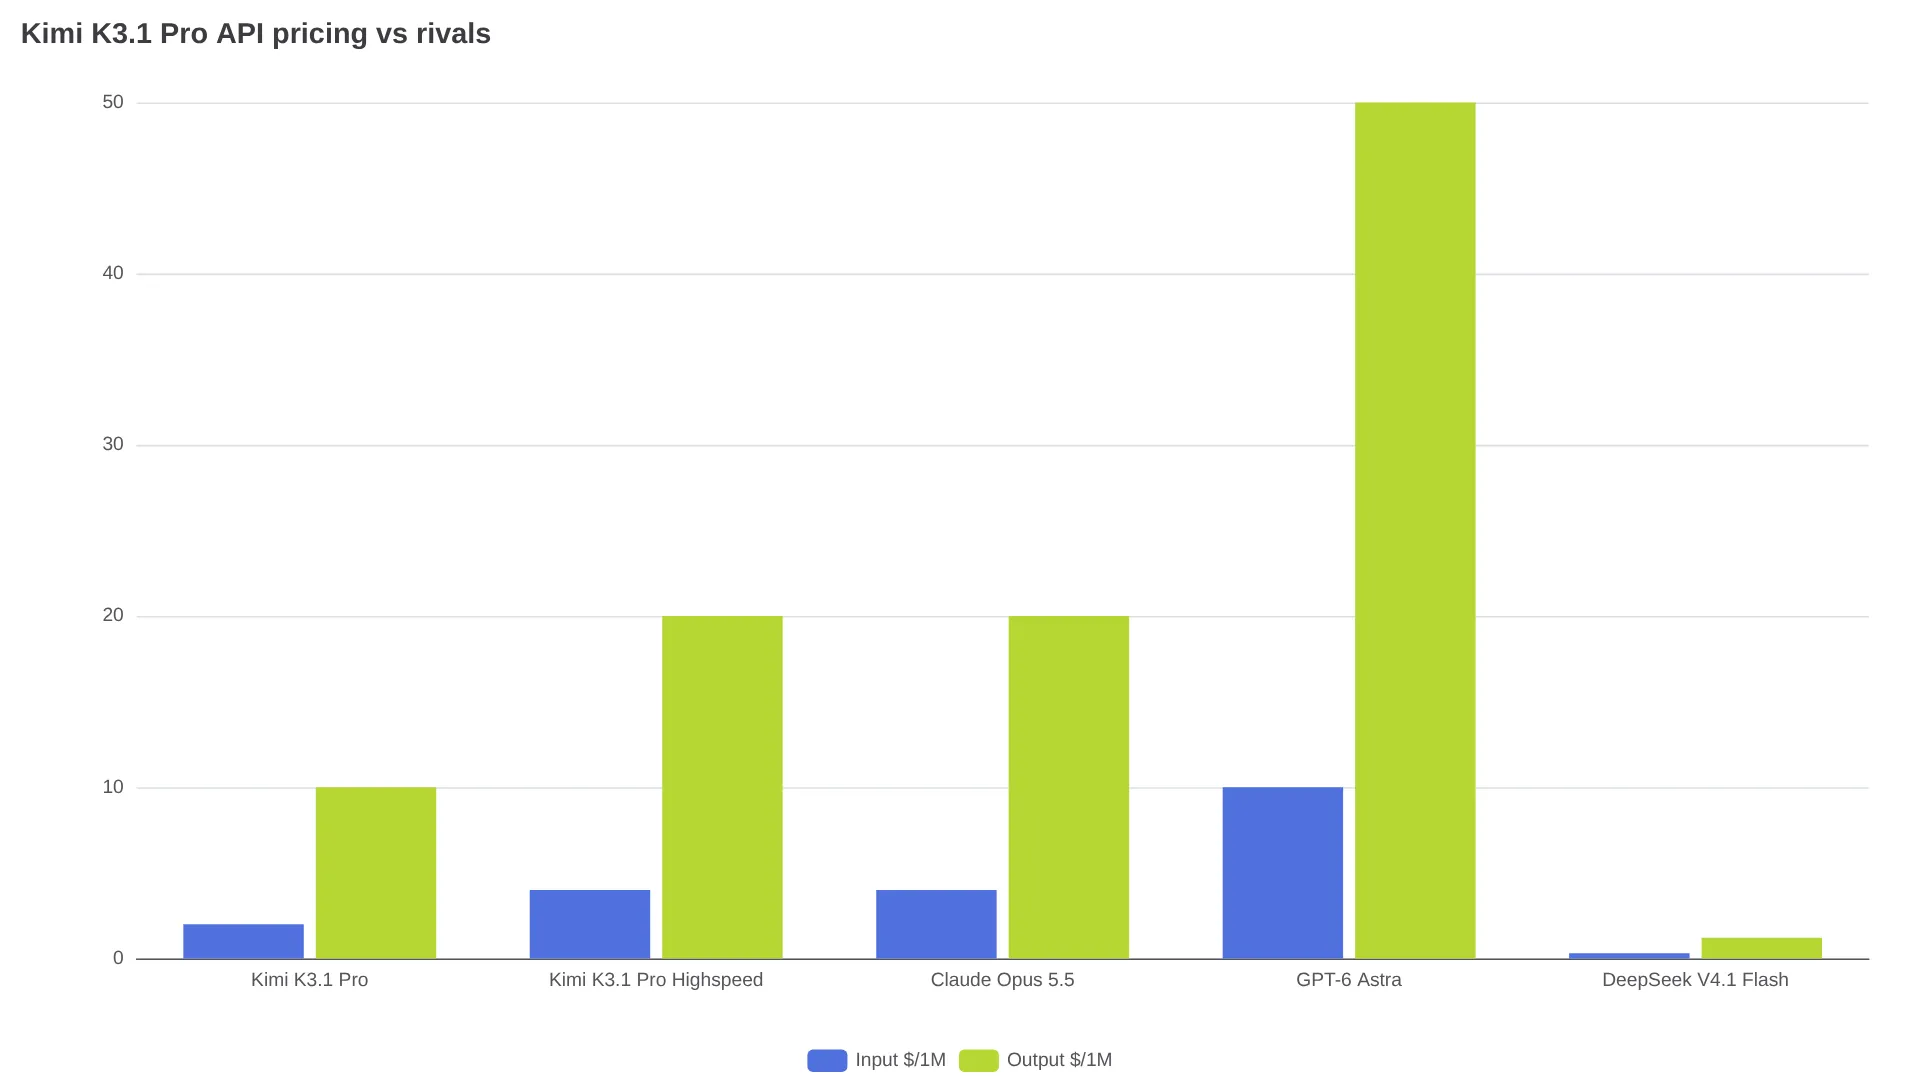
和競品相比,標準版 K3.1 Pro 比 Kimi K3 pricing 的 $3/$15 低 33%,價格是 Claude Opus 5.5($4/$20)的一半,也是 GPT-6 Astra($10/$50)的五分之一,數據來自 ArtificialWatch 的比較。根據 AI/ML API 定價表,DeepSeek V4.1 Flash 以 $0.30/$1.20 壓低了所有列出的競品,但下一節會看到,它的 benchmark 成績有明顯落差。Highspeed 與 Opus 5.5 定價完全一致,因此只有在它宣稱的 2 至 3 倍速度,確實能讓延遲敏感型任務縮短足夠時間、抵銷雙倍 token 成本時才值得選。
$39 訂閱額度不耐用,API 為何反而划算?
上市當天看 API 定價還算合理,訂閱制的體驗卻不是如此。多位付費使用者表示,5 小時額度只用一兩個 prompt 就耗盡,甚至一次程式開發任務就吃掉大量月度配額。
「Kimi K3.1 Pro 現在是全世界最好的開放模型,毫無疑問。但單靠它自己的訂閱制幾乎沒法用。我用的是 $39 方案,做 ship test……就吃掉我每月額度的 11.6%。這代表我一個月大概只能做 8 次這類東西……最糟的訂閱方案……瓶頸不在品質,而在算力。」 — @Da7_Tech,使用者回報的額度消耗情況
「Kimi K3.1 Pro 的用量限制真的令人作嘔又可恥。我 5 小時的額度,prompt 才進行剛好 1 分鐘就用完了,而且什麼都還沒做出來!」 — @MiaAI_lab,$39 方案訂閱者
有使用者表示,自己為四個 prompt 花了 $400 的訂閱費,估計相同工作透過 API 只要 $29;另有使用者回報,單一動畫任務就耗掉大部分 5 小時額度。對開發者來說,結論很直接:應透過按量計費 API 評估 K3.1 Pro,例如 Moonshot、OpenRouter、Vercel AI Gateway。100k 輸入加 10k 輸出的成本,在重試與工具費用前是 $0.30,而不是把同一套推理能力丟進更嚴格的訂閱額度限制裡。
Benchmark 怎麼看:先保留對廠商數據的警覺
以下主要分數皆由 Moonshot 公布,除非另有說明;測試採最大推理強度、temperature 1.0 與 top-p 0.95。小幅差距應視為設定相關,因為各家分數並非由同一套測試框架收集:Kimi 使用 Kimi Code,其他模型用 Claude Code,而 OfficeQA 中的 GPT-6 Astra 使用 Codex,詳見 AI/ML API 的說明。
| 評測項目 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | 40.0% |
| Agents' Last Exam v1.1 | 43.2% | 42.6% | 32.8% | 37.7% |
| OfficeQA Pro v2 | 64.4% | 62.2% | 54.4% | 40.4% |
| BenchCAD with tools | 92.7% | 96.2% | 95.9% | 81.6% |
Kimi 在五項中拿下三項第一;在 Terminal-Bench 則落後 0.7 個百分點。TheQuery 指出,這個差距低於 Anthropic 為 Opus 報告的 2.6 個百分點標準誤。BenchCAD 的 92.7% 是在 1,000 個案例的開放模型子集上,以 voxel overlap 計算;至於 Claude 的數據,則是從 system card 匯入,並非所有模型在統一環境下重新跑測,這些都記載於 AI/ML API 的方法論說明。
事實正確性方面,Moonshot 內部的 Kimi Hallu Bench 顯示,K3.1 Pro 在標準測試集的 claim-level error 為 5.4%,GPT-6 Astra 為 4.2%;在附工具的 Hard 測試集上,則是 8.3% 對 5.5%,參見 AI/ML API Hallu 表格。相較 K3 在 Hard 測試的 23.4%,K3.1 Pro 降低了 65%,但 Astra 仍在兩個測試集都領先;若一次錯誤陳述就會毀掉最終成果,Astra 仍應保留在候選名單中。這些全都是對抗式壓力測試,不能直接視為日常使用的錯誤機率。
上市時可取得的獨立數據來自 Artificial Analysis:K3.1 Pro 在其 Intelligence Index 獲得 55 分,總排名第 4,排在 Claude Opus 5.5、Sonnet 5.5 與 Muse Wonder Full 之後。這項排名不僅依賴廠商自行測試,也為「接近前沿、價格只要一半」的說法提供了支持。
API 串接方式與避免費用失控的設定
Kimi K3.1 Pro 相容 OpenAI API,因此遷移主要只需更換 base URL 與 model ID。官方 base URL 為 https://api.moonshot.ai/v1,模型 ID 是 kimi-k3.1-pro 與 kimi-k3.1-pro-highspeed;這一點由 TheQuery 的 endpoint 查核與 AI/ML API 設定指南確認。第三方 gateway 則採用帶命名空間的 ID,例如 Requesty 的 moonshot/kimi-k3.1-pro,或 Vercel 上的 moonshotai/kimi-k3.1-pro。
根據 TheQuery 的 API 行為說明,quickstart 將 generation settings 固定為 temperature 1.0 與 top-p 0.95,並建議不要自行調整,直接省略即可。成本控制應改用 reasoning_effort:先以 low 做測試,任務失敗時提高至 high,最後正式執行才使用預設的 max。即使設定 max_completion_tokens 為 8,192,實際可見答案仍可能很短,因為隱藏推理同樣會吃掉這個額度,並按每 100 萬 token $10 計費。
依據 AI/ML API 的工具使用與 token 指引,以下是控制成本的重點:
- 工具步驟之間要完整保留 assistant message;若使用串流,也必須保留
reasoning_content,並在下一次呼叫前回傳工具結果。 - 在 5 分鐘快取窗口內重複使用 prompt 前綴,可把重複輸入成本降到每 100 萬 token $0.20。
- 衡量的是每個被接受成果的成本,不是單純每個 token 的價格。
- 單價較低的模型若需要重試兩次,就不是真的比較便宜。
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
儲值 $1 即可開通使用權,但仍受分級 rate limit 約束;企業存取預設關閉,需由管理員啟用,這是 TheQuery 的 API 行為查核結果。隱私方面,Opper 對 Moonshot 路由的稽核指出,該路由預設會保留內容,且客戶資料會用於訓練,並未提供 zero-data-retention 選項。若未具備合約層面的保護措施,不應經由這個路由傳送機密或受監管資料。
該選哪一個?真正要算進去的取捨
| 你的需求 | 建議選擇 | 原因 |
|---|---|---|
| 最便宜的前沿級程式開發任務 | Kimi K3.1 Pro API | SWE-Marathon 領先,價格只要 Opus 一半,共享 100 萬 token 上下文 |
| 最低延遲 | Kimi K3.1 Pro Highspeed | 宣稱速度提升 2 至 3 倍,但 token 成本剛好是 2 倍 |
| 最少的事實錯誤 | GPT-6 Astra | 標準 Hallu 為 4.2%,對比 5.4%,但價格是 5 倍 |
| 最低 token 單價,可接受較弱分數 | DeepSeek V4.1 Flash | $0.30/$1.20,但列出的五項 benchmark 中有四項最低 |
| 自行部署 | 等待 | 權重承諾於 11 月 4 日前發布,授權仍未知 |
如果 Moonshot 在 11 月 4 日前以寬鬆授權發布完整權重,自行部署可能會改寫訂閱額度與 API 成本之間的計算。正在比較長上下文程式模型的開發者,在做出決定前也可參考這篇 best LLM for coding agents in 2026。
Kimi K3.1 Pro API 常見問題
Kimi K3.1 Pro API 的價格是多少?
標準版 Kimi K3.1 Pro 的未快取輸入為每 100 萬 token $2,輸出為 $10,快取輸入讀取則為每 100 萬 token $0.20。Highspeed 的輸入、輸出與快取寫入費率都翻倍,但快取讀取仍維持 $0.20。
K3.1 Pro 和 Highspeed 差在哪裡?
Highspeed 宣稱在相同智能水準下,提供 2 至 3 倍推論服務速度,代價是輸入與輸出價格翻倍,從 $2/$10 變成 $4/$20。Vercel 的即時 provider 表格列出 Highspeed 擁有更低延遲與更高吞吐量,但 Moonshot 的加速說法尚缺乏獨立的任務完成時間比較。
API 的模型 ID 是什麼?
官方 Kimi API 請使用 kimi-k3.1-pro 與 kimi-k3.1-pro-highspeed;第三方 gateway 則使用帶命名空間的等效 ID,例如 moonshot/kimi-k3.1-pro。既有 K3 整合必須明確改用新 ID。
Kimi 會員是否包含 API 用量?
不包含。API 費用與 Kimi 會員及 Kimi Code 訂閱分開計算;上市首週的使用者回報顯示,面對相同工作,訂閱額度遠比按量計費 token 更嚴格。
可以關閉推理功能嗎?
不行。Kimi K3.1 Pro 永遠會進行推理;low、high 與 max 只會調整思考程度,預設是 max。若是短篇、不需推理的請求,應改用其他模型。
API 是否相容 OpenAI?
是。只要把 OpenAI SDK client 指向 https://api.moonshot.ai/v1,或第三方 gateway 的 base URL,再指定模型 ID,即可使用;串流時設為 stream=True。quickstart 固定使用 temperature 1.0 和 top-p 0.95,應改以 reasoning_effort 與 max_completion_tokens 進行調整。