 AIREITER
如果這週就得取得可自行部署的模型 checkpoint,兩者之中目前只有 MiniMax M3.1 Flash 能下載。它的開放權重現已上架 Hugging Face;Kimi K3.1 Pro 則尚未釋出權重,Moonshot 承諾會在 2026 年 11 月 4 日前公開。
目前能從 Hugging Face 下載的只有 MiniMax
MiniMax 約在 2026 年 10 月 22 至 23 日,於 Hugging Face 發布 M3.1 Flash 權重,採用 minimax-community 授權;發表報導指出 ModelScope 也有提供模型(Cocoloop)。Kimi 官方技術部落格則表示,Kimi K3.1 Pro 現已可透過 Kimi.com、各項 App、Kimi Code 與 Kimi API 使用;完整模型權重預計在 2026 年 11 月 4 日前推出(kimi.com)。
MiniMax M3.1 Flash 與 Kimi K3.1 Pro 規格對照
MiniMax M3.1 Flash 是原生多模態 MoE 模型,總參數約 4,280 億,每個 token 啟用 230 億參數;可接收文字、圖片與影片,輸出為文字,最長支援 100 萬 token 上下文(MiniMax 發表文章)。Kimi K3.1 Pro 官方定義為 3T 級 MoE,具備 100 萬 token 上下文視窗(kimi.com);至於 2.8T 總參數與 1,040 億啟用參數,則來自發表報導(ArtificialWatch、ExplainX),並非 Moonshot 官方公開的參數數據。
| 項目 | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| 總參數/啟用參數 | 約 428B/每 token 啟用 23B | 3T 級;發表報導稱為 2.8T/啟用 104B |
| Hugging Face 儲存庫 | MiniMaxAI/MiniMax-M3.1-Flash,已上線 | 截至 2026 年 10 月 24 日尚無;預定 11 月 4 日前推出 |
| 下載容量 | 約 252 GB | 未知;若以 MiniMax 的密度估算(每 B 參數約 0.59 GB),2.8T checkpoint 將是 TB 級 |
| 上下文 | 最長 100 萬 token,實際依部署而定 | 100 萬 token |
| 輸入/輸出 | 文字、圖片、影片輸入;文字輸出 | 多模態、文字輸出;自行部署時支援的確切模態尚未確認 |
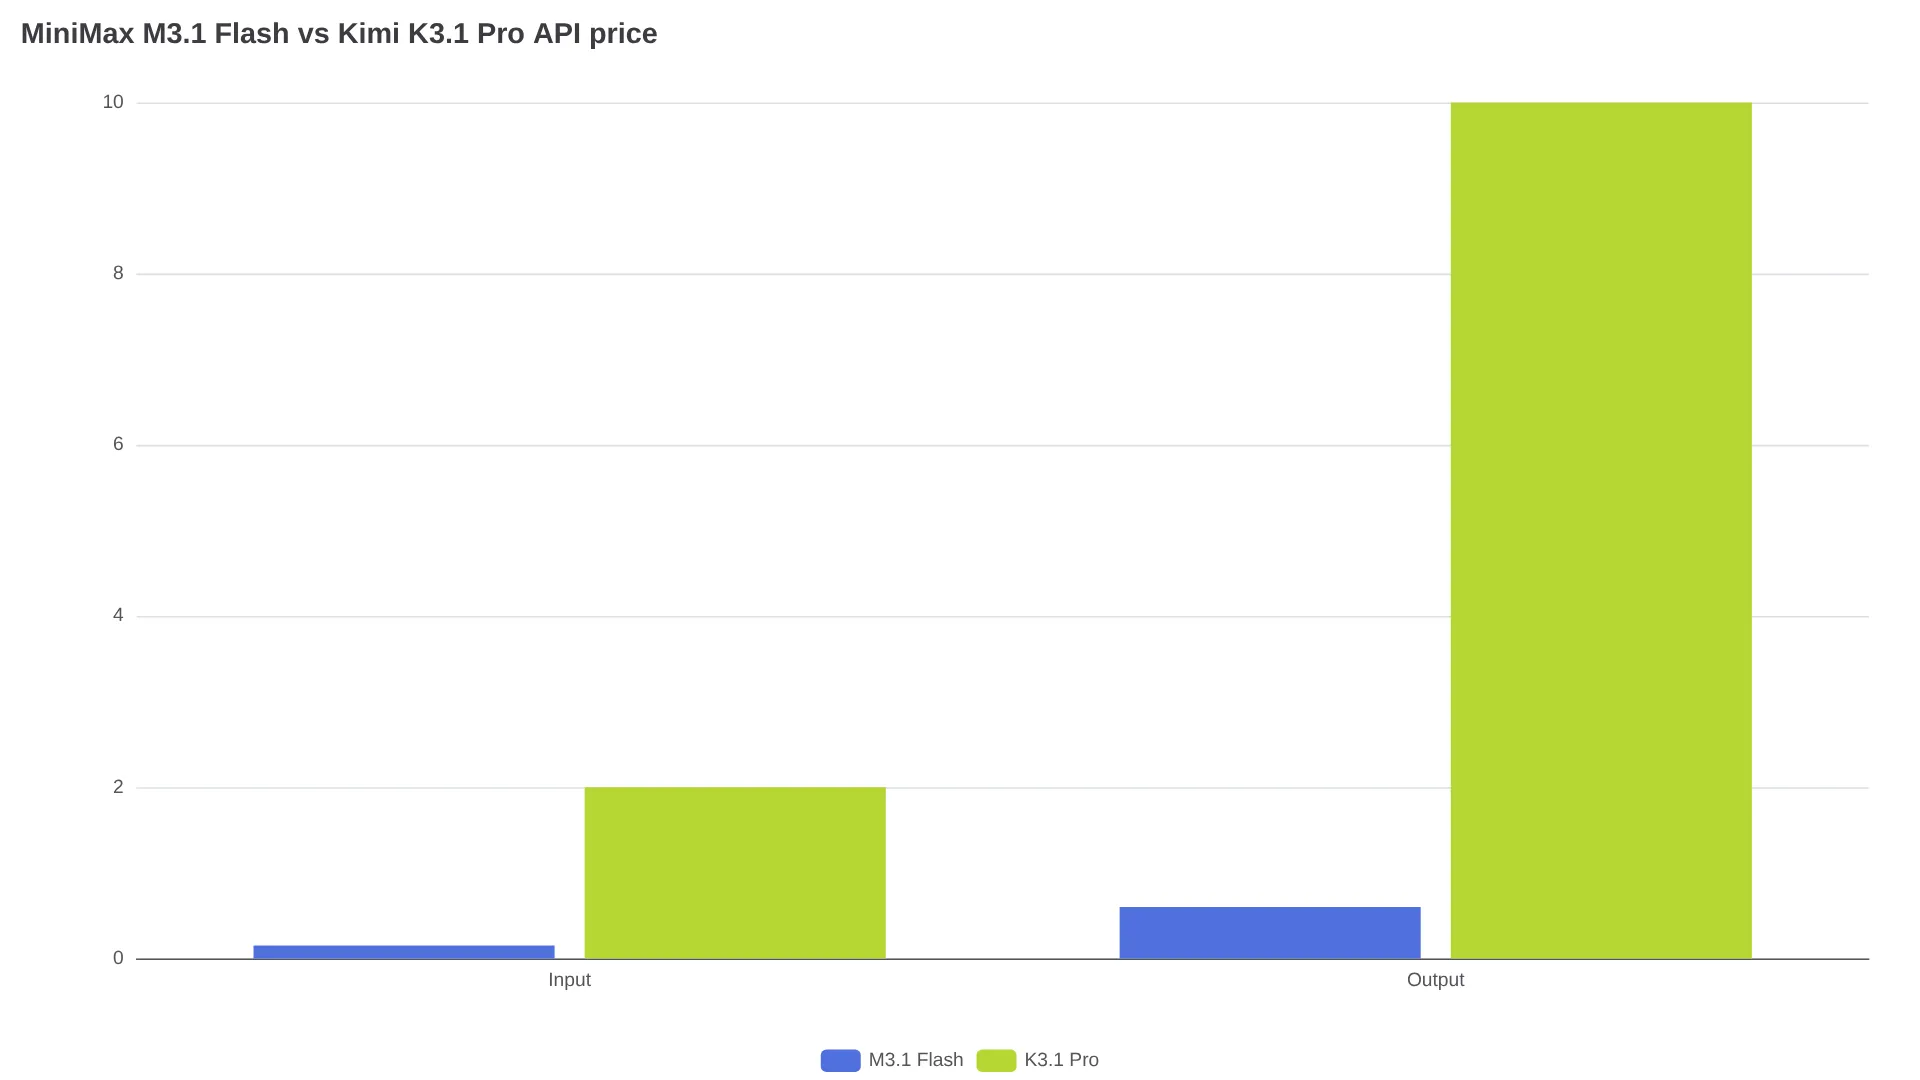
| 官方 API 價格 | 每 100 萬 token:輸入 $0.15/輸出 $0.60/快取 $0.015(MiniMax) | 報導價格為每 100 萬 token:輸入 $2/輸出 $10(ArtificialWatch) |
| 推論部署方案 | SGLang、vLLM、TokenSpeed;多晶片可用 FlagOS | 尚未公布;API 模型 ID 為 kimi-k3.1-pro/kimi-k3.1-pro-highspeed(Kimi 文件) |
| 建議取樣設定 | Temperature 1.0、top-p 0.95;推理強度 low–max | 依 Kimi benchmark 設定:最高推理強度、temperature 1.0、top-p 0.95 |
MiniMax 提供的官方下載指令如下:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash開始跑 benchmark 前,請確認檔案是否完整,包括 DSpark draft head、tokenizer 與設定檔。MiniMax 也提醒,測試結果適用於官方權重,第三方量化版本的表現可能不同。
以下 benchmark 數字除非另有標註,皆應視為廠商自行公布的成績:
| Benchmark | M3.1 Flash(廠商數據) | 廠商列出的競品 |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017:60.5 |
| BankerToolBench | 76.2 | Opus 5:76.2(平手) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol:60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017:77.0 |
| OSWorld 2.0 | 61.7 | Opus 5:70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5:51.8 |
一份引用的獨立評測快照顯示,M3.1 Flash 得分 53.78%,在 26 個模型中排名第 16,長期任務成績偏弱(Vals)。Kimi 自家圖表則稱 K3.1 Pro 在列出的 14 項測試中領先 6 項,其中 Agents' Last Exam 為 43.2、SWE Marathon 為 51.7,Terminal-Bench 4.0 則為 65.7。
下載 252 GB 權重後,託管成本怎麼算
該儲存庫容量約為 252 GB。若每個權重採用 4 bit,光是 4,280 億參數理論上就約需 214 GB,還未算入 KV cache 與執行期緩衝區;想取得可用的上下文長度,應預期需要數張 80 GB 級 GPU。NVIDIA 的 RTX Spark 帳號指出,本地執行可考慮 DGX Station 或由 4 台 DGX Spark 128 GB 組成的叢集(X 貼文);X 上的自架使用者也提到,252 GB 的下載量加上這樣的硬體門檻,已排除一般桌機,而 API 價格仍相當便宜(@bufcapy)。
建議先算 API 端的帳,因為 MiniMax API 的價格異常低。以每 100 萬 token 輸入 $0.15、輸出 $0.60 計算,一天使用 1,000 萬輸入 token 與 200 萬輸出 token,費用為 10 × $0.15 + 2 × $0.60 = $2.70,約為每月 $81。
損益兩平的公式,是每月叢集成本除以每 token 的 API 成本。輸入每 100 萬 token $0.15 時,每月 $150 的租用成本相當於 10 億輸入 token;輸出每 100 萬 token $0.60 時,每月 $600 相當於 10 億輸出 token。將你實際取得的租用報價與工程時間一併代入:只有當按上述費率計算的每月 API 帳單超過總成本,或政策要求權重必須留在你的安全邊界內時,自行託管才划算。Kimi 的反差更大:報導中的 API 價格為每 100 萬 token $2/$10,輸入端約為 MiniMax 的 13 倍,輸出端約為 17 倍。因此,未來若釋出 2.8T 參數 checkpoint,必須具備非常高且持續的吞吐量,才能合理化 TB 級儲存與多節點叢集的成本。
第一天自行部署,實際能用到什麼
首日框架支援已經到位,但仍不算完整。模型卡列出 SGLang、vLLM、TokenSpeed,以及用於多晶片部署的 FlagOS,SGLang 也提供 Docker 映像檔;Transformers、KTransformers、unsloth 與 ATOM 的整合在發表時仍持續進行。一名部署者指出,vLLM 的 H100/H200 範例設定目標是 256K token,而非完整的 100 萬 token,同時關閉影片輸入,也未啟用 DSpark speculative decoding(@sancaksofttech)。下載的是同一份權重,不代表所有部署方式都能解鎖完整功能。
r/LocalLLaMA 社群反覆出現的一個疑問是:「Flash」講的是推論經濟性,不代表模型體積小:
量化後能塞進 256GB 嗎?拜託可以。 — u/BawbbySmith,發表於 r/LocalLLaMA
比硬體更早決定成敗的授權條款
M3.1 Flash 是開放權重,不是開源模型。儲存庫中的 LICENSE 標示為 minimax-community,可參閱授權檔案;非商業用途可自由使用。商業用途必須顯著標示「Built with MiniMax M3.1-Flash」,並一次性通知 MiniMax;年營收超過 $20M 的組織或產品,必須事先取得書面授權,且禁止軍事用途。
對內部工具而言,這些要求負擔不大;但對商業代管服務可能構成阻礙,因為標示義務與營收門檻最難處理。Kimi 的授權內容要等到 11 月 4 日權重釋出後才會明朗;Moonshot 已在技術部落格說明,開放 checkpoint 與 API 模型會有所不同,因為開放權重已移除與網路安全相關的訓練資料(kimi.com)。正式建置前,請務必閱讀兩者的 LICENSE 檔案。
依你的使用情境選擇
| 你的情境 | 建議選擇 |
|---|---|
| 這週就需要權重做本地評測、微調基底或 air-gapped 部署 | MiniMax M3.1 Flash——兩者中唯一可下載的選項 |
| 在意成本、負載變動大的程式開發 agent | MiniMax API,每 100 萬 token 為 $0.15/$0.60——只有持續高用量時才考慮自架 |
| 追求前沿長期程式任務能力,而且能等待 | 先評估 Kimi K3.1 Pro API;待 11 月 4 日權重、授權與實際容量公布後,再決定是否自架 |
| 商業代管產品 | 先由法務確認 MiniMax 的標示義務與 $20M 授權門檻;Kimi 在授權公布前無法判斷 |
| 消費級 GPU 或單台 Mac | 目前未引用任何已驗證的單機方案——除非準備測試未受支援的設定,否則應使用 API |
常見問題
MiniMax M3.1 Flash 官方權重在哪裡下載?
官方儲存庫是 Hugging Face 上的 MiniMaxAI/MiniMax-M3.1-Flash,另有 ModelScope 鏡像;可透過 hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash 下載。
Kimi K3.1 Pro 有官方 Hugging Face 儲存庫嗎?
沒有。截至 2026 年 10 月 24 日,尚無公開的 K3.1 Pro 權重儲存庫;Moonshot 技術部落格承諾會在 2026 年 11 月 4 日前釋出完整權重。
MiniMax M3.1 Flash 可以商業使用嗎?
可以,但附帶條件:必須標示「Built with MiniMax M3.1-Flash」、一次性通知 MiniMax,年營收超過 $20M 時則須先取得書面授權;軍事用途遭禁止。請與法律顧問依據儲存庫 LICENSE 再次確認。
它能在消費級 GPU 或 Apple Silicon 上執行嗎?
引用的部署指引沒有提供已驗證的單張消費級 GPU 方案;估算顯示,量化權重加上 KV cache 仍需要數張 80 GB GPU。NVIDIA 指向的硬體為 DGX Station 或 4x DGX Spark 128 GB 叢集。
現在能搭配 vLLM 或 SGLang 使用嗎?
兩者都有首日部署方案,另外還有 TokenSpeed 與用於多晶片執行的 FlagOS。不過,範例設定可能將上下文限制在 256K、停用影片輸入,或未開啟 DSpark;請依你的硬體查看模型卡中的最新部署方案。
自行部署時能使用完整的 100 萬 token 上下文嗎?
標示的最大值為 100 萬 token,但實際可用長度取決於 GPU 記憶體與服務設定。處理長上下文工作負載時,請明確預留 KV cache 的記憶體空間。
延伸閱讀:MiniMax M3.1 Flash 開放權重:下載、執行與成本指南、Kimi K3.1 Pro API 定價指南、Kimi K3 開放權重