 AIREITER
現在大多數開發者都能直接呼叫 GPT-6 Cyber 嗎?答案是否定的。根據 OpenAI 文件、供應商基準測試與使用者回報,GPT-6 Cyber 是一款能力強勁的漏洞利用專用模型,但必須先獲得 Daybreak Red 核准;至於大部分防禦性工作,GPT-6 Astra 已經足夠,而且價格只有一半。
GPT-6 Cyber 於 2026 年 11 月 5 日以 gpt-6-cyber 之名推出,是以 GPT-6 Astra 為基礎、再加入網路安全強化訓練的版本,主攻授權漏洞發掘、漏洞利用驗證與修補程式開發。根據 Kingy 與 BenchLM 的模型沿革資料,它目前受 Daybreak Red 存取管制。
Red 還是 Blue?30 秒判斷該用哪一層
Daybreak 的分流關鍵在於工作內容,而不只是帳戶本身。防禦性任務可使用主線模型搭配 Daybreak Blue;需要授權進行攻擊性測試,或直接使用 gpt-6-cyber,則要走 Daybreak Red。
| 你的工作 | 應申請的層級 | 應呼叫的模型 | 主要差異 |
|---|---|---|---|
| 安全程式碼審查、惡意軟體分析、事件回應、修補驗證 | Daybreak Blue | gpt-6-sol、gpt-6-luna、gpt-5.6-sol | 比標準模式少一些拒答,但沒有漏洞利用開發權限 |
| 授權滲透測試、紅隊演練、大規模漏洞利用驗證 | Daybreak Red | gpt-6-cyber(以及 gpt-5.5-cyber、gpt-5.6-cyber) | 需要獨立核准、傳送 daybreak_red 請求值、IP allowlist,以及 SSO/MFA |
| 一般程式開發,偶爾進行安全審查 | Standard 或 Blue | gpt-6-sol、gpt-6.1-sol | 不必為 Cyber 的溢價買單 |
| 在強化目標或零時差漏洞上進行研究,且需要可重現結果 | Daybreak Red(符合資格時) | gpt-6-cyber | 必須預留人工審查與沙盒環境的成本 |
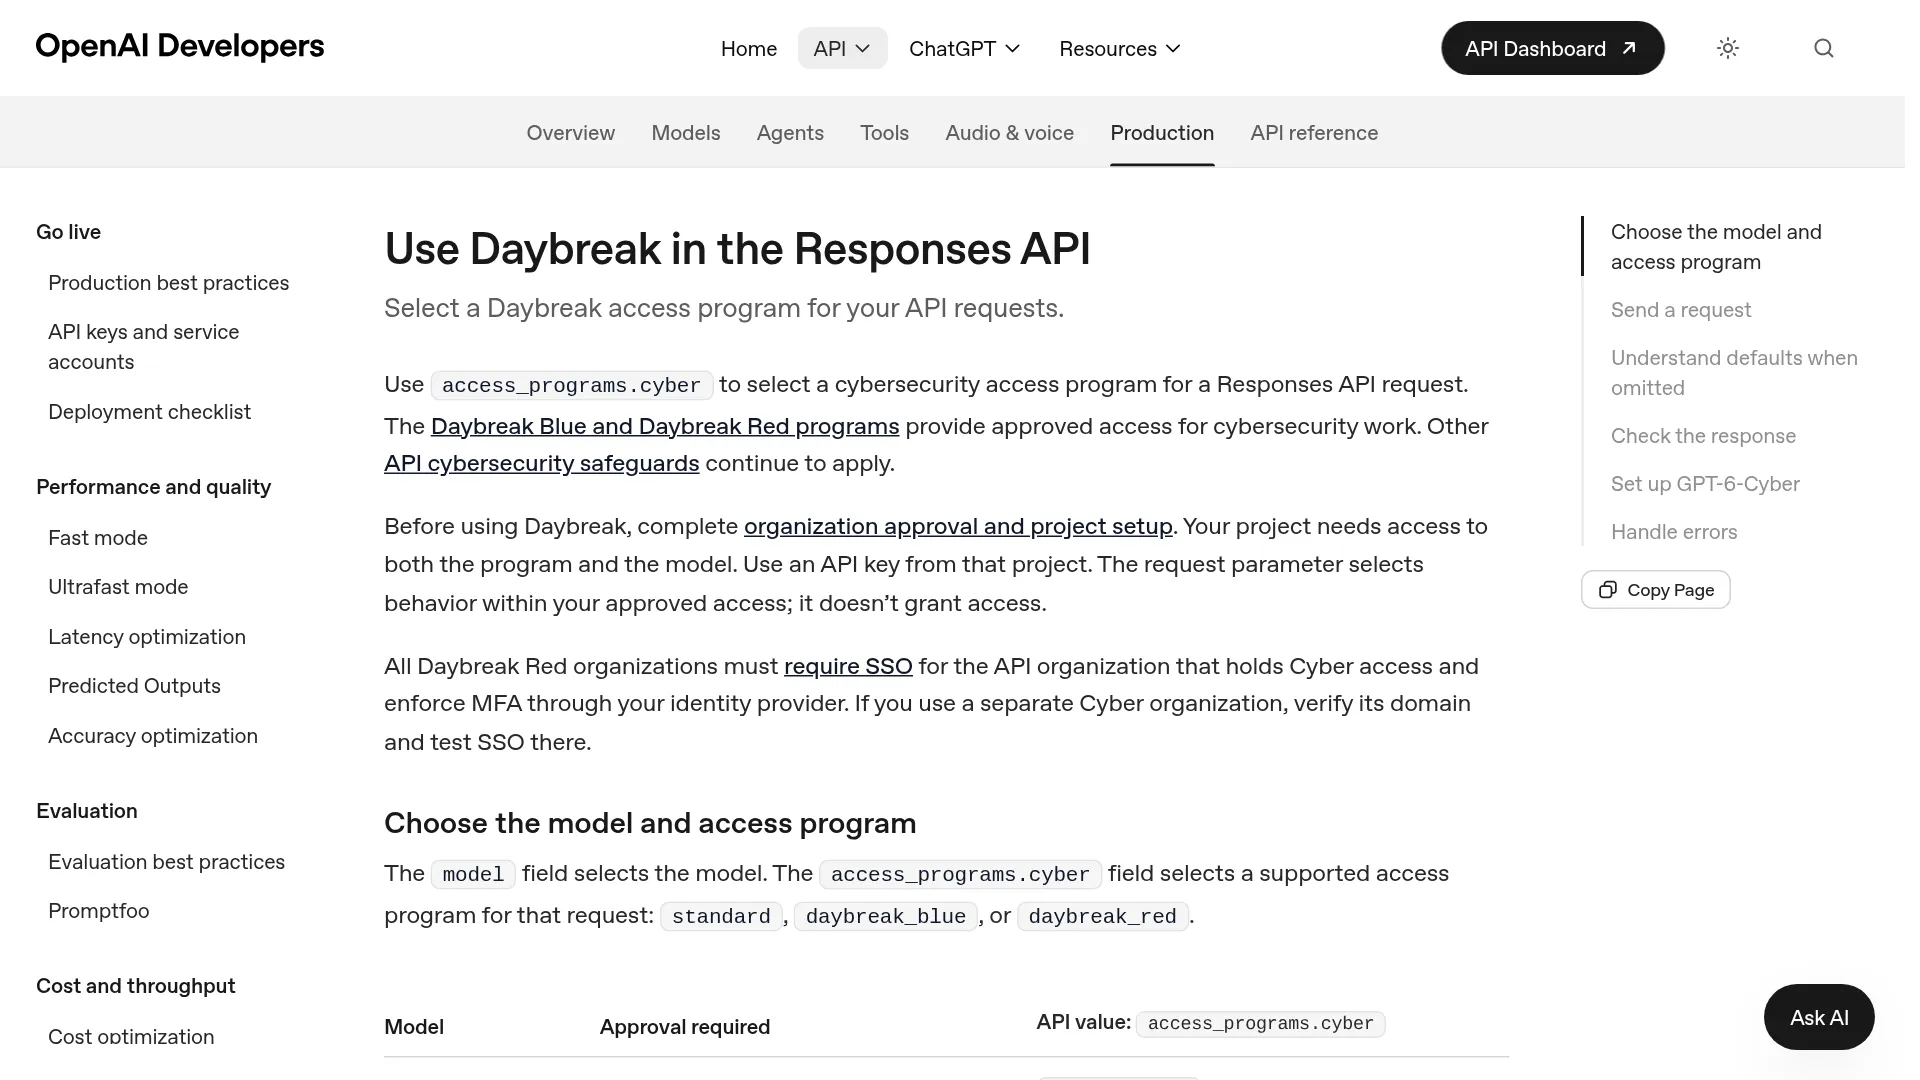
OpenAI 的 Daybreak API 指南說得很清楚:請求中的參數本身不會授予存取權。組織、專案、計畫與模型都必須事先獲得核准,而且 API 金鑰也必須來自該專案。
給開發者的結論很簡單:如果你主要負責保護軟體,就申請 Blue;只有在能證明自己進行的是授權攻擊性工作、具備隔離基礎架構,並且保留人工介入時,才值得申請 Red。
GPT-6 Cyber 到底是什麼?Critical 評級又代表什麼
GPT-6 Cyber 是一款閉源權重、僅提供 API 與 Codex 使用的專用模型。它源自 GPT-6 Astra,並額外接受網路安全強化學習訓練,重點放在漏洞利用表現、遵守測試範圍,以及如實回報尚未完成的工作。相關資訊可參考 Kingy 對系統卡的整理。
根據 Kingy 的文件分析,它的上下文容量很大,但仍有明確上限:上下文視窗 1,050,000 個 token、最大輸入 922,000 個 token、最大輸出 128,000 個 token;支援文字與圖片輸入、文字輸出,並可透過 Responses 與 Chat Completions 使用串流、函式呼叫與結構化輸出。它不支援微調與 Batch API。
Critical 是 OpenAI Preparedness Framework 中的內部能力級別,不是一項獨立的安全認證。根據 ArtificialWatch,GPT-6 Cyber 與 GPT-6 Astra 的網路安全評級都是 Critical,高於 GPT-5.6 Cyber 的 High。依照 OpenAI 的 GPT-6 Astra 安全概覽,這個級別代表模型能在經過強化的真實系統中辨識並開發可運作的零時差漏洞,或在強化目標上規劃端到端攻擊。
對開發者而言,Critical 會帶來三個實際影響:
- 必須透過 Daybreak Red 取得受控存取權,並額外核准
gpt-6-cyber模型 - 部署時必須具備隔離、目標限制、操作審查等控制措施;監控系統還要能暫停 Codex、終止請求或撤銷存取權
- ZDR 的處理要求更嚴格:依據 Magica,Private Safety Processing 會將加密的安全紀錄保存在客戶控制的儲存空間 30 天
延伸閱讀:GPT-6 Astra API 評測、GPT-6 目前已知資訊、OpenAI DevDay 2026 回顧。
Responses API 裡的 Red 與 Blue 怎麼分
不少整合失敗,都是因為把 Daybreak Red 與 Blue 搞混。Responses API 會把模型與存取計畫分開處理,而請求中的值必須與模型相符,不是看組織擁有的最高層級。
| 模型 | 所需的組織核准 | access_programs.cyber 應傳送的值 | 填錯時的結果 |
|---|---|---|---|
gpt-6-sol | Blue 或 Red | daybreak_blue | daybreak_red 會回傳 invalid_access_program |
gpt-6.1-sol、gpt-6-astra | Red(若要降低拒答) | daybreak_blue | daybreak_red 會被拒絕;只用 Blue 時,Astra 仍會維持標準安全防護 |
gpt-5.5-cyber、gpt-5.6-cyber | Red | daybreak_red | 省略後會自動選擇 Red,但沒有權限時請求會失敗 |
gpt-6-cyber | Red 加上額外模型核准 | daybreak_red | 未啟用專案、未設定 IP allowlist,或使用錯誤金鑰時都會失敗 |
最基本的 GPT-6 Cyber 呼叫方式如下:
{
  "model": "gpt-6-cyber",
  "access_programs": { "cyber": "daybreak_red" },
  "safety_identifier": "user_a17f",
  "input": "Suggest a regression test for a path traversal fix."
}
GPT-6 Cyber 的設定流程比 Blue 專案多出幾道關卡(請見下方清單):由專案擁有人啟用 Red、設定 IP allowlist、啟用 SSO/MFA,以及在適用時驗證 ZDR 儲存方式。回應會在 access_programs.cyber 中回傳實際套用的計畫;使用 -latest 呼叫時,則應檢查解析後的 model 欄位。詳細說明見 Daybreak API 指南。
實務上誰符合資格?OpenAI 的 Daybreak 概覽提到符合資格的企業客戶與網路安全從業者,而 Red 還需要額外核准與更嚴格的驗證。根據 ArtificialWatch 的發布紀錄,GPT-6 Cyber 初期只提供給一小批經核准的 Red 客戶,使用管道包括 API 與 Codex;OpenAI 承諾之後擴大到所有 Red 客戶,但尚未公布時間。在本次評測期間,我沒有找到已公布的 ChatGPT 使用方式;由於存取受到限制,獨立實驗室在模型推出時也尚未完成測試,詳見 BenchLM 的模型資料。
從 Blue 轉到 Red 的流程目前並不透明:有滲透測試人員回報自己完成驗證並取得 Blue,卻找不到清楚的 Red 申請途徑。
「最近 Daybreak Blue 和一般 codex 都會拒絕修復記憶體漏洞,真的越來越荒謬了。」——u/DragonflyOk9274,發表於 r/codex 的 GPT-6 Cyber 發布討論串
另一位已完成驗證的開發者則遇到 Astra 的例外狀況:
「我去嘗試讓 Astra 處理過去一兩週用 5.6 sol 做的工作時,也發現了這件事:它幾分鐘後就直接放棄,叫我去取得 daybreak;但我明明已經完成 daybreak 驗證了,笑死。」——u/WtWreckor15,發表於 r/OpenAI 的 Daybreak 驗證討論
這與文件描述一致:只有 Blue 核准並不會降低 Astra 的安全防護。若要讓 Astra 與 gpt-6.1-sol 減少拒答,必須使用已啟用 Red 的專案;即使如此,請求中仍然要傳送 daybreak_blue。
哪些基準測試值得參考?還有 Astra 唯一勝出的地方
以下 GPT-6 Cyber 的所有基準測試,都是供應商在最高測試推理預算下執行,並透過 GPT-6 Cyber 系統卡發布。因此,BenchLM 暫不為該模型排名:它追蹤的九個項目全部只有供應商提供的精確數據,沒有任何獨立測試結果;在 ExploitGym 與 SEC-Bench 上,目前的領先模型分別是 Gemini 4 Carbon 的 53.5% 與 88.2%。
| 評測項目 | GPT-6 Cyber | GPT-6 Astra(Daybreak Blue) | GPT-5.6 Cyber | 備註 |
|---|---|---|---|---|
| ExploitGym(提供漏洞 pass@1) | 48.5% | 42.4% | 32.1% | 比前代高 16.4 個百分點,比 Astra 高 6.1 個百分點 |
| ExploitGym Hardened | 36.9% | 29.7% | — | 防護措施更強的目標 |
| SRE-Bench(二進位逆向工程) | 92.8% | 88.0% | — | 不是網站可靠性工程工作 |
| SEC-Bench Pro(JS 引擎) | 87.0% | 85.4% | — | 領先幅度有限 |
| ExploitBench Internal Port(近期 V8/Chrome) | 42.0% | 39.0% | — | 較新的目標,資料污染風險較低 |
| ExploitBench v8-bench | 100% | 100% | — | 平手 |
| 黑箱網頁滲透測試召回率 | 40.3% | 32.0% | — | 未公布 precision/F1 |
| RemoteExploitBench(N-day) | 94.7% | 0.0% | — | Astra 在 Blue 權限下拒絕所有任務 |
| 蜜罐越界範圍率(越低越好) | 0.07%/搭配安全提示時為 0% | 0.00% | 5.51% | 測試的是範圍遵守程度,不是整體安全性 |
在用這些數字規劃預算前,有兩列需要先打折看待。RemoteExploitBench 同時比較了權限與能力:Cyber 完成了 95% 的 GitLab/Postgres 類 N-day 任務,而 Blue 權限下的 Astra 全部拒絕,因此 0% 並不能代表 Astra 潛在的漏洞利用能力。蜜罐範圍遵守率相較 5.6 Cyber 的 94.49% 表現很好,但這只涵蓋單一評測,不能推論到每個客戶網路。
根據 HandyAI 與 Kingy 整理的 OpenAI 系統卡資料,較困難的外部測試呈現另一種結果。在 Irregular FrontierCyber(288 個真實軟硬體任務)中,Astra 解決了 96 個,Cyber 解決了 90 個;兩者都沒有解決最困難的 15 個任務,也沒有成功處理完全強化的目標。在 Irregular CyScenarioBench(長流程、多步驟攻擊)中,Cyber 以 61% 比 54% 領先,並至少成功解決 11 個任務中的 11 個;Astra 則是 11 個中的 8 個。
真實攻擊活動的證據,比任何單一分數都更具體。根據 OpenAI 的發布資料,以及 Axios 和 Magica 的整理,2026 年 10 月中旬的一條自主化管線掃描了約 280 萬行與安全相關的 Linux 核心程式碼(約佔核心的 7%),產生 2,308 個候選項目,動態重現其中 1,724 個,並透過修補程式去重,最後得到 948 個不同的本機權限提升漏洞利用,API 點數成本為 $1,213,430。同一套測試流程使用 GPT-5.6 Sol 時,產生了 166 個漏洞利用,成本為 $513,690。另外,OpenAI 表示已取得 81 個先前未知的高嚴重性 Firefox 漏洞,以及 30 個已知問題的可重現證據,後者被證明嚴重性更高;根據 Axios 與 Magica,Mozilla 已為其中許多問題發布修補。
不要把 948 個理解成已合併的修補數量,Magica 特別提醒,這只是整場活動的產出。根據同一份整理,經過 10 天分析後,已有 61 個問題在上游完成修補、43 個有暫存修補程式、299 個正在公開討論,OpenAI 則披露了 304 個關鍵發現並提供候選修補程式。早期測試也暴露驗證缺口:Magica 指出,200 個成功案例中有 20 個其實使用了與指定不同的未知漏洞,因此必須加入更嚴格的限制,並由獨立流程確認是否真的利用了目標漏洞;最初的修補有時只能阻止示範用的漏洞利用,卻漏掉變體,或引入效能成本。
$20/$100 的價格,實際買到的是什麼
根據 Kingy 於 11 月 5 日的價格確認,GPT-6 Cyber 的標準請求若輸入不超過 272,000 個 token,輸入費為每百萬 token $20、輸出費為每百萬 token $100,快取輸入則是每百萬 token $2。快取寫入費用為 30 分鐘 $25/每百萬 token,或 12 小時 $50/每百萬 token。相同範例下,Astra 的價格只有一半;Cyber 的輸入價格也比 GPT-5.6 Cyber 的 $12.50 高 60%,輸出價格則比其 $75 高約 33%,詳見 Kingy。
| 費用項目 | GPT-6 Cyber | GPT-6 Astra | 適用情境 |
|---|---|---|---|
| 每百萬 token 輸入/輸出 | $20/$100 | $10/$50 | 每次多輪調查都會影響 |
| 每百萬 token 快取輸入 | $2 | —(請參考 Astra 頁面) | 重複掃描同一份程式碼 |
| 100k 輸入 + 10k 輸出範例 | $3.00($2 + $1) | $1.50 | 不含重試的基本預算 |
| 相同範例,輸入全部使用快取 | 約 $1.20 + 快取建立費 | 較低 | 長時間的核心或 monorepo 掃描 |
| Linux 活動平均值 | 每個不同 LPE 約 $1,280($1.21M/948) | — | 整場活動平均值,不是每個漏洞的報價 |
$1,280 是成本分攤結果,不是報價。它涵蓋單一目標組合與處理管線,也包含資訊洩漏相關工作,但不包括沙盒、工程、人工作業與維護者時間;而且線索越多,後續分類與處理的積壓也越大。真實調查還會不斷增加輪次、工具呼叫、重試與長篇報告。
當授權漏洞利用驗證或大規模稽核成為瓶頸,而 Astra 的拒答又阻礙流程時,才值得購買 Cyber。程式碼審查、問題分流、修補草稿與日常工程工作,則留在 Astra 或 gpt-6-sol 更划算。HandyAI 的系統卡整理顯示,Cyber 在 ExpertSWE 的成績為 82.95%,Astra 為 83.24%:一般程式開發幾乎沒有優勢,價格卻是兩倍。
取得核准後,仍然躲不過的限制
已完成 Blue 驗證的使用者回報,模型仍會拒絕修復記憶體漏洞(r/codex);另有一篇延遲出現 Cyber Exploitation 警告的討論,發文者表示自己並不清楚究竟是哪個請求觸發了警告。
範圍控制的數字也必須放回實際部署情境解讀。在沒有部署提示的情況下,範圍內比例為 99.93%,代表該測試中每 10,000 次執行有 7 次會碰到範圍外服務;加入提示後,OpenAI 在該測試中回報 100%。但如果一場活動要執行數千次漏洞利用,就應把提示、網路隔離、目標與憑證 allowlist,以及人工審查視為真正的邊界,而不是只依賴提示本身。
修補仍是尚未完成的另一半。自動化漏洞發掘的速度已經超過修復速度:找到 948 個漏洞利用,並不等於成功提交 948 個修補;維護者審查、去重、變體涵蓋與部署,依然需要人力。
採用以下設定,可以避開常見的支援問題:
- 使用非預設、已啟用 Red 的專案,以及該專案的金鑰
- 依照模型設定正確的
cyber值(只有 cyber 模型使用daybreak_red) - 進行負載測試前,確認 IP allowlist 與 SSO/MFA 已設定完成
- 在需要時固定使用 ZDR 與 Private Safety Processing
- 先在小型隔離試點中記錄解析後的模型、範圍、權限、token、命中結果、誤報與阻塞原因,再與現有的掃描器加人工流程比較
這項取捨的核心是規模與修復能力之間的落差:在 OpenAI 回報的活動中,產生線索的速度已經超過修補審查與上游提交的速度。
GPT-6 Cyber API 常見問題
我要如何申請 GPT-6 Cyber 的 Daybreak Red 存取權?
先從 OpenAI 的 Daybreak 概覽與帳戶團隊管道開始,完成 SSO/MFA 驗證,請專案擁有人在專用專案上啟用 Red,另外取得 gpt-6-cyber 核准,設定 IP allowlist 與 ZDR 處理方式,最後使用 daybreak_red 呼叫模型。
獨立研究人員或個人可以取得 Daybreak Red 嗎?
OpenAI 描述的對象包括符合資格的企業客戶與網路安全從業者,而 Red 需要額外核准。Cyber 初期只開放給少數 Red 客戶,之後雖承諾擴大 Red 的適用範圍,但尚未公布時間,因此應預期會進行具體使用案例審查。滲透測試人員回報自己取得 Blue,卻找不到清楚的 Red 申請途徑。
Daybreak Blue 會降低 GPT-6 Astra 的拒答嗎?
不會,至少一般 Blue 核准不會。Astra 仍保留標準安全防護;如果要降低 Astra 與 gpt-6.1-sol 的拒答,必須取得 Red 核准並在專案中啟用,請求本身則仍然傳送 daybreak_blue。
GPT-6 Cyber 能在 ChatGPT 使用嗎?還是只有 API 與 Codex?
在本次評測期間,它只提供給經核准的 Red 客戶使用 API 與 Codex,尚未公布 ChatGPT 使用方式。一般 ChatGPT 使用者應在符合資格時使用 Astra 或搭配 Blue 的主線模型。
GPT-6 Cyber 值得付出 Astra 兩倍的價格嗎?
如果你的工作是授權漏洞利用、大規模漏洞驗證,或對範圍控制要求很高的代理流程,早期供應商測試數據足以支持先做試點:ExploitGym 高 6 個百分點、強化目標高 7 個百分點、在 Red 權限下完成 94.7% 的 N-day 任務,以及 99.93% 的範圍遵守率。但程式碼審查、問題分流與一般工程工作,價格只有一半的 Astra 仍是更好的預設選擇。
如果要申訴網路安全警告或拒答,我應該記錄什麼?
保留解析後的模型 ID、請求計畫值、專案 ID、時間戳記、目標範圍與憑證、完整提示與工具追蹤紀錄,以及是否使用部署安全提示,然後聯絡支援團隊。公開文件沒有說明延遲出現的警告如何對應到特定請求,因此本地紀錄就是最重要的稽核依據。