 AIREITER
「cinematic」と一言書くだけでは、モデルが空白を好きなように埋めてしまいます。カメラの指示やプロバイダー側の推奨構文を省けば、固定カメラの映像になりやすく、音声フィールドを指定しなければ、意図しないセリフが入り込むこともあります。MiniMax H3のプロンプトは、短い映像台本を書く感覚に近いものです。公式ガイドでは、ショットのタイムスタンプ、安定した話者ID、2つの専用サウンドフィールドを備えた3フィールド構成が定められています。プロンプトはプロバイダーによって異なりますが、おおむね7,000文字の上限に収める必要があり、クリップの長さは15秒までです。
まずはH3のプロンプト形式を選ぶ:2つのガイドと4つのモード
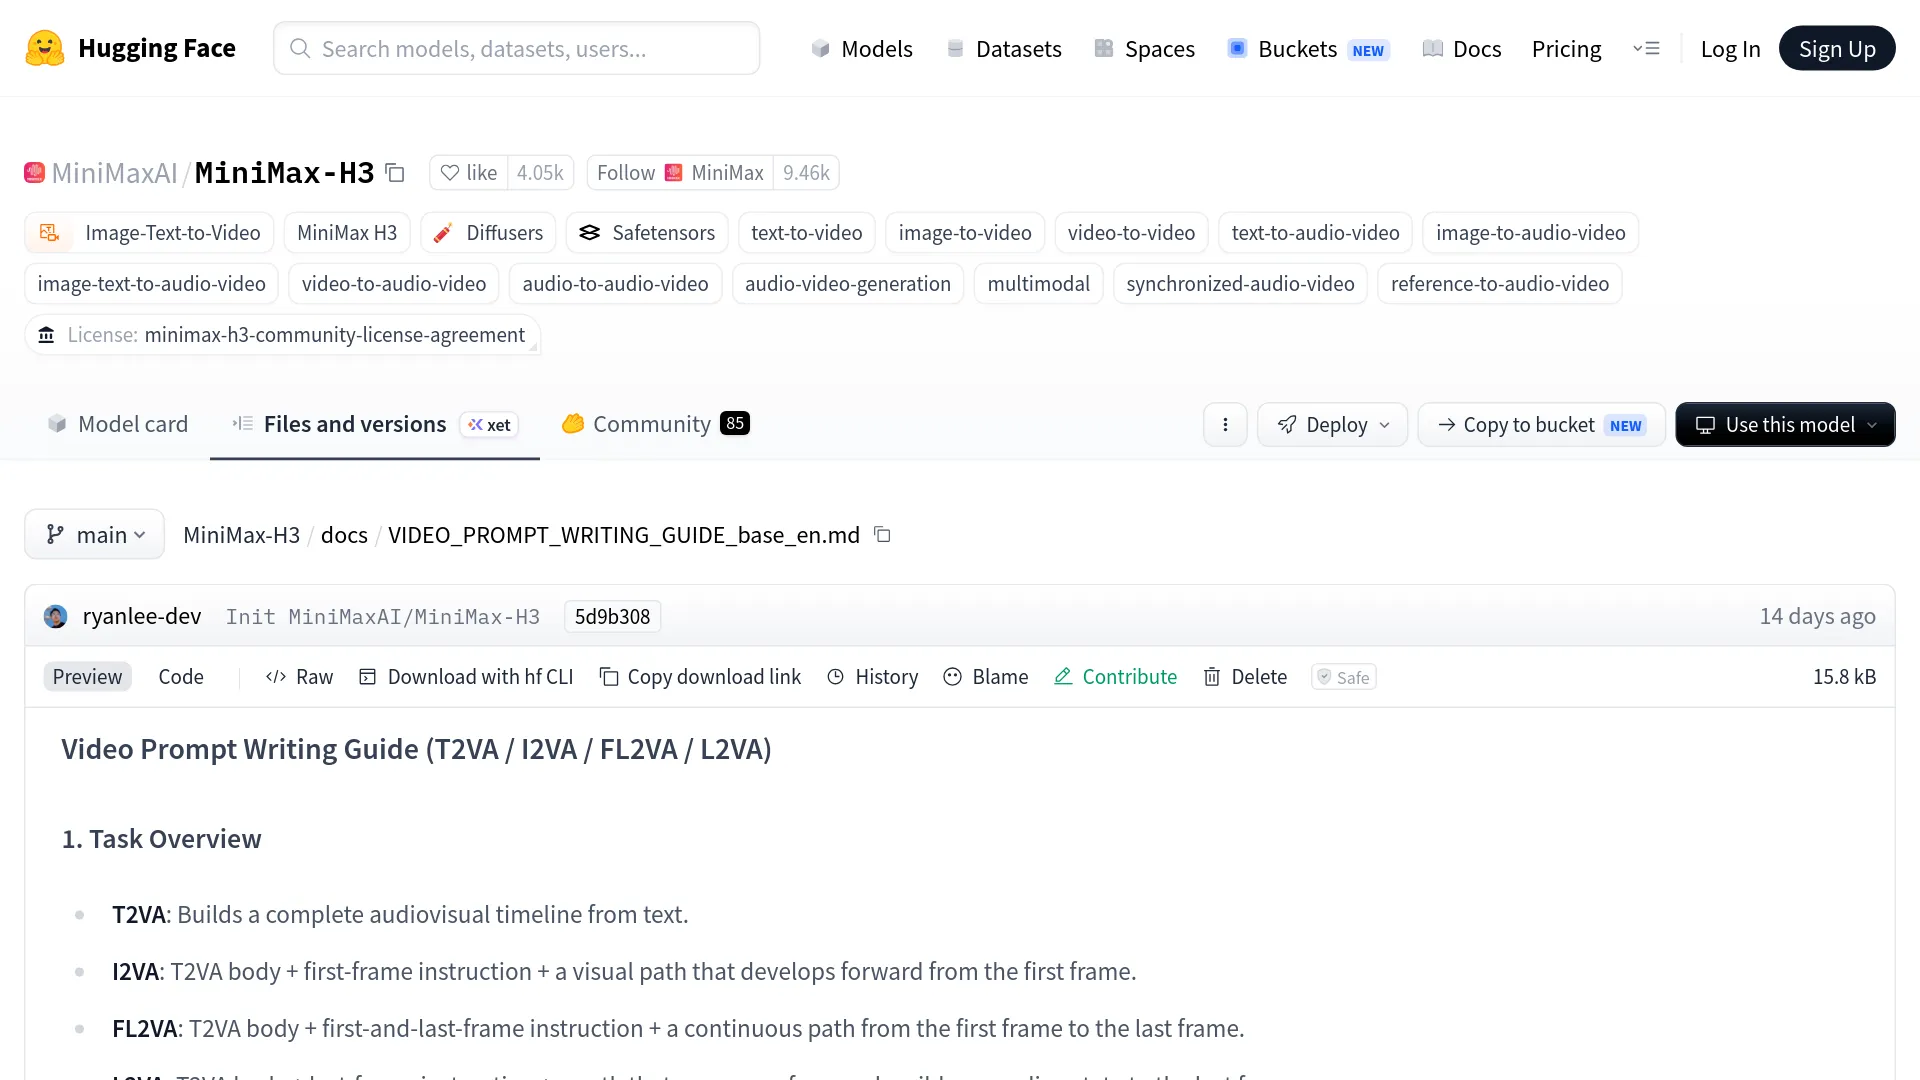
MiniMaxは、Hugging FaceのMiniMax-H3リポジトリで、プロンプト作成に関する2種類のガイドを公開しています。両者は想定するワークフローが異なります。base guideは、アップロードした参照素材を使わない4種類の生成タスクを扱います。一方、画像、動画、音声のいずれかを参照素材として使う場合はreference guideを使います。base guideの4つのモードは次のとおりです。
| モード | 入力 | プロンプトに必要な整合性指定 |
|---|---|---|
| T2VA | テキストのみ | なし。基本フィールドから直接書き始める |
| I2VA | 最初のフレーム画像1枚 | 「Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]」 |
| FL2VA | 最初と最後のフレーム | Picture 1を0.00秒、Picture 2を動画の正確な終了時刻に対応させる |
| L2VA | 最後のフレーム画像1枚 | Picture 1を動画の終了時刻と最後のショットに対応させる |
どちらのガイドにも完成例が掲載されています。MiniMaxのローンチ記事でも、モデルはタスクをメニューから選ぶのではなく、テキスト、画像、動画、音声の関係をプロンプトで指定するものとして説明されています。ホスト型エンドポイントでは、minimax/h3/text-to-video、image-to-video、falのreference-to-videoという3つのワークフローに整理されていますが、土台となるプロンプト構造は変わりません。
baseプロンプトを行ごとに理解する
MiniMax H3のbaseモードでは、整合性指定が必要な場合はそれを先頭に置き、その後に3つの必須フィールドを空行で区切って記述します。基本形は次のとおりです。
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_descriptionはタイムラインを担当します。映像スタイル、構図、動作、ショット変更、話者、セリフ、劇中音など、画面に見えるものと聞こえるものをすべてここに記述します。overall_soundscapeは、環境音や物理音を1~4文、1段落でまとめるフィールドです。セリフは含めません。non_diegetic_musicは、登場人物には聞こえない劇伴を1~3文で指定します。音楽が不要ならN/Aとします。
公式ガイドのT2VA例(夜明け前のベーカリー)をもとにした記述例です。
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
公式ルールに沿って、各行が制御する内容を整理すると次のようになります。
| プロンプト要素 | 制御する内容 | ルール |
|---|---|---|
[Shot 1] Live-action, cinematic. | 全体のスタイル | スタイルラベルはShot 1の冒頭に置く。ガイドにある例(一部)はCinematic、live-action、2D-animated、3D CG、claymation、watercolor、vintage film |
A middle-aged baker (S1), grey apron, rolled sleeves | 話者の識別 | IDの前に人物の属性を書く。ショットが変わってもIDは維持する |
The camera pushes in with small amplitude at slow speed | カメラ | 動きの種類、振れ幅、速度を自然な動作として記述する |
<d>[English] First batch of the day.</d> | セリフ | 言語タグと正確なセリフだけを書く。逐語のままとし、翻訳しない |
At 00:05.000, the camera cuts to... | カット時刻 | 時刻は必ず昇順にする。[Shot 1]自体にはタイムスタンプを付けない |
<scenetrans> continuing seamlessly across the cut | 音声の連続性 | カットをまたぐセリフを示す。接続する両方の箇所に記述する |
ショット、カット、カメラワークの指定方法
MiniMax H3のショット構文には明確な位置ルールがあります。[Shot 1]にはタイムスタンプを付けず、2つ目以降のショットはAt 00:03.500,のように、必ず増加するカット時刻から始めます。カットの表現は「the camera cuts to」「the shot transitions to」「the shot switches to」のような簡潔なものが推奨されています。クロスディゾルブ、フェード、ワイプを使う場合は、明示的に指定してください。フレーミングが少し変わるだけならカットではなくカメラ移動を使います。カットは、新しい被写体、空間、状態、または時間の情報を導入する場合に使うものだからです。
カメラの動きは、自然な英語の動作として、最大3つの要素で書きます。動きの種類、振れ幅、速度です。
| 要素 | 使用できる表現 |
|---|---|
| 動きの種類 | Zoom In/Out、Push In/Pull Out、Pan Left/Right、Truck Left/Right、Tilt Up/Down、Pedestal Up/Down、Arc Shot、Tracking Shot、Static Shot、Shake Slightly/Strongly、POV、Roll Clockwise/Counterclockwise |
| 振れ幅 | 「with small amplitude」、「with large amplitude」 |
| 速度 | 「at slow speed」、「at fast speed」 |
中程度の振れ幅と通常速度は、慣例として省略します。なお、「Zoom In」はカメラ位置を固定したまま焦点距離を変える動きです。「Push In」はカメラ自体が前進します。ガイドがこの2つを区別しているのは、その意味が異なるためです。
セリフと話者ラベルの正しい付け方
MiniMax H3のプロンプトでは、声を発するキャラクターごとに(S1)、(S2)のような安定したIDを割り当てます。同時に話す場合は(S1,S2)のような複合IDを使い、ショットが変わっても同じIDを維持します。話さないキャラクターにはIDを付けません。話者が初めて登場する場面では、画面内か画面外か、年齢層、性別、声の高さ、声質、話す速度、アクセントなど、生成を安定させるための情報を十分に指定します。
1行の基本構文は次のとおりです。
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>典型的な失敗を防ぐポイントは4つあります。人物の属性、動作、話し方は<d>の外に置き、タグの中には言語タグと正確なセリフだけを入れます。ボイスオーバーを指定する場合は、文字どおり「says in an off-screen voiceover」と書き、その直後に、画面内のキャラクターの唇は閉じたままだと説明します。カットをまたぐセリフには、接続する両方の箇所に<scenetrans>を置き、「continues seamlessly across the cut」や「carries over from the previous shot」のような連続性の表現を加えます。動画の終端でセリフを途切れさせる場合は<cutoff>を使います。
引用符には、ひとつだけ決められた用途があります。看板、標識、ラベル、ネオン、字幕など、映像内に表示される文字を英語のダブルクォーテーションで囲み、原文のまま記述することです。話し言葉を引用符で囲むと、H3が音声ではなく画面に焼き付けられた字幕として描画する原因になります。
2つのサウンドフィールドを使い分ける
MiniMaxのローンチ記事によると、H3の音声出力はすべてネイティブステレオで、映像と同時に生成されます。そのため、音声は形容詞で済ませず、2つの専用フィールドに分けて指定します。overall_soundscapeには、風、雨、交通、足音、衣擦れ、衝撃音、呼吸、笑い声などの環境音や物理音を1~4文で書きます。完全な無音を明示的に求める場合だけN/Aを使います。non_diegetic_musicには、登場人物には聞こえない劇伴を指定します。楽器編成、速さ、リズム、音量の変化を具体的に書き、「epic」「emotional」のような抽象的なムード表現は避けます。音楽を入れたくない場合の値はN/Aです。
歌、劇中のラジオ、路上ミュージシャンなど、世界の中で鳴っている音はどちらのフィールドにも入りません。タイムラインを記述するintegrated_multimodal_descriptionに書きます。この分離は見た目だけのルールではありません。APIMODELSの解説でも、安定した結果には明示的な音声制約が必要だと説明されています。non_diegetic_musicを曖昧にしたままだと、指定していない音楽が加わる可能性があります。
参照プロンプトの書き方:ラベルと保持指定
アップロードした素材を生成に使う場合は、reference guideの出番です。このガイドでは、subject_definitions、summary、retention_analysis、detailed_description、overall_soundscape、non_diegetic_musicの6セクションを、この順番で記述する必要があります。生成タスクでは、通常detailed_descriptionを英語350~500語でまとめます。ただしセリフが多い場合は、語数よりも、発話全体が収まることを優先します。
役割を担うラベルは4種類です。
| ラベル | 用途 |
|---|---|
<Subject N> | 出力で実際に使う画面上の要素。素材から抽象化した人物、製品、シーン、衣装、スタイル、動作など |
<Picture N> | 具体的なフレームの基準となる画像。最初のフレーム、キーフレーム、最後のフレーム、構図の基準など |
<Video N> | 動画全体との関係。編集元、続きの起点、カメラやカット構造、リズムなど |
<Audio N> | コピーまたは参照する音声信号。声質、歌詞、ビート、効果音など |
番号はラベルの種類ごとに独立しています。したがって、アップロードした動画を<Video 1>、その音声トラックを<Audio 2>とすることもできます。話す人物には、ラベルと話者IDを組み合わせて<Subject 3> (S1)のように書きます。
summaryは、[reference generation]や[video editing + audio reuse]のような角括弧付きのタスク接頭辞から始めます。動画編集の場合は、「The target video is an edited version of <Video 1>.」で書き始める必要があります。続くretention_analysisでは、各ラベルに保持方法を1つ割り当てます。映像にはfully_preserved、partially_preserved、attribute_transfer、weak_referenceを使い、音声にはfully_copy、partially_copy、reference、weak_referenceを使います。顔は維持しつつ服装は変える、といった指示をH3に伝えるのがこの指定です。
公式ドキュメントの順序に沿った、参照モードの最小構成は次のとおりです。
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
H3の挙動がおかしいときの症状別チェック
| 症状 | 考えられる原因 | 対処法 |
|---|---|---|
| 意味不明な音声や、いわゆる「Sims語」 | セリフが構造化されていない、話者IDがない、話さない人物の説明がない | (S1)/(S2)のIDを追加し、正確なセリフを<d>[Language] ...</d>で囲む。無言の人物は話さないと明示する |
| セリフが焼き付け字幕になる | 話し言葉を引用符で囲んでいる | 引用符は画面に表示する文字だけに使い、セリフは<d>タグへ移す |
| 別のキャラクターにセリフが割り当てられる | 話者IDと人物の説明が結び付いていない | 初登場時に年齢、画面内かどうか、声などの属性を加え、ショットをまたいでもIDを維持する |
| 指定していない劇伴や音楽が入る | non_diegetic_musicが曖昧、または未指定 | 音楽を不要にする場合はnon_diegetic_music: N/Aと書く。コミュニティでも不要な音声を止める方法として評価されている |
| 意図しないカットが入る | タイムスタンプなしでシーン変更を示している | [Shot N] At 00:03.500の形式で明示的なカット表現を使う。ワンカットなら「no cuts」と指定する |
| 顔、服装、製品の見た目が変化する | 参照素材の役割を指定していない | 該当ラベルにfully_preservedを指定したretention_analysisの行を追加し、登場するたびにラベルを繰り返す |
文字化けと字幕に関する項目は、公式の構文ルールに基づいています。r/StableDiffusionのコミュニティでも、同じ対処法が実際に効果を上げたと報告されています。なかでも、不要な音声を抑える方法としてnon_diegetic_music: N/Aが頻繁に挙げられています。
生成上限と、検証にかかる料金
プロンプトは無限に長くできず、生成のたびに料金も発生します。公式APIとホスト型プロバイダーで確認できる制限は次のとおりです。
| 項目 | 値 | 注記 |
|---|---|---|
| クリップの長さ | 最大15秒、整数秒 | fal/EvoLinkエンドポイントでは最小5秒。一部のV2 APIドキュメントでは4秒と記載 |
| 解像度 | 768pおよび2K、24 FPS | MiniMaxによると、デフォルトの出力解像度は2K |
| 参照ファイル | 画像最大9枚、動画3本、音声3個 | 合計12ファイル。音声だけを参照素材にすることはできない |
| プロンプト長 | 約7,000文字 | falおよびV2 APIのドキュメントによる値。APIMODELSは20,480と記載しているため、プロバイダーを確認する |
| アスペクト比 | 21:9、16:9、4:3、1:1、3:4、9:16、adaptive | Image-to-videoでは入力画像の比率に従う |
料金はプロバイダーによって変わるため、以下は定価ではなく、その時点でのスナップショットとして見てください。falでは、8月1日時点の料金スナップショットで、2K生成は1秒あたり0.26ドルでした。5秒で1.30ドル、15秒で3.90ドルです。最初の5枚の参照画像は無料で、追加画像は1枚0.08ドルです。APIMODELSでは、H3は1秒あたり0.088ドルで、15秒クリップは1.32ドル。成功したリクエストだけに課金されます。同じマーケットプレイスにおける、1秒あたりの料金は次の画像のとおりです。
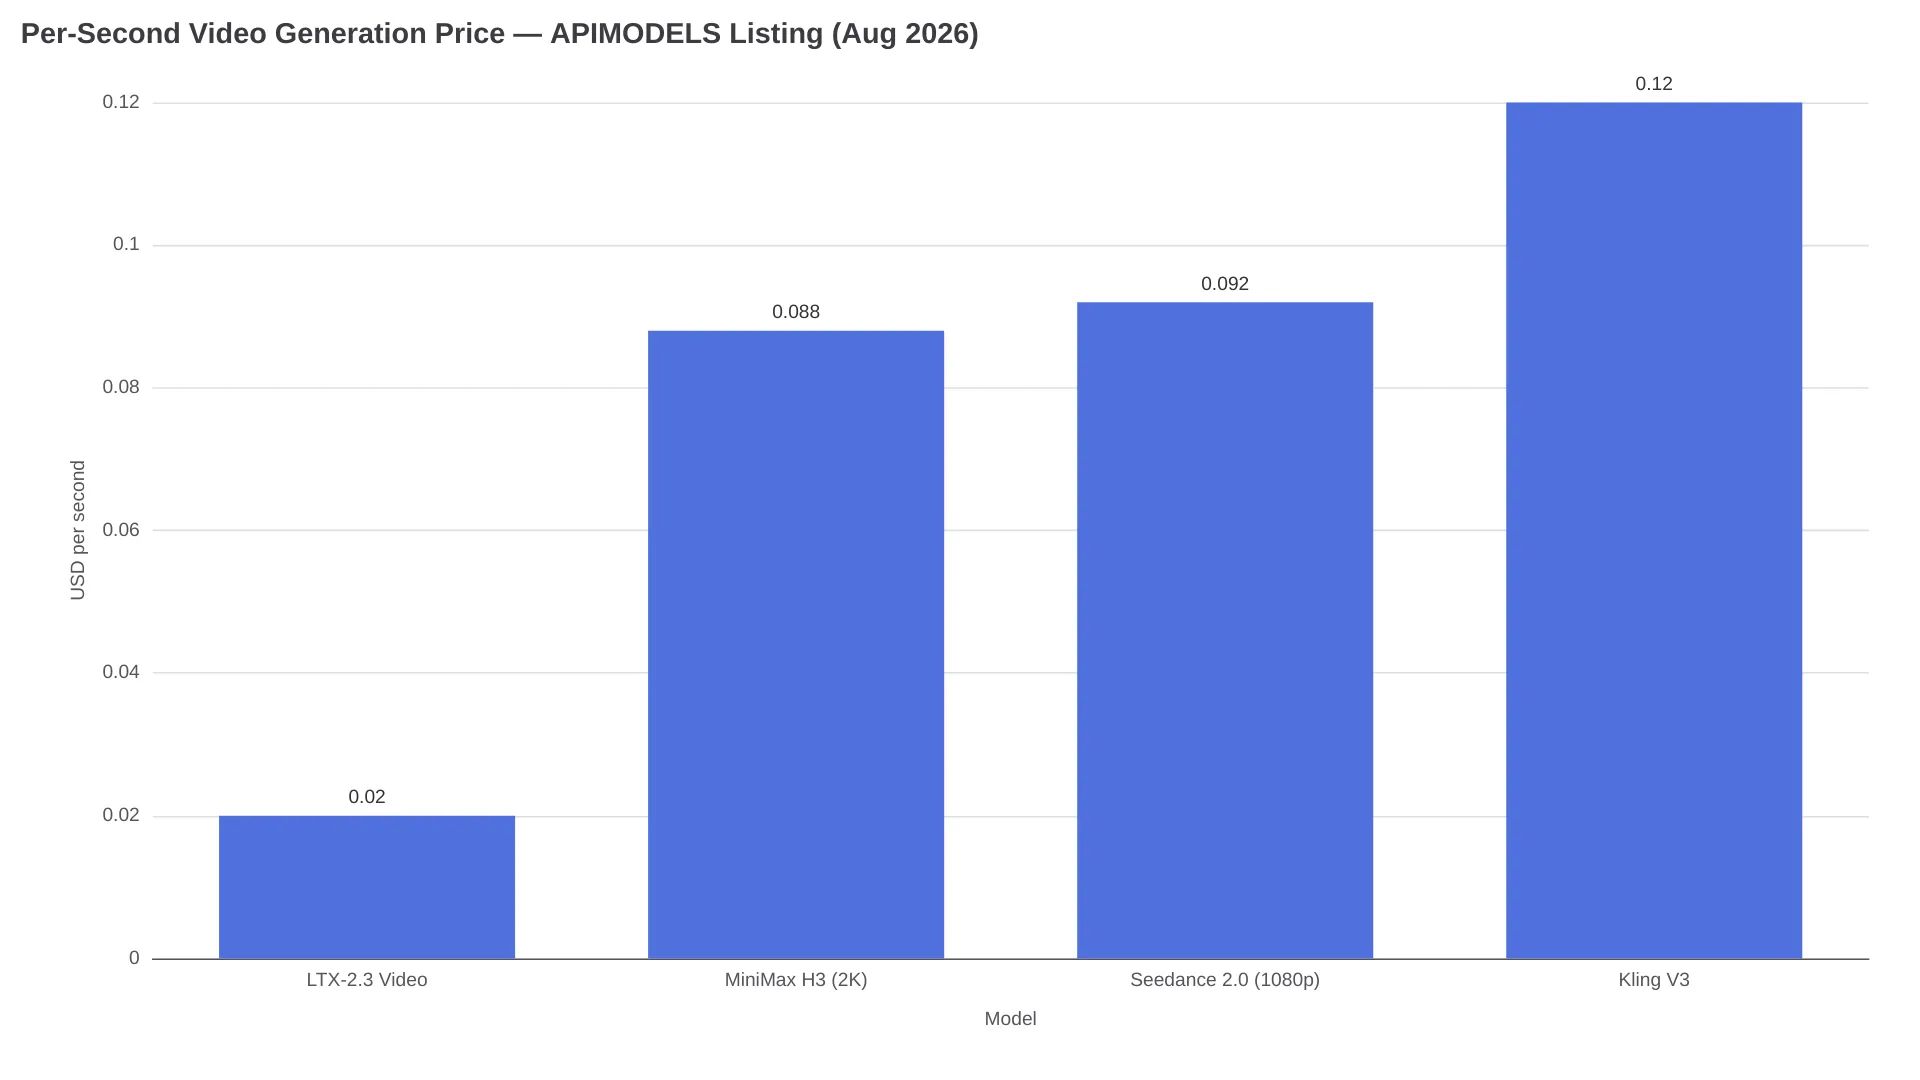
実際の予算を左右するのは、リトライ回数です。構造化した15秒の会話プロンプトが2回目で完成した場合、APIMODELSでは2.64ドル。一方、構造化されていないプロンプトで使えるテイクを得るまで5回かかれば、6.60ドルになります。ホスト型のH3エンドポイントでプロンプトを試すなら、AIReiterのMiniMax H3 APIページで、ページ上の最新料金を確認しながらモデルを実行できます。
そのまま使えるスタート用テンプレート
短尺動画の多くは、次の2つのbaseテンプレートから始められます。角括弧の部分を埋め、フィールド名と空行はそのまま残してください。
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/A空欄を埋めた完成プロンプトを探しているなら、ソースへのリンクを保った3つのライブラリが役立ちます。ecomimagelab/awesome-minimax-h3-promptsには58個のプロンプト(公式39、コミュニティ検証済み19)があり、すべてダウンロード可能な結果動画付きです。「No video, no entry」という方針で運営されています。imagineVid/Awesome-minimax-h3-prompts-and-skillsには、オムニリファレンスによる人物の一貫性からネイティブ音声の会話まで、6つのワークフローにまたがる検証済み事例が28件あります。APIMODELSのギャラリーでは、用途別に226個のプロンプトを閲覧でき、クリップも添付されています。ここでの基本方針は「References carry identity, the prompt carries action.」です。
台本そのものを作る方法も2つあります。Redditユーザーの報告によれば、公式ガイドをLLMに貼り付け、「このアイデアをbase guideを使ったT2VAに書き換えて」といった具合にモードを指定すると、安定した結果が得られます。ComfyUI向け拡張のMiniMax H3 Prompt Writer v0.3を使えば、ノードベースのワークフロー内で構造化フォーマットを組み立てることもできます。
FAQ
MiniMax H3のbaseガイドとreferenceガイドは何が違いますか?
base guideは、参照素材を使わない4つのモード(T2VA、I2VA、FL2VA、L2VA)を、3つの基本フィールドで構成します。reference guideでは、アップロードした画像、動画、音声が生成に影響する場合に、6つの必須セクションと<Subject>/<Picture>/<Video>/<Audio>ラベルを追加します。
MiniMax H3のプロンプトで話者を指定するには?
最初に声を発する順に、(S1)、(S2)のような安定したIDを割り当てます。ショットが変わっても同じIDを使い、同時に話す場合は(S1,S2)とします。<d>タグの中に入れるのは、言語タグと正確なセリフだけです。
MiniMax H3で意味不明な音声が出るのを止めるには?
話者IDと逐語の<d>タグでセリフを構造化し、話さないキャラクターは無言だと明記します。劇伴が不要ならnon_diegetic_music: N/Aと指定してください。公式ルールとコミュニティの双方で確認されている対処法です。
MiniMax H3のセリフは引用符で囲むべきですか?
いいえ。引用符は映像内に表示される文字専用です。話し言葉は<d>[Language] ...</d>に入れてください。そうしないと、H3がセリフを画面上の字幕として描画する可能性があります。
MiniMax H3のプロンプトはどのくらい長くできますか?
falと公式V2 APIのドキュメントでは約7,000文字です。一方、APIMODELSは20,480文字と記載しています。10,000文字の台本を書く前に、利用するエンドポイントの上限を確認してください。
構文だけでは解決できないこと
プロンプトを構造化すると成功率は上がりますが、生成結果が決定論的になるわけではありません。人物の完全な同一性、ロゴ、製品の再現性は依然として確率的です。コミュニティ製のAPIラッパーも、フレーム単位の一貫性は保証できないと明記しています。優れたプロンプトライブラリの例でも、アイデンティティを維持するために長い制約ブロックを使っているだけで、測定済みの保証をしているわけではありません。非言語音を表すインラインの<tags>はコミュニティによる実験段階で、生成結果によって効果が変わります。評価するときは、1リクエストあたりの料金ではなく、承認できる1秒あたりのコストで判断しましょう。プロンプトを書く際は、公式のbase guideとreference guideをブラウザーのタブで開いておくと便利です。
関連記事:MiniMax H3のリリース概要ではモデルの概要を、MiniMax H3とLTX 2.3の比較では、1秒あたりの料金が最も安い選択肢との違いを解説しています。