 AIREITER
コーディングエージェントは、コンテキストが料金区分をまたいだ瞬間や、推論用の予算で出力上限を圧迫した瞬間に、見かけの安さが崩れます。Grok 4.6とOpus 5で迷ったら、プロンプトが200Kトークン未満のコスト重視の用途はGrok 4.6。1Mトークンのコンテキスト、128Kトークンの出力、あるいはドキュメント化されたエージェント制御が要件ならClaude Opus 5です。
まずは、どれだけの仕事をさせるかで決める
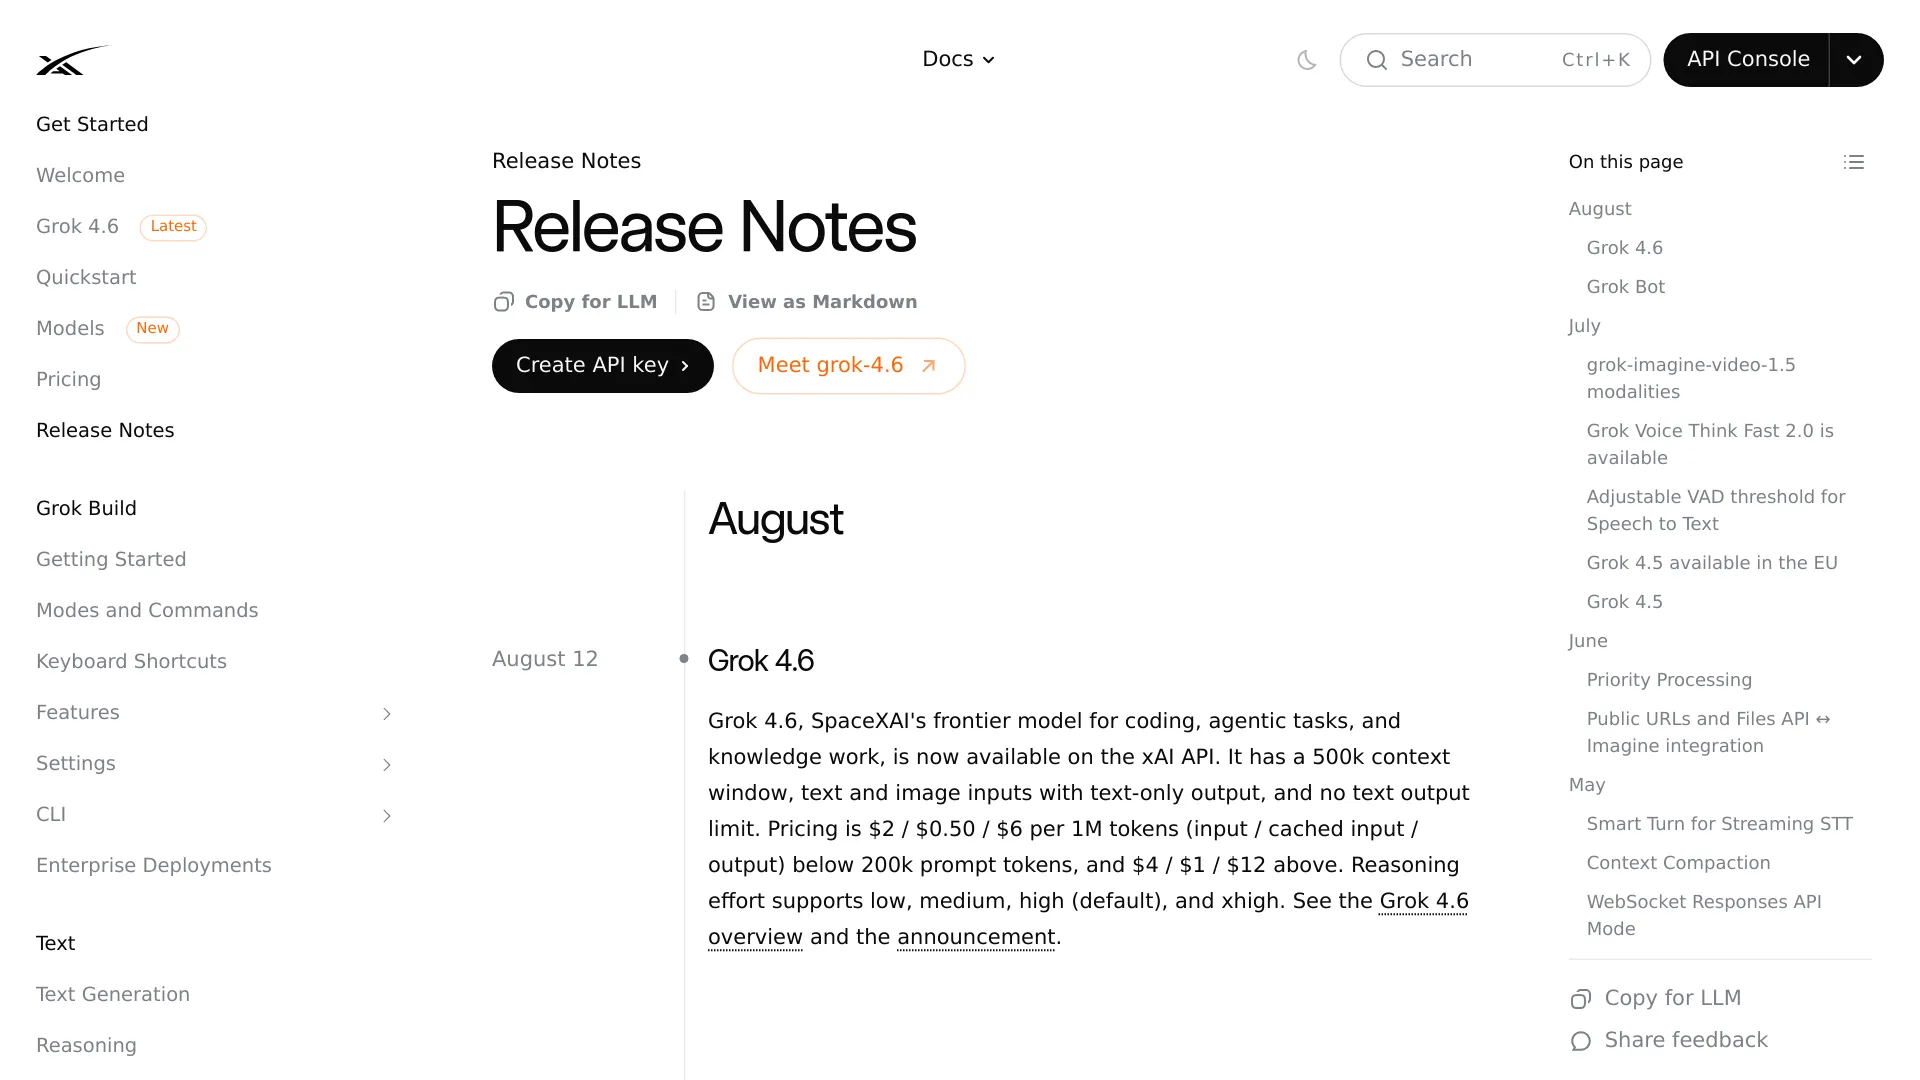
テキストを生成するコーディングエージェントやナレッジワークのエージェントが、通常200Kプロンプトトークン未満に収まるなら、Grok 4.6が現実的な標準選択です。xAIは2026年8月12日付のリリースノートで、500Kのコンテキストウィンドウ、テキストと画像の入力、テキスト出力、lowからxhighまで4段階のeffort設定を示しています。仕様を確認する際の一次情報はxAI's developer release notesです。
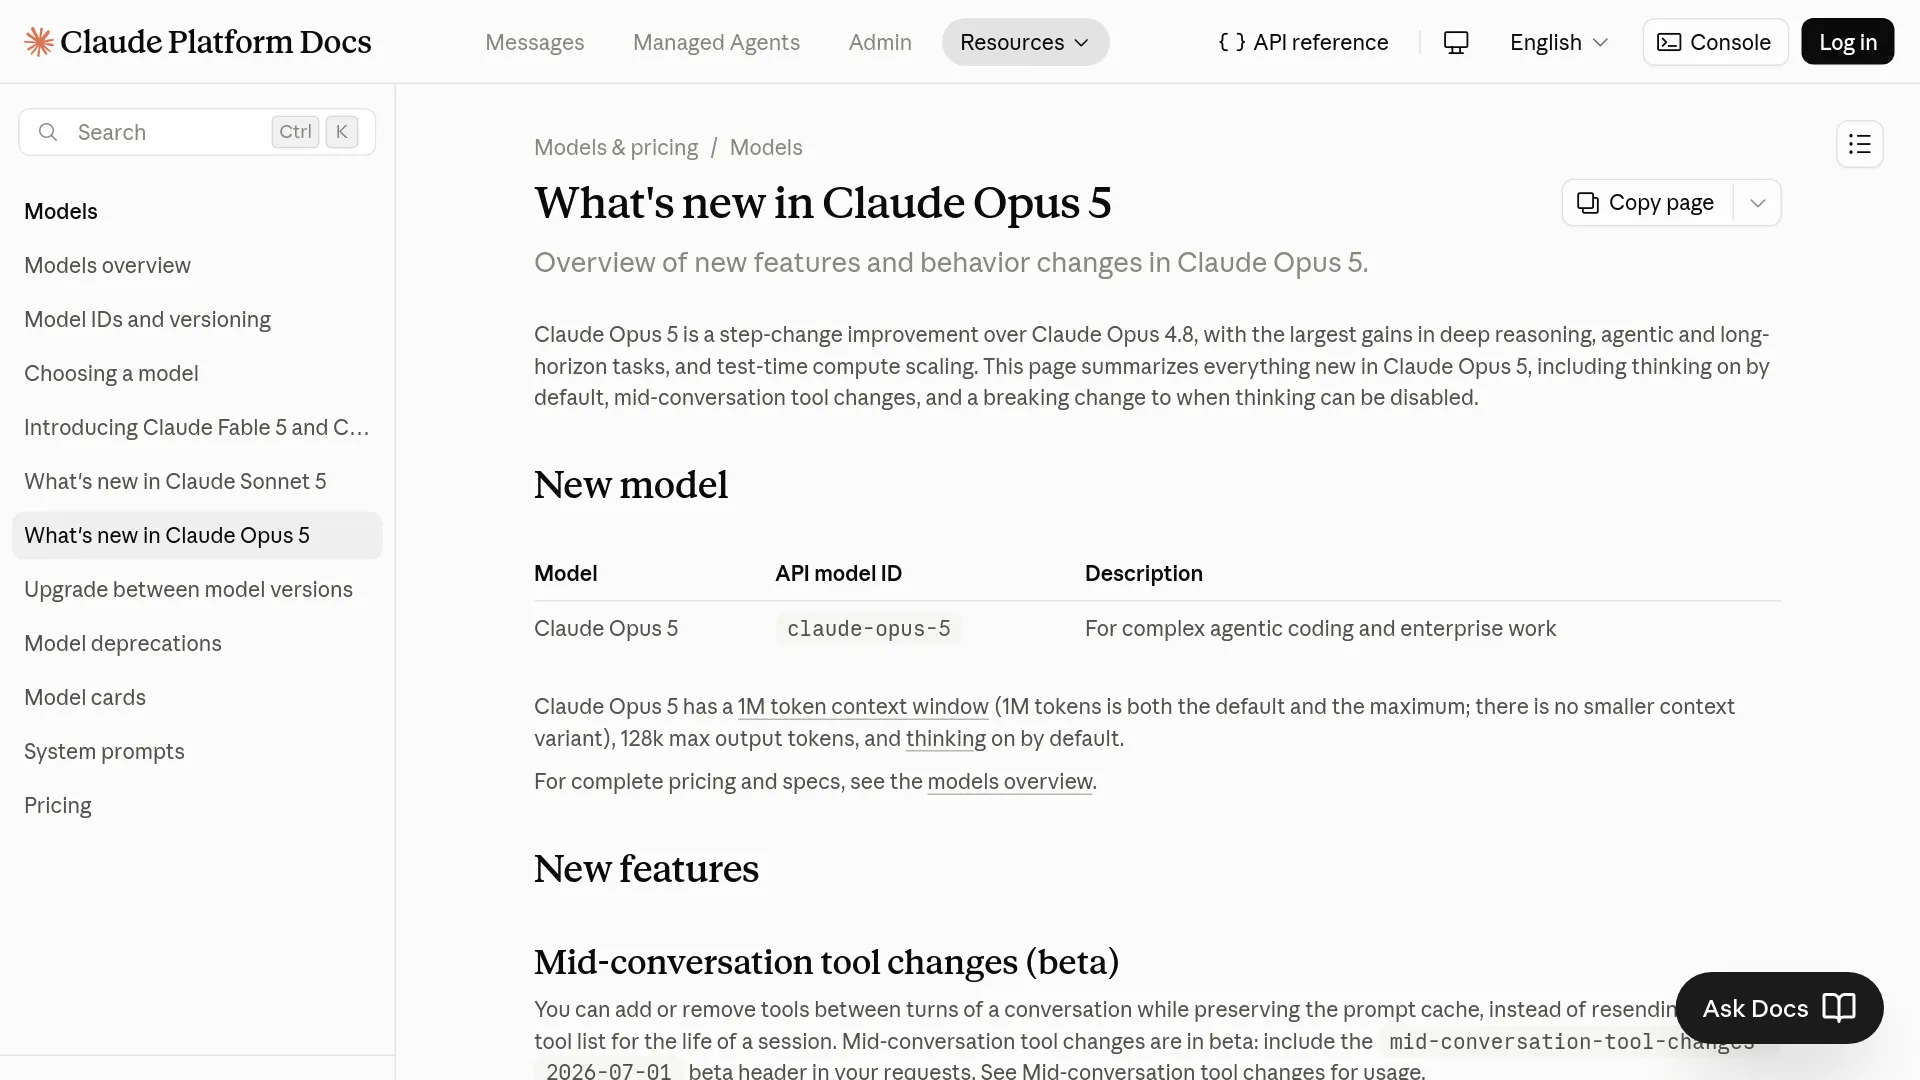
500Kトークンでは足りない、最大128Kトークンの出力が必要、あるいはAnthropicのフォールバックや動的なツール一覧機能に依存するワークフローなら、Claude Opus 5のほうが適しています。Anthropicは、デフォルトかつ最大1Mトークンのコンテキストウィンドウ、デフォルトで有効になるthinking、APIと主要クラウドパートナーでのclaude-opus-5の提供を案内しています。ここでは、小さなベンチマーク差よりもClaude Platform's Opus 5 documentationのほうが、導入判断に大きく影響します。
ここで参照している資料には、あらゆるコーディング作業を一律に決着させる共通ベンチマークはありません。最大プロンプトサイズ、必要な出力長、ツールの契約、そしてタスク完了までのコストを、自分の評価環境で測るところから始めてください。
スコアを見る前に、APIの制約を1枚にまとめる
Grok 4.6とClaude Opus 5はいずれも、テキストと画像を受け取り、テキストを生成します。比較で重要になるのは、コンテキスト容量、長いプロンプトの料金、出力の扱い、そして統合時の制御機能です。
| APIの項目 | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| コンテキストウィンドウ | 500Kトークン | 1Mトークン |
| 入力モダリティ | テキスト、画像 | テキスト、画像、Anthropicが説明するPDF/ドキュメントワークフロー |
| 出力モダリティ | テキスト | テキスト |
| 最大テキスト出力 | xAIのリリースノートに数値上限の記載なし | 128Kトークン |
| Effort設定 | low、medium、high、xhigh | low、medium、high、xhigh、max |
| デフォルトのeffort | high | high |
| 標準入力料金 | $2/M tokens | $5/M tokens |
| 標準出力料金 | $6/M tokens | $25/M tokens |
| 長いプロンプトのルール | プロンプトが200Kトークンを超えると、入力は$4/M、出力は$12/M | Opus 5のリリースドキュメントに同等のしきい値の記載なし |
| キャッシュ入力 | 200K未満は$0.50/M、200K超は$1/M | キャッシュ可能なプロンプトは512トークン以上。キャッシュ料金は別途記載 |
表示上の単価はGrok 4.6のほうが低いものの、プロンプトが200Kトークンを超えると料金は2倍になります。Opus 5は高価ですが、ワークフローで必要になるなら、1Mのコンテキストによって分割処理や検索のオーバーヘッドを避けられます。
Grok 4.6では200Kトークンが料金の分岐点になる
Grok 4.6は、プロンプトが200Kトークン未満の場合、入力が100万トークンあたり$2、出力が$6です。200Kトークンを超えると、xAIの料金は入力$4/M、出力$12/Mに上がり、キャッシュ入力はそれぞれ$0.50/Mと$1/Mになります。安いほうの料金だけを見ていると、この境界を見落とします。2つの料金区分はxAI's release notesに記載されています。
表示料金で計算すると、キャッシュされていない入力100Kトークンと出力20Kトークンのリクエストは$0.32です。一方、入力250Kトークンと出力20Kトークンでは、高い料金区分が適用されて$1.24になります。ただし、これはリクエスト単体の計算です。実際のエージェント実行では、リトライ、ツール呼び出し、キャッシュされたプレフィックス、蓄積したコンテキストが請求額を大きく左右します。
最近のr/grokでの議論では、設定に依存するCursorBench 3.2の数値として、Grok 4.6 Extra Highが1タスクあたり$2.81、46ステップ、Opus 5 Maxが$8.23、78ステップだったと報告されています。ただし、これは投稿者の評価環境で得た結果であり、ベンダーに依存しない保証ではありません。同じ投稿では、Terminal-Bench 3.0でのGrok 4.6は26.0%で、名前が挙がった他のモデルを下回ったとも報告されています。
Opus 5はエージェントの組み込み方を変える
Claude Opus 5ではthinkingがデフォルトで有効です。max_tokensは内部のthinkingと目に見える出力で共有するハード上限なので、thinkingを使わないOpus 4.8向けのリクエストから移行する場合は、より大きな出力予算が必要になることがあります。Anthropicは、thinking: {"type":"disabled"}とxhighまたはmaxを組み合わせるとHTTP 400が返るとも説明しています。移行ノートが示す選択肢は2つです。thinkingを無効にするならeffortを下げるか、無効化の設定自体を削除します。
Claude Opus 5では、キャッシュ可能なプロンプトの最小長もOpus 4.8の1,024トークンから512トークンに下がりました。ベータ版の制御機能を使えば、プロンプトキャッシュを無効にせず会話の途中でツールを変更でき、管理されたfallbacks: "default"モードも利用できます。権限やツールセットが頻繁に変わるエージェントには意味のある機能ですが、単純なステートレスの補完エンドポイントには必要ありません。
Fast modeはAPI限定のリサーチプレビューで、料金は入力$10/M、出力$50/Mです。Opus 5の標準料金の2倍にあたります。Anthropicによると、Amazon Bedrock、Google Cloud、Microsoft Foundryでは利用できないため、移植性と速度を両立できるとは限りません。Anthropic's launch announcementには、標準料金として入力$5/M、出力$25/Mが示されています。
コーディングエージェントの評価は、方向性を示す材料にとどまる
Anthropicの報告では、Opus 5は最大effortでCursorBench 3.2の約70.0%に達し、1タスクあたりのコストは約$8.50でした。これは、Fable 5が報告した最高スコアを0.5ポイント以内の差で追いながら、コストはおよそ半分です。ただし、これらはAnthropicが図示した結果であり、プロバイダー横断の監査ではありません。Opus 5の発表によると、Frontier-Benchは各タスクを5回試行し、Anthropic内部の実行環境で測定しています。
コードレビューについては、より限定的ながら実務に近い測定があります。CodeRabbitは、実際のオープンソースプルリクエストから検証済みのエラーパターンをおよそ100件集め、各設定を3回ずつ実行し、フィルタリング後のレビューコメントを評価しました。xhigh effortでは、Opus 5の設定が既知の問題を55.2%検出したのに対し、本番ベースラインは61.1%でした。一方、実用的な精度は39.3%対35.2%で、nitpickはOpus 5が92件、ベースラインが23件でした。CodeRabbit's Opus 5 evaluationは、Opus 5を唯一の安全網にするのではなく、精度を重視した特定の役割で使うことを推奨しています。
この結果から導ける実務的なルールは明確です。Opus 5は複数のeffortレベルで評価し、自分のプルリクエストを使って再現率、適合率、トークン使用量、レビューのノイズを測定してください。Grok 4.6について、xAIの現行リリースノートはAPIの仕様と料金を示していますが、直接比較できるコードレビュー調査は公開していません。コーディングエージェントのスコアだけを根拠に、コードレビューでの勝利まで推測してはいけません。
導入先ごとにモデルを選ぶ
通常のプロンプトが200Kトークン未満に収まり、表示上のAPIコストを抑えたいエージェントなら、Grok 4.6を推奨します。ただし、評価予算はこの境界をまたぐ前提で組みましょう。最初のプロンプトが小さくても、ツールの出力やリトライによってリポジトリエージェントが200Kを超えることがあるためです。
アクティブなコンテキストが500Kトークンを超えるリポジトリ、ドキュメント、エージェントセッション、最大128Kトークンの出力、またはAnthropicが提供するツール変更・フォールバック制御が必要なら、Claude Opus 5を推奨します。まずはhighから始め、maxの効果を決めつける前に、低いeffortでもテストしてください。
自動コードレビューでは、一般的なコーディングベンチマークだけでモデルを選ばないでください。ラベル付きのプルリクエストを用意し、問題の再現率と誤検知の負荷を記録したうえで、同時実行、API利用、検証不備に備えた別のレビュー経路も残しておきます。CodeRabbitの評価では、テストしたOpus 5の設定でこれらのカテゴリが弱点になりました。Its category findingsは、あらゆるClaude導入に対する断定ではなく、タスクとの相性を検証する理由として読むべきです。
| 導入シナリオ | デフォルトの選択 | 判断の決め手 |
|---|---|---|
| 200Kプロンプトトークン未満のコスト重視コーディングエージェント | Grok 4.6 | 入力$2/M、出力$6/Mという表示料金 |
| 500Kを超える長時間のリポジトリ/ドキュメントセッション | Claude Opus 5 | 1Mのコンテキストウィンドウと128Kの出力上限 |
| ツールが動的に変わるエージェント | Claude Opus 5 | 会話中のツール変更後もキャッシュを維持できるベータ機能 |
| 200Kトークン超のプロンプトが頻繁に発生するタスク | 両方を評価 | Grok 4.6は境界を超えると表示上のトークン料金が2倍になる |
| コードレビューパイプライン | ラベル付きPRで両方を評価 | 見出しのスコアより、再現率、適合率、リトライ、レビューのノイズが重要 |
FAQ
Grok 4.6はOpus 5より安いですか?
プロンプトが200Kトークン未満なら、xAIのGrok 4.6は入力$2/M、出力$6/Mです。Opus 5は入力$5/M、出力$25/Mなので、この範囲ではGrok 4.6のほうが安価です。ただし、Grok 4.6の表示料金はプロンプトが200Kトークンを超えると2倍になるため、最初のリクエスト単価ではなく、タスク完了までのコストで比較してください。
コーディングにはどちらを使うべきですか?
エージェントが通常200Kプロンプトトークン未満に収まり、API料金を抑えたいならGrok 4.6を選びます。1Mのコンテキスト、128Kの出力、Anthropicのエージェント制御が必要ならOpus 5です。最終的には、実際に扱う言語、リポジトリの構成、ツールループで検証してください。
次にやるべき導入テスト
代表的なタスクを20〜50件用意し、固定したツール、リトライ回数、トークンのログ設定で各候補を同じ条件で実行します。必要な合格率を、より低いタスク完了コストで達成できるモデルを選びましょう。そのうえで、コンテキストや制御面の強みが決定的になるワークロード向けに、もう一方のモデルもルーティング先として残しておくと安心です。
関連記事:Claude Opus 5 API pricing guide、Grok 4.6 release details、Grok 4.6 vs GPT-5.6。