 AIREITER
Artificial Analysis Intelligence Indexでは、Grok 4.6が約61、GPT-5.6 Solが58.9と、両者の総合的な知能性能はほぼ同水準にある。一方で出力トークン単価はSolが5倍高い。ただし、Solはコンテキストウィンドウが約2倍広く、エージェント効率の評価でも優位なため、単純なトークン単価だけでは価値を決められない。
知能指数はほぼ同点。ただし見えない差もある
Artificial Analysis Intelligence Index v4.1は、推論、コーディング、知識系タスクを統合した評価指標だ。OpenAIの発表によるとGPT-5.6 Solのスコアは58.9。Grok 4.6は、Artificial Analysisのarenaデータを引用するコミュニティ報告で約61とされている。この数値は独立した確認を受けたものではないが、Artificial AnalysisがGrok 4.6をSolと同等と位置付けていることとは整合する。
ただし、このような総合スコアだけでは、コンテキスト長、エージェントとしての効率、ベンチマークごとのばらつきは見えてこない。OpenAIが公開した結果では、SolはTerminal-Bench 2.1で88.8%、DeepSWE v1.1で72.7%と、エージェント色の強い評価で突出している。Grok 4.6の個別スコアはまだ独立して公表されていない。Intelligence Indexでは総合知能が近いとしても、エージェント性能では別の結論になる可能性がある。
| 項目 | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| 開発元 | xAI | OpenAI |
| コンテキストウィンドウ | 500Kトークン(x.ai/api) | 約1,050,000トークン(openai.com) |
| API入力(100万トークンあたり) | $2.00(x.ai/api) | $5.00(openai.com) |
| API出力(100万トークンあたり) | $6.00(x.ai/api) | $30.00(openai.com) |
| Intelligence Index v4.1 | 約61(コミュニティ報告) | 58.9(公式) |
| クラウドでの提供 | Azure AI Foundry、Oracle OCI、Google Vertex(x.ai/api) | Azure、AWS Bedrock(openai.com) |
API料金:入力は2.5分の1、出力は5分の1
xAIのAPIページでは、Grok 4.6の料金は入力100万トークンあたり$2.00、出力100万トークンあたり$6.00とされている。対してOpenAIのGPT-5.6ページでは、Solは入力$5.00、出力$30.00だ。
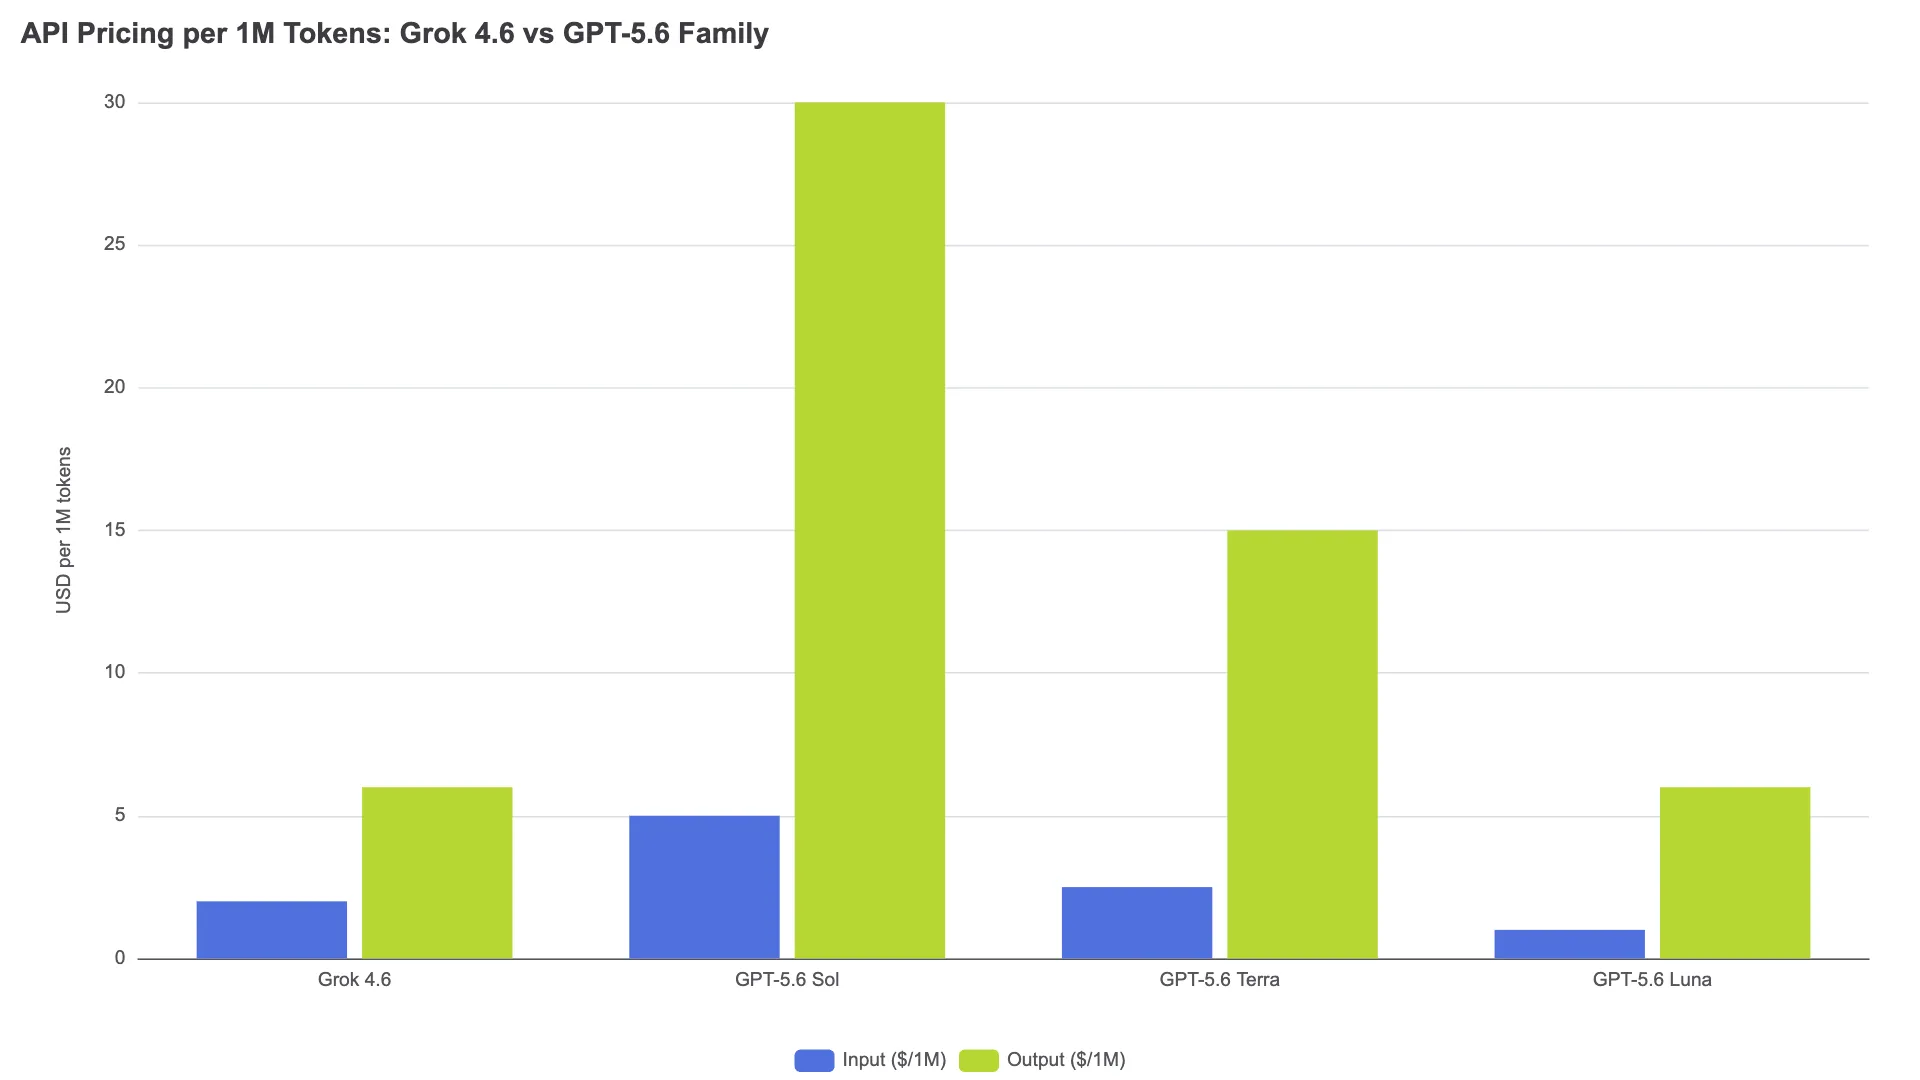
月間で入力50Mトークン、出力10Mトークンを使うワークロードなら、Grok 4.6は$160、Solは$550となる。Solの推論モードがタスクごとにより多くのトークンを消費する点を考慮する前でも、差は3.4倍だ。
OpenAIにはより安価な階層もある。GPT-5.6 Terraは$2.50/$15.00、GPT-5.6 Lunaは$1.00/$6.00で、Lunaの価格は2026年7月30日に80%引き下げられた。Lunaは出力価格がGrok 4.6と同額で、入力価格ではさらに安い。ただしLunaは小型モデルであり、ベンチマークスコアは全般に低い。知能性能の同等性を基準に比較するなら、対象はGrok 4.6とSolになる。この条件ではGrokのコスト優位は大きい。
コンテキスト長は500K対1Mトークン
xAIのAPIページによれば、Grok 4.6のコンテキストウィンドウは500Kトークン。SolはOpenAIのドキュメントによると約105万トークンを扱える。500Kトークンあれば、一般的なコンポーネント、モジュール、そして大半のサービス単位のコーディング作業には対応できる。一方で、モノレポ全体、複数の大規模文書、長い会話履歴を1プロンプトへ投入する必要があるなら、Solの1Mトークンが意味を持つ。たとえばコードベースのコンテキスト800Kトークンを一度に分析するエージェントワークフローでは、Solは対応できるが、Grok 4.6は対応できない。
長大なコンテキストでは、情報を実際に取り出せるかという信頼性も重要だ。OpenAIの報告では、Solは1Mトークン時のGraphWalks BFSで77.1%を記録している。Grokは同等の長文脈検索スコアを公表していない。「この600Kトークンのコードベースからバグを見つける」といった用途では、Solの広いウィンドウは単なる収容力の問題ではない。その深さから情報を取得できるかどうかにも関わる。
コーディングとエージェント評価で見える違い
Intelligence Indexでの接戦は、コーディング特化ベンチマークにそのまま当てはまるわけではない。以下では、OpenAIが公式に公開したGPT-5.6 Solのスコアと、参考値としてFritz.aiが報じたGrok 4.5の結果を並べた。Grok 4.6固有のコーディングベンチマークは独立して公表されていないため、Grok列は4.6との直接対決ではなく、前世代の参考値として読む必要がある。
| ベンチマーク | GPT-5.6 Sol(公式) | Grok 4.5(参考値) | 差 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1 | 58.9 | - | Grok 4.6:約61(ほぼ同点) |
| Coding Agent Index v1.1 | 80.0 | - | Grok 4.6のデータなし |
| Terminal-Bench 2.1 | 88.8% | 83.3% | Solが5.5ポイント上 |
| DeepSWE v1.1 | 72.7% | 53.0% | Solが19.7ポイント上 |
| SWE-Bench Pro | 64.6% | 64.7% | 実質同点 |
| GPQA Diamond | 94.6% | 93.1% | Solが1.5ポイント上 |
特に注目したいのは、SolがTerminal-BenchとDeepSWEで示した優位だ。Terminal-Benchは、パッケージのインストール、テスト実行、失敗のデバッグといった実際のターミナル作業をエージェントが完遂できるかを測る。DeepSWEは、実在するGitHub issueを対象にエンドツーエンドのソフトウェアエンジニアリング能力を評価する。Grok 4.5に対するDeepSWEの19.7ポイント差は、計画、実行、エラーからの復帰が求められる複雑な多段コーディングタスクで、Solが大幅に優れている可能性を示す。Grok 4.6のポストトレーニングによる改善がこの差をどこまで縮めたかは、今後の検証を待つ必要がある。
ベンチマーク結果は決定打ではなく、方向性を示すものだ。エージェントのハーネス、ツール、プロンプト、実行環境によって結果は変わるため、あるハーネスで低いスコアのモデルが別のハーネスでは上回ることもある。
比べるべきはトークン単価ではなく完了タスクの単価
料金表だけを見ると、Grok 4.6のトークン単価は圧倒的に低い。しかし、エージェントで購入しているのはトークンではなく、完了したタスクだ。同じコーディングタスクをSolが出力3,000トークンで完了し、Grok 4.6は6,000トークン必要とする場合を考えよう。リトライの増加、長い推論連鎖、ツール利用の効率差があれば、タスク単位のコスト差は縮まる。
現在の料金を使った感度分析で、その幅を確認できる。Solでは入力10K・出力4Kトークン、Grok 4.6では入力12K・出力8Kトークンを要するコーディングタスク、つまりSolに2倍のトークン効率があるケースでは、次のようになる。
| コスト要因 | GPT-5.6 Sol | Grok 4.6 |
|---|---|---|
| 入力コスト | $0.05 | $0.024 |
| 出力コスト | $0.12 | $0.048 |
| タスクあたりの合計 | $0.17 | $0.072 |
Grok 4.6に2倍のトークン効率差があるこのシナリオでも、タスク単価はGrok 4.6が2.4倍安い。Artificial Analysisを引用するRedditユーザーは、Grok 4.6のIntelligence Indexタスクあたりのコストを約$0.86と見積もっている。実際のワークロードでSol並みのトークン効率になった場合にもGrokの価格優位が残るかは、タスクの複雑さとエージェントハーネスに左右される。
本当のリスクはトークン経済性ではなく、タスクを完了できるかどうかにある。SolがTerminal-BenchとDeepSWEで高いスコアを示していることは、Grokでは失敗してリトライや人手介入が必要になるような複雑なエージェントタスクを、Solが成功させられる可能性を意味する。価格がいくら低くても、失敗したタスクは完了したタスクより高くつく。
利用経路とエコシステム
両モデルとも、単一プロバイダーのAPIに閉じた存在ではなくなっている。主な情報源はxAIのAPIページとOpenAIのドキュメントだ。
| 利用経路 | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Azure | AI Foundry(x.ai) | Azure OpenAI(openai.com) |
| AWS | 掲載なし | Bedrock(openai.com) |
| Google Cloud | Vertex Model Garden(x.ai) | 掲載なし |
| Oracle | OCI Generative AI(x.ai) | 掲載なし |
| IDE連携 | Cursor、Devin | Cursor、Codex |
| SDK互換性 | OpenAI + Anthropic SDKs(x.ai) | OpenAI SDK |
| 一般向けチャット | SuperGrok($30/月)、X Premium+ | ChatGPT Plus($20/月)(fritz.ai) |
| 一般利用データでの学習 | デフォルトでオプトイン、オプトアウトが必要 | API/Businessデータはデフォルトで対象外 |
xAIのドキュメントによると、GrokはOpenAIとAnthropicの両SDKをサポートする。移行時に必要なのは、APIキーとエンドポイントの変更だけだ。機密コードや独自コードを扱う場合、APIおよびBusinessデータをデフォルトで学習に使用しないOpenAIの方針は、調達面での利点になる。Fritz.aiのプライバシー分析によれば、Grokの一般利用者は学習を拒否するには手動でオプトアウトしなければならない。
用途別:どちらを選ぶべきか
| ワークロード | 推奨 | 理由 |
|---|---|---|
| 大量のコーディングエージェント処理 | Grok 4.6 | 大規模利用でトークンコストが2.5~5分の1 |
| 複雑な多段エージェントタスク | GPT-5.6 Sol(暫定) | エージェントベンチマークの優位はGrok 4.6ではなくGrok 4.5との比較 |
| 大規模コードベースの分析(500Kトークン超) | GPT-5.6 Sol | コンテキストウィンドウが約2倍大きい |
| コスト重視のバッチ処理 | Grok 4.6 | 知能性能はほぼ同等で、トークン単価が低い |
| リアルタイムのSNS/Webリサーチ | Grok 4.6 | XとWeb検索をネイティブで利用可能(x.ai) |
| 機密性の高いコード/独自コード | GPT-5.6 Sol | APIデータはデフォルトで学習に使われない |
| Azureでのエンタープライズ導入 | どちらでも可 | どちらもAzure AI Foundryで利用可能 |
最も確実な判断方法は、実際の代表タスクを両方のAPIで実行することだ。成功完了率、成功タスクあたりのコスト中央値、リトライ回数、レイテンシを比較したい。
FAQ
Grok 4.6の比較対象はGPT-5.6 SolではなくTerraにすべき?
Terra($2.50/$15.00)は価格面ではGrok 4.6に近いが、公開済みのすべてのベンチマークでSolを下回る。Intelligence Indexは55.0、Coding Agent Indexは77.4、Terminal-Benchは87.4%だ(OpenAIによる)。知能性能をそろえて比較するなら、Grok 4.6対Solが公平だ。価格を基準にするなら、Grok 4.6対Terraではコスト、ベンチマークスコアの両方でGrokが有利になる。Luna($1.00/$6.00)は両者より安価だが、品質面で大きなトレードオフがある。
Grok 4.6の仕様と機能をさらに詳しく知りたい場合は、Grok 4.6 guideを参照してほしい。GPT-5.6を旧世代のGrokと比較するなら、前世代同士を扱ったGPT-5.6 Sol vs. Grok 4.5 analysisも役立つ。