Due modelli Gemini 4, rilasciati da Google a distanza di tre giorni: Carbon il 10 novembre 2026 e Hydrogen il 12 novembre. Ridurli a «Carbon è intelligente, Hydrogen è veloce» è comodo, ma può far lievitare i costi. In un benchmark di video grounding, Hydrogen — pur costando il 25% in meno per token — ha generato una fattura di $35.35, contro i $27.94 di Carbon, perché ha prodotto 2,6 volte più token in output.
Entrambi sono disponibili come gemini-4-carbon e gemini-4-hydrogen via Gemini API e AI Studio, hanno una finestra di contesto unificata da 1.048.576 token e accettano testo, immagini, audio, video e PDF restituendo output testuale (confronto live di OpenRouter). Carbon è il modello frontier per il ragionamento complesso e di lungo periodo; Hydrogen ne è la variante distillata e ottimizzata per la velocità, pensata per l'esecuzione quotidiana. Nei post di lancio di Carbon e Hydrogen, Google sottolinea anche un altro uso: Hydrogen può agire da modello esecutivo sotto un piano elaborato da Carbon.
Quando il modello meno caro finisce per costare di più
Il test end-to-end pubblico citato qui è il benchmark di grounded-video QA di Agnify: il modello deve individuare l'oggetto richiesto dalla domanda, inquadrarlo nei keyframe e seguirlo nel video. Il set comprende 300 domande, 1,9 ore di video e gli stessi 7,6M di token input per ciascun modello. Su questo carico video, il risultato mette in crisi il semplice confronto dei listini per token.
| Modello | HOTA | Oggetto corretto | Costo esecuzione | Costo / ora di video |
|---|---|---|---|---|
| GPT-6.1 Terra | 0.6169 | 94.3% | — | $8.19 |
| Gemini 4 Carbon | 0.6016 | 94.3% | $27.94 | $14.60, $29.20 dal 1° dicembre |
| Gemini 4 Hydrogen | 0.6006 | 95.1% | $35.35 | ~$18.50 fisso |
| Claude Opus 5.5 | 0.5944 | 92.7% | — | $43 |
Tra Carbon e Hydrogen ci sono appena 0,001 punti HOTA, con intervalli di confidenza sovrapposti: dal punto di vista statistico è un pareggio, così come con Terra, Sol e Opus 5.5 sullo stesso campione. La differenza sta nell'emissione: Hydrogen ha prodotto 3,19M di token output contro 1,23M di Carbon; nella fase 3, la mediana per i box di singoli oggetti era 387 token contro 47. In un caso con lettere di gommapiuma, Hydrogen ha consumato 62.138 token, delimitato la lettera sbagliata e ottenuto 0,36; Carbon ha usato 80 token e raggiunto 0,70. Il report completo di Agnify stima che limitare la verbosità di Hydrogen nella fase 3 al livello di Carbon ridurrebbe il costo dell'esecuzione a circa $24.
Vale quindi alla lettera la regola della guida ai workload di Vercel: prezzi per token identici non significano costi per task identici. Misurate il costo per task accettato, includendo i retry, non il costo per milione di token.
Come si posizionano davvero i modelli Google
La guida di Vercel indica Argon come punto di partenza generalista per sintesi e knowledge work (Vercel). Rispetto a quel riferimento, Carbon è il modello da chiamare per debugging difficile e problemi scientifici aperti, mentre Hydrogen è la scelta per attività ripetibili, delimitate e ad alto volume. Per Argon, rimandiamo alle nostre guide Carbon vs Argon e Hydrogen vs Argon.
L'aspetto più interessante è l'architettura a due modelli. In modalità Orchestrator, Antigravity consente a Carbon di pianificare in sola lettura, quindi passa a Hydrogen le modifiche ai file e l'esecuzione dei test, restituendo il controllo a Carbon se il flusso si blocca. Il funzionamento è descritto nell'approfondimento di Vercel sul routing eve e nella panoramica di Hydrogen di DataCamp. Questa combinazione riporta una riduzione delle quote del 24% e completamenti del 19% più rapidi, con risultati su Terminal-Bench vicini a Carbon: il modello frontier pianifica una volta, quello rapido gestisce il volume.
I due modelli hanno pesi chiusi (OnlySOTA), supportano input multimodali e output testuale con reasoning (OpenRouter). Carbon offre livelli di thinking low, medium e high, con medium come predefinito. Hydrogen aggiunge xhigh e usa high come default. Livelli con lo stesso nome non equivalgono allo stesso calcolo sui due modelli: nei test, registrate sempre modello e livello.
Dal 1° dicembre il listino cambia le carte in tavola
Il prezzo di riferimento di Carbon è promozionale. Hydrogen, invece, mantiene tariffe fisse: una differenza che pesa su più decisioni d'acquisto di qualsiasi benchmark.
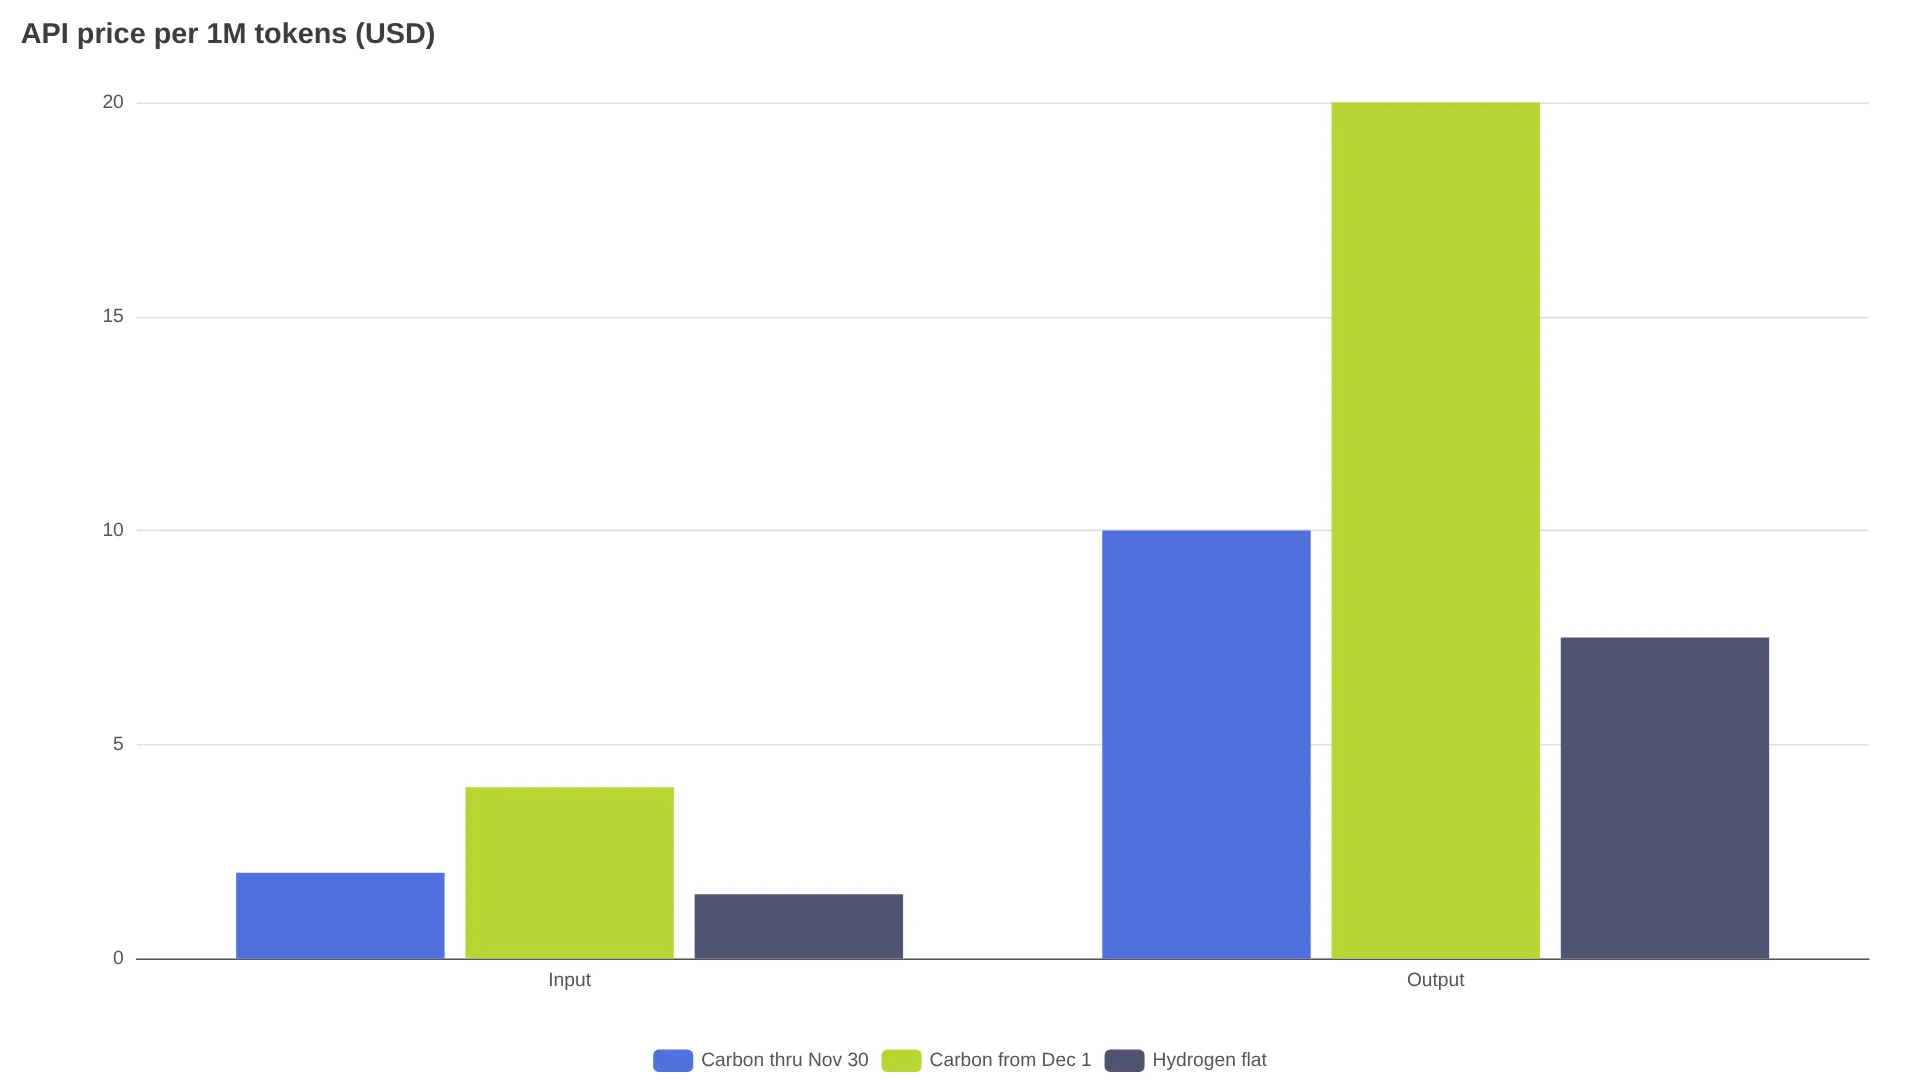
| Fascia | Carbon fino al 30 novembre | Carbon dal 1° dicembre | Hydrogen |
|---|---|---|---|
| Input / 1M | $2.00 | $4.00 | $1.50 |
| Output / 1M | $10.00 | $20.00 | $7.50 |
| Input in cache / 1M | $0.10 | $0.20 | $0.075 |
| Batch input+output | $1.00 / $5.00 | $2.00 / $10.00 | dipende dal provider |
| Priority input+output | $3.60 / $18.00 | $7.20 / $36.00 | dipende dal provider |
Prezzi: le tariffe di lancio Google arrivano dalle note day-0 di LiteLLM e dalle tabelle prezzi Cloud; le tariffe fisse di Hydrogen da DataCamp e dalla documentazione AI Studio. Il prezzo dell'output include i token di thinking: per Carbon, il reasoning più profondo pesa quindi due volte, nei token consumati e nel raddoppio di dicembre.
Fino a novembre, l'esecuzione video di Carbon costava il 9% meno di Argon a parità di tariffe per token, perché consumava meno token. Da dicembre, Hydrogen diventa più economico su qualsiasi workload con verbosità simile. Con un mix 3:1 tra input e output (OnlySOTA), Hydrogen costa $3.00/M contro i $4.00/M di Carbon a novembre e gli $8.00/M dal 1° dicembre. Per usare entrambi dietro un'unica chiave, la pagina API Gemini 4 Carbon instrada verso l'uno o l'altro modello.
Velocità e livello di thinking: ciò che cambia l'esperienza dell'agente
Le mediane live del confronto OpenRouter parlano chiaro: Carbon ha una latenza p50 di 11,32s a 57 token/s; Hydrogen arriva a 1,68s e 144 token/s. Hydrogen risponde per la prima volta circa 6,7 volte prima e offre 2,5 volte il throughput, una differenza dominante nell'esperienza di un agente interattivo.
| Livello Hydrogen | Costo per task | Intelligence Index | Uso |
|---|---|---|---|
low | ~$0.29 | 27 | Attività semplici e ad alto volume |
medium | ~$0.80 | 41 | Lavoro di routine in cui conta la velocità |
high (predefinito) | ~$1.87 | 51 | La maggior parte del coding e del lavoro agentico |
xhigh | ~$3.16 | 54 | Solo problemi multi-step più difficili |
Stime di Artificial Analysis riportate da DataCamp. Passare da high a xhigh costa il 69% in più per task, per soli 3 punti di indice, e può portare il modello a ragionare troppo su prompt semplici.
Particolarità dell'API da gestire nel codice (DataCamp):
thinking_budgeteMINIMALrestituiscono HTTP 400; usate invecethinking_leveltemperatureviene ignorato- L'output sincrono è limitato a 65.536 token; Carbon ha un limite inferiore di 32.768, secondo il test di Agnify
- Hydrogen è in GA a breve termine, con almeno 45 giorni di preavviso prima del ritiro
I benchmark vanno letti per tipo di lavoro
| Fonte | Carbon | Hydrogen | Confronto |
|---|---|---|---|
| Intelligence Index (OnlySOTA) | 60.0, n. 2/57 | 53.9, n. 7/57 | — |
| Arena Agent | 0.164, n. 3/65 | 0.149, n. 5/65 | — |
| Terminal-Bench 4.0 (OnlySOTA) | 64.5%, n. 3/59 | 56.4%, n. 12/59 | Sonnet 5.5 64% (AA indipendente) |
| Arena Code | 1768, n. 4/157 | 1704, n. 11/157 | — |
| Arena Text | 1526, n. 1/421 | 1490, n. 15/421 | — |
| Agents' Last Exam (DataCamp) | 77.4% | 71.6% | Argon 69.0% |
| Allucinazioni AA-Omniscience | — | 8% | 5 volte meno affermazioni inventate rispetto a Flash 3.8 (Google via DataCamp) |
OnlySOTA aggrega classifiche di terze parti invece di condurre test propri (OnlySOTA). La tabella Google corretta di Terminal-Bench 4.1, riportata da DataCamp, assegna a Hydrogen 57.0%, contro 18.2% di Flash e 63.9% di Sonnet. In sintesi: Hydrogen è competitivo nel coding agentico, ma non è la scelta migliore per workflow fortemente incentrati sul terminale.
Il vero limite, oggi, è l'accesso
Gli ID dei modelli sono stabili: gemini-4-carbon e gemini-4-hydrogen. Hydrogen è documentato per tutte le fasce API, inclusa una fascia gratuita con rate limit (DataCamp, documentazione AI Studio). Carbon richiede API a pagamento e accesso Ultra (post di lancio di Carbon). Nella pratica, il rollout è stato discontinuo: Hydrogen è comparso, scomparso e ha sostituito automaticamente Flash a seconda di app e account (thread di lancio su r/GeminiAI). I dettagli sono nel nostro tracker su prezzi e stato di rilascio di Hydrogen.
Prima di una migrazione, conviene mettere a budget anche le segnalazioni sulle quote:
"Ieri i limiti erano più generosi. Ho il piano pro a pagamento. Oggi i prompt, per esempio scrivere un capitolo di circa 6-7k parole, consumano intorno al 4-5 percento ciascuno. Ieri, quando è comparso Hydrogen, 3 capitoli erano circa il 2% della quota di 5 ore. Il limite di 5 ore è ridicolo" — u/Neat_Reaction9164, r/GeminiAI
"Oggi ho programmato con lui e con Sonnet, e Hydrogen ha decisamente dato il meglio di sé, con un'efficienza sorprendente; Sonnet invece è stato un po' altalenante e ha raggiunto i limiti d'uso ... È ancora troppo presto per giudicare." — u/mmmtv, r/GeminiAI
Testate sul percorso esatto che porterete in produzione — AI Studio, Antigravity, Cursor o API — perché piano, integrazione e livello di thinking possono modificare in modo sostanziale la quota effettiva. Se usate l'auto-routing, includete la chiamata decisionale in costi e latenza: il pattern eve di Vercel usa google/gemini-decision-1 a ogni turno, con Argon come fallback.
La scelta giusta in base al vostro workload
Tre profili coprono la maggior parte dei carichi API:
- Per il volume quotidiano, scegliete Hydrogen. Modifiche di codice di routine con diff verificabili, estrazione da formati consolidati, Q&A su una sola fonte, triage ad alto volume. Bloccate
high, fate regression test conmediume riservatexhighai casi multi-step che dimostrano di averne bisogno. - Passate a Carbon per il 10% più difficile. Spiegazioni concorrenti, root-cause analysis in cui una patch può mascherare il sintomo, esperimenti in conflitto che richiedono un test discriminante, insiemi di documenti in cui gli emendamenti prevalgono sulle proposte. Accettate la latenza e il prezzo di dicembre.
- Usateli in coppia. Carbon pianifica in sola lettura, Hydrogen esegue modifiche e test, Carbon riprende il controllo quando il processo si blocca. Questa configurazione riporta una riduzione delle quote del 24% e completamenti del 19% più rapidi.
Il compromesso ancora aperto è il rischio di verbosità. Nel test di Agnify, il valore predefinito high di Hydrogen emetteva da 89 a 201 token di ragionamento, contro i 51-64 del default di Carbon. Impostate limiti all'output e misurate i token emessi sui vostri prompt. Per ora, il budget di Hydrogen va calcolato sui token prodotti, non su quelli quotati.
FAQ
Carbon è migliore di Hydrogen nel reasoning?
Sì. Intelligence Index 60.0 contro 53.9, Terminal-Bench 4.0 64.5% contro 56.4%, Arena Text n. 1 contro n. 15; nel video QA, invece, pareggiano con HOTA 0.6016 contro 0.6006.
Quale costa meno?
Hydrogen: $1.50/$7.50 per 1M, con prezzi fissi. Carbon: $2/$10 fino al 30 novembre, $4/$20 dal 1° dicembre.
Quale è più veloce?
Hydrogen: latenza mediana di 1.68s contro 11.32s e throughput di 144 contro 57 token/s.
Hanno la stessa finestra di contesto?
Sì: 1.048.576 token unificati per entrambi.
Carbon può pianificare mentre Hydrogen esegue?
Sì, tramite Antigravity Orchestrator oppure routing a ogni turno con gemini-decision-1.
Quale livello di thinking usare?
Carbon medium, Hydrogen high; mantenete xhigh solo quando il tasso di accettazione cresce in modo misurabile.