 AIREITER
Gemini 4 Carbon non è il modello da usare per qualsiasi attività. Ha senso quando il lavoro può procedere per ore senza supervisione: refactoring multi-agente, documenti costruiti da 200 viste e cicli exploit-patch. La stessa Google indica Gemini 4 Argon come la scelta ideale per la maggior parte delle attività di ingegneria software e knowledge work; Carbon entra in gioco sui compiti più complessi, consumando però più token.
Gemini 4 Carbon è un modello frontier per il ragionamento, basato su Gemini 4 Argon. Google lo ha annunciato il 28 ottobre 2026 e reso generalmente disponibile il 10 novembre 2026. La model card di DeepMind indica marzo 2026 come data di cutoff della conoscenza, fino a 1 milione di token complessivi tra input e output, input testuali, documenti, immagini, audio e video, con output testuale.
Chi può usare Carbon oggi
L'accesso a Gemini 4 Carbon varia in base al canale, e quello consumer è il più limitato. Gli sviluppatori possono usarlo nel tier API a pagamento di Google AI Studio, oltre che in Android Studio e Gemini for business. Per i consumatori, Carbon è disponibile nell'app Gemini, in AI Mode di Search e in Google Antigravity esclusivamente con Google AI Ultra. Gli scienziati possono richiedere sei mesi gratuiti al livello di utilizzo più alto di Antigravity, mentre i defender verificati possono candidarsi attraverso il Fairwind Program.
Gli abbonati Google AI Pro non ottengono Carbon sulle superfici consumer: una limitazione segnalata ripetutamente nei thread di lancio su r/GeminiAI.
"Disponibile per ULTRA. Argon per Pro finisce dopo due prompt." — u/Nodayssoff su r/GeminiAI
I materiali di lancio collegati non specificano quote consumer fisse, una data di arrivo per il tier Pro o una disponibilità uniforme per tutti i Paesi. Nella discussione sull'accesso e nel thread sulle quote, gli utenti riportano plafond di cinque ore e settimanali esauriti in pochi prompt, chiavi funzionanti su una superficie ma bloccate in Antigravity e, al day one, errori An internal error has occurred. Considerate Ultra come una postazione di test per Carbon, non come accesso illimitato.
Carbon e Argon a confronto
Gemini 4 Carbon e Gemini 4 Argon condividono prezzi di listino e dimensione del contesto. A differenziarli sono capacità, latenza e consumo di token.
| Voce | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| Base | Basato su Argon, con più ragionamento per lavori complessi e di lunga durata | Modello frontier di base, predefinito per l'ingegneria ordinaria |
| Disponibilità generale | 10 novembre 2026 | 13 ottobre 2026 secondo il confronto di ToolColumn |
| ID modello API | Da verificare in AI Studio al momento della chiamata: nei post di lancio non c'è un ID stabile distinto | gemini-4-argon secondo il confronto di ToolColumn |
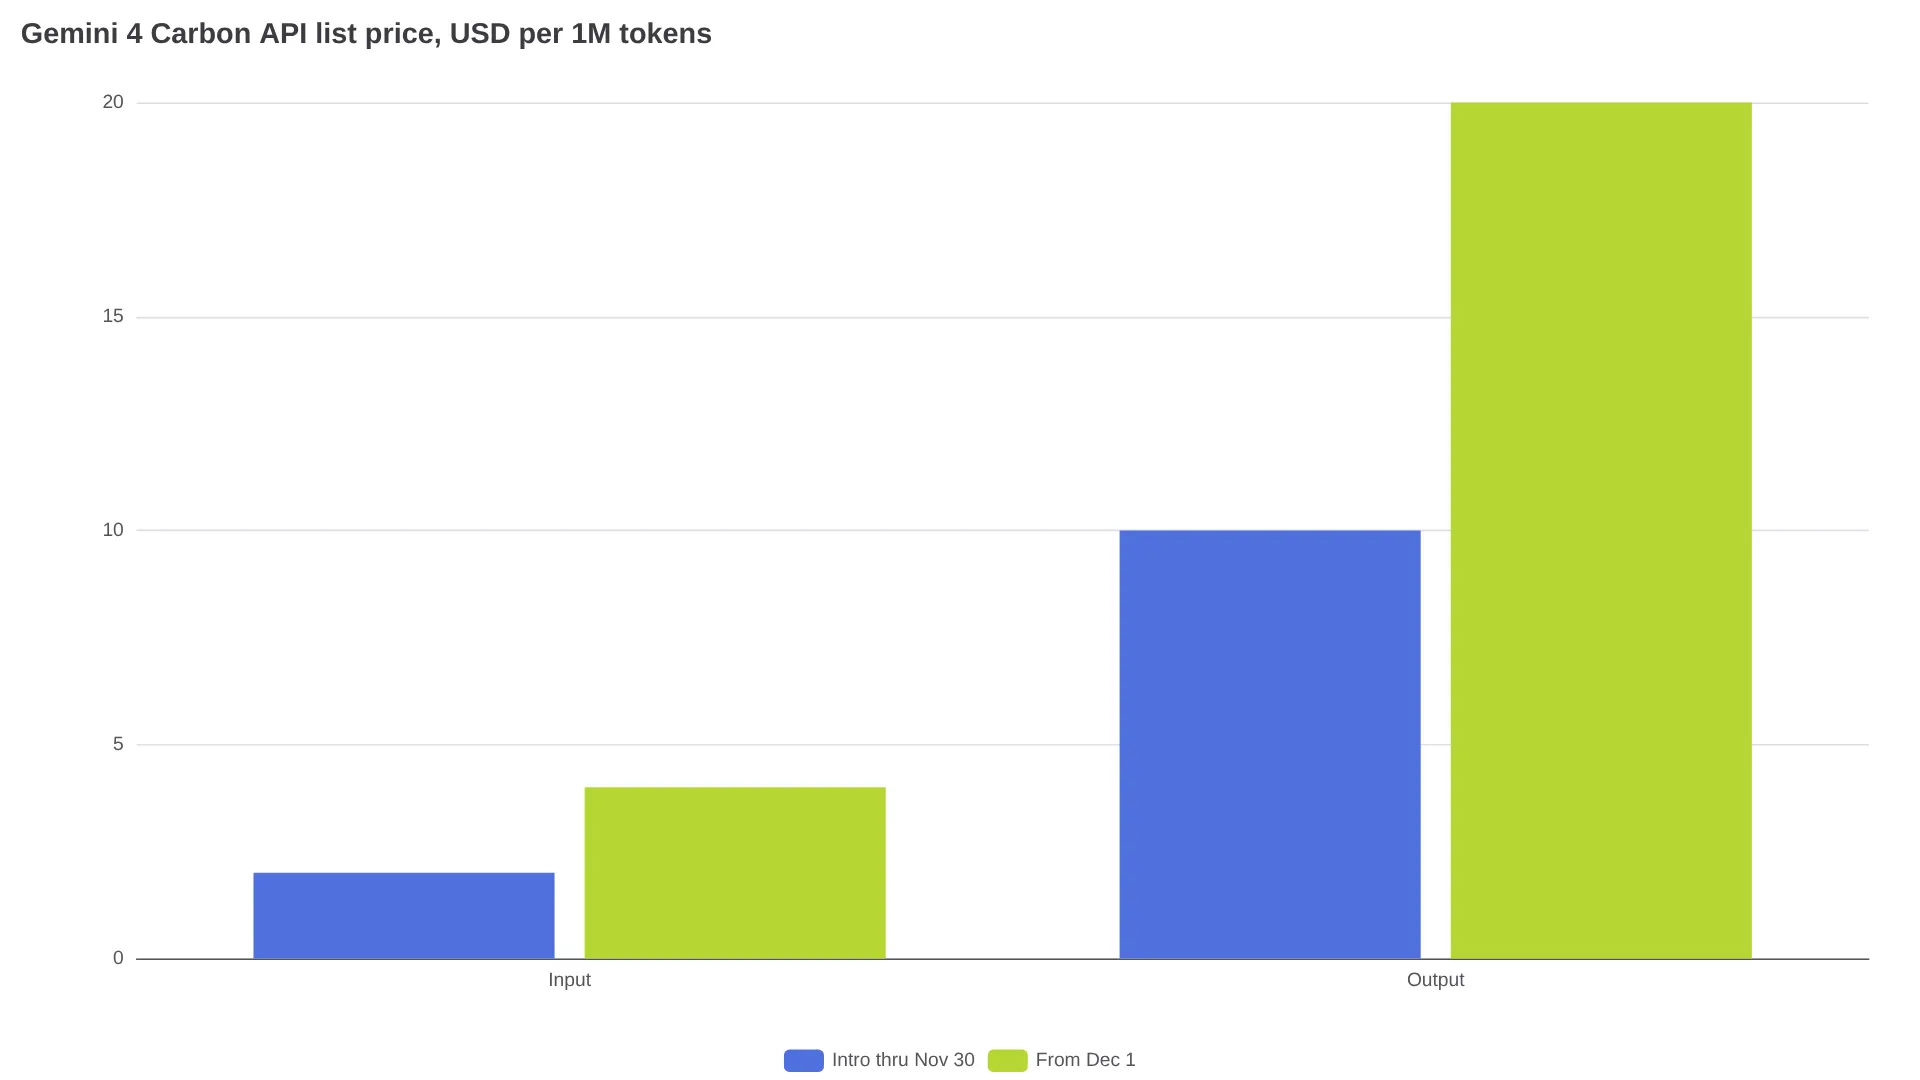
| Prezzo API di listino, lancio fino al 30 novembre 2026 | $2 input / $10 output per 1M token, $0.10 input in cache | $2 input / $10 output per 1M token, $0.10 input in cache |
| Prezzo API di listino dal 1° dicembre 2026 | $4 input / $20 output per 1M token | $4 input / $20 output per 1M token |
| Contesto | Fino a 1M di token complessivi tra input e output | 1,048,576 token secondo il confronto di ToolColumn |
| Modalità di input | Testo, documenti, immagini, audio, video | Testo, immagini secondo Artificial Analysis |
| Artificial Analysis Intelligence Index v5.0.1 | 60 | 50 |
| Costo ponderato per attività dell'indice | $7.76 | $9.95 |
| Velocità di output | 82 tok/s | 68 tok/s |
| Tempo al primo token di risposta | 67.54 s | 40.02 s |
| Livelli di thinking | Configurabili; i livelli più alti consumano più token | Low / Medium / High, Medium predefinito secondo il confronto di ToolColumn |
I prezzi provengono dall'annuncio di disponibilità di Google; velocità, latenza, costo per attività e distinzione delle modalità arrivano da Artificial Analysis Carbon vs Argon. L'input in cache costa il 95% in meno del listino, cioè $0.10 per 1M ai prezzi di lancio.
Il prezzo di listino è identico, il costo per carico di lavoro no. Artificial Analysis registra $7.76 per attività ponderata dell'Intelligence Index per Carbon, contro $9.95 per Argon, pur con Carbon che genera in media circa 7.000 token di output in più per attività. Carbon completa le attività ponderate in 24.9 minuti contro i 28.6 minuti di Argon, ma attende 67.54 secondi per il primo token di risposta contro 40.02 secondi. È il lavoratore più forte sulle sessioni prolungate, ma parte più lentamente.
Dove Carbon fa la differenza e dove no
Google riporta 17 valutazioni; qui sotto sono selezionate le righe Carbon contro Argon. Gemini 4 Carbon supera Gemini 4 Argon in tutte e 17 e guida il gruppo completo di cinque modelli in 15. Le due eccezioni contano: GPT-6 Astra guida FrontierSWE 2 con 65.5% contro 61.2% di Carbon, mentre Claude Opus 5.5 è primo in OSWorld-2.1 offline con 87.2% contro 81.5% di Carbon.
| Carico di lavoro | Benchmark | Carbon | Argon | Divario |
|---|---|---|---|---|
| Programmazione agentica | SWE-sweep | 9.6% | 4.3% | +5.3 pp |
| Programmazione agentica | Terminal-Bench 4.0 | 65.2% | 57.1% | +8.1 pp |
| Programmazione agentica | FrontierSWE 2 | 61.2% | 55.0% | +6.2 pp, ancora dietro Astra |
| Uso del computer | Agents' Last Exam v1.1 | 77.4% | 69.0% | +8.4 pp |
| Uso del computer | OSWorld-2.1 offline | 81.5% | 74.7% | +6.8 pp, ancora dietro Opus 5.5 |
| Knowledge work | AutomationBench, Zapier | 53.9% | 51.3% | +2.6 pp |
| Knowledge work | Vending-Bench 2 balance | $16,484 | $13,718 | +$2,766 di saldo simulato |
| Contesto lungo | GraphWalks 256K-1M BFS F1 | 96.2% | 84.2% | +12.0 pp |
| Scienza | Terminal-Bench-Science 0.1 | 64.8% | 52.9% | +11.9 pp |
| Scienza | RiemannBench | 80.0% | 76.0% | +4.0 pp |
| Cyber | ExploitGym | 54.8% | 42.0% | +12.8 pp |
| Cyber | SEC-bench Pro | 88.2% | 83.4% | +4.8 pp |
| Cyber | CWE-bench | 71.0% | 68.0% | +3.0 pp |
Tutte le righe provengono dalla tabella della model card di DeepMind, ottobre 2026. Le righe Cyber riflettono l'accesso Fairwind senza guardrail, non il comportamento dei prodotti standard. La stessa scheda aggiunge Chartography (72.5% contro 71.6%), Vals Index (70.4% contro 69.2%), AA Index v5.0 (59 contro 50) e Blueprint-Bench 2 similarity (58.6% contro 54.4%), completando tutte e 17 le valutazioni.
- Carichi tecnici più impegnativi: i vantaggi maggiori di Carbon emergono nella validazione di exploit, nel recupero su grafi da 256K-1M, nella scienza via terminale e nel coding multi-step da terminale.
- Knowledge work ordinario: su lettura di grafici, valutazioni generali e automazione d'ufficio, il divario scende a 1-3 punti.
- Affidabilità e sicurezza: nel post di presentazione di Carbon, Google riporta il superamento dei test di agentic honesty nel 92% di 375 attività contro il 70% di Argon, lo 0.0% di successo delle prompt injection indirette contro lo 0.7% di Argon e circa la metà delle affermazioni non supportate.
Artificial Analysis colloca Carbon davanti in tutte e nove le componenti dell'Intelligence Index, con vantaggi soprattutto nel ragionamento fisico e nell'ingegneria su repository open, come FrontierCode 2.0: 40.6% contro 25.7% di Argon. Separatamente, il post sulla disponibilità di Google rivendica il primo posto su CursorBench 4.0, Perplexity WANDR e Zapier AutomationBench, a un costo per attività oltre 2x inferiore rispetto al miglior modello esterno successivo.
Cosa affidare a Carbon e cosa lasciare ad Argon
Usate Gemini 4 Carbon quando i cicli di verifica compensano il costo: per esempio ricostruzioni notturne in Three.js da 200+ viste di disegni PDF, con 10 cicli, e build di fisica multi-agente /swarm documentate nel post sulla disponibilità di Google. Il progetto della community qui sotto mostra lo stesso schema, su scala minore.
"Tocco l'erba con Gemini 4 Carbon. Ho creato questo prato da zero in CUDA e C++, senza game engine né librerie 3D. 52k fili d'erba e fiori selvatici; alla fine ho sintetizzato anche il suono del vento in C++, così che le stesse raffiche [guidino l'audio]." — @GlitterPixely su X
Per il lavoro di routine, restate su Gemini 4 Argon. Il vantaggio misurato più piccolo di Carbon riguarda la lettura di grafici e l'automazione d'ufficio: iniziate quindi modifiche a singolo file, normali attività CRUD e fogli di calcolo con schema rigido su Argon. Eviterete anche il primo token più lento e il maggiore consumo di token di Carbon. Il thinking High brucia rapidamente token nei lavori di storytelling brevi: un report su OpenRouter cita circa 6.000 token di thinking per una storia di 4.000 caratteri con High.
Configurazione pratica: avviate i nuovi agenti su Argon Medium per validare prompt, quota e permessi degli strumenti. Spostate su Carbon solo la coda lunga che fallisce: migrazioni tra pacchetti, indagini sulla causa radice attraverso sottosistemi, set documentali da oltre 100K token con disegni e tabelle e cicli di scansione-triage-correzione in stile Fortify, per i quali il post sulla disponibilità di Google riporta internamente 100% di recall nelle scansioni e 95% di precisione nel triage. In /swarm, assegnate a Carbon i ruoli di architetto, coordinatore e verificatore avversariale e lasciate ai modelli più leggeri gli spazi di lavoro paralleli. Se una sessione Carbon restituisce ripetutamente errori interni, riprovate in una sessione nuova prima di aumentare il thinking: le discussioni del day one riportano errori senza una causa chiara.
Come pianificare il budget dopo il 1° dicembre
Quando i prezzi API di listino raddoppieranno il 1° dicembre, il caching aggressivo degli input, scontato del 95% sul listino, diventa la leva principale per riusare repository, disegni e output degli strumenti.
Non fate i conti soltanto sul listino. Carbon genera più token di output per attività misurata: un mese da 50M input / 5M output passa quindi da $150 in fase introduttiva a $300 dopo l'introduzione ai prezzi di listino, per entrambi i modelli, prima di considerare il thinking aggiuntivo di Carbon. Eppure Artificial Analysis registra per Carbon un costo ponderato inferiore per attività completata nell'Intelligence Index, perché meno tentativi e maggiore throughput prolungato compensano il volume di token. La regola è semplice: thinking High per catene di exploit e scienza via terminale, dove Carbon guida di 8-13 punti; Medium o Low per documenti e rifiniture UI, dove il vantaggio è di 1-3 punti.
Per calcoli più dettagliati voce per voce, consultate la recensione dei prezzi API di Gemini 4 Carbon del sito.
FAQ su Gemini 4 Carbon
Google AI Pro riceverà mai Carbon?
I materiali collegati non indicano una data per Pro. Restate su Argon e considerate Ultra come una postazione temporanea per testare Carbon.
Quale livello di thinking incide sulla fattura?
Medium serve a validare i prompt; High va riservato a catene di exploit e scienza via terminale con divari di almeno 8 punti.
Carbon e Argon condividono le quote?
Non esiste una documentazione certa su quote condivise. Verificate i limiti attivi dell'account su ciascuna superficie: la cifra di 1M indica la capacità di contesto, non una quota di utilizzo.
La scelta rapida
| Se il vostro lavoro è | Scelta | Perché |
|---|---|---|
| Consegna questa settimana, codice e documenti di routine | Argon Medium | Divario di 1-3 punti, primo token più rapido, minor consumo |
| Migrazione di più giorni, repository da 100K+ token con disegni | Carbon, poi passate a Medium quando è tutto a posto | +8-12 punti su terminale e contesto lungo |
| Scansione, triage e patch di vulnerabilità open source | Carbon via Fairwind/API | +12.8 punti in ExploitGym secondo la model card; tasso di codice sicuro oltre 2x Argon |
| Agenti per documenti finanziari o legali con grafici | Prima Argon, Carbon per cifre contestate | Carbon è n. 2 su Multimodal Knowledge Agent a un costo per attività 6x inferiore rispetto al leader secondo il post sulla disponibilità, ma Argon è vicino su AutomationBench |
| Abbonato Ultra con quota settimanale limitata | Argon ogni giorno, Carbon per una sola esecuzione difficile | Alcuni utenti riportano che Carbon esaurisce i plafond in pochi prompt |
Carbon è lo specialista da noleggiare per il compito difficile, non il modello da impostare come predefinito. Argon resta nella coda quotidiana; Carbon giustifica il prezzo di listino di dicembre solo quando sono i cicli di verifica e la profondità exploit-to-patch a determinare il risultato.