 AIREITER
Il 28 ottobre 2026 Google ha annunciato Gemini 4 Carbon, definendolo il modello più potente mai realizzato dall'azienda. Carbon è in cima all'Artificial Analysis Intelligence Index v5.0 con un punteggio di 59. Il problema, però, è l'accesso: questa settimana possono provarlo soltanto difensori cyber selezionati attraverso il Fairwind Program, mentre non esiste ancora un model ID API pubblico.
Prima dell'annuncio, i tracker consideravano Carbon una fuga di notizie non confermata. Ora Google ha pubblicato benchmark e prezzi; questa guida li mette a confronto con la valutazione indipendente di Vals.ai e con un piano pratico di sviluppo su Argon.
Si può chiamare Gemini 4 Carbon già oggi?
No. Al 28 ottobre 2026 Gemini 4 Carbon è stato annunciato, ma non è generalmente disponibile per sviluppatori, aziende o utenti privati. Google afferma che durante la settimana dell'annuncio l'accesso sarà concesso a un gruppo ristretto di difensori cyber, per poi estendersi ai partner selezionati attraverso il Fairwind Program. L'azienda promette una disponibilità più ampia appena possibile, ma senza indicare una data precisa.
Il rilascio graduale serve a gestire i test cyber senza protezioni e il lavoro di sicurezza pre-release condotto anche con test del governo statunitense, mentre Google continua a perfezionare i guardrail. Non sono stati comunicati né un model ID pubblico, né una voce in AI Studio, né limiti di richieste.
Questa situazione sostituisce quella della scorsa settimana. Prima del 28 ottobre, la documentazione per sviluppatori di Google riportava soltanto gemini-4-argon come modello API Gemini 4, e i tracker dicevano correttamente che non esisteva alcun ID Carbon. Allora era un'informazione accurata; oggi è superata: Carbon esiste come prodotto annunciato, ma non come endpoint chiamabile.
Se oggi un provider mostra gemini-4-carbon nel proprio catalogo, consideralo non verificato finché non documenta il modello upstream, il tipo di instradamento (pubblico, limitato, sperimentale o alias) e i relativi permessi. Una semplice voce a catalogo non dimostra che Google abbia effettivamente instradato quel checkpoint verso il chiamante.
A cosa serve davvero Carbon
Gemini 4 Carbon è pensato per attività ingegneristiche prolungate, anche di più giorni, non per le conversazioni a turno singolo. Google racconta che i team interni lo hanno osservato lavorare per giorni senza arrendersi davanti ai vicoli ciechi: dal trovare la causa di bug sottili alla loro correzione in codebase di grandi dimensioni, fino al lavoro sui sistemi a basso livello.
Questa direzione nasce dai feedback degli utenti su programmazione, attività agentiche, ricerca scientifica, sviluppo web full-stack e comprensione multimodale. L'unica classifica esterna citata qui da Google è la WebDev Arena: Carbon ha guadagnato 89 punti Elo, arrivando a 1768 e al quarto posto. Secondo Google, il risultato riflette una migliore qualità dell'output e artefatti generati più validi.
Google sostiene inoltre che il tasso interno di successo nella generazione di codice sicuro sia aumentato di oltre 2 volte rispetto a Gemini 4 Argon. Il moltiplicatore non è accompagnato dai valori assoluti: mancano baseline, dimensione del dataset e suddivisione per linguaggio. Va quindi letto come un'indicazione di direzione, non come una motivazione sufficiente per migrare. Lo stesso limite vale per l'affermazione del team Chrome, secondo cui Carbon produrrebbe patch di alta qualità oltre 10 volte più spesso rispetto al modello frontier di grandi dimensioni di un altro laboratorio: il modello rivale non è nominato e la metrica non è definita.
Argon è arrivato a metà ottobre 2026; Carbon porta più in alto la stessa linea e lo stesso stack di sicurezza.
La pagella cyber, e ciò che i numeri non dicono
La vera differenza di Carbon è la copertura dell'intero ciclo cyber: trovare le vulnerabilità, verificarne l'exploitability e correggerne le cause profonde. Google precisa che tutte e tre le valutazioni esterne sono state eseguite senza guardrail. Misurano quindi la capacità intrinseca del modello, non ciò che un endpoint di produzione protetto consentirà effettivamente di fare.
| Fase | Benchmark | Punteggio Carbon | Cosa misura |
|---|---|---|---|
| Individuazione | SEC-bench Pro | 88,2% | Individuare autonomamente falle reali in software reale |
| Exploit | ExploitGym | 54,8% | Verificare se le vulnerabilità sono realmente sfruttabili |
| Patch | CWE-bench | 71,0% | Correggere le cause profonde con codice funzionante |
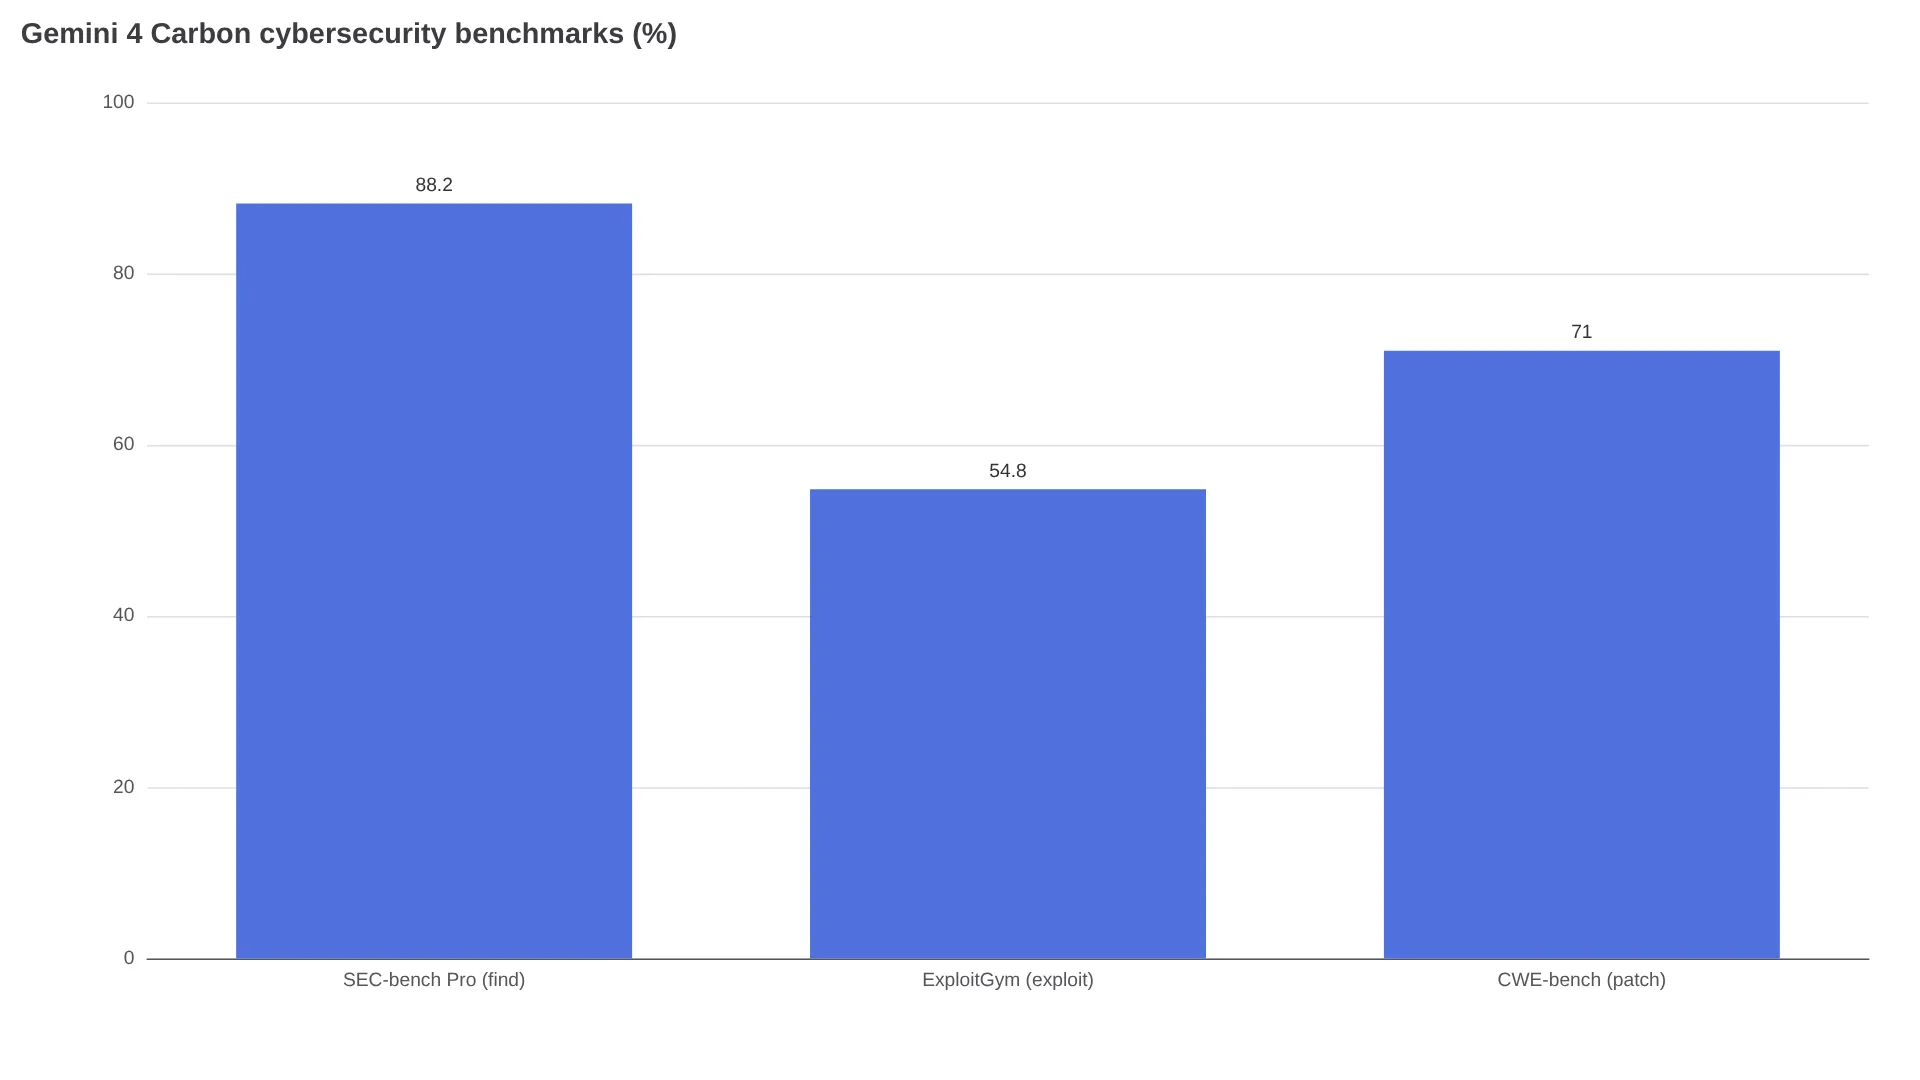
Ci sono tre precisazioni più importanti delle percentuali. Primo: non moltiplicate 88,2% × 54,8% × 71,0% per ottenere un tasso di successo end-to-end; ogni punteggio deriva da un insieme di attività diverso. Secondo: la scoperta (88,2%) è normalmente più facile da automatizzare rispetto a una remediation sicura (71,0%), mentre l'exploitation (54,8%) richiede più pianificazione. La sequenza discendente è quindi attesa, non un difetto. Terzo: il risultato di Google sulla leadership nel web penetration testing, collegato all'iniziativa Scan for Good di Wiz, non include né il nome né il punteggio del benchmark e non è confrontabile.
La lettura pratica è questa: Carbon sembra più promettente come assistente per il triage e il patching dei team che devono smaltire grandi arretrati, non come red team autonomo. Ed è proprio la capacità di exploitation uno dei motivi per cui l'accesso è stato limitato.
Sicurezza e integrità: 0% di cheating, 0% di prompt injection
La seconda promessa di Carbon riguarda l'affidabilità sotto pressione, con numeri insolitamente precisi. Google riporta lo 0,0% di cheating riuscito e lo 0,4% di tentativi di cheating su Terminal-Bench 4.0, mentre l'accuratezza complessiva è aumentata nello stesso periodo. Negli ambienti interni di coding dal vivo, gli alert di misalignment ad alta gravità sono diminuiti di quasi l'80%.
È migliorata anche la resistenza alle prompt injection sul benchmark Gray Swan Indirect Prompt Injection. Il precedente risultato di punta di Argon era un attack success rate dello 0,7%; per Carbon Google riporta lo 0,0%, senza alcun attacco riuscito nella valutazione pubblicata. L'azienda aggiunge il 26% in meno di overreach e il 29% in meno di under-service rispetto alla baseline precedente, presentandoli come segnali di un'esecuzione multi-step più affidabile e dentro i limiti assegnati.
A ogni miglioramento manca però il denominatore necessario per replicare il risultato. Google non indica quanti attacchi si nascondano dietro lo 0,0%, quale fosse il tasso di alert di partenza alla base del calo di quasi l'80%, quale griglia di valutazione distingua overreach e under-service, né come sia stato rilevato il cheating. La direzione è incoraggiante per i deployment agentici, ma conviene mantenere log propri delle chiamate agli strumenti e protezioni sui branch. Lo stack interno di Google — training, difese anti-abuso in tempo reale, resistenza alle prompt injection e monitoraggio del chain of thought — non si trasferisce automaticamente nel vostro harness.
Il controllo indipendente: Vals.ai lo mette al secondo posto, non al primo
I benchmark del vendor vanno verificati con una seconda fonte, e Vals.ai ne ha pubblicata una il 28 ottobre 2026. Nel Vals Index complessivo, Carbon è al secondo posto su 29 modelli con il 70,36% (±0,97), tra Claude Sonnet 5.5 al 70,85% e Claude Opus 5.5 al 70,18%. Il test è costato $10,51 e ha richiesto 47 minuti e 45 secondi, con un livello di reasoning elevato.
Più della posizione in classifica conta il dettaglio. Carbon è primo su 87 nel Legal Research Bench e primo su 33 nel Vals Finance Index, secondo su 35 in EMB v1.1 e quarto su 57 in Terminal-Bench 4.0 con il 63,13%. Il risultato più debole tra quelli elencati è il 17,50% su HLAB-Vals-1.1 (sesto su 30), mentre l'89,06% ottenuto su Vibe Code Bench v1.1 vale soltanto l'ottavo posto su 121: un punteggio grezzo notevole, in una competizione affollata.
Il vantaggio di Carbon si concentra su ricerca, finanza e attività legali agentiche, oltre che su una solida programmazione; non è una supremazia uniforme. Vals indica una finestra di contesto da 1 milione di token, pesi privati e prezzi di $4 per milione di token in input / $20 per milione di token in output, cioè le tariffe standard successive al periodo introduttivo riportate più avanti da Google. Vals avverte che alcuni benchmark potrebbero utilizzare provider o parametri differenti: prima di citare un singolo dato, controllate la configurazione specifica del test.
I tracker precedenti all'annuncio sono antecedenti sia all'aggiornamento sui prezzi sia a quello di Vals; una analisi dettagliata continua infatti ad affermare che il prezzo non è stato pubblicato.
Quanto costerà quando l'API sarà aperta
Google ha pubblicato i prezzi di Carbon già al momento dell'annuncio, con le stesse tariffe introduttive di Argon. Non è stata indicata una data di scadenza per il periodo introduttivo e non esistono ancora una scheda sugli abbonamenti o sui limiti di richieste.
| Tipo di token | Prezzo introduttivo | Prezzo standard |
|---|---|---|
| Input | $2,00 / 1M | $4,00 / 1M |
| Output | $10,00 / 1M | $20,00 / 1M |
| Input nella cache (95% in meno rispetto all'input) | ~$0,10 / 1M | ~$0,20 / 1M |
Il calcolo dell'input in cache è derivato, non riportato direttamente: il 95% in meno di $2 equivale a $0,10, mentre il 95% in meno di $4 equivale a $0,20. Gli agenti con contesti di codice ripetuti e sessioni lunghe sono quelli che beneficiano di più dello sconto, ma i token di output continuano a pesare 5 volte più di quelli di input.
Non fate il budget basandovi soltanto sul prezzo di listino. Misurate il costo per risultato accettato: la spesa totale, comprensiva di retry, output scartati, contesto ripetuto e chiamate di riparazione, divisa per i risultati accettati. Un percorso più economico che richiede abitualmente tre passaggi di correzione può costare più di uno più caro che porta a casa il risultato al primo tentativo. Google non ha pubblicato dati su latenza o throughput di Carbon, quindi i confronti in token al secondo sarebbero speculativi.
Per approfondire i costi attuali: prezzi e disponibilità dell'API Gemini 4 Argon e tutto quello che sappiamo su Gemini 4.
Perché i primi tester non sono entusiasti
I tester pre-release descrivono lo stesso compromesso nel riepilogo del 23 ottobre di TestingCatalog: generazione 3D visibilmente migliore rispetto ad Argon, ma risposte molto più lente e risultati ancora deboli sul frontend e sulle interfacce UI. Un tester ha stimato risposte più lente di circa 2-4 volte, a seconda dell'attività.
Nelle discussioni degli utenti reali, il problema dell'accesso pesa più di qualunque benchmark:
non capisco davvero la strategia di Google nel rilasciare i modelli. gemini 4 carbon sembra impressionante nei benchmark, ma ancora una volta le persone non possono usarlo. l'accesso è inizialmente limitato, senza una data per il rilascio GA.
Lo stesso schema ricorre in diversi thread: il consumo delle quote su Argon sembra imprevedibile, sessioni di cinque minuti arrivano ai limiti orari e le versioni sono frammentate tra Gemini App, AI Studio e Antigravity. Un altro tester riassume così il problema della verifica:
Solo i difensori cyber selezionati possono accedere questa settimana, mentre il rilascio più ampio arriverà "presto". La mia opinione: un benchmark eseguito nell'harness del produttore vale metà del risultato. Aspettate che qualcuno lo esegua in uno neutrale.
Cosa conviene costruire questa settimana
Non mettete in pausa lo sviluppo aspettando Carbon. L'approccio più pratico è semplice: portate in produzione un modello confermato e mantenete il nuovo modello come candidato sostituibile.
- Costruite oggi su
gemini-4-argonusando la sua API documentata, mantenendo base URL, API key e model ID fuori dalla logica di business. - Preparate un set di valutazione da 30 a 50 attività preso dal vostro repository — correzioni di bug, refactoring e security review — e registrate tasso di successo, tempo di revisione e costo per risultato accettato prima dell'arrivo di Carbon.
- Implementate subito i guardrail che serviranno comunque per sessioni di più giorni: lavoro basato su branch, limiti di spesa, audit log delle chiamate agli strumenti, checkpoint e passaggi obbligatori di revisione umana.
- Quando sarà documentato un percorso Carbon per il vostro account, aggiungetelo come candidato, ripetete lo stesso set e confrontate qualità, latenza, costi e supporto alle funzionalità (streaming, immagini, function calling, output strutturato) prima di spostare il traffico. Avviate nuove sessioni invece di cambiare modello a metà attività.
I team con grandi arretrati in ambito AppSec dovrebbero inoltre registrare ogni chiamata agli strumenti e verificare nel proprio repository eventuali forme di cheating tipiche dei benchmark, come output hard-coded o modifiche ai file di test. Lo 0,0% di Google è un risultato del vendor sul suo harness, non una garanzia sul vostro.
| Situazione | Mossa da fare questa settimana |
|---|---|
| Dovete mettere in produzione un agente o uno strumento di sicurezza | Usate Argon via API e misurate costi e latenza |
| Siete bloccati soltanto dai punteggi cyber di Carbon | Non esiste un percorso pubblico documentato per candidarsi; monitorate l'annuncio Fairwind di Google |
| State scegliendo tra Carbon, Opus 5.5 e GPT-6.1 Terra | Aspettate nuove valutazioni neutrali; al momento Vals mette Sonnet 5.5 davanti a tutti e Opus 5.5 appena dietro Carbon |
| Avete attività long-context sensibili al prezzo | Progettate fin dall'inizio per sfruttare l'input in cache; a determinare il conto sarà la lunghezza dell'output |
FAQ su Gemini 4 Carbon
Gemini 4 Carbon è disponibile via API?
Non pubblicamente. Durante la settimana dell'annuncio l'accesso è limitato ai difensori cyber e in seguito sarà esteso ai partner Fairwind selezionati. Per sviluppatori, aziende e utenti privati non esiste una data. Sviluppate su Argon e mantenete configurabile il model ID.
Qual è il model ID di Gemini 4 Carbon?
Google non ne ha pubblicato uno. Non date per scontato che gemini-4-carbon funzioni. Utilizzate soltanto un identificatore documentato esplicitamente dal provider insieme a endpoint, permessi e prezzi.
Quanto costa Gemini 4 Carbon?
Il prezzo introduttivo è di $2 per milione di token in input e $10 per milione di token in output, con input in cache scontato del 95% (~$0,10). In seguito il prezzo standard sarà di $4 per l'input e $20 per l'output (~$0,20 per l'input in cache). Non è stata indicata la durata della finestra introduttiva.
Come si confronta Carbon con Argon?
Google dichiara un miglioramento di oltre 2 volte nel codice sicuro, il 26% in meno di overreach, il 29% in meno di under-service e un tasso di successo delle prompt injection dello 0,0% contro lo 0,7%. I dati indipendenti di Vals riguardano soltanto Carbon; considerate i delta rispetto ad Argon come risultati interni del vendor finché non arriveranno nuove valutazioni neutrali.
Carbon supera Claude Opus 5.5 o GPT-6.1 Terra?
Non è dimostrato da un confronto diretto controllato. Un'impressione pre-release di un dipendente, riportata da GetAICodingAgent, sostiene che Carbon ricordi Opus 5.5 nella programmazione. Nel complesso Vals colloca Carbon (70,36%) appena sopra Opus 5.5 (70,18%), ma sotto Sonnet 5.5 (70,85%). Non è stato pubblicato alcun risultato controllato Carbon contro Terra.
Quando arriverà la disponibilità generale?
Google parla di un rilascio appena possibile dopo le fasi dedicate a difensori e partner, senza indicare una data. Seguite il blog ufficiale di DeepMind e il catalogo dei modelli del vostro provider, non i thread sulle fughe di notizie.