 AIREITER
Un menu da bar con quattro prezzi sembra un compito banale, finché il modello non decide di cambiarne uno. MOSS Image riesce a mantenere corretti testi di questo tipo molto più spesso di quanto ci si aspetterebbe da un modello delle sue dimensioni, ma solo se gli si forniscono una struttura chiara e una revisione finale da grafico.
È proprio questo il compromesso che mette alla prova questa recensione: un modello text-to-image da 5 miliardi di parametri, open source e distribuito con licenza Apache 2.0, capace di accettare prompt fino a 4.096 token e box JSON opzionali per testo e oggetti. Il team OpenMOSS lo ha pubblicato il 16 ottobre 2026 con i checkpoint Base e SFT, mentre l'API ospitata sulla piattaforma MOSI è arrivata il 20 ottobre. Se lavori a poster, menu, etichette o infografiche dove il testo deve essere esatto, vale la pena provarlo. Se invece ti servono coerenza dei personaggi o fotoritocco, meglio restare su un modello chiuso.
I primi risultati chiariscono subito il quadro: il testo regge, l'estetica non sempre
MOSS Image dà il meglio di sé con testi lunghi e precisi, non con l'estetica generale. Il LongLongTextBench del produttore riporta una copertura testuale Mean-6 complessiva del 96,3: 97,1 per i testi lunghi in inglese e 92,4 per quelli in cinese, su 240 attività con una media di circa 1.340 caratteri. GPT Image 2 arriva a 99,0 e Nano Banana Pro a 96,6. Sono però numeri ottenuti dal produttore su un benchmark progettato dal produttore: vanno considerati come un dato da verificare, non come una garanzia.
Il secondo valore da guardare è quanto il modello rispetta il layout. Il rapporto tecnico descritto in questa recensione indica 0,88 mIoU e 0,70 Layout AUC nel test 7Bench sull'aderenza ai box, circa il doppio dei risultati di Ideogram 4, rispettivamente 0,44 e 0,20, e nettamente sopra GPT Image 2, fermo a 0,30 e 0,16 nello stesso rapporto. Su RealLayoutArena, che comprende 61 attività valutate alla cieca tra poster, infografiche e interfacce, il sistema MOSS completo con miglioramento del prompt raggiunge 1.698,70 Elo, secondo solo a GPT Image 2 con 1.844,35. Quando tutti i generatori ricevono lo stesso prompt migliorato, invece, il solo backbone arriva primo. Anche in questo caso si tratta di risultati del produttore, ancora in attesa di replicazione indipendente.
Un piccolo test controllato rende la differenza più concreta. Il team di mossimage.run ha confrontato una volta per prompt MOSS Image SFT e FLUX.1 dev, sulla stessa tela da 1024x1024 e con gli stessi seed, senza selezionare solo i risultati migliori e lasciando nel set anche gli errori. Per questa recensione non ho ripetuto i test di latenza sull'hosting MOSI: i risultati riassunti nella tabella sono i primi output ottenuti da quel team tramite endpoint fal, mentre l'API MOSI è stata valutata sulla documentazione e sullo stato della finestra gratuita:
| Test | Cosa richiedeva il prompt | Primo output di MOSS Image SFT | Primo output di FLUX.1 dev |
|---|---|---|---|
| Menu del bar | MORNING MENU più Espresso 3.50, Flat White 4.20, Butter Croissant 3.80, Avocado Toast 8.50 allineati a destra | Tutti e quattro gli elementi e i prezzi sono corretti | Layout chiaro, ma 3.80 è diventato 3.60 |
| Etichetta del miele | WILDFLOWER HONEY, Raw & Unfiltered, Net Wt. 12 oz (340 g) disposti lungo la curva dell'etichetta | Tutte e tre le righe sono corrette | Titolo e peso corretti, la riga centrale è diventata Raw & Unfilterelrd |
| Poster bilingue | 周末市集 / WEEKEND MARKET, Sat 10:00–18:00, Riverside Park, Free entry / 免费入场 | Dettagli cinesi e inglesi corretti | Composizione riuscita, ma cinese illeggibile e 10.00–178.00 |
Le impostazioni erano 50 step e CFG 3 per MOSS, contro 28 step e guidance 3,5 per FLUX, tramite fal-ai/moss-image e fal-ai/flux/dev. Tre esempi non bastano per decretare un vincitore, come ammette anche quella pagina, ma il punto è il tipo di errore: un'immagine dall'aspetto convincente con un prezzo o un orario modificato è peggiore di un risultato chiaramente rotto.
"MOSS Image ha gestito bene il layout strutturato e il testo in inglese per essere un modello da 5B. Non è perfetto su ogni dettaglio, ma il flusso di lavoro è sembrato finalmente controllabile." — @Olaemmy1200, in un video completo del flusso di lavoro per un poster
Cosa offre davvero l'API: un generatore compatto con un lettore molto più grande
MOSS Image è un diffusion transformer single-stream con 42 layer, addestrato da zero. I 5 miliardi di parametri riguardano solo il generatore. Intorno ci sono un text encoder Qwen3.5-9B congelato, che interpreta il prompt, e una VAE FLUX.2 small-decoder, che genera i pixel. Questa separazione spiega sia il punto di forza sia il conto dell'hardware: la comprensione dei prompt lunghi e bilingui arriva da un lettore da 9B, non dal denoiser da 5B.
Il vantaggio più concreto è la finestra di contesto. Linguaggio naturale, sequenze di tag e layout JSON condividono un limite di 4.096 token: abbastanza per scrivere ogni riga di un poster invece di ridurla a una didascalia breve. La documentazione dell'API MOSI indica per il servizio ospitato un limite di testo lungo fino a 4.000 caratteri, con rendering del testo, negative prompt e generazione del layout supportati. Gli output consigliati sono nell'intervallo 1–2 megapixel, con estrapolazione da 512x512 fino a 2K e dimensioni divisibili per 16.
I checkpoint da considerare sono due:
- MOSS-Image-SFT è il modello Base perfezionato con fine-tuning supervisionato su dati selezionati. Il team OpenMOSS lo consiglia per la generazione diretta, perché raggruppa meglio il testo e produce layout più puliti. L'API ospitata usa per impostazione predefinita
moss-image-sft-1.0, mentre per la riproducibilità è disponibile lo snapshot bloccatomoss-image-sft-1.0-2026-10-09. - MOSS-Image-Base rinuncia al post-training e alla distillazione CFG per conservare il segnale grezzo dell'addestramento. La guida ufficiale lo indica per chi deve fare fine-tuning e consiglia di congelare il text encoder. Scegli Base per addestrare una LoRA o cercare una distribuzione stilistica diversa, non se vuoi creare un poster subito.
I pesi e il codice di inferenza incluso sono pubblicati con licenza Apache 2.0, secondo la scheda del modello su Hugging Face e la pagina ufficiale del progetto. Questo consente l'uso commerciale e il fine-tuning, ma non autorizza automaticamente ogni personaggio, logo o somiglianza che potresti generare per una campagna: conserva il file di licenza e la revisione esatta insieme a qualsiasi progetto commerciale. Il codice si trova nel repository GitHub di OpenMOSS.
Il layout JSON è il motivo per cui vale la pena affrontare questo flusso di lavoro
Il linguaggio naturale funziona ancora, ma è la sintassi del layout a rendere interessante il modello per chi lavora nel design. Un prompt strutturato descrive la scena generale e assegna poi a ogni elemento testuale o oggetto una didascalia e un box dedicati. I box guidano la generazione: non sono livelli vettoriali né garantiscono una precisione al pixel.
La convenzione delle coordinate spiazza quasi tutti al primo tentativo. Con bbox_coord_space: "abs_centralized" e bbox_format: "yxyx", ogni box è espresso come [y_min, x_min, y_max, x_max] in pixel rispetto al centro della tela. Su un'immagine 1024x1024, ciascun asse va da -512 a +512. Non inserire in questo schema coordinate con origine nell'angolo in alto a sinistra o un layout della community nella scala 0–1000 senza prima convertirlo.
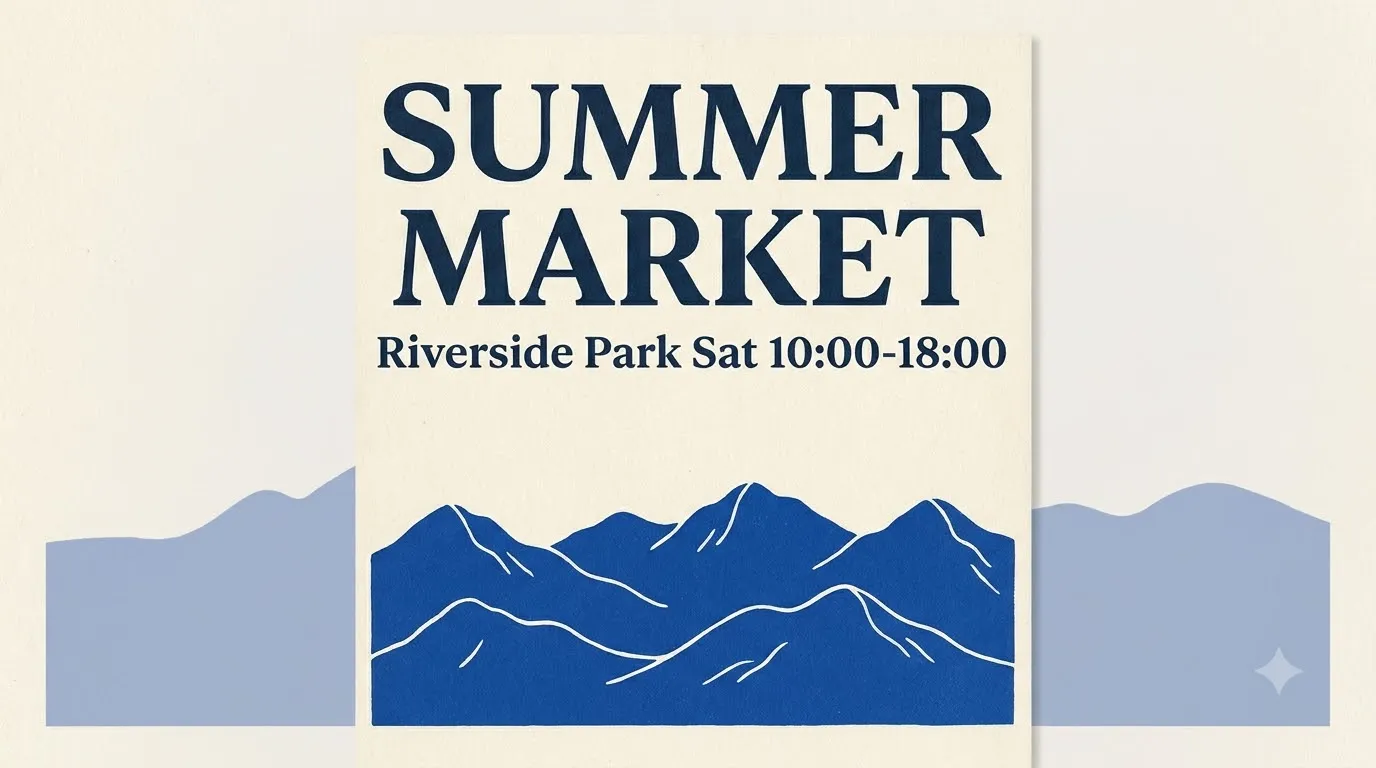
Una struttura minima può essere questa, con il titolo sopra e l'illustrazione sotto:
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
Nessuno si mette a scrivere a mano questi box per un'infografica con 20 elementi. Il metodo usato dai primi utenti consiste nel far preparare il JSON da un LLM con capacità visive, partendo da un brief o da uno schizzo, e correggere poi le coordinate prima della generazione. Il tester giapponese @chimolog7 lo ha detto senza giri di parole: il formato bbox è troppo difficile da compilare per una persona, quindi lo ha generato con Opus. Il risultato, però, è stato un rendering del giapponese con appena l'1% di refusi percepiti, mentre Krea 2 continuava a sbagliare spesso (post).
Il secondo accorgimento è la rigenerazione controllata. Poiché il modello è solo text-to-image e non accetta immagini di riferimento, non puoi applicare img2img a una foto e conservarla. Puoi però cambiare il testo o la posizione di un singolo box, mantenere lo stesso seed e rigenerare: il resto del layout rimane in gran parte invariato. L'utente @li9292 lo ha mostrato con la copertina di un report settimanale contenente migliaia di caratteri cinesi e 20 box: ha modificato un solo box usando lo stesso seed, mentre il resto del layout è rimasto al suo posto (post). Per i lavori in cui il testo deve essere esatto, questo ciclo singolo-box-più-stesso-seed conta più di qualsiasi preset stilistico.
Per un quadro più ampio sul rendering del testo, il nostro test sui migliori modelli di immagini per il rendering del testo nel 2026 mostra perché serviva un'opzione basata prima di tutto sul layout.
Come chiamarla e quanto costa davvero il gratis
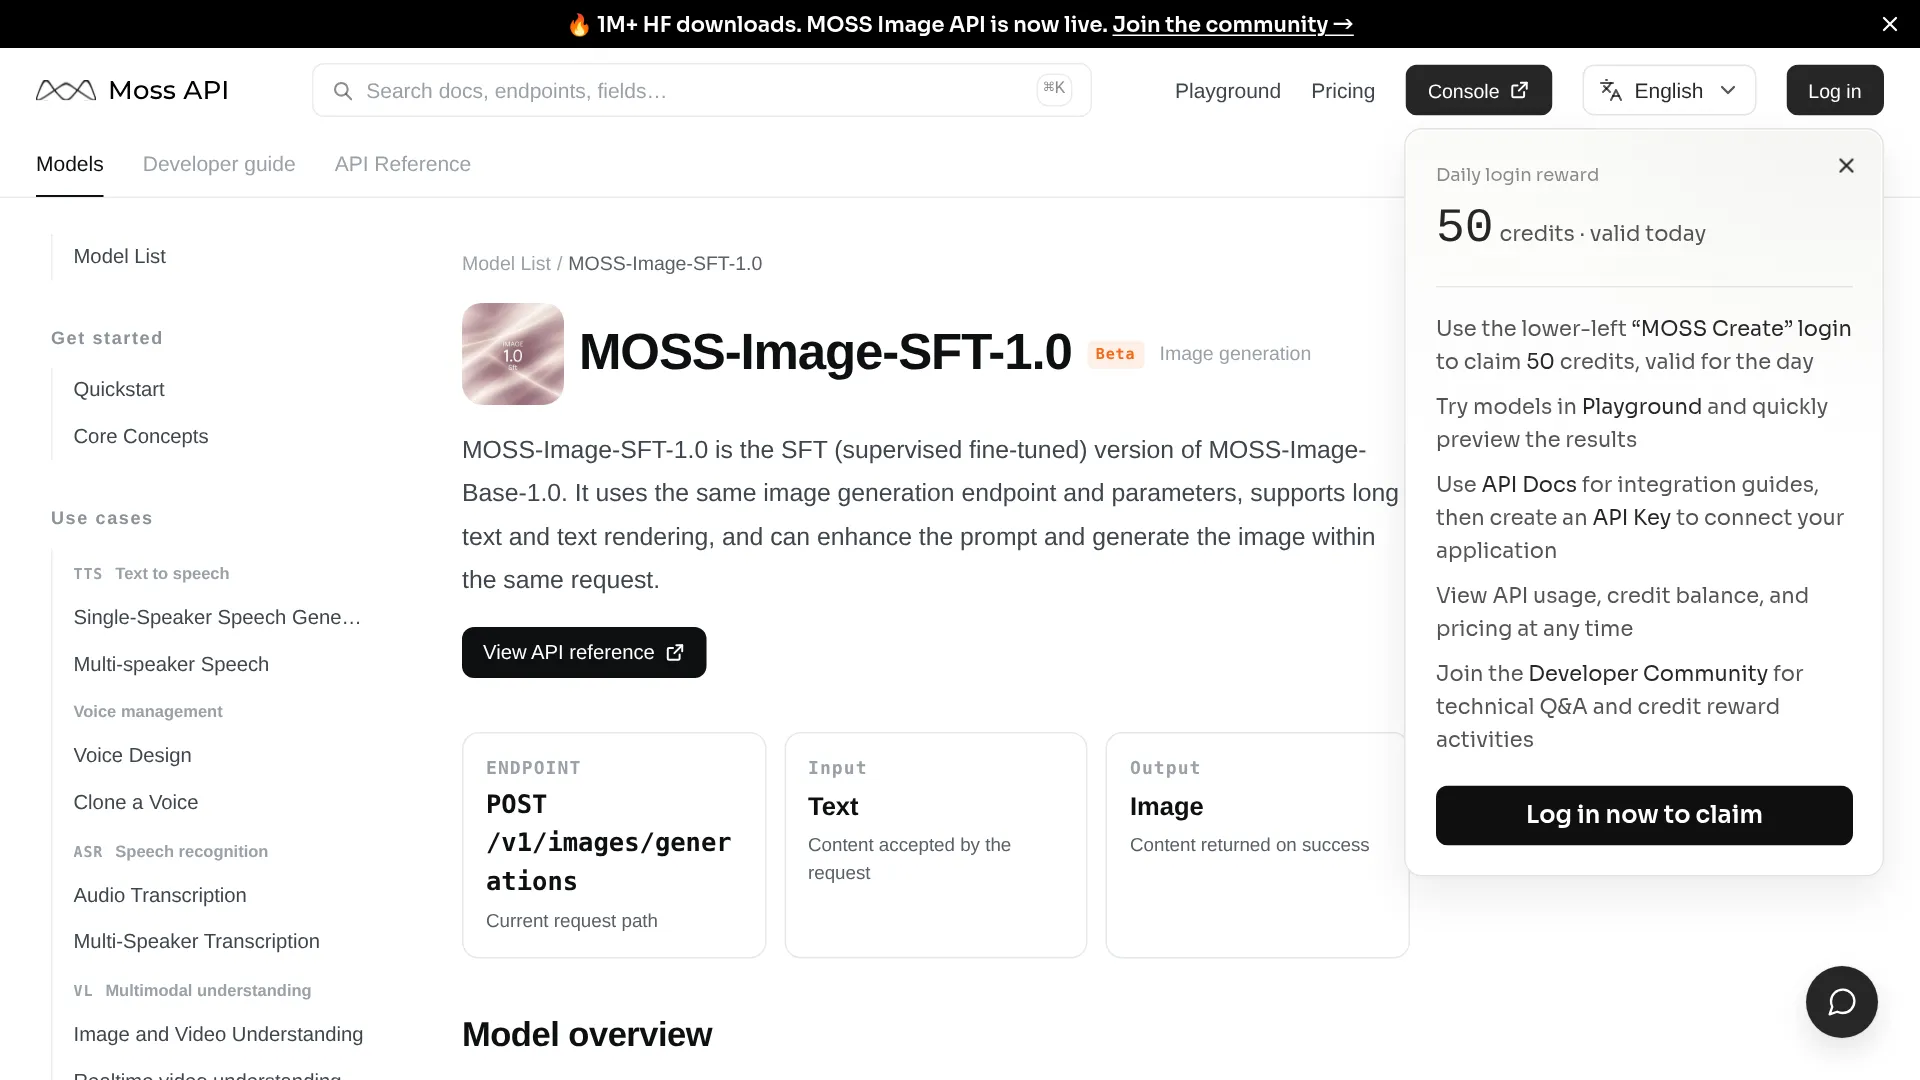
Il percorso ospitato passa da un solo endpoint. La documentazione dell'API MOSI indica POST /v1/images/generations per moss-image-sft-1.0, con solo testo in ingresso e immagine in uscita: niente input immagine, audio o video, streaming o API per task asincroni. Il miglioramento del prompt è integrato ma disattivato di default; si abilita con prompt_enhance: true, mentre la versione dell'enhancer viene scelta lato server.
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
Quando ti serve un controllo sui singoli box, passa come prompt una stringa contenente il layout JSON completo; la forma in linguaggio naturale qui sopra è la chiamata più semplice da copiare e incollare.
Al momento della verifica, la fatturazione indicava Free for a limited time a 0 credits, con un link al listino completo per il periodo successivo. La guida al confronto tra Base e SFT segnala la stessa situazione: playground attivo dal 20 ottobre, ma nessun prezzo stabile per immagine pubblicato. Fai quindi i conti di conseguenza: finestra gratuita per i prototipi, poi tariffe del provider più il tasso di scarto dovuto ai risultati con refusi.
L'inferenza locale elimina il costo per immagine, ma presenta un conto hardware concreto. L'elenco dei file Comfy-Org verificato il 20 ottobre arriva a circa 29,72 GB di pesi BF16 prima di considerare ambiente e cache: circa 10,16 GB per il backbone, 19,31 GB per il text encoder e 0,25 GB per la VAE small. INT8 ConvRot dimezza circa l'ingombro del transformer, con un backbone da circa 5,41 GB e un encoder da 9,75 GB; è disponibile anche un'opzione encoder W4A8 GPTQ da circa 7,34 GB.
| Configurazione | Cosa scaricare | Nota pratica |
|---|---|---|
| BF16 completo | 29,72 GB di pesi più memoria di lavoro | Stretto anche su 32 GB senza offload; RAM di sistema e lunghezza del prompt fanno la differenza |
| Quantizzato INT8 | Circa 15 GB più offload | Percorso documentato su 12 GB a circa 1 MP, un'immagine per batch, con un picco di circa 9,7 GB nel test della community citato qui; è il punto di partenza per schede da 8–12 GB |
| DMD community a 8 step / 4 step | Adattatore più workflow compatibile | Circa 24 secondi contro circa 137 secondi nello stesso report a 1 MP su RTX 3060, ma i primi adattatori perdevano sfumature: stabilisci prima una baseline a 50 step |
La baseline ufficiale di campionamento usa Euler, 50 step, CFG 3.0, shift 5.0 e skip-layer guidance al layer 22, a 1024x1024. Il supporto nativo a ComfyUI è stato integrato il 16 ottobre (annuncio qui): aggiorna ComfyUI, cerca i template per MOSS-Image e usa il workflow Base o SFT corrispondente con i file Comfy-Org, senza mescolare un grafo di plugin con un loader nativo.
Se stai confrontando più provider, la nostra analisi sulle API di generazione immagini più economiche offre un riferimento utile per mettere in relazione tempo GPU e costo degli scarti.
Dove i modelli chiusi sono ancora superiori
I limiti sono chiari ed è meglio considerarli prima di affidare a questo stack un lavoro definitivo. Il modello rilasciato è solo text-to-image. Non offre editing delle immagini né input di riferimento; la generazione basata su immagini di riferimento è indicata come lavoro futuro. Se devi conservare una foto caricata o mantenere lo stesso personaggio in più scene, usa invece un modello pensato per l'editing, come Qwen Image 2.1 per l'editing in produzione.
Le persone e la sensibilità estetica sono il secondo punto debole. A 5B, i volti possono risultare generici, le proporzioni cambiano e le mani mostrano i soliti difetti.
"Non gestisce bene nemmeno le proporzioni dei personaggi. E non è particolarmente bravo con i soliti problemi delle 'mani deformi' e simili." — @SlipperyGem
I test pratici citati confermano che conviene controllare gli stessi aspetti prima della pubblicazione: prompt brevi, personaggi con nome, tag degli artisti e vincoli precisi restano incostanti, il testo piccolo richiede una revisione, e le lingue al di fuori del benchmark inglese/cinese vanno controllate manualmente. La configurazione ufficiale a 50 step è pesante su hardware modesto, mentre gli adattatori veloci sacrificano le sfumature dell'illuminazione e il rispetto dei vincoli in cambio della velocità. Per ogni risultato da conservare, annota checkpoint, encoder, VAE, precisione, prompt, seed e tempo totale, compresa la codifica.
Il serving locale orientato alla velocità racconta la stessa storia dal punto di vista dell'hardware. Lucebox ha misurato 2,7 secondi per un'immagine 1024x1024 a 8 step e CFG 1 su una Radeon AI PRO R9700 con i propri kernel, 1,8 volte più veloce end-to-end di ComfyUI su una DGX Spark con le stesse impostazioni. Il controllo visivo del team, però, ha trovato 4 output deformi su 8 con CFG 1, contro 1 su 8 con CFG 2,5, che richiede 5,2 secondi. Più veloce non significa automaticamente più utilizzabile.
FAQ su MOSS Image API
MOSS Image è gratuito per l'uso commerciale?
I pesi e il codice incluso sono rilasciati con licenza Apache 2.0, che consente l'uso commerciale e il fine-tuning senza costi di licenza. Gli endpoint ospitati stabiliscono prezzi e regole sui contenuti, mentre quantizzazioni e LoRA di terze parti mantengono i propri termini.
Base o SFT: quale dovrebbe usare l'API?
L'API ospitata usa SFT (moss-image-sft-1.0), il checkpoint perfezionato che il team consiglia per la generazione. Scarica SFT per poster e infografiche da realizzare subito; scegli Base per il fine-tuning o l'addestramento di una LoRA.
Può funzionare con 12 GB di VRAM?
Una configurazione documentata da 12 GB funziona con un workflow quantizzato e offload sulla CPU, a circa 1 MP e con un'immagine per batch.
Può modificare una foto o mantenere identico un personaggio?
No. Il backbone rilasciato non usa immagini di riferimento come condizionamento. Riutilizzare un seed con JSON modificato permette di controllare la rigenerazione, ma non conserva una fotografia caricata e non garantisce l'identità del personaggio.
Chi dovrebbe provare MOSS Image adesso
| Il tuo lavoro | Scegli MOSS Image quando | Scegli altro quando |
|---|---|---|
| Poster, menu, slide o mockup UI con testo preciso | Contano più il testo bilingue lungo e il posizionamento tramite box che i personaggi fotorealistici | Ti servono solo slogan di una riga: un modello chiuso è più rapido da usare |
| Pipeline e-commerce o editoriale | Puoi aggiungere un passaggio LLM-to-JSON e una revisione del testo, e vuoi pesi Apache 2.0 da eseguire o perfezionare in autonomia | Ti servono oggi img2img, inpainting o personaggi vincolati a un'immagine di riferimento |
| Sviluppo locale con budget limitato | 12 GB più quantizzazione sono sufficienti, oppure la finestra gratuita MOSI copre il prototipo | Ti servono throughput garantito, streaming o task asincroni: l'API ospitata non offre ancora nessuna di queste opzioni |
Per il design ricco di testo, quando vuoi poter specificare anche il layout, MOSS Image è uno dei rari modelli open source in cui il sistema di vincoli è il vero prodotto. Per tutto ciò che richiede che un volto resti lo stesso volto, consideralo un motore tipografico da affiancare a un modello di immagini chiuso, non un sostituto.