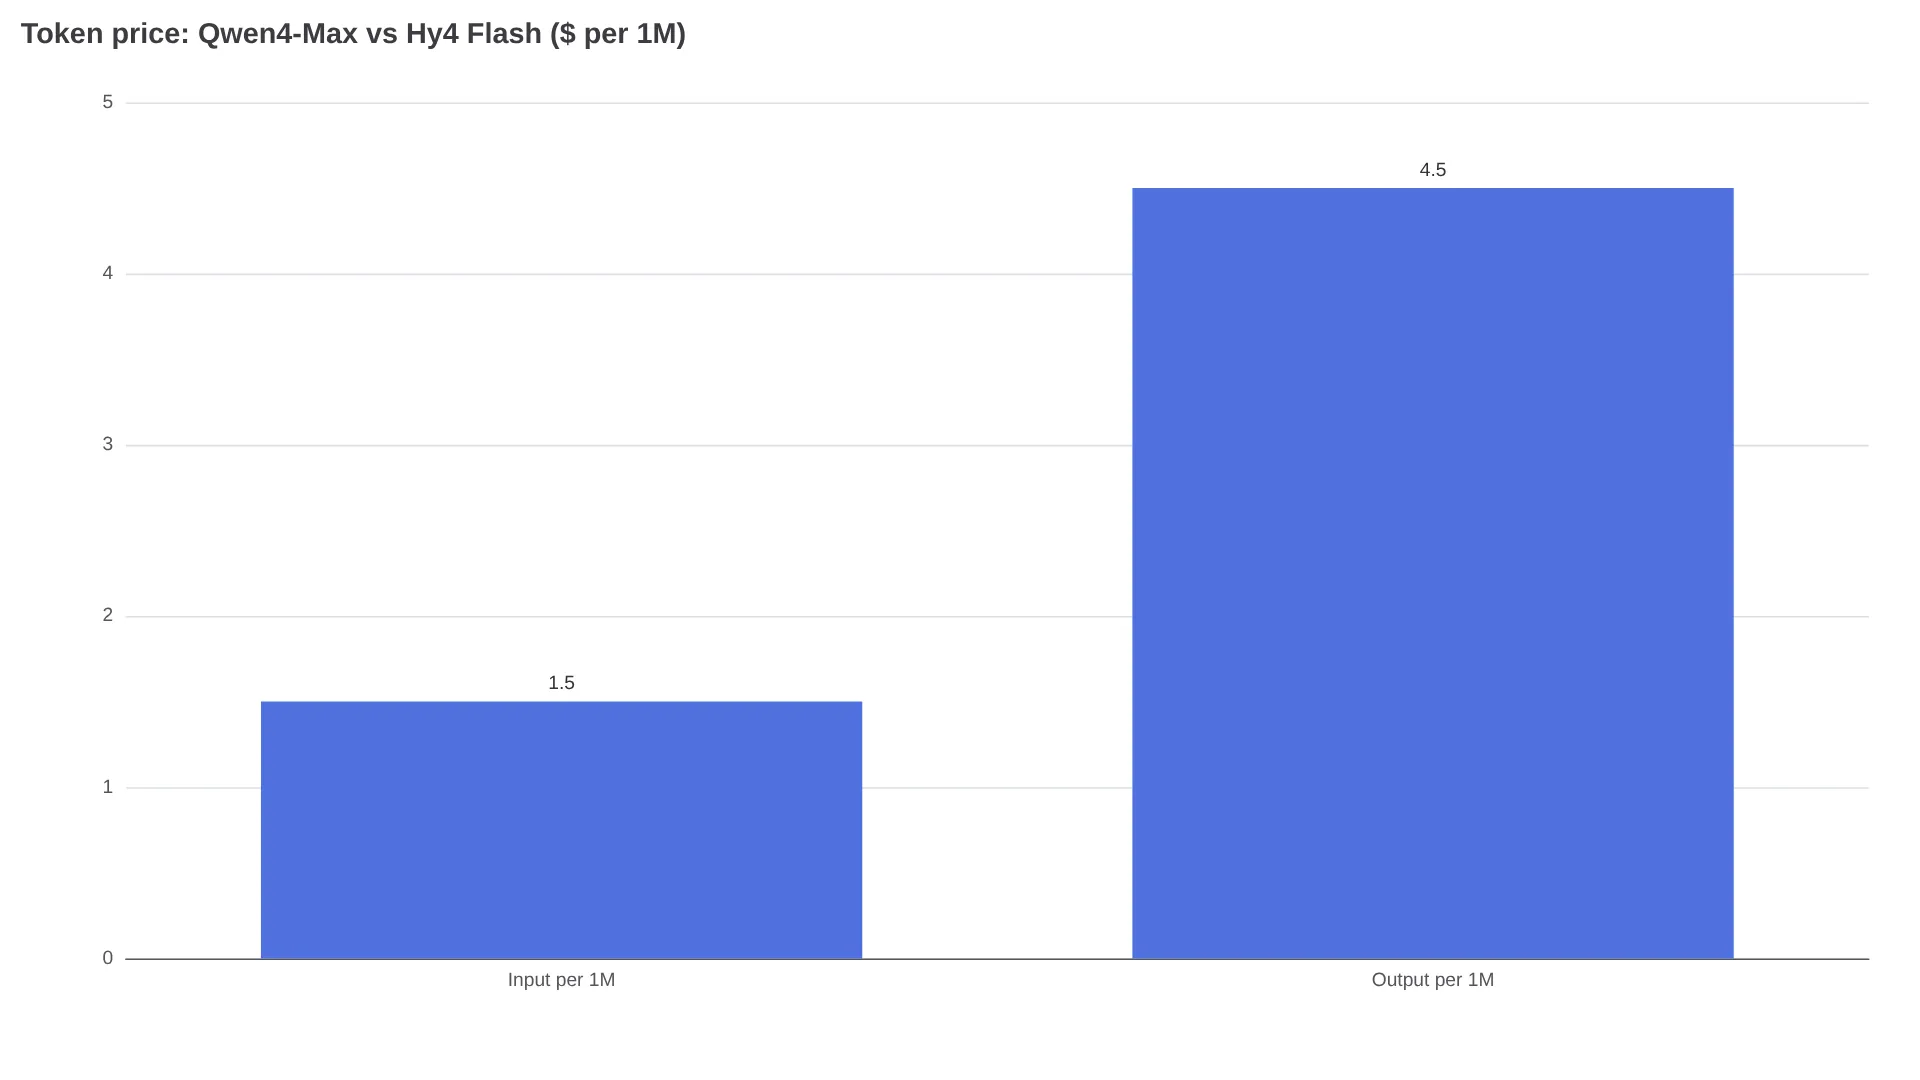
Sui benchmark citati per coding complesso e workflow articolati, Qwen4-Max supera Hy4 Flash; Hy4 Flash, però, costa molto meno a ogni tentativo. QwenCloud quota Qwen4-Max $1.50/$4.50 per milione di token, mentre Tencent indica $0.070/$0.281 per Hy4 Flash: circa 21 volte di più sull'input e 16 volte sull'output. Per un agente, il conto finale non dipende solo dal listino: incidono token di ragionamento, retry e riuso della cache. In questa recensione dei prezzi API di Qwen4 Max mettiamo a confronto il contesto da 1M, i backbone da 2.4T e 224B e le stime dei vendor sul costo per task, per capire a quale carico assegnare ciascun modello.
Prezzi a listino, a colpo d'occhio
| Voce | Qwen4-Max (Singapore / internazionale) | Hy4 Flash (TokenHub internazionale) |
|---|---|---|
| Input per 1M | $1.50 | $0.070 |
| Output per 1M (ragionamento incluso) | $4.50 | $0.281 |
| Lettura input in cache per 1M | $0.075 | $0.003 |
| Creazione esplicita della cache per 1M | $1.875 (5 min) / $3.00 (1 ora) | Non comunicata separatamente |
| Totale misto: 0.5M input + 0.5M output | $3.00 | ~$0.176 |
| ID modello | qwen4-max tramite QwenCloud | Hy4 Flash tramite Tencent |
Una sessione di coding agentico con 60.000 token in input e 4.000 in output rende bene visibile lo scarto. Con Qwen4-Max si spendono $0.09 per l'input e $0.018 per l'output, ovvero circa $0.108 a tentativo. Hy4 Flash costa $0.0042 più $0.0011, circa $0.0053 per tentativo: all'incirca 20 volte meno prima di considerare i retry. Con input interamente in cache, gli stessi 60k token di input costano $0.0045 su Qwen4-Max e $0.00018 su Hy4 Flash, prima dell'output. QwenCloud fattura il ragionamento come output; per Hy4 Flash l'output costa $0.281 per milione, quindi output più brevi riducono direttamente i token fatturati.
Cosa dicono i backbone sui costi
Qwen4-Max è un modello MoE da 2.4T parametri, con 71B parametri attivi per token (Offloop, DataCamp); Hy4 Flash è un LatentMoE da 224B, con 12B parametri attivi, inferenza a 4 bit e una velocità dichiarata di oltre 150 token al secondo (Tencent). Per la fattura conta il volume di output effettivamente prodotto: nei test Qwen4-Max ha raggiunto 127M token in output, contro una mediana dei concorrenti di 78.6M (DataCamp), mentre il post-training di Hy4 Flash ha ridotto del 50% la lunghezza media dell'output (Tencent).
Il prezzo che si paga davvero
A Singapore, QwenCloud applica $1.50 per l'input, $4.50 per l'output e $0.075 per le letture da cache. Il limite massimo è di 991,808 token in input senza thinking e 983,616 con thinking, con 131,072 token in output a thinking disattivato e 262,144 token complessivi (QwenCloud). Altri deployment, in Virginia, Francoforte, Tokyo e Hong Kong, indicano $1.413 / $4.24 / $0.071 (tabella regionale via Offloop).
Per i nuovi account pay-as-you-go di Singapore viene pubblicizzato un credito gratuito di 1 milione di token, soggetto a condizioni (Xenospectrum). Il percorso Token Plan di qwen4-max-preview verrà ritirato il 25 novembre 2026 e non ha mai coperto i backend di produzione (note di migrazione).
Per il modello flash, Hy4 Flash indica $0.070 / $0.281 / $0.003, contro $0.834 / $2.501 / $0.042 del flagship Hy4 completo (Tencent). Fino al 30 novembre 2026, TokenHub era a metà prezzo, con input effettivo di circa $0.035 (Tencent). Per la disponibilità, controllate OpenRouter. Dettagli: prezzi di Hy4 Flash.
I tre fattori che determinano la spesa reale
Primo: il ragionamento condivide il budget dell'output ed è fatturato come output. Qwen4-Max usa per impostazione predefinita high, con un budget thinking di 131,072 token; le alternative sono xhigh e low. Il test SVG di Simon Willison via OpenRouter, riassunto da Offloop, ha usato 6,362 token con high e 26,295 con xhigh a parità di prompt: 4.1 volte i token fatturabili. In modalità thinking, impostare max_completion_tokens a 10,000 significa avere 10,000 token totali per ragionamento più risposta.
Secondo: verbosità e retry si sommano. I dati compilati da Alibaba e riportati da Offloop attribuiscono a Qwen4-Max circa 105,000 token di output per task benchmark, contro 171,000 per Qwen3.8-Max: un taglio del 39%, ma ancora ben oltre la mediana dei concorrenti. Un benchmark Reddit in sandbox, composto da 56 task con due tentativi ciascuno, 112 tentativi totali (thread), ha rilevato 64 successi per Qwen4-Max Preview contro 61 per DeepSeek V4.1 Flash, con 16 timeout contro 4 e circa 13 minuti per task contro 7. Ogni timeout ritentato genera un'altra richiesta fatturabile.
"i 16 timeout di qwen pesano molto in quel 64 contro 61." — u/the_crooked_badger, thread r/DeepSeek
Terzo: il riuso della cache favorisce gli agenti a contesto lungo. La lettura da cache di Qwen4-Max a $0.075 costa il 95% in meno dell'input standard; un commentatore nel thread r/Qwen_AI ha segnalato 112M di input in cache contro 14M senza cache. La lettura cache di Hy4 Flash a $0.003 è comunque 25 volte più economica, ma incide meno quando il conto è dominato da cicli di ragionamento aggiuntivi. Come ha scritto @MarcosRGjr, "Ignore the per-token price. Agents get billed per task" (post).
Quanto dichiarano i vendor per task, e cosa mostrano le fonti esterne
Confronto tra dichiarazioni dei vendor e proxy esterni, non un testa a testa verificato.
| Dichiarazione | Valore | Base |
|---|---|---|
| Alibaba Work360, Qwen4-Max contro Qwen3.8-Max (interno al vendor, via DataCamp) | $1.67 contro $4.43 per task tentato | Suite da 721 campi, circa 35% di token in meno con high |
| Grafico Alibaba con righe AA, Qwen4-Max contro Qwen3.8-Max (compilato dal vendor, via Offloop) | $3.27 contro $10.02 per task benchmark | xhigh, 105K contro 171K token in output |
| Tencent WorkIndex, Hy4 Flash contro Hy4 completo (interno al vendor, via Tencent e analisi) | ¥0.2 contro ¥5.7 per task | Suite office di 8 set |
| Test alla cieca Tencent, Hy4 Flash contro Claude Haiku 5.5 (condotto dal vendor, via Tencent) | ¥0.26, 2.79/4 contro ¥4.73, 2.81/4 | 85 utenti, 259 task, 6.7 contro 6.8 min |
Su Work360, Qwen4-Max ottiene 52.69 contro 47.74 di Qwen3.8-Max; l'Intelligence Index sale da 34 a 43, restando dietro a Kimi K3.1 Pro con 46 e Opus 5.5 con 59 (Offloop, LLM Leaderboard).
I risultati esterni riprodotti nei grafici dei vendor delimitano queste affermazioni. Test affiliati a Vals, tramite la guida di LLM Leaderboard, hanno misurato Qwen4-Max al 63.20% per $9.33 a test, contro GPT-6.1 Sol al 63.94% per $3.61. Nel grafico di Tencent, Terminal-Bench 4.0 assegna a Qwen4-Max 48.5% e a Hy4 Flash 19.2% (Hy4 completo 44.4%); ProgramBench mostra 31.5 contro 16.0 (Offloop). AutomationBench-AA indica 72.5% per Qwen4-Max (DataCamp) contro 52.2 per l'automazione di Hy4 Flash (Tokenstrom).
Il costo atteso per successo equivale al costo per tentativo diviso per la probabilità di successo. Solo a scopo illustrativo: $0.108 / 0.485 ≈ $0.22 per Qwen4-Max, contro $0.0053 / 0.192 ≈ $0.028 per Hy4 Flash, una distanza di circa 8 volte. I tassi dei benchmark non coincidono con i tassi di retry in produzione. A questi volumi di token, Qwen4-Max deve avere una probabilità di successo circa 20 volte superiore, oppure offrire risparmi equivalenti su tool, latenza e correzioni, per prevalere sul solo costo in dollari.
Assegna il modello al carico giusto, poi verifica con 30 replay
| Profilo dell'agente | Scelta predefinita consigliata | Motivo |
|---|---|---|
| Coding complesso, a lungo orizzonte, e lavoro da terminale | Qwen4-Max con high | Un tasso di successo superiore (48.5 contro 19.2, 31.5 contro 16.0) può giustificare il sovrapprezzo quando fallimenti o correzioni sono costosi |
| Cicli office ad alto volume: slide, documenti, correzione di fogli, computer-use | Hy4 Flash | ¥0.2 contro ¥5.7 su WorkIndex, parità con Claude Haiku 5.5 (2.79 contro 2.81) a circa un diciottesimo del costo |
| Pipeline in cache ed estrazione batch | Hy4 Flash come default; Qwen4-Max quando il replay dimostra un risparmio sulla qualità | Confrontate $0.003 contro $0.075 per le letture cache, più il costo delle correzioni sui vostri documenti |
Prima di scegliere definitivamente, riproducete 30 dei vostri task su entrambi i modelli. Per ogni successo, conteggiate i token di ragionamento più output, registrate chiamate ai tool, timeout, correzioni e tempo mediano insieme ai costi.
FAQ
Quanto costa l'API di Qwen4 Max per milione di token?
QwenCloud Singapore indica $1.50 per l'input, $4.50 per l'output e $0.075 per le letture in cache. Nelle altre regioni risultano $1.413 / $4.24 / $0.071. Hy4 Flash indica $0.070 per l'input, $0.281 per l'output e $0.003 per la cache.
I token di reasoning o thinking vengono fatturati come output?
Qwen4-Max fattura il thinking a $4.50 all'interno di un budget condiviso di 262,144 token. L'output di Hy4 Flash costa $0.281, quindi output più brevi riducono i token fatturati.
Qual è il limite di contesto utilizzabile, non quello nominale di 1M?
QwenCloud documenta 991,808 token in input senza thinking e 983,616 con thinking, 131,072 token in output con thinking disattivato e 262,144 token complessivi. Tencent indica un contesto da 1M per Hy4 Flash. Lasciate un margine di sicurezza.
Qwen4-Max o Hy4 Flash costa meno per task agentico completato?
Per tentativo, Hy4 Flash costa circa 20 volte meno; Tencent dichiara un costo per task pari a un ventesimo di Hy4 completo e a un ottavo di DeepSeek-V4.1-Flash-1017 ai prezzi di picco (Tencent). Nel calcolo illustrativo precedente, resta circa 8 volte più economico per successo atteso, ma Qwen4-Max può prevalere quando meno fallimenti e meno correzioni compensano il prezzo dei token.