 AIREITER
Il prezzo dichiarato è identico: $0.10 per 1 milione di token in input. Eppure, con lo stesso documento di policy ripetuto, una soluzione può costare $520 e l’altra $70. In pratica, OpenAI Decisions API è più adatta ai transcript degli agenti con contesto ricorrente; Gemini Decisions API dà il meglio con audio, video e checklist fino a 1.000 regole.
Stesso prezzo in vetrina, conto diverso
OpenAI Decisions API e Gemini Decisions API applicano entrambe $0.10 per 1 milione di token in input non memorizzati nella cache e non addebitano i token di output. OpenAI Decisions API è diventata generalmente disponibile il 22 ottobre 2026 con il modello gpt-6-luna; Gemini Decisions API è arrivata l'11 novembre 2026 in v1beta, con il modello gemini-decision-1. A determinare quale sia davvero più economica non è il logo, ma la ripetizione dell'input e il tipo di contenuto inviato.
| Parametro | OpenAI Decisions API | Gemini Decisions API |
|---|---|---|
| Modello | gpt-6-luna | gemini-decision-1 |
| Stato | GA dal 22 ottobre 2026 (documentazione OpenAI) | Preview v1beta dall'11 novembre 2026 (annuncio Google) |
| Domande per richiesta | 1–400 (documentazione OpenAI) | 1–1.000 (annuncio Google) |
| Finestra di contesto | Moltiplicatore 2x per contesti lunghi oltre 272K token | 262.144 token |
| Input | Testo, immagini, input_json, conversazioni e tool call | Testo, immagini, audio, video, PDF |
| Costo output | $0 | $0 |
| Input in cache | $0.01 per 1 milione di token, prefisso ≥1.024 token | Non supportato |
| Tier gratuito | Nessun tier gratuito separato dichiarato | Sì, in AI Studio: 200 RPM / 50K TPM / 10K RPD |
| Latenza dichiarata | Circa 10 volte più veloce della Responses API | 50–100 ms di calcolo del modello, 150–250 ms end-to-end fino a 16K token |
| Enterprise | ZDR, HIPAA, aree US/UE (+10%) | Supporto Cloud in arrivo |
Come si presenta davvero una richiesta
OpenAI Decisions API usa POST /v1/decisions con un array ordinato di domande, ciascuna con un name opzionale. Gemini Decisions API usa invece client.decisions.create() con una mappa indicizzata da ID scelti dallo sviluppatore. I tipi di domanda sono tre in entrambi i casi, ma cambiano nomi e limiti.
In OpenAI troviamo predicate (probabilità da 0 a 1), choice (categorie non ordinate) e score (livelli ordinati da 2 a 10, con media pesata sulla probabilità), secondo la guida OpenAI. Gemini propone invece noul (sì/no, probabilità da 0.01 a 0.99), choice (da 2 a 255 opzioni) e score (da 2 a 255 livelli, con 2–10 come intervallo consigliato), come spiega l'annuncio Google. Le domande contenute nella stessa richiesta sono indipendenti su entrambe le piattaforme: per concatenare la logica servono codice applicativo o una seconda chiamata.
Tre dettagli che fanno saltare una migrazione
Gemini ordina alfabeticamente le chiavi di choice prima di calcolare il punteggio. Un'opzione generica chiamata none_of_the_above, per esempio, può finire prima di shipping (comportamento documentato). OpenAI ripropone il name della domanda nell'array delle risposte, mentre Gemini restituisce una mappa indicizzata dall'ID della domanda. Inoltre, noul di Gemini non restituisce mai un valore superiore a 0.99: una soglia >0.99 non scatterà mai.
Differisce anche la gestione dei rifiuti. OpenAI può restituire un refusal per una singola domanda e rispondere comunque alle altre, come indicato nella guida OpenAI. Gemini invece rifiuta l'intera richiesta con HTTP 400 quando scattano i controlli di sicurezza o sui contenuti vietati, usando codici come safety e prohibited_content.
"Una cosa curiosa è che Decisions e la normale generazione di testo sembrano usare percorsi separati per caching e inferenza." — u/Balance- su r/OpenAI
Se devi supportare entrambe le API, conviene progettare un adapter sottile. Uniforma gli ID delle domande, rinomina le chiavi di Gemini per evitare sorprese nei pareggi alfabetici e limita a ≤0.99 le soglie usate con Gemini.
Cosa accetta ciascuna API e cosa dovrai costruire
Gemini Decisions API accetta nativamente testo, immagini, audio, video e PDF all'interno dello stesso input. OpenAI Decisions API supporta testo, immagini, input_json, cronologia delle conversazioni, function call e output dei tool, ma non file né audio. La differenza si vede subito: in un caso il preprocessing scompare, nell'altro entra a far parte dell'architettura.
Una registrazione di chiamata insieme ai dati dell'account arriva direttamente a Gemini, senza trascrizione. Lo stesso vale per un PDF scansionato di una richiesta di risarcimento accompagnato dalle foto dei danni, senza passare dall'OCR. Un transcript di un agente con tool call, invece, arriva a OpenAI in modo nativo con corrispondenza tramite call_id; con Gemini bisogna prima appiattirlo in testo. OpenAI supporta inoltre immagini inserite nelle instructions della domanda, utili per confrontare candidato e riferimento.
Il conteggio dei token per le immagini cambia da un fornitore all'altro. In un test pratico indipendente (System Design Academy), una foto di un uovo da 224×224 pixel contava 523 token di input su OpenAI con tre domande, contro una stima di 390 token su Gemini Low (257 token immagine), 663 su Medium e 1.223 su High, pari a $0.039, $0.066 e $0.122 ogni 1.000 foto.
Le dichiarazioni sulla latenza provengono dai vendor. Google indica 150–250 ms end-to-end e una crescita quasi piatta passando da 1 a 100 domande, fino a 16K token. OpenAI dichiara una velocità circa 10 volte superiore alla Responses API, senza fornire un valore assoluto. Le esperienze degli utenti, però, sono meno uniformi:
"Velocità e costi. Le risposte sono praticamente immediate e costano una frazione." — u/zyeus-guy su r/OpenAI
Ho provato Gemini Decision 1 sul tier gratuito: routing corretto 30/30 con mediana di circa 0,24 s e ripetizioni deterministiche, ma ha scelto con grande sicurezza la categoria sbagliata quando mancava "other". — test pratico su r/GeminiAI
Considera quindi la latenza dichiarata dal vendor come un limite da verificare e superare nei test, non come uno SLA di produzione.
Quanto costano davvero 1 milione di richieste
Su entrambe le API l'input condiviso viene fatturato una sola volta per richiesta. Aggiungere domande incide soltanto sui token delle istruzioni. La vera differenza emerge quando lo stesso input viene ripetuto tra richieste diverse: OpenAI lo mette in cache, Gemini lo fattura ogni volta.
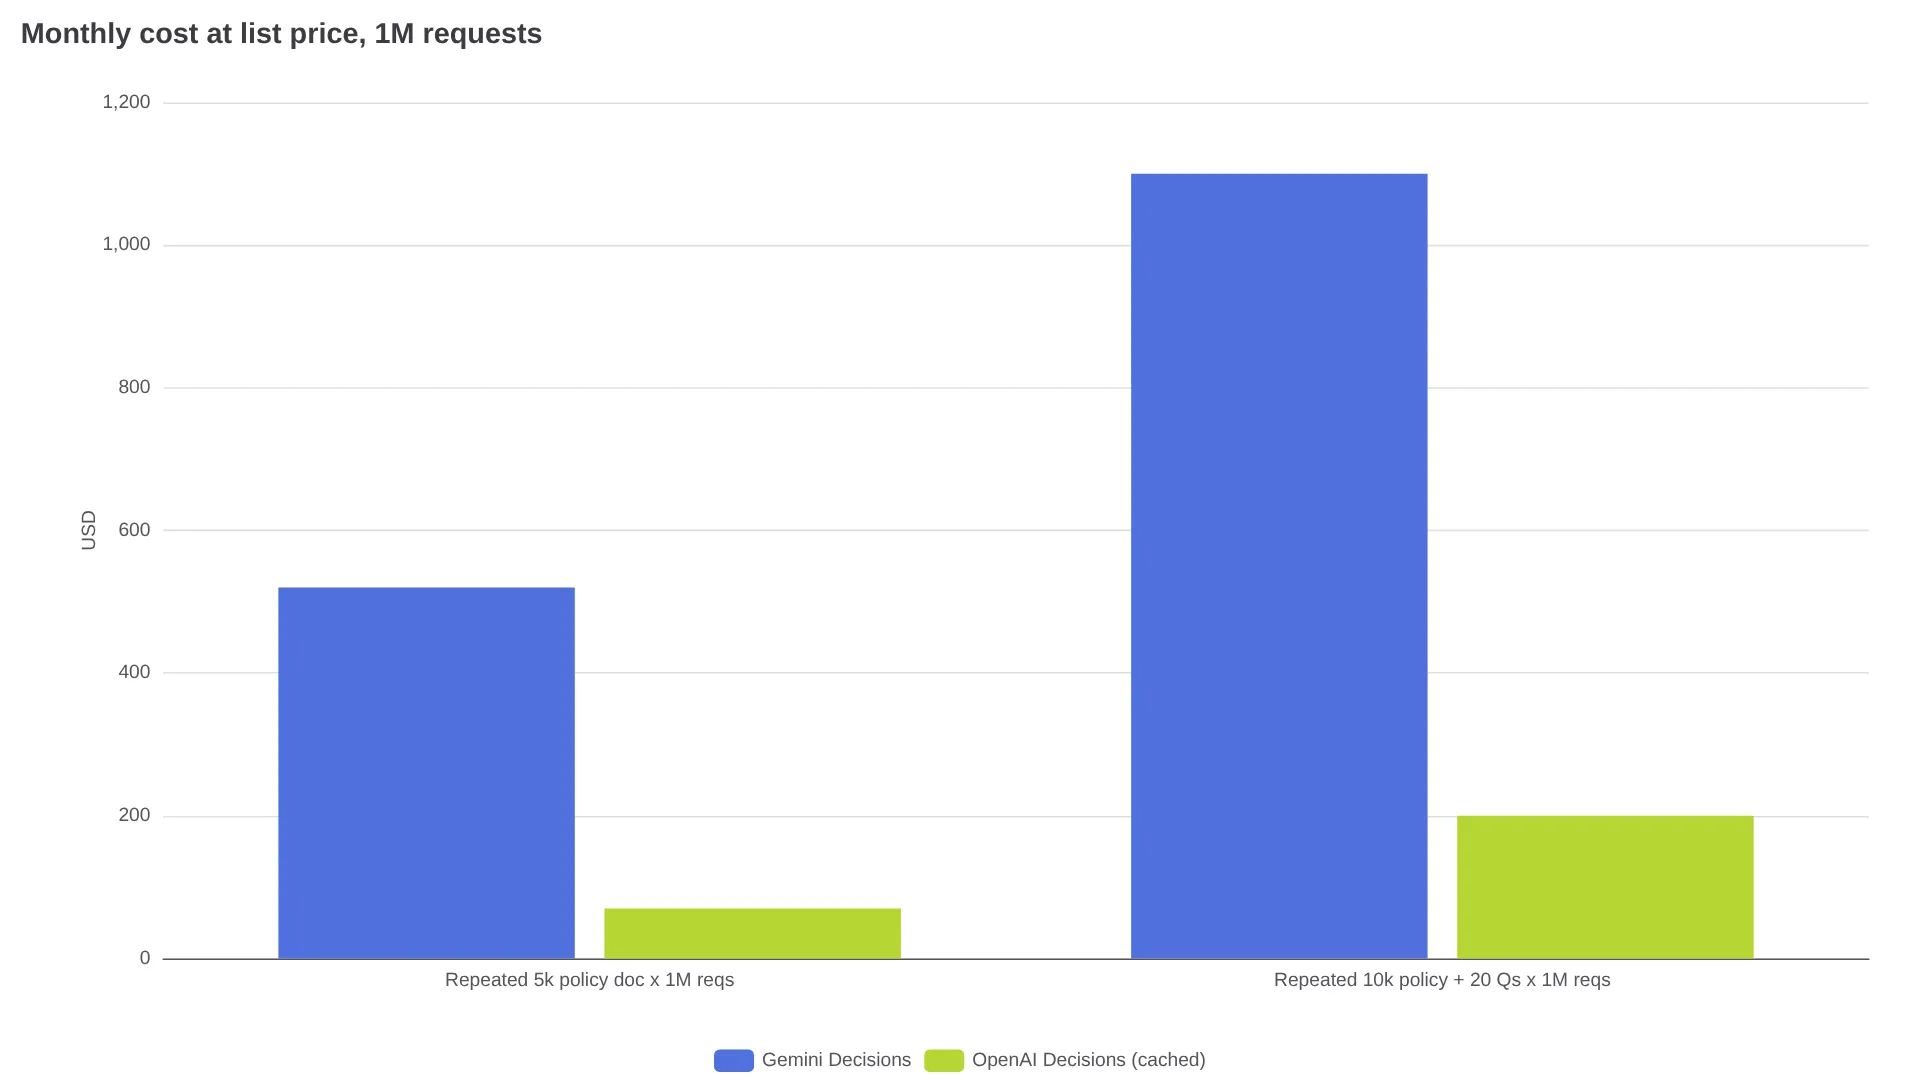
Il calcolo, puramente indicativo e basato sui prezzi di listino, segue lo schema pubblicato da Apidog e BaristaLabs e considera gli hit della cache OpenAI prima dei costi di scrittura:
- 1 milione di ticket con la stessa policy da 5.000 token più 200 token nuovi: circa $520 con Gemini, circa $70 con OpenAI grazie alla cache.
- 1 milione di richieste con la stessa policy da 10.000 token più 20 domande da circa 50 token: circa $1.100 con Gemini, circa $200 con OpenAI, più i costi di scrittura.
Con input nuovi e unici il vantaggio scompare: un messaggio da 400 token senza prefisso riutilizzabile costa la stessa tariffa di $0.10 per 1 milione su entrambe le piattaforme. Più della scelta del modello conta il batching: una richiesta con 20 controlli su un record da 4.000 token costa circa $0.50 ogni 1.000 record, mentre 20 richieste separate arrivano a circa $8.10.
Le conversazioni lunghe, in cui ogni turno rilegge il contesto precedente, favoriscono la cache. In una simulazione, un router da 30 turni che legge 124.680 token costa circa $12.47 ogni 1.000 chat su Gemini Decision 1 senza caching, contro circa $6.31 su un modello con cache.
Quanto è affidabile il numero restituito?
Nella tabella riportata da Google e riassunta da AIToolsReview, Decision 1 supera Luna in tutti i test condivisi, con un ECE top-1 di 0.0250 contro 0.0721 per Luna e 0.0494 per Jev 1.14. Nel public split di JevBench i risultati sono 92.2% per Decision 1, 90.9% per Luna e 90.0% per Jev 1.14. Il costo totale della suite è stato di $0.88 per Decision 1, $0.68 per Jev e $0.93 per Luna.
Una classifica indipendente di Artificial Analysis, citata nella stessa recensione, assegna a Decision 1 un Decision Index di 66: è a pari merito con Jev 1.14 e al 9° posto su 18, circa 7 punti dietro Drex Max v1.1. Nel test When2Call, Decision 1 raggiunge il 75.2%, Jev l'80.8% e Drex Max il 94.6%, con un costo di $345 per 1 milione di task e 211 ms per Decision 1, contro $156 e 92 ms per Jev.
Per automatizzare decisioni basate su soglie, la calibrazione conta più dell'accuratezza dichiarata in prima battuta. Una confidenza di 0.90 dovrebbe corrispondere a una risposta corretta circa 9 volte su 10 sulla distribuzione reale di deployment. Valida le soglie su 200–500 casi etichettati e misura l'accuratezza per fascia di confidenza.
"Confidenza: le probabilità calibrate in stile Jev non sono una funzione restituita da tutti gli endpoint compatibili con OpenAI." — u/xapep su r/LLMDevs
Si ripresentano soprattutto due problemi. I primi test pratici segnalano su OpenAI una tendenza a preferire la prima scelta (@NatashaTheRobot); nel test pratico di Gemini citato sopra, l'assenza di un'opzione generica porta a scegliere la categoria meno sbagliata invece di astenersi. Per ridurre entrambi i rischi, aggiungi un'opzione other, un predicato separato per verificare l'ambito, descrizioni brevi e ben distinte e un controllo umano sotto la soglia.
Checklist di produzione prima del rilascio
OpenAI è GA, offre caching, report sull'utilizzo tramite GET /v1/organization/usage/decisions, ZDR e HIPAA per i clienti idonei, oltre all'elaborazione regionale negli Stati Uniti e nell'UE con un sovrapprezzo del 10%. Gemini è in v1beta, con il supporto Cloud in arrivo. Entrambi i vendor elencano integrazioni con framework come OpenRouter, LangChain, Vercel e LiteLLM.
Le regole della cache influenzano direttamente l'architettura. OpenAI riutilizza un prefisso di input condiviso di almeno 1.024 token; il contenuto delle domande non conta per raggiungere il minimo. Gemini non offre context caching né tier Batch, Flex o Priority. Per i prototipi gratuiti Gemini è più comodo, ma i contenuti del tier gratuito possono essere usati per migliorare i prodotti Google: per questo, tieni i dati reali dei clienti sulle chiavi a pagamento. Prima di automatizzare azioni ad alto impatto, registra per una settimana la distribuzione dei valori di confidenza.
Scegli in base al carico di lavoro, non al logo
Un loop di routing per agenti con tool call e istruzioni ripetute porta naturalmente verso OpenAI Decisions API. La stessa scelta vale in presenza di requisiti ZDR, HIPAA o di residenza dei dati nell'UE.
Registrazioni audio, clip video o PDF scansionati da analizzare con centinaia di controlli indicano invece Gemini Decisions API. L'acquisizione nativa di audio, video e PDF elimina i passaggi di trascrizione e OCR, mentre 1.000 domande per richiesta coprono liste di regole oltre il limite di 400. Restano i limiti di budget: 100 MB inline per richiesta, 50 MB per PDF e 15 MB per URL esterno.
Con testo breve e unico e meno di 400 domande, a prezzo di listino è un pareggio. Puoi prototipare sul tier gratuito di Gemini usando dati sintetici, poi ripetere gli stessi 200–500 casi etichettati su entrambe le API e confrontare accuratezza per fascia, latenza p50/p95, token per richiesta e costo mensile.
| Carico di lavoro | Scelta |
|---|---|
| Documento di policy da 5K–10K ripetuto, QPS elevato | OpenAI Decisions API: la cache fa risparmiare oltre l'80% |
| Routing di agenti con cronologia delle tool call, voce GPT-Live | OpenAI Decisions API |
| Decisioni su audio / video / PDF, >400 regole | Gemini Decisions API |
| Testo breve e unico, <400 domande | Pareggio — scegli lo stack già in uso |
| Prototipazione gratuita | Gemini AI Studio, poi rivaluta su piano a pagamento |
Gemini è più economico di OpenAI?
Il prezzo di listino è pari: $0.10 per 1 milione di token, senza costi di output. OpenAI vince con il contesto ripetuto messo in cache; Gemini è più conveniente per la prototipazione gratuita.
OpenAI può leggere audio, video o PDF?
No: supporta solo testo, immagini, JSON e conversazioni con tool call. Gemini gestisce invece audio, video e PDF nativamente.
Quante domande si possono inviare per richiesta?
Gemini da 1 a 1.000 entro 262.144 token; OpenAI da 1 a 400.
Gemini è pronto per la produzione?
Gemini è in v1beta e il supporto Cloud è ancora in attesa; OpenAI è GA e offre ZDR, HIPAA ed elaborazione regionale.
Servono ancora Jev o un classificatore locale?
Jev indica $0.042 per 1 milione e primeggia in alcuni test di selezione dei tool; se il costo per task è il fattore dominante, includilo nel benchmark.
Come gestire una confidenza bassa?
Imposta le soglie sui dati etichettati, automatizza le decisioni sopra la soglia, invia la fascia intermedia a un modello più grande e blocca le altre per la revisione umana, sempre con un'opzione other.
Per approfondire: