 AIREITER
Con la tariffa standard, una decisione di routing basata su 500 token costa $0.00005. È un prezzo abbastanza basso da rendere l’API Decisions interessante per i flussi ad alto volume, ma non significa che sia automaticamente adatta alle azioni più delicate: le probabilità vanno comunque calibrate sui propri dati etichettati.
Il conto parte da frazioni di centesimo, non da un costo fisso per chiamata
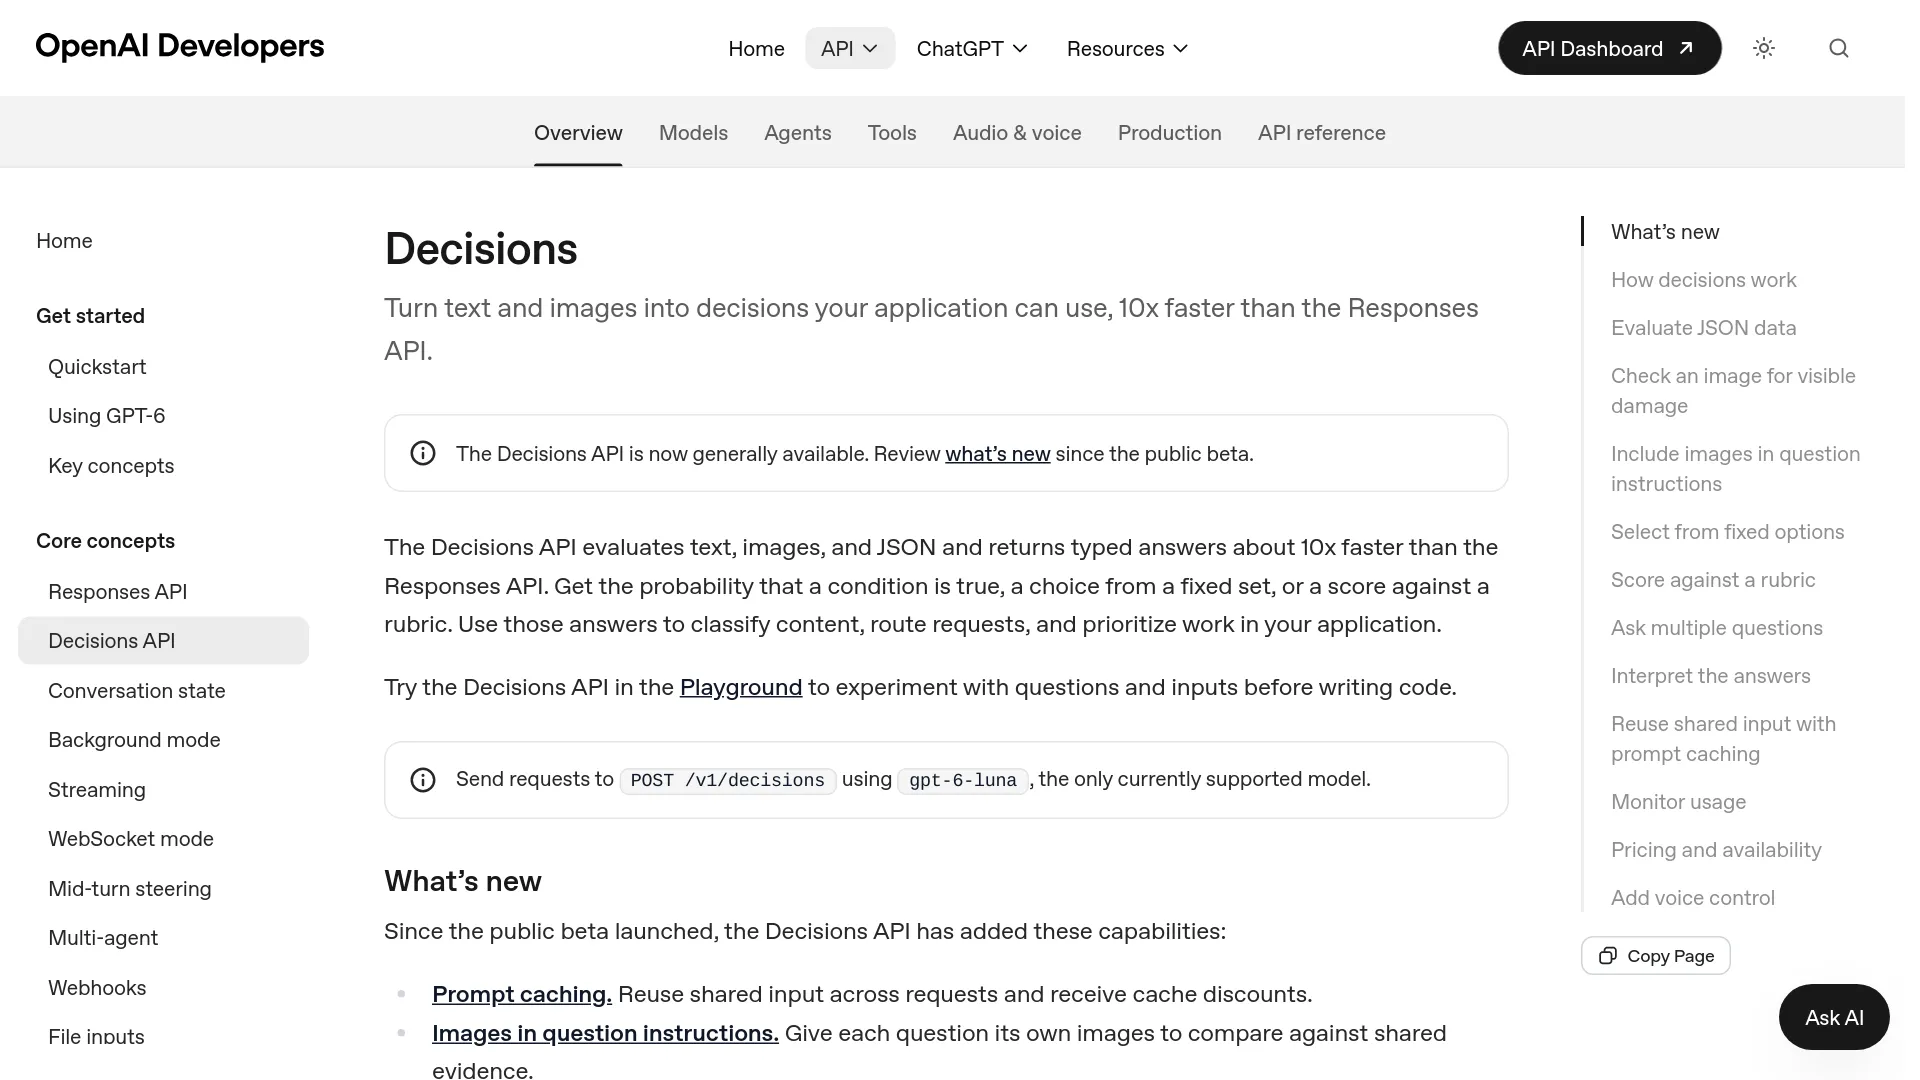
Il prezzo dell’API Decisions di OpenAI è di $0.10 per 1 milione di token in input non presenti nella cache, mentre i token di output sono gratuiti. OpenAI descrive oggi l’endpoint come generalmente disponibile, alimentato esclusivamente da gpt-6-luna e accessibile tramite POST /v1/decisions nella guida aggiornata a Decisions.
Nel listino pubblicato non compare alcun costo separato per richiesta. Il calcolo di base è:
costo mensile = richieste × media dei token di input fatturati ÷ 1,000,000 × $0.10
Quanto si spende con 10K, 100K e 1M di richieste
Consideriamo un carico di lavoro con una media di 500 token in input per richiesta:
| Richieste mensili | Token di input | Costo input standard | Costo per richiesta |
|---|---|---|---|
| 10,000 | 5 milioni | $0.50 | $0.00005 |
| 100,000 | 50 milioni | $5.00 | $0.00005 |
| 1,000,000 | 500 milioni | $50.00 | $0.00005 |
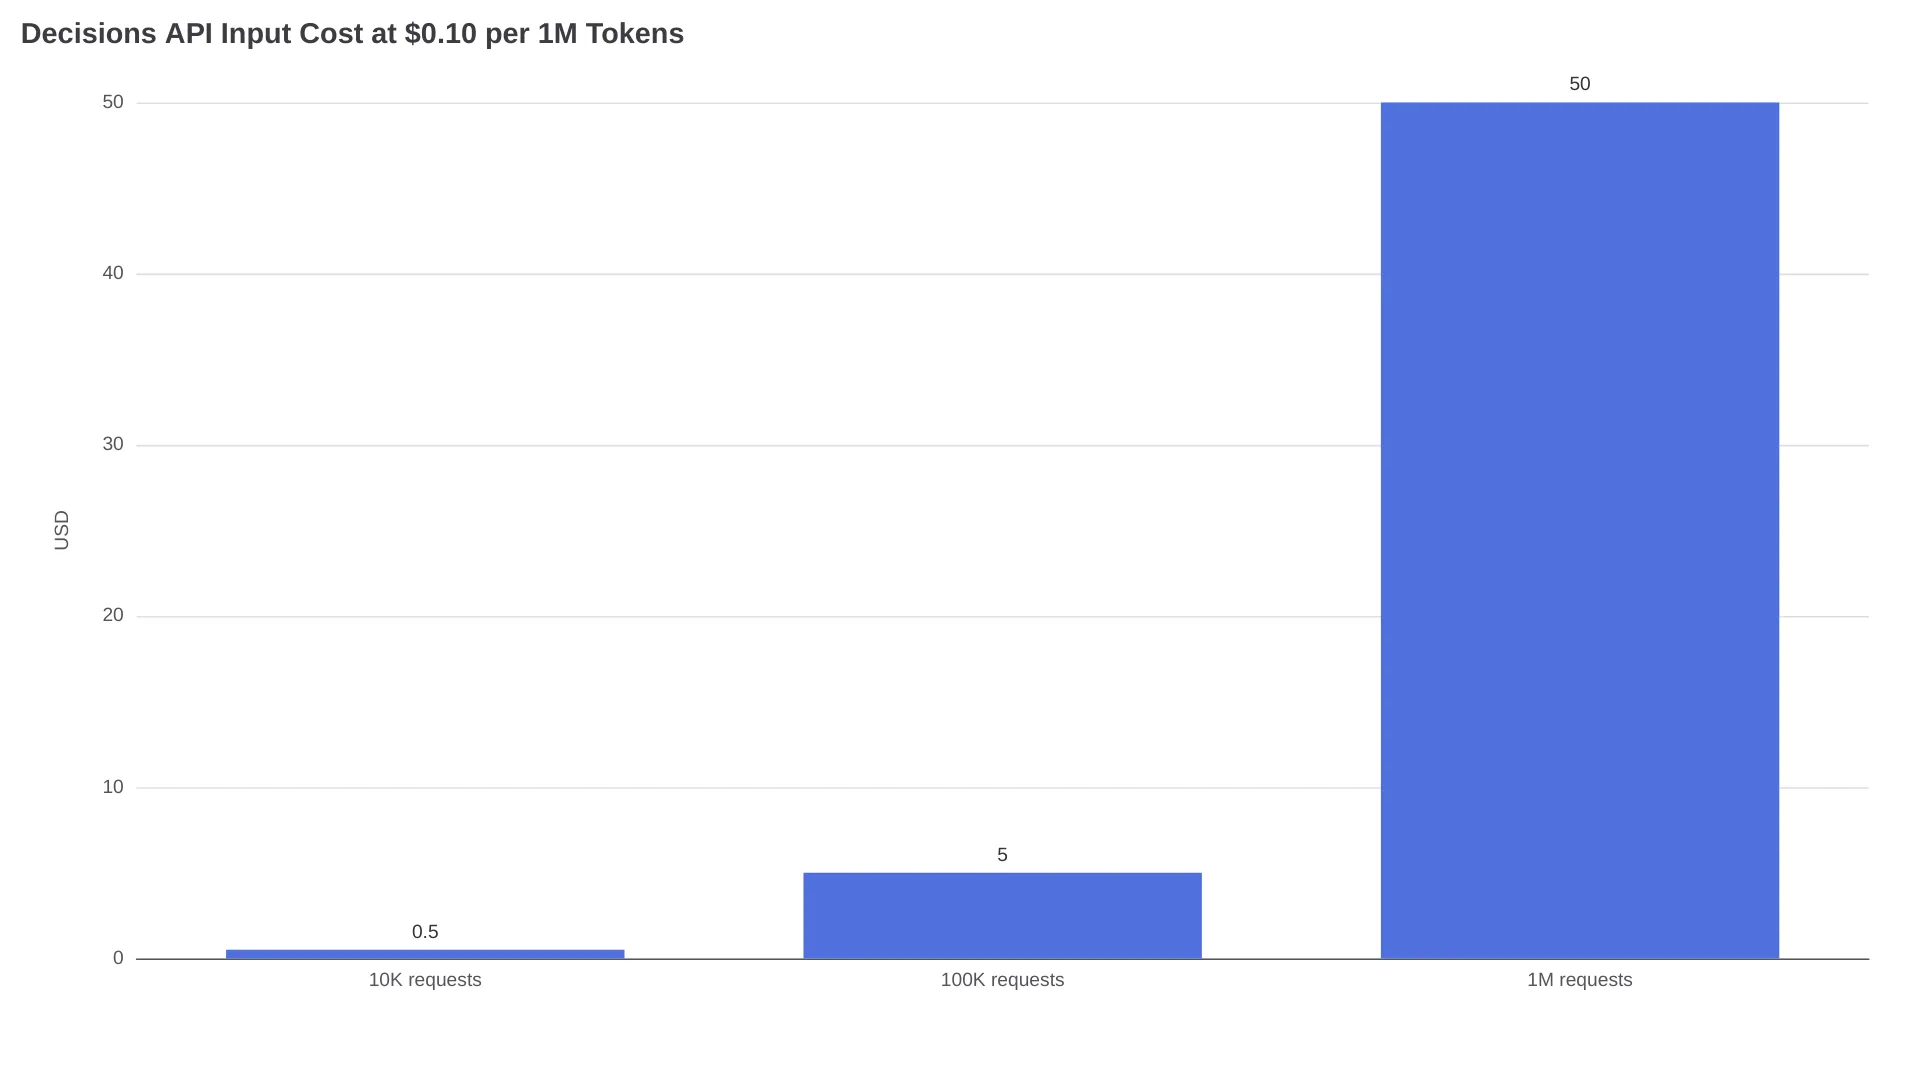
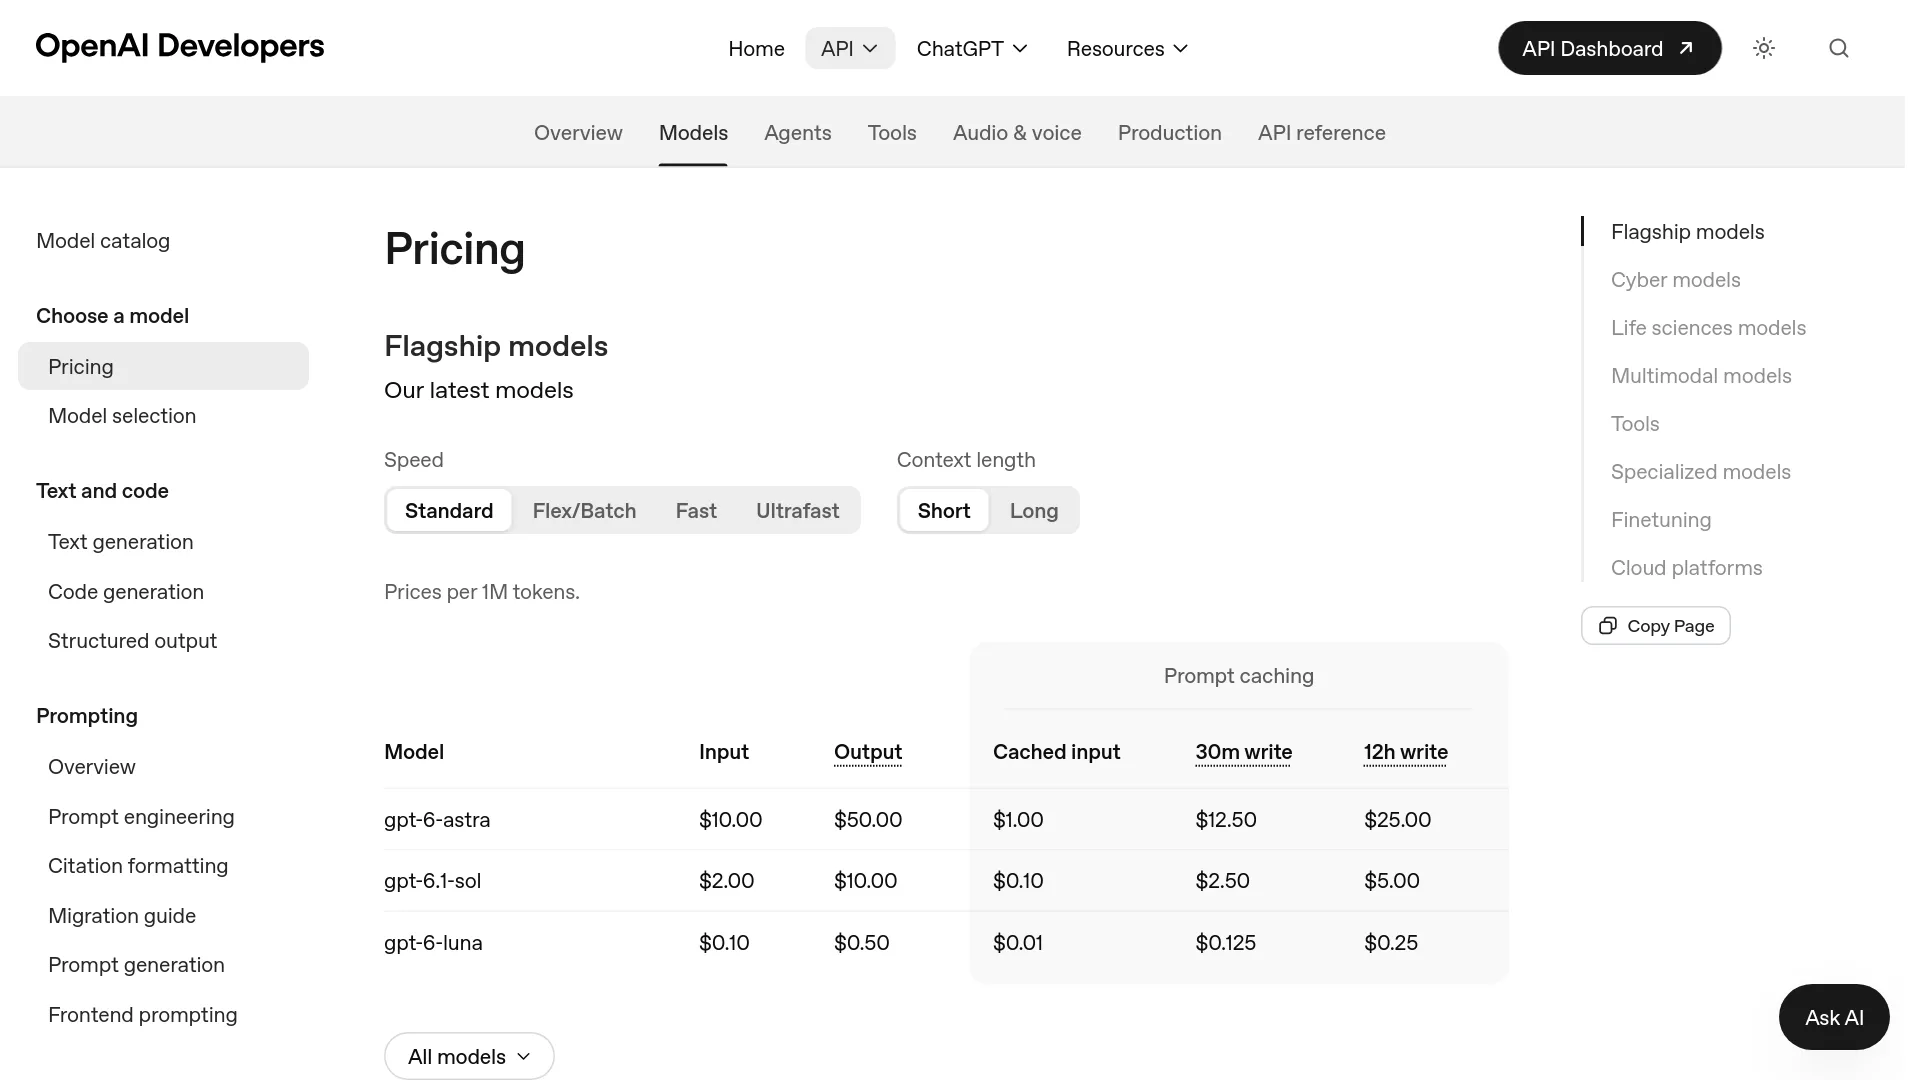
Gli output di tipo predicate, choice e score non aggiungono costi per i token generati. Un JSON equivalente prodotto con Responses viene invece fatturato alla tariffa di output del modello; la tabella dei prezzi di OpenAI indica per l’output standard di gpt-6-luna un costo di $0.50 per milione di token.
Letture e scritture della cache, trattamento regionale e contesti lunghi
Il valore di $0.10 non è l’unica tariffa possibile per l’input. La guida aggiornata specifica che le letture della prompt cache hanno un prezzo scontato, mentre le scritture in cache seguono le tariffe standard di scrittura in cache di gpt-6-luna. Il listino di OpenAI indica per l’input Luna in cache standard $0.01 per milione di token, una scrittura in cache di 30 minuti a $0.125 e una scrittura di 12 ore a $0.25 per milione di token.
Il caching si attiva solo quando il prefisso condiviso riutilizzabile contiene almeno 1,024 token. Le domande non contribuiscono a raggiungere questa soglia e le immagini specifiche di una domanda restano fuori dal prefisso riutilizzabile. Le letture e le scritture della cache sono già comprese in usage.input_tokens; aggiungerle di nuovo porterebbe a conteggiare due volte l’utilizzo, come spiega la sezione sul prompt caching.
Gli endpoint con trattamento regionale o requisiti di residenza dei dati possono applicare un incremento del 10% sui modelli più recenti idonei. La sezione ufficiale su prezzi e disponibilità avverte inoltre che possono entrare in gioco moltiplicatori per i contesti lunghi. Prima di impegnarsi su un carico soggetto a requisiti di compliance, è quindi opportuno verificare il listino aggiornato: entrambi i modificatori possono alterare il semplice calcolo basato su $0.10.
Un endpoint volutamente specializzato
L’API Decisions trasforma le informazioni disponibili in uno di tre risultati tipizzati. È pensata per classificare e assegnare punteggi, non per sostituire un endpoint generalista di generazione delle risposte a un costo inferiore.
| Tipo di domanda | Risultato | Uso adatto | Uso poco adatto |
|---|---|---|---|
predicate | Probabilità da 0 a 1 | Filtro antifrode, verifica di danni visibili, filtro di pertinenza | Una motivazione scritta della decisione |
choice | Un’opzione tra quelle fornite, probabilità delle opzioni e confidenza | Instradamento delle code, categoria del documento, prossima azione | Una categoria sconosciuta o generata dinamicamente |
score | Punteggio ponderato, probabilità dei livelli e confidenza | Gravità, urgenza, qualità di un lead | Estrazione di nomi, date o campi arbitrari |
Uno score può includere da 2 a 10 livelli ordinati. Una richiesta può contenere da 1 a 400 domande, ma nella stessa richiesta dovrebbero finire solo domande indipendenti. Se la seconda domanda dipende dalla risposta alla prima, OpenAI consiglia di inviare una seconda richiesta dopo aver ricevuto il primo risultato.
Più domande indipendenti possono riutilizzare le stesse informazioni. Per esempio, un singolo ticket di assistenza può essere analizzato per individuare una richiesta di rimborso, assegnarlo al reparto corretto e valutarne l’urgenza senza reinviare il ticket tre volte. La guida all’utilizzo chiarisce che num_model_requests conta la richiesta, non il numero di domande contenute.
Cosa è cambiato dopo la beta pubblica
L’attuale elenco What's new ha superato diversi limiti della fase di lancio:
- Il limite di domande è passato da 200 a 400.
- Il prompt caching è disponibile per gli input condivisi.
- Gli input possono includere JSON nativo, cronologia delle conversazioni, record di chiamate a funzioni e relativi output degli strumenti.
- Le immagini possono essere fornite tramite URL pubblici HTTP/HTTPS o base64 inline;
file_id, audio, file e riferimenti a item restano non supportati. - Il reporting a livello di organizzazione è disponibile tramite
GET /v1/organization/usage/decisions; richiede una chiave admin conapi.usage.reade permette di raggruppare i risultati per progetto, chiave API o modello.
Scegli tra Decisions e Responses in base al risultato che ti serve
Conviene usare l’API Decisions quando il codice dell’applicazione conosce già la forma delle risposte ammesse. Responses è più adatta quando il modello deve comporre informazioni; per scegliere uno strumento e fornirne gli argomenti, invece, la scelta corretta è il function calling.
| Esigenza | Scelta predefinita | Motivo |
|---|---|---|
| Filtro sì/no con probabilità | Decisions | Output predicate nativo, senza costi per una risposta generata |
| Selezionare un percorso noto | Decisions | Restituisce la probabilità di ogni opzione insieme alla confidenza |
| Classificare secondo una rubrica ordinata | Decisions | Score ponderato nativo e distribuzione tra i livelli |
| Restituire campi JSON arbitrari | Responses con Structured Outputs | Decisions non supporta uno schema JSON di output personalizzato |
| Spiegare perché un elemento è stato rifiutato | Responses | Decisions non genera spiegazioni in prosa |
| Scegliere uno strumento e crearne gli argomenti | Function calling | Decisions seleziona una risposta, ma non produce gli argomenti dello strumento |
Con 100,000 chiamate da 400 token di input ciascuna, l’input con Decisions costa $4. Se una chiamata equivalente a Responses producesse 30 token di output ogni volta, le tariffe pubblicate per Luna porterebbero il costo a $4 per l’input più $1.50 per l’output, cioè $5.50 prima di considerare eventuali token di ragionamento. La scelta dell’endpoint dipende comunque dal fatto che l’applicazione debba generare campi o spiegazioni.
Entrambi gli endpoint ricevono ora prezzi scontati per le letture dalla cache. Per misurare i token effettivamente letti dalla cache, usa l’oggetto di utilizzo restituito dalla risposta invece di ricavarli stimando la lunghezza del prompt.
Gli errori economici restano comunque costosi
Una fattura ridotta per i token non diminuisce il costo di un’approvazione errata, di un’azione di moderazione sbagliata o dell’instradamento scorretto di un pagamento. La guida di OpenAI all’interpretazione delle risposte consiglia di impostare le soglie usando esempi etichettati e tenendo conto del diverso impatto di falsi positivi e falsi negativi.
Lo stesso problema emerge anche nelle discussioni tra sviluppatori. In un thread Reddit sui decision API orientato alla produzione, u/Ctbhatia ha scritto:
“un gate che dice di saltare è meglio di uno che sbaglia.” Fonte: u/Ctbhatia su r/LLMDevs
Confidenza e probabilità dell’API sono segnali, non una garanzia pubblicata di calibrazione. Un risultato con confidenza 0.90 non va interpretato come corretto nel 90% dei casi finché questa relazione non è stata misurata su dati rappresentativi.
OpenAI afferma nella guida ufficiale che Decisions è circa 10 volte più veloce di Responses, ma non pubblica dati p50, p95, regione, dimensione del payload o configurazione del confronto. Prima di definire un budget di latenza, esegui benchmark nella regione in cui avverrà il deployment.
Il passaggio in produzione: calibrare, astenersi, poi automatizzare
- Crea un set di dati etichettato a partire dal carico di lavoro reale, includendo i casi ambigui e gli errori con il costo più alto.
- Esegui le stesse domande sul set e traccia i tassi di falsi positivi e falsi negativi alle diverse soglie.
- Inserisci nel codice un percorso esplicito di astensione. Le risposte con bassa confidenza o in conflitto dovrebbero passare a una revisione umana invece di forzare un instradamento.
- Monitora l’utilizzo dei token e il numero di richieste con
GET /v1/organization/usage/decisions, quindi controlla un campione dei risultati automatizzati dopo il rilascio.
Una tabella per decidere il deployment
L’API Decisions di OpenAI è la scelta predefinita giusta per valutazioni brevi, ad alto volume e con opzioni limitate, all’interno di uno stack OpenAI già esistente. Il prezzo, da solo, non è un motivo sufficiente per migrare.
| Carico di lavoro | Raccomandazione | Condizione principale |
|---|---|---|
| Instradamento di richieste di supporto o lead | Usa Decisions | Le categorie sono fisse e sono disponibili esempi etichettati |
| Analisi dei danni nelle immagini | Prova Decisions | Confronta l’accuratezza sulle immagini; ora sono supportati gli URL ospitati |
| Policy lunga più elemento breve | Testa entrambi gli endpoint | Verifica i token realmente letti dalla cache e la latenza |
| Carico di lavoro soggetto a compliance o con azioni distruttive | Usa Decisions solo come gate | Servono astensione, revisione e soglie asimmetriche |
| Estrazione più spiegazione | Usa Responses | Una singola chiamata più ricca può evitare una seconda richiesta di generazione |
| Selezione di strumenti con relativi argomenti | Usa function calling | Il contratto di output corrisponde direttamente all’azione |
| Carico di lavoro UE o regolamentato | Valuta Decisions | Conferma idoneità, residenza dei dati e sovrapprezzo regionale |
FAQ sui prezzi dell’API Decisions di OpenAI
L’API Decisions viene fatturata per richiesta o per token?
Il prezzo dipende dai token di input, non dal numero di richieste. L’input standard non presente nella cache costa attualmente $0.10 per 1 milione di token, con possibili variazioni dovute al caching e ai modificatori regionali o per contesti lunghi.
I token di output dell’API Decisions sono gratuiti?
Sì. La guida ufficiale a Decisions specifica che i token di output non vengono fatturati.
Esiste un piano gratuito?
L’attuale documentazione di OpenAI su Decisions non indica un piano gratuito dedicato. Crediti dell’account o condizioni contrattuali possono comunque influire su quanto paga una determinata organizzazione.
Il prompt caching funziona con l’API Decisions?
Sì. I prefissi di input condivisi di almeno 1,024 token possono essere idonei e OpenAI inserisce implicitamente un punto di separazione alla fine dell’input condiviso. Il contenuto delle domande e le immagini specifiche delle singole domande non fanno parte del prefisso riutilizzabile.
Decisions costa meno di Responses?
In genere sì, quando si tratta di classificazioni brevi e delimitate che non richiedono testo generato. Il vantaggio può ridursi se l’output di Responses è molto breve oppure sparire quando il flusso richiede una seconda chiamata per l’estrazione o la spiegazione.
Quante domande possono stare in una singola richiesta?
Il limite attuale va da 1 a 400 domande. Le domande indipendenti possono condividere lo stesso input; quelle dipendenti richiedono richieste separate.
Le immagini sono supportate e vengono fatturate?
Sì. Decisions accetta URL HTTP/HTTPS di immagini ospitate e immagini inline in base64; l’input immagine contribuisce all’utilizzo fatturato dell’input. I riferimenti a immagini tramite file_id non sono supportati.
Il trattamento regionale costa di più?
Può costare di più. La pagina dei prezzi di OpenAI applica un incremento del 10% agli endpoint regionali e a quelli con requisiti di residenza dei dati per i modelli più recenti idonei; prima del deployment, verifica la tariffa aggiornata per la regione di destinazione.