 AIREITER
Google ha lanciato Gemini Decisions API l'11 novembre 2026. Gemini Decision 1 assegna un risultato a scelte predefinite in un'unica elaborazione, ma il dettaglio più importante è un altro: per capire se conviene davvero rispetto a OpenAI bisogna guardare soprattutto a caching e tipo di carico.
Quanto costa una richiesta a Gemini Decisions API
Gemini Decisions API costa $0.10 per 1 milione di token di input, senza addebiti per i token di output. L'input multimodale condiviso viene conteggiato una sola volta per richiesta, indipendentemente dal numero di domande valutate. Ogni domanda aggiuntiva contribuisce soltanto con i propri token di istruzioni e criteri.
Google presenta Gemini Decision 1 come quasi 5 volte più economico, su una suite di benchmark condivisa, rispetto a Gemini 3.5 Flash-Lite usato con Interactions API. Non ci sono costi per i token di output, addebiti variabili per i token di ragionamento né spese separate per trascrizione audio o OCR. Per i prototipi è disponibile un piano API gratuito in Google AI Studio.
| Scenario (500 token di input fatturati per richiesta) | Richieste mensili | Token di input | Costo a $0.10/1M |
|---|---|---|---|
| Instradamento delle richieste al supporto | 10,000 | 5M | $0.50 |
| Filtro di moderazione | 100,000 | 50M | $5.00 |
| Selezione degli strumenti per un agente | 1,000,000 | 500M | $50.00 |
La formula è requests x average billed input tokens / 1,000,000 x $0.10. Poiché l'evidenza condivisa viene conteggiata una sola volta, inserire 50 controlli indipendenti sullo stesso ticket nella medesima richiesta aggiunge soltanto i token specifici delle domande. Il risparmio deriva dal batching, non da uno sconto applicato a ogni domanda.
Cosa può valutare Gemini Decision 1
Gemini Decision 1 (model ID gemini-decision-1) è un classificatore e valutatore progettato per questo scopo, non un modello conversazionale. Una richiesta può contenere un singolo input multimodale condiviso fino a 256K token e un massimo di 1.000 domande indipendenti. Ogni risposta include le probabilità e un punteggio di confidenza compreso tra 0 e 1.
Gli input possono essere testo, immagini, audio, video e PDF riuniti nello stesso blocco, usando lo stesso formato Content block di Interactions API. Per immagini e video è possibile regolare la risoluzione: ridurre l'evidenza a una miniatura prima dell'upload incide quindi direttamente sul costo in token. In una singola richiesta si possono combinare questi tre tipi di domanda:
| Tipo | Struttura | Risultato | Ideale per |
|---|---|---|---|
noul (sì/no) | Una condizione, con descrizioni opzionali per vero e falso | Probabilità che la condizione sia verificata | Controlli di policy, rilevamento di versamenti, filtri di rilevanza |
choice (scelta multipla) | Da 2 a 255 opzioni nominate con relativi criteri | Opzione vincente e probabilità normalizzate per ogni candidato | Instradamento al modello o alla coda, selezione dell'azione successiva |
score (rubrica ordinata) | Livelli ordinati a partire da 0 | Punteggio ponderato continuo e probabilità per ogni livello | Gravità, urgenza, qualità dei lead |
Google dichiara 50–100 ms di elaborazione mediana del modello e 150–250 ms di latenza end-to-end, misurati su input multimodali e contesti fino a 16K token. Secondo l'azienda, il dato resta quasi invariato da 1 a 100 domande per richiesta. Nei benchmark dedicati a instradamento degli agenti, ragionamento, ranking e comprensione multimodale, Google afferma inoltre che Gemini Decision 1 guida la suite con il minore errore di calibrazione. Per ora entrambe le affermazioni vanno considerate benchmark del fornitore, in attesa di dati indipendenti.
Gemini Decisions API contro OpenAI Decisions API
Il confronto più diretto è con Decisions API di OpenAI, arrivata alcune settimane prima allo stesso prezzo di listino. Gemini Decisions API pareggia OpenAI a $0.10 per 1M token di input con output tipizzati gratuiti, ma le differenze emergono su capacità, modalità supportate e caching.
| Caratteristica | Gemini Decisions API | OpenAI Decisions API |
|---|---|---|
| Modello | gemini-decision-1 | Classe gpt-6-luna |
| Prezzo di listino | $0.10 / 1M input, $0 output | $0.10 / 1M input, $0 output |
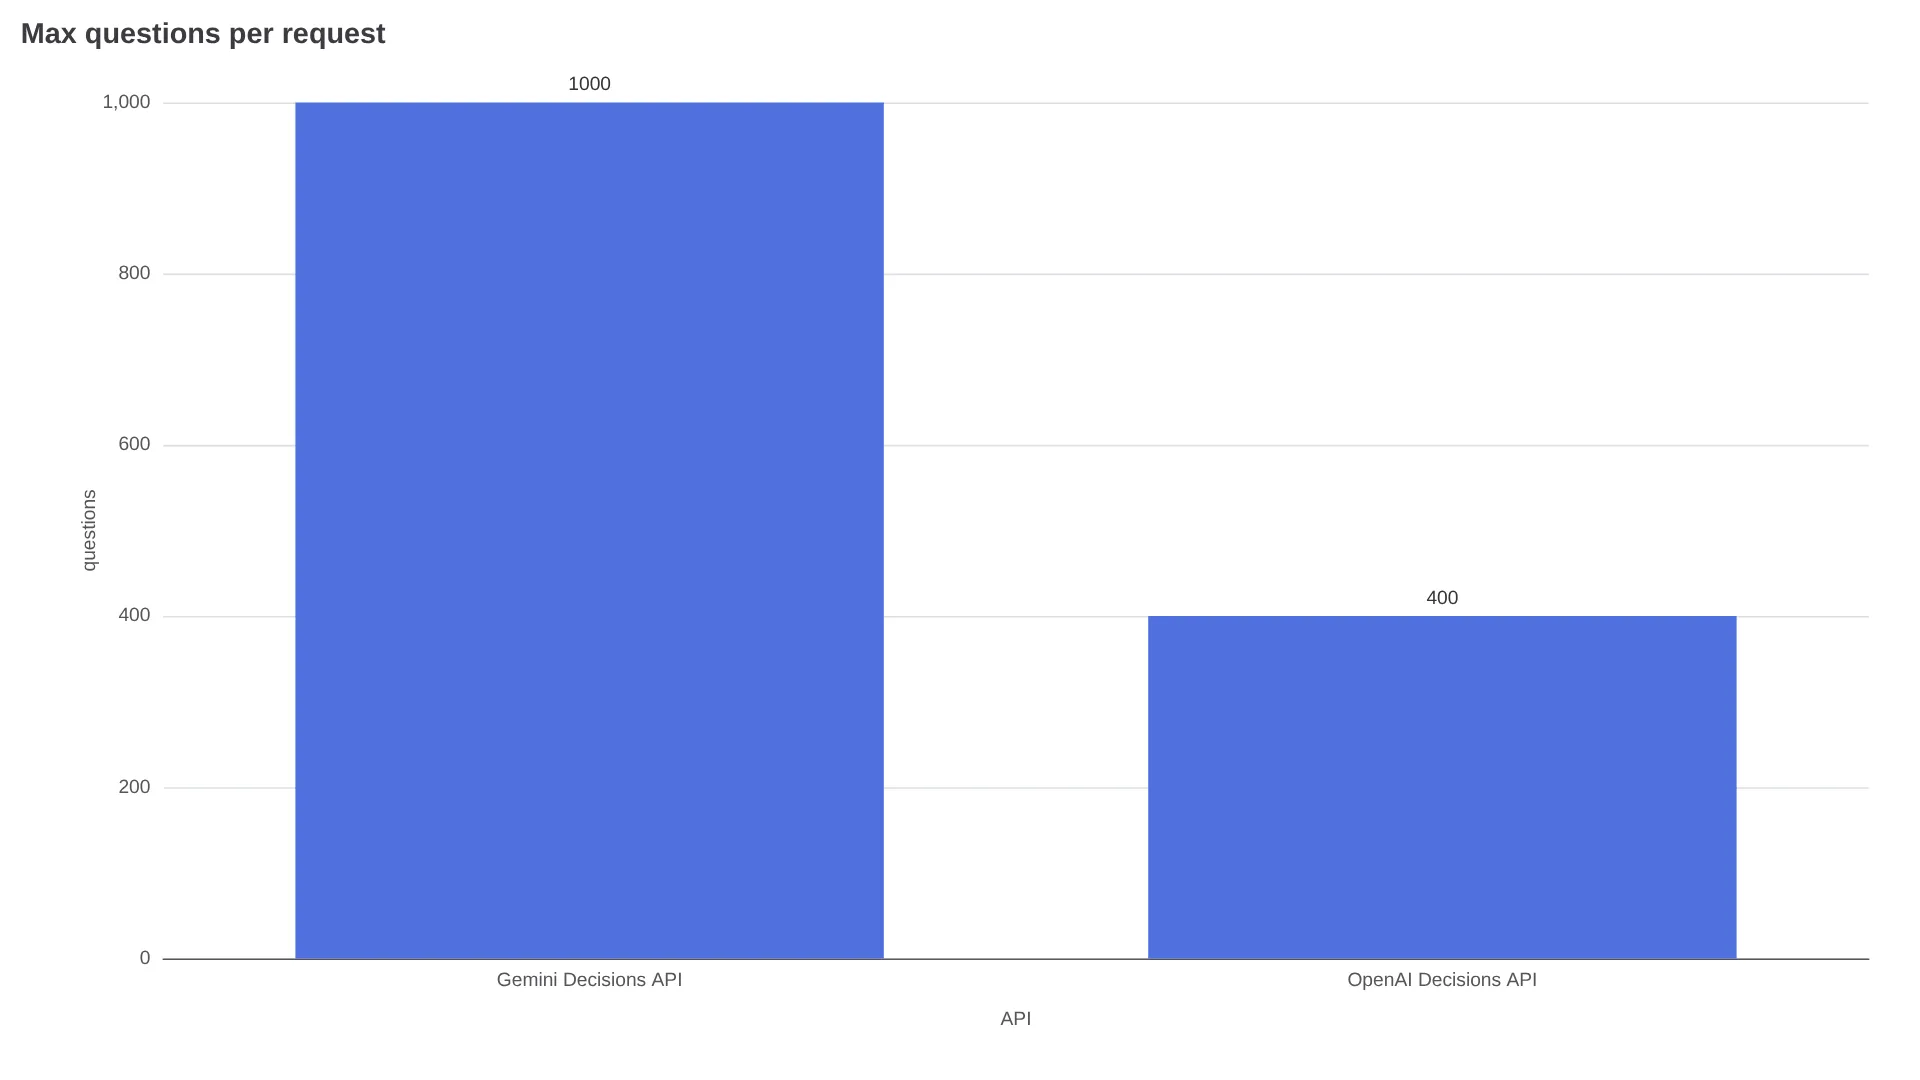
| Domande massime per richiesta | 1,000 | 400 |
| Tipi di domanda | sì/no, choice (2–255), punteggio con rubrica | predicato, choice, score (2–10 livelli) |
| Modalità di input | Testo, immagini, audio, video, PDF (contesto da 256K) | Testo, immagini (URL, base64), JSON nativo, cronologia della conversazione, output degli strumenti; niente audio o file |
| Indicazione sulla latenza | 150–250 ms end-to-end, 50–100 ms di elaborazione del modello | Circa 10 volte più veloce di Responses (nessun p50/p95 pubblicato) |
| Prompt caching | Non annunciato nel post di lancio | Sì: prefisso minimo di 1.024 token, $0.01/1M per le letture dalla cache |
| Piano gratuito | Sì, piano gratuito in AI Studio | Nessun piano gratuito dedicato documentato |
| Reportistica | Utilizzo standard della Gemini API | GET /v1/organization/usage/decisions con chiave admin |
La colonna Gemini si basa sul post di lancio di Google; quella OpenAI sulla guida ai prezzi di OpenAI Decisions API pubblicata da AIReiter, che cita la documentazione ufficiale di OpenAI.
Dalla tabella emergono tre conseguenze pratiche.
- Scegli Gemini Decisions API quando l'evidenza è multimodale. Una registrazione della chiamata insieme ai dati dell'account, oppure un PDF di una pratica con le foto dei danni, può essere elaborata in un solo passaggio; con l'endpoint OpenAI servirebbe in genere una fase di preprocessing separata.
- È la scelta più adatta per un ampio fan-out. Con 1.000 domande indipendenti per richiesta contro 400, lo stesso ticket può includere l'intento di rimborso, l'instradamento al reparto, il livello di urgenza e decine di predicati di policy senza un secondo round trip.
- OpenAI mantiene un vantaggio quando le policy condivise sono lunghe. Il caching dei prefissi porta il costo delle richieste ripetute a $0.01/1M, un dettaglio rilevante se ogni chiamata reinvia un documento di policy da 5.000 token e le domande sono brevi.
Dove inserire Gemini Decisions API in produzione
Secondo l'annuncio di lancio, Google usa l'endpoint in Notebook per l'instradamento, in Stitch per i wireframe, in CC per scegliere le emoji e in Search per la sicurezza MCP. Il modello d'uso è sempre lo stesso: un blocco di evidenza condiviso, molte opzioni vincolate e routing del codice basato sulla confidenza restituita. Ed è proprio su questo punto che un ingegnere invita alla prudenza:
"Il punto non è spendere poco, ma restringere lo spazio delle risposte. La confidenza non equivale all'accuratezza: calibrate il sistema su campioni reali del business e definite soglie di astensione prima del go-live." — @david1989_zhu (tradotto dal cinese)
Costruisci un set etichettato a partire dal carico reale, includendo i casi ambigui, traccia i tassi di falsi positivi e falsi negativi alle diverse soglie e assegna ai risultati con bassa confidenza un percorso esplicito di astensione e revisione umana. I lavori che esulano dal suo contratto — estrazione libera, spiegazioni generate, chiamate a strumenti che richiedono argomenti — restano di competenza di Interactions API, Responses API o del function calling.
Come chiamare Gemini Decision 1
L'endpoint è disponibile tramite Gemini API in Google AI Studio con il modello gemini-decision-1, usando client.decisions.create negli SDK google-genai. Le guide per Python, JavaScript e REST sono nella documentazione di Decisions API. L'esempio ufficiale del bancone della sala pausa verifica una foto e una nota testuale rispetto a tutti e tre i tipi di domanda in un'unica richiesta:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "image", "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg", "mime_type": "image/jpeg"},
        {"type": "text", "text": "Breakroom counter check before the 9 AM client meeting."},
    ],
    questions={
        "has_spill": {"type": "noul", "instructions": "Is there an uncleaned liquid spill on the counter?"},
        "next_action": {"type": "choice", "instructions": "Which cleanup action fits the scene?",
            "criteria": {"wipe_with_cloth": "Small counter spill with cloth nearby.",
                         "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
                         "ready_for_meeting": "Counter is clean and ready."}},
        "severity": {"type": "score", "instructions": "Rate the severity of the counter mess.",
            "criteria": ["Clean and ready.", "Minor localized spill.", "Major spill or safety hazard."]},
    },
)
print(result)
Google elenca integrazioni con OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit e OpenCode; il supporto Google Cloud arriverà prossimamente. Se hai già costruito il sistema sull'endpoint di OpenAI, la strategia di migrazione è semplice: trasferisci per primi i gate multimodali e i carichi con fan-out elevato, lascia dove il caching è scontato i flussi che reinviano policy lunghe e ricalibra da zero le soglie. Le scale di confidenza non sono intercambiabili tra fornitori.
| Il tuo carico | Scelta consigliata |
|---|---|
| Classificare, instradare o assegnare un punteggio con opzioni fisse | Gemini Decisions API |
| L'evidenza include audio, video o PDF | Gemini Decisions API |
| Più di 400 controlli indipendenti per elemento | Gemini Decisions API |
| Policy condivisa lunga reinviata a ogni chiamata | Testa prima le letture dalla cache di OpenAI |
| Servono spiegazioni, estrazione o argomenti per strumenti | Interactions / Responses / function calling |
| Azione distruttiva o legata alla compliance | Decisions solo come gate, con revisione umana |
Esiste un piano gratuito per Gemini Decisions API?
Sì, Google AI Studio offre un piano gratuito per la prototipazione.
Gemini Decisions API supporta il prompt caching?
Nel post di lancio non compare alcuna opzione di caching al 12 novembre 2026.
Quante domande possono entrare in una richiesta a Gemini Decisions API?
Fino a 1.000 domande indipendenti su un singolo input condiviso fino a 256K token.
Quale latenza bisogna prevedere in produzione?
Prevedi 250 ms end-to-end finché non avrai misurato il tuo p95 regionale.
Serve ancora Interactions API?
Sì, per comporre testo, estrarre campi arbitrari, spiegare le decisioni o generare argomenti per gli strumenti.