 AIREITER
ERNIE 5.5 Flash Preview è già disponibile via API, ma Baidu avverte che il post-training non è ancora completo e che la versione finale potrebbe comportarsi diversamente. È una premessa essenziale per interpretare le demo di coding durate 11 ore, le 20 righe di benchmark e la promessa di pubblicare i pesi il 25 novembre.
Non è ancora il lancio definitivo: cosa ha pubblicato Baidu l'11 novembre
ERNIE 5.5 Flash Preview è un checkpoint intermedio del post-training, non un modello pronto per il rilascio definitivo. Baidu ha pubblicato ERNIE 5.5 Flash Base il 5 novembre 2026 come checkpoint grezzo di pre-training (annuncio della versione Base), quindi l'11 novembre ha presentato la Preview, la prima versione sottoposta a post-training sulla Base. Per il rilascio ufficiale sono previsti altri miglioramenti.
Il modello adotta un'architettura sparse mixture-of-experts con 280 miliardi di parametri complessivi e 14 miliardi di parametri attivi per token. Il contesto dichiarato è di 1M token; una analisi dell'endpoint riporta per Qianfan i valori precisi di 1.024.000 token, con un output massimo di 921.600. Baidu dichiara oltre 200 token al secondo per utente su Qianfan (post ufficiale).
All'11 novembre non esiste ancora un repository della Preview su Hugging Face: sono disponibili soltanto ERNIE-5.5-Flash-Base e la relativa variante BF16 del 21 ottobre. Comportamento delle API, tokenizer, runtime e prezzi attuali potrebbero quindi differire dai pesi scaricabili dopo il 25 novembre.
Come usare oggi ERNIE 5.5 Flash Preview: Qianfan e OpenRouter
ERNIE 5.5 Flash Preview è accessibile tramite Qianfan di Baidu e tramite OpenRouter. Qianfan usa l'ID ufficiale ernie-5.5-flash-preview nelle sezioni text generation e deep thinking; su OpenRouter il modello è indicato come baidu/ernie-5.5-flash-preview.
L'elenco dei modelli di Qianfan (documentazione del 10 novembre) indica contesto, input e output da 1M token, con limiti predefiniti di RPM 60 e TPM 1.000.000. In modalità deep thinking, il limite di output da 1M comprende anche la catena di ragionamento. Secondo la documentazione di Baidu, il modello è solo testuale; gli elementi visivi nei test di Baidu usano invece uno strumento basato su Claude Opus 5.5 (analisi). Il ragionamento opera a un unico livello fisso di intensità elevata e non può essere disattivato (la stessa analisi): ogni chiamata comporta quindi il consumo di token di ragionamento.
from openai import OpenAI
# OpenRouter path (verified model ID)
or_client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="OPENROUTER_KEY")
or_client.chat.completions.create(
    model="baidu/ernie-5.5-flash-preview",
    messages=[{"role": "user", "content": "Summarize this 80-page supplier contract as a table."}],
    max_tokens=4000,
)
# Qianfan path (illustrative; copy base URL + key from Qianfan console, model ernie-5.5-flash-preview)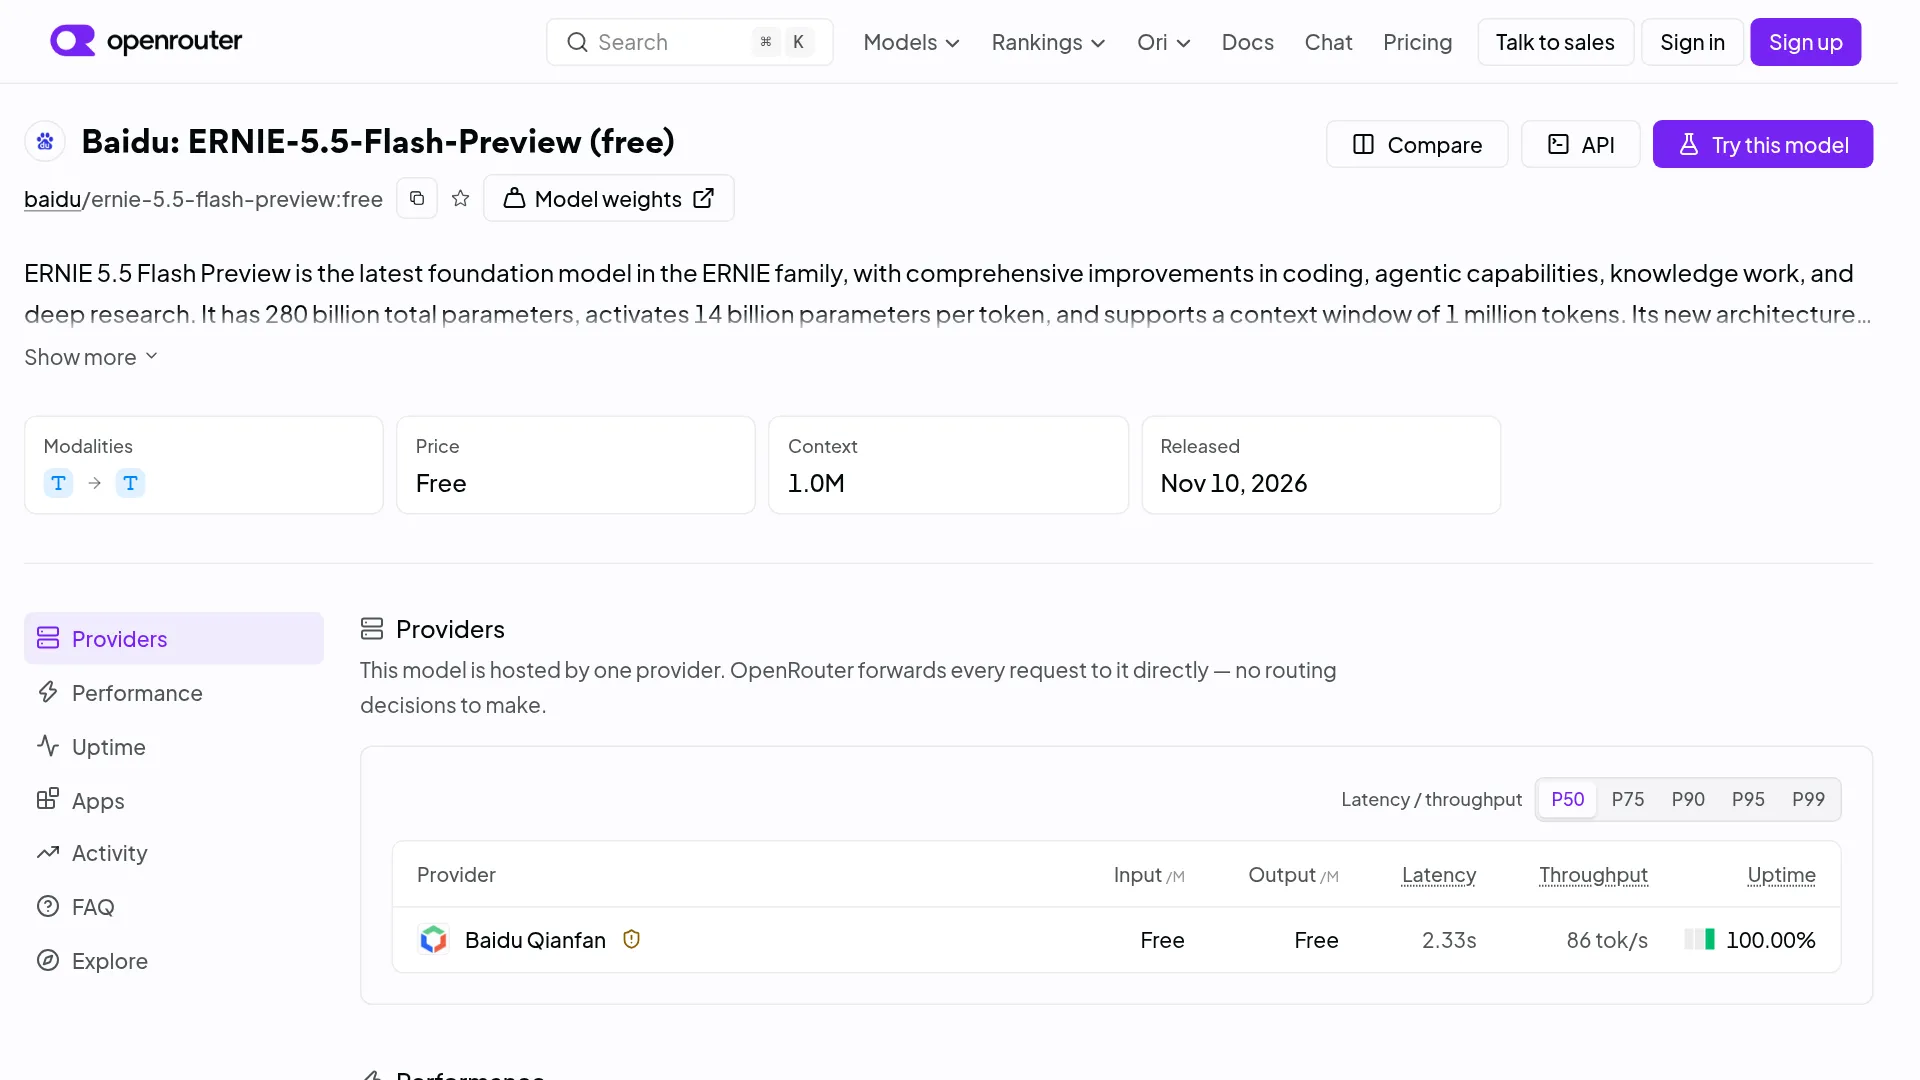
Quanto costa una lunga sessione agentica su Qianfan e OpenRouter
Qianfan applica una tariffa pay-as-you-go in yuan per mille token; OpenRouter chiede $0.28 per milione di token in input e $1.13 per milione in output, con $0.028 per milione per le letture dalla cache. Nelle ore di punta (8:00-22:00), le tariffe promozionali e quelle di listino sono rispettivamente 0.001 / 0.002 yuan per mille token in input, 0.0001 / 0.0002 per la cache e 0.004 / 0.008 per l'output (tariffe Qianfan, documentazione del 10 novembre). Nelle ore non di punta ogni cifra si dimezza; non sono indicati né il fuso orario né la data di fine della promozione.
| Percorso | Input | Output | Cache hit | Note |
|---|---|---|---|---|
| Qianfan, promozionale ore di punta (8:00-22:00) | 1.00 yuan/M | 4.00 yuan/M | 0.10 yuan/M | Pay-as-you-go, doc 2026-11-10 |
| Qianfan, promozionale ore non di punta (22:00-8:00) | 0.50 yuan/M | 2.00 yuan/M | 0.05 yuan/M | Stessa documentazione, fuso orario non indicato |
| Qianfan, listino ore di punta | 2.00 yuan/M | 8.00 yuan/M | 0.20 yuan/M | Tariffa standard senza promozione |
| OpenRouter | $0.28/M | $1.13/M | $0.028/M | baidu/ernie-5.5-flash-preview |
La formula è: token di input x tariffa input + (token di output + token di ragionamento) x tariffa output. Alle tariffe di listino di OpenRouter, 500K token in input costano circa $0.14, mentre 500K token tra output e ragionamento costano circa $0.57. Prima di fissare un budget per esecuzione, registrate i token di ragionamento per ogni attività; per i batch più consistenti, conviene programmare l'elaborazione nelle ore non di punta di Qianfan.
I 20 benchmark sono dichiarazioni di Baidu: quattro demo e una posizione a metà classifica
Baidu ha pubblicato 20 righe di benchmark e quattro dimostrazioni. Tutti i valori sono dichiarati da Baidu e non sono stati replicati; nelle classifiche di Artificial Analysis citate dalla copertura del lancio non ho trovato risultati indipendenti sulla Preview (OrcaRouter, HandyAI). È quindi più corretto leggerli come una scheda di risultati del produttore, non come una classifica definitiva.
Sette righe selezionate dalla tabella di 20 benchmark di Baidu (valori dichiarati da Baidu, salvo diversa indicazione):
| Benchmark | ERNIE 5.5 Flash Preview | Miglior rivale nella tabella di Baidu |
|---|---|---|
| Terminal-Bench 4.0 | 46.5 | Claude Opus 5.5 63.6-66.4 (grafico contro nuova esecuzione in tabella) |
| DeepSWE v1.1 | 71.2 | DeepSeek V4.1 Flash 77.0 |
| AutomationBench | 61.9 | DeepSeek V4.1 Flash 60.5, Hy4 56.2: ERNIE è in testa |
| SpreadsheetBench V2 | 36.4 | Claude Opus 5.5 35.1, GPT-6.1 Sol 32.0: ERNIE è in testa |
| OfficeQA Pro V2 | 67.9 | GPT-6.1 Sol 70.0: ERNIE è indietro di 2.1 |
| APEX-Agents 1.1 | 64.2 | Hy4 77.6, Claude Opus 5.5 73.5: ERNIE è indietro |
| DRACO | 84.9 | Hy4 90.7, Claude Opus 5.5 87.4: ERNIE è a metà classifica |
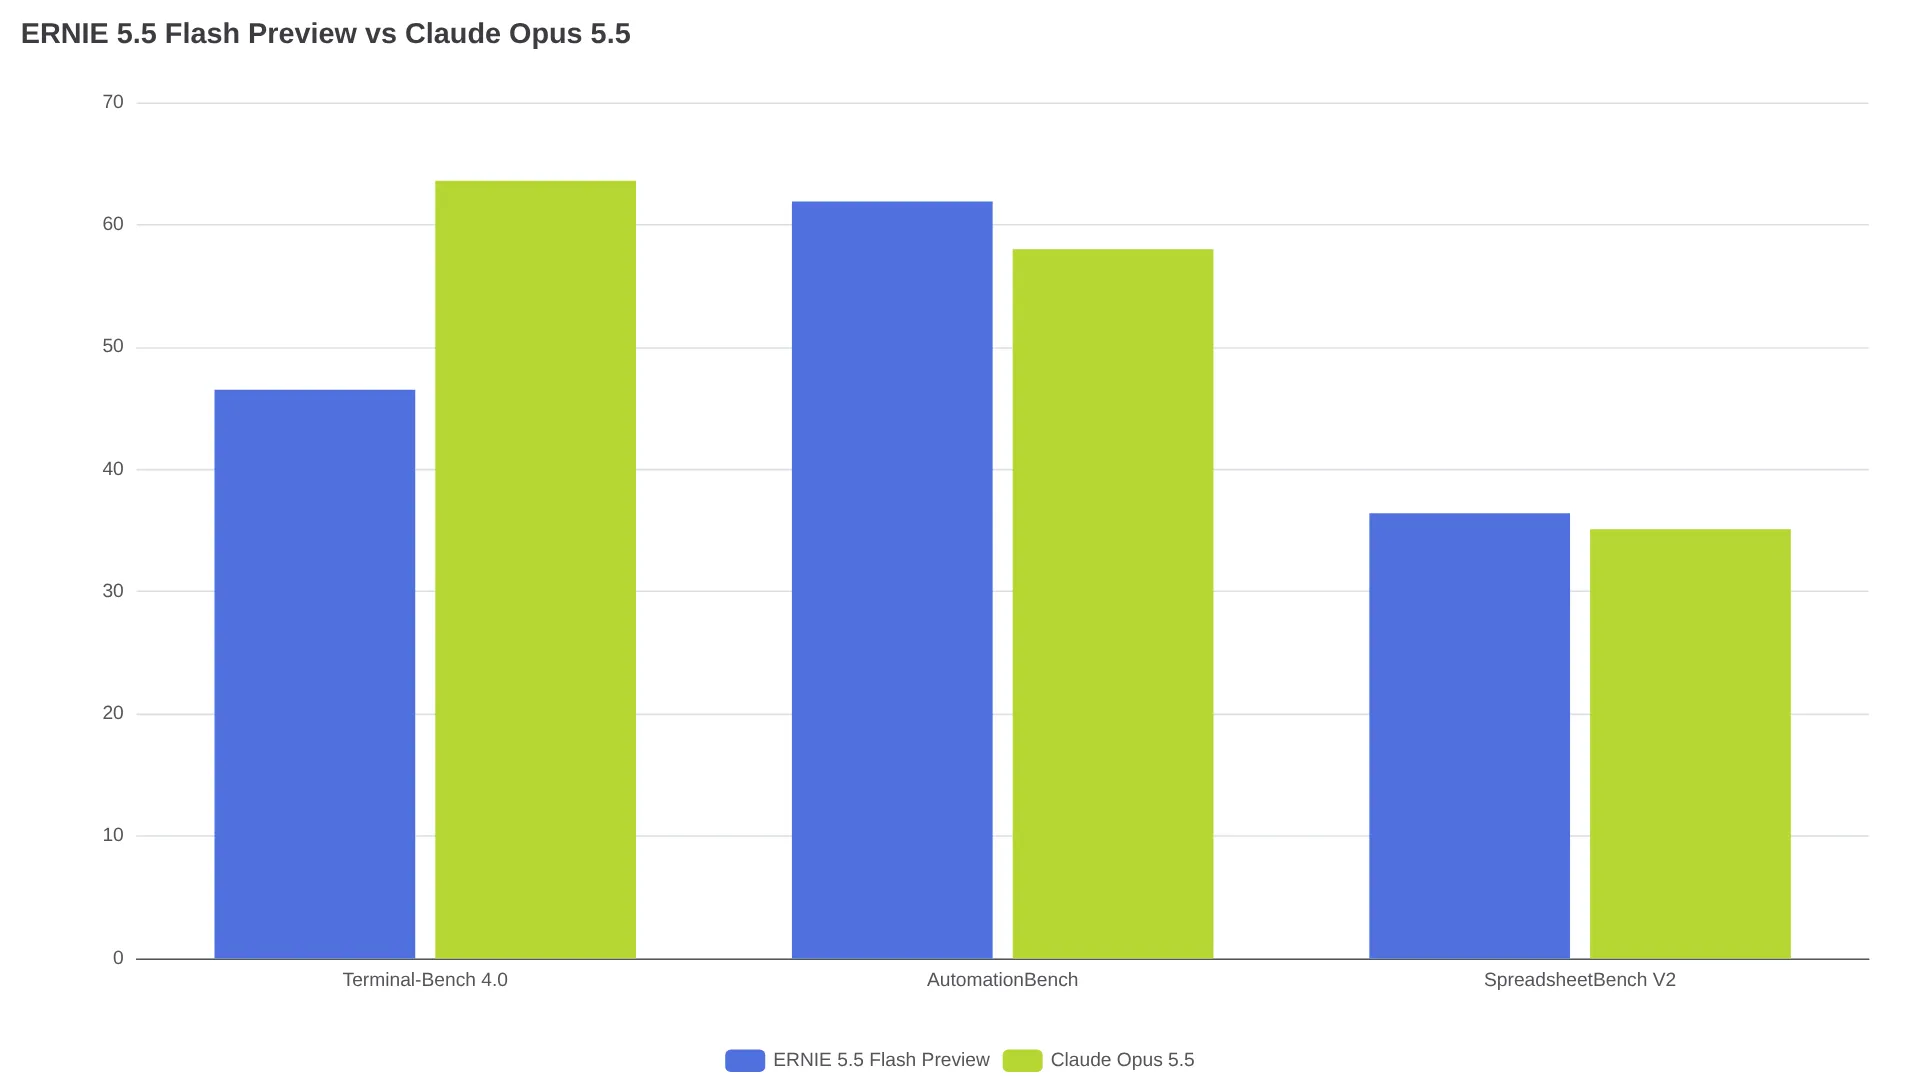
Ci sono però alcuni dettagli che cambiano la lettura dei risultati: le righe contrassegnate da un asterisco sono autovalutazioni di Baidu; le due righe "AA" usano gli harness di Artificial Analysis, ma con esecuzioni effettuate da Baidu (analisi); gli elementi visivi usano uno strumento basato su Claude; una verifica indipendente ha rilevato che le nuove esecuzioni di Baidu sui rivali in AutomationBench superavano di oltre 15 punti i valori pubblicati (HandyAI); inoltre, l'appendice è stata distribuita come immagine, rendendo impossibile verificarla.
Le demo di Baidu descrivono una notevole autonomia su quattro filoni (tutti i dati sono dichiarati da Baidu): una sessione di 11 ore per costruire un progetto wuxia in Unreal Engine 5.8, oltre a circa 100 mini-game mobile; scene realizzate in Blender, tra cui un aeroporto e il complesso di Horyu-ji (circa 2.100 oggetti e 1,82 milioni di triangoli), oltre a componenti in FreeCAD; report di ricerca da 20 e 24 pagine, un foglio di calcolo Monte Carlo e un file WAV orchestrale di 6m34s; infine, un cortometraggio di 116 secondi con un pellicano in 20 stili, generato attraverso oltre 10.000 righe di Python.
Le aggregazioni di terze parti collocano la Preview a metà classifica: Handy AI le ha assegnato 67.8 punti, 17ª posizione assoluta, e 69.1 punti, 6ª tra 57 modelli open-weight. Davanti troviamo Kimi K3.1 Pro (94.4), Hy4 (73.9) e DeepSeek V4.1 Flash 1017 (71.9).
"Il nuovo modello di Baidu non è la notizia principale. Lo è la licenza. ... Se arriverà Apache 2.0, sarà un cambiamento concreto." — @thestonyground, post su X
Pesi, licenza e uso locale: la promessa del 25 novembre e la discrepanza tra gli annunci
I pesi sono stati promessi, ma non sono ancora stati pubblicati. L'annuncio in inglese parla di Apache 2.0 in arrivo; quello in cinese indica il 25 novembre come scadenza, senza specificare alcuna licenza.
Flash Base è stato distribuito con una licenza restrittiva che esclude UE, Regno Unito e Corea del Sud e impone requisiti di attribuzione (repository, analisi). I team che operano in queste aree dovrebbero quindi attendere la pubblicazione scritta dei termini della Preview.
Per la Preview non ho trovato file GGUF, una tabella delle quantizzazioni o un dato ufficiale sulla VRAM. I parametri attivi non corrispondono alla memoria residente: 280B parametri a 4 bit richiedono circa 140 GB prima dell'overhead, quindi qualsiasi configurazione con 32 GB di VRAM implicherebbe un forte ricorso all'offload sulla CPU. Il thread su r/LocalLLaMA offre soltanto una stima approssimativa della community, vicina a 32 GB di VRAM + 128 GB di RAM, e mette in dubbio che i 200 token al secondo rappresentino la velocità su una macchina consumer con batch 1. Non acquistate hardware prima del 25 novembre.
Conviene costruire qualcosa sulla Preview questa settimana?
La Preview è interessante per test economici su contesti lunghi; per qualunque componente critico conviene aspettare il rilascio definitivo. I primi carichi da provare, alla luce dei risultati non replicati di Baidu, sono la modifica di fogli di calcolo, il question answering su file Office e i batch di automazione.
| Scenario | Cosa fare |
|---|---|
| Batch in stile Spreadsheet / OfficeQA / AutomationBench | Provate subito l'API; Qianfan nelle ore non di punta o OpenRouter mantengono bassi i costi dei test |
| Lettura di contesti da 1M e sintesi di ricerche | Avviate un pilot con budget di output rigidi; il ragionamento obbligatorio fa aumentare i consumi |
| Coding da terminale come dipendenza principale | Restate su Opus / GPT / DeepSeek; ripetete i test dopo nuove verifiche indipendenti |
| Produzione o self-hosting in UE / Regno Unito / Corea del Sud | Aspettate il repository e una licenza Apache 2.0 esplicitamente indicata |
| Fine-tuning o distillazione | Aspettate; verificate i termini per il training nella licenza della Preview |
Le demo di Baidu suggeriscono una buona resistenza sulle sessioni lunghe, ma manca la verificabilità: usate la Preview come secondo modello economico per i task agentici estesi, almeno finché non arriveranno risultati indipendenti e un repository Apache 2.0 con una data chiara.
ERNIE 5.5 Flash Preview è già open source?
No. L'accesso via API è attivo, ma l'11 novembre i pesi non erano pubblici su Hugging Face. La pubblicazione è promessa entro il 25 novembre e Apache 2.0 è indicata soltanto nell'annuncio in inglese.
ERNIE 5.5 Flash Preview è multimodale?
No, è un modello solo testuale. Le demo orchestrano strumenti esterni tramite codice; gli elementi visivi dei benchmark usano uno strumento basato su Claude.
Qual è la differenza tra Flash Base, Flash Preview e Flash definitivo?
La Base del 5 novembre è un checkpoint grezzo; la Preview dell'11 novembre è la prima versione intermedia sottoposta a post-training; Flash definitivo sarà il prossimo rilascio ufficiale.
Perché il divario in Terminal-Bench rispetto a Claude Opus 5.5 è importante?
Il divario suggerisce una minore affidabilità nei task da terminale più lunghi; inoltre, poiché il ragionamento è obbligatorio, i tentativi ripetuti possono aumentare ulteriormente i costi. ERNIE ha ottenuto 46.5 contro il risultato di Opus 5.5, compreso tra 63.6 e 66.4.
La Preview è pronta per l'uso in produzione?
No: al momento del lancio non esisteva una nuova esecuzione indipendente e il comportamento potrebbe cambiare. Usatela per batch non critici e vincolate l'impiego in produzione a nuove verifiche e alla licenza finale.