L'API di Qwen4 Max non è più confinata all'anteprima Token Plan: ora funziona anche in modalità pay-as-you-go, a $1.50 per 1M di token in input e $4.50 in output, con una finestra di contesto da 1M di token. Per i nuovi progetti usa qwen4-max: qwen4-max-preview verrà ritirato il 25 novembre 2026.
Qwen4-Max API in breve: disponibile dal 16 novembre 2026
Alibaba ha reso Qwen4-Max generalmente disponibile il 16 novembre 2026 su Alibaba Cloud Model Studio, con l'ID qwen4-max, dopo un'anteprima riservata al Token Plan iniziata l'11 novembre. L'annuncio di @Alibaba_Qwen parla di una nuova architettura MoE con visione nativa e finestra di contesto da 1M di token; l'API è attiva su QwenCloud. La documentazione QwenCloud rispecchia quella di Model Studio per l'accesso internazionale: scegli l'endpoint di Model Studio corrispondente alla tua regione (documentazione QwenCloud).
| Voce | Qwen4-Max (qwen4-max) |
|---|---|
| Stato | GA dal 16 novembre 2026; l'anteprima qwen4-max-preview è attiva dall'11 al 25 novembre 2026, poi verrà ritirata |
| Input / output | $1.50 / $4.50 per 1M di token (Singapore, piano internazionale) |
| Lettura della cache | $0.075 per 1M di token |
| Altre regioni | $1.413 / $4.24 per 1M di token negli Stati Uniti (Virginia), a Francoforte, Tokyo e Hong Kong |
| Contesto | 1M di token; input massimo indicato: 991K token |
| Output massimo | 131.072 token senza thinking; 262.144 token complessivi per thinking e risposta |
| Modalità di input | Testo, immagini, video |
| Stile API | Compatibile con OpenAI e Anthropic; tool calling, output JSON strutturato, ricerca web, caching, batch e fine-tuning |
| Regioni | Singapore, Stati Uniti (Virginia), Francoforte, Tokyo, Hong Kong e Pechino; job batch solo a Pechino |
| Prova | I nuovi account Singapore ricevono 1M di token gratuiti per 90 giorni |
Prezzi e limiti riportati qui sopra provengono dalla documentazione di Alibaba Cloud Model Studio, consultata il 16 novembre 2026 (prezzi e documentazione QwenCloud). Per esempio, 100K token in input più 10K in output costano a Singapore circa $0.15 + $0.045 = $0.195.
Cosa cambia davvero rispetto a Qwen3.8-Max
Nel suo annuncio, citando i dati di Artificial Analysis, Qwen assegna a Qwen4-Max un Intelligence Index di 43: 9 punti in più rispetto a Qwen3.8-Max (xhigh) e 3 in meno rispetto a Kimi K3.1 Pro. Il costo medio è di $3.27 per attività, circa un terzo di quello di Qwen3.8-Max, con il 39% in meno di token generati.
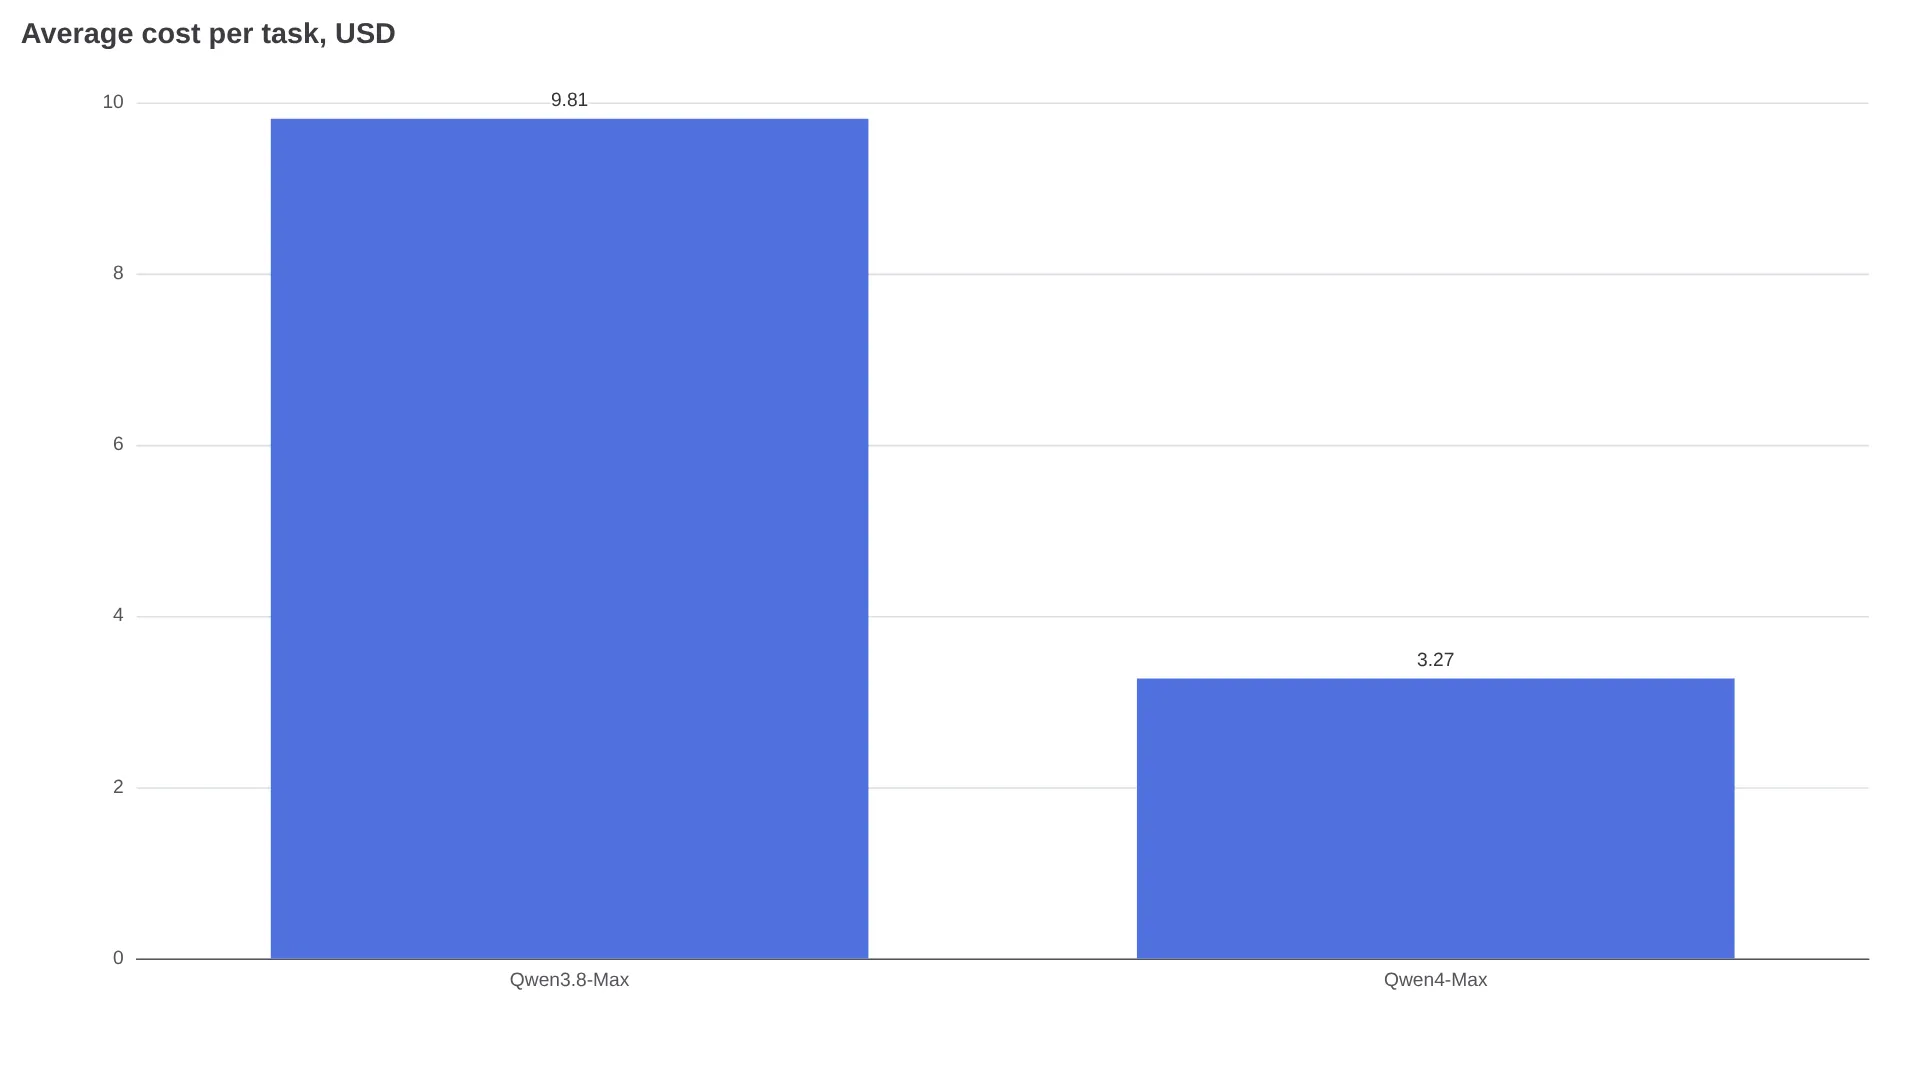
Il risparmio arriva da due direzioni: il prezzo per token indicato nella tabella e il minor numero di token utilizzati per attività, fino a circa il 50% in meno nella valutazione interna di Qwen. I vantaggi sono ancora più evidenti nelle elaborazioni da 1M di token con riutilizzo della cache, perché le letture implicite costano $0.075 per 1M e, secondo Qwen, sono il 70% più economiche rispetto alla cache di Qwen3.8-Max.
Alla base c'è un'architettura MoE con visione nativa: 2.4T di parametri complessivi, 71B attivi e 328B di embedding N-gram. Il blog di Qwen cita i punteggi di Artificial Analysis, ma AI First Look e AICoder segnalano che il 16 novembre le tabelle complete dei benchmark e le classifiche pubbliche di AA non erano ancora disponibili.
Per approfondire il modello precedente: prezzi dell'API Qwen3.8-Max e Qwen3.8-Max a confronto con Kimi K3.
Specifiche e limiti che incidono sulla spesa
La cifra da 1M fa notizia, ma ci sono tre limiti da tenere d'occhio.
Contesto e input realmente utilizzabile. La finestra è da 1M di token, ma QwenCloud indica un input massimo di 991K token. Lascia quindi un margine di sicurezza e verifica il recupero delle informazioni nella parte centrale del contesto, soprattutto nei flussi basati sulla ricerca.
Output e thinking condividono lo stesso budget. Senza thinking, l'output massimo è di 131.072 token. Quando il thinking è attivo, ragionamento e risposta devono rientrare insieme nel limite di 262.144 token: più spazio consumi per il ragionamento, meno ne resta per la risposta. Secondo l'analisi delle specifiche dell'anteprima di XenoSpectrum, la preview arrivava a 393.216 token condivisi. Non fissare quindi i limiti dell'anteprima nel codice di produzione.
Il valore predefinito del thinking è cambiato. Il thinking è attivo di default. Nel modello GA l'impostazione predefinita è high, mentre sono disponibili anche low e xhigh; la preview usava xhigh come valore predefinito, secondo la tabella delle specifiche di AI First Look. Se la latenza è eccessiva, prova prima a impostare reasoning_effort su low.
L'input multimodale comprende testo, immagini e video. Nella preview, i limiti dichiarati per l'invio dei video erano 2 ore, 2 GB e 64 video per richiesta, secondo l'analisi delle specifiche dell'anteprima di XenoSpectrum: sono limiti di invio, non una garanzia sulla capacità di comprensione. Per i video lunghi, fai prove sui tuoi file.
Per tenere sotto controllo i costi, usa un output JSON strutturato per evitare risposte prolisse e riutilizza i contesti lunghi tramite la cache ($0.075 per 1M di token a Singapore). Le note di lancio di AICoder indicano inoltre la creazione esplicita di una cache di cinque minuti a $1.875 per 1M, dove supportata.
Come chiamare qwen4-max con l'SDK OpenAI
Model Studio supporta i formati OpenAI Chat Completions, Responses e Anthropic Messages API, secondo la documentazione dei modelli di Alibaba Cloud. Per i backend pay-as-you-go usa qwen4-max; qwen4-max-preview è disponibile solo con Token Plan.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
La chiave API e l'endpoint devono appartenere alla stessa regione di Model Studio. Puoi richiedere response_format={"type": "json_object"} oppure uno JSON Schema, dove supportato, e devi validare gli output strutturati di grandi dimensioni.
Pay-as-you-go, Token Plan o app di chat: quale scegliere
| Percorso | Ideale per | Vincolo principale |
|---|---|---|
Model Studio pay-as-you-go (qwen4-max) | App, backend e batch | Fatturazione a consumo; controlla endpoint regionale e chiave |
Token Plan (qwen4-max-preview) | Sviluppo interattivo in Claude Code, Cline, Cursor e OpenCode | Solo uso interattivo; niente automazioni di produzione, script batch o integrazione in backend; solo regione Singapore; termina il 25 novembre 2026 alle 24:00 UTC+8 |
| Qwen Chat, QwenWork, QwenStudio e Qoder | Provare prompt, lavorare sui documenti e usare un IDE agentico senza configurare chiavi | Disponibilità e consumo dei crediti sono mostrati nell'app; non costituisce un contratto API |
Il Token Plan è un pacchetto mensile di crediti pensato per lo sviluppo interattivo. La panoramica del Token Plan di Apidog indica livelli singoli che vanno dal Lite, a $3 con prezzo evento / $8 di listino e 20.000 crediti, fino al Pro, a $43 con prezzo evento / $51 di listino e 200.000 crediti; le chiavi iniziano con sb-sp-. Condividere le chiavi, eseguire job in background o incorporare la chiave in un backend distribuito viola i termini. Per provare i prompt, Apidog e XenoSpectrum indicano Qwen Chat, QwenWork, QwenStudio e Qoder come percorsi di valutazione; la disponibilità viene mostrata nell'app e varia a seconda dell'account.
Effettua la migrazione prima del 25 novembre 2026:
- Sostituisci la stringa del modello da
qwen4-max-previewaqwen4-max. - Passa dall'URL base e dalla chiave del Token Plan a una chiave pay-as-you-go di Model Studio e all'endpoint regionale corretto.
- Ripeti i test sui valori predefiniti del thinking (da
xhighahigh). - Ricalcola i budget di output (limite condiviso di 393K nella preview contro i limiti GA di 131K/262K).
Cosa riferiscono i primi utenti: ottimo per i progetti nuovi, agenti ancora discontinui
I test su campioni ridotti raccolti da AI First Look riportano progetti completati con un solo prompt, inclusi 20 test nascosti su 20 in circa 2,5 minuti contro i 17 minuti di Qwen3.8-Max. La stessa raccolta segnala però un test su un gioco in cui Qwen4-Max ha finito prima, pur classificandosi ancora secondo nella valutazione complessiva.
Continuo a ricevere questi errori quando provo a generare codice.
— @bijanbowen, post (prima impressione di un utente reale, 16 novembre 2026; screenshot di errori ripetuti nella generazione di codice)
Una prima raccolta di impressioni di tester in lingua cinese (@weconomypistis) ha indicato nel prezzo e nel costo per attività i vantaggi principali, ma ha giudicato le operazioni da terminale e degli agenti un passo indietro rispetto a Kimi, con risposte più lente.
Domande frequenti
Qwen4-Max è un modello open-weight?
No. Al 16 novembre Qwen4-Max era disponibile solo come modello ospitato e non erano stati annunciati i pesi, secondo il tracker di AI First Look. Qwen ha dichiarato che in futuro i modelli Qwen4 più piccoli riceveranno pesi open, come riportato nell'annuncio di Qwen4-Max, ma non ha indicato date, dimensioni o licenze.