 AIREITER
Qwen3.8-Max è ora disponibile in versione general availability: costa $2 per milione di token in input e $6 per milione in output. Quest'ultima tariffa è almeno quattro volte più bassa di quella di Claude Opus 4.8, Claude Fable 5 e GPT-5.6 Sol. Attenzione però a reasoning_effort, impostato di default su xhigh: il prezzo di listino e la fattura reale possono divergere già dalla prima richiesta.
Prezzi di Qwen3.8-Max per milione di token
Qwen3.8-Max è un modello mixture-of-experts da 2,4 trilioni di parametri, con 95 miliardi di parametri attivi per token. Prende il posto di Qwen3.7-Max come modello di punta di Alibaba. Le tariffe seguenti provengono dalla pagina del modello su Alibaba, contrassegnata come "Updated: Aug 2, 2026":
| Voce | Prezzo per 1M di token |
|---|---|
| Input | $2.00 |
| Output | $6.00 |
| Input (cache implicita) | $0.25 |
| Creazione cache esplicita | $2.50 |
| Lettura cache esplicita | $0.17 |
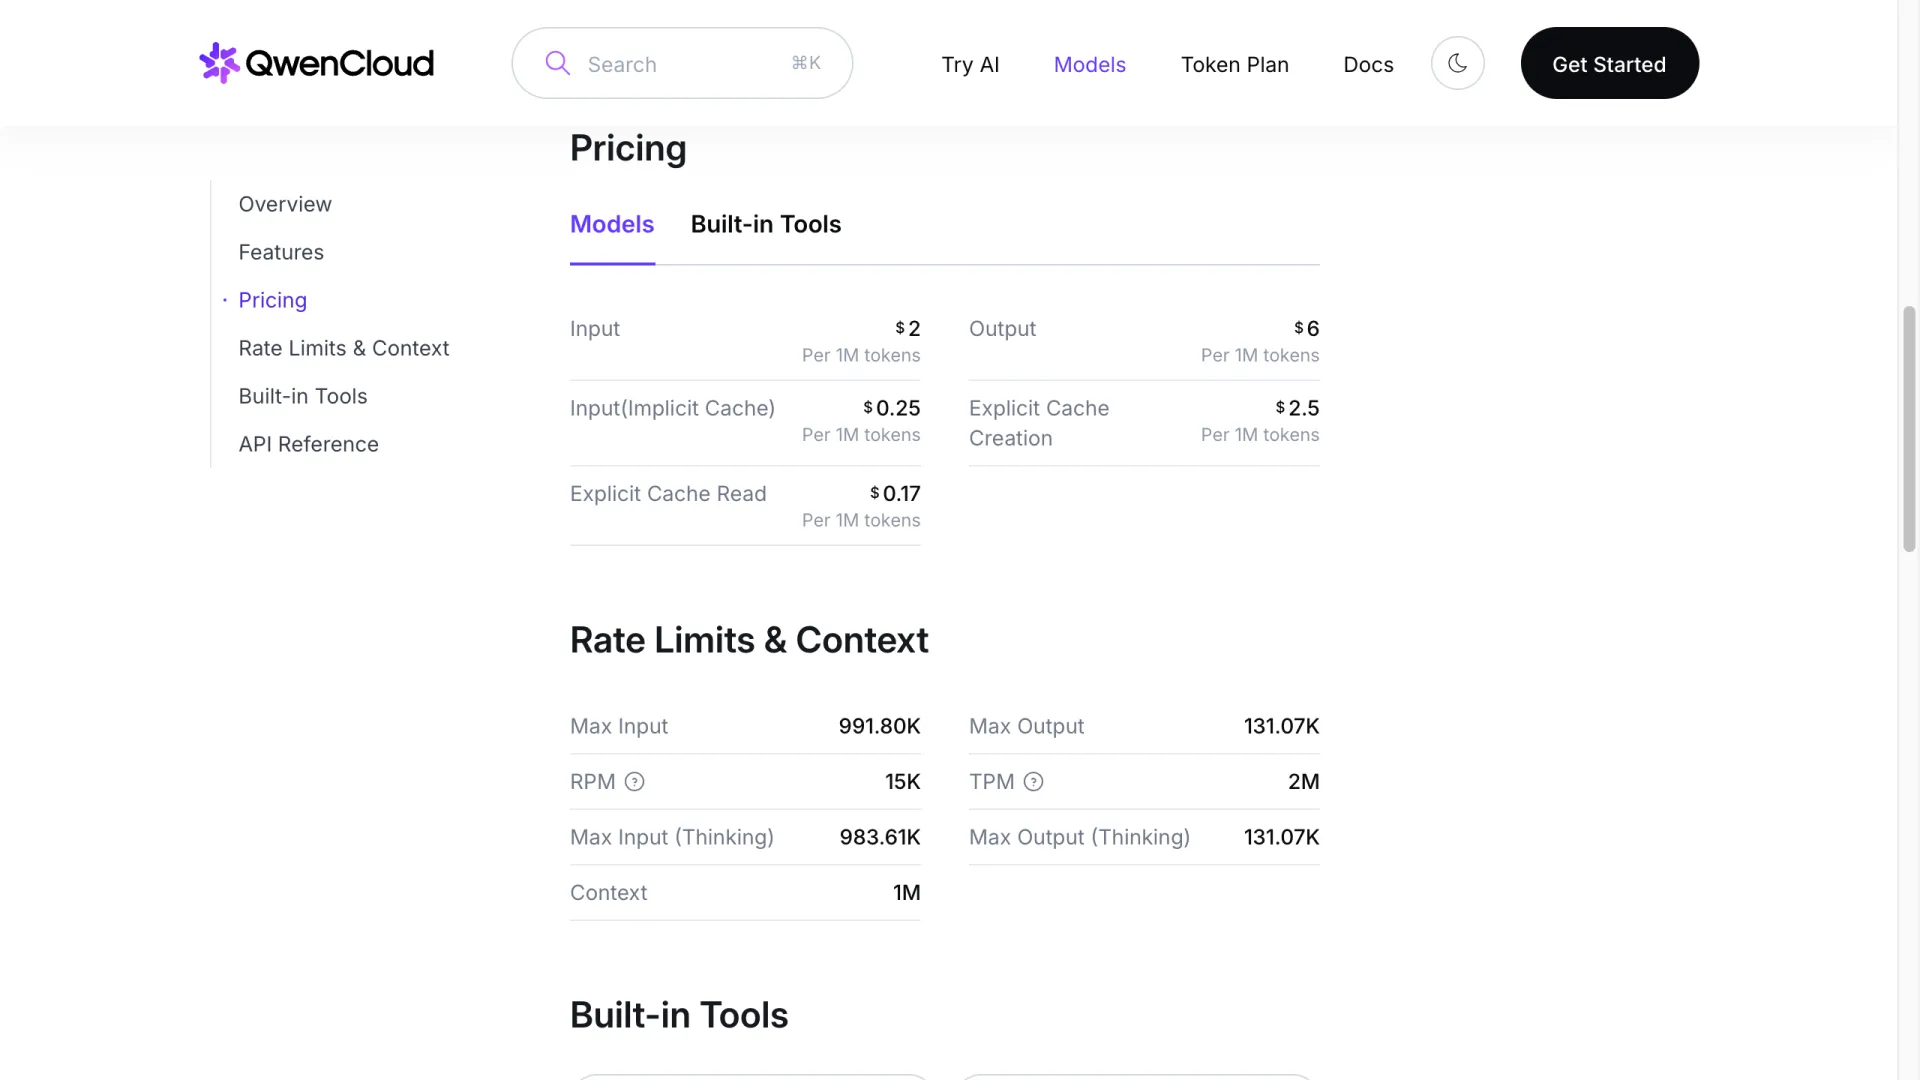
La cache implicita non richiede alcun intervento nel codice. I prefissi ripetuti vengono fatturati automaticamente a $0,25, un ottavo della tariffa input standard. La cache esplicita, invece, richiede una scelta: costa $2,50 in scrittura e $0,17 in lettura. Risulta più conveniente dell'input senza cache già dalla seconda lettura, ma supera la tariffa implicita da $0,25 soltanto intorno alla trentesima lettura dello stesso prefisso. Nella maggior parte delle applicazioni, conviene quindi non usare la cache esplicita.
C'è un limite importante: l'API è aperta, i pesi non ancora. Il post di lancio di Alibaba afferma che i pesi di Qwen3.8-Max arriveranno su Hugging Face e ModelScope la prossima settimana. È il primo impegno con una data dopo settimane di un "coming soon" senza scadenza; al 3 agosto, nella barra laterale della pagina del modello compare ancora Open Source: No.
Perché $6 in output non raccontano il costo effettivo
La documentazione di lancio di Alibaba prevede tre livelli per reasoning_effort e indica xhigh come predefinito: è il più approfondito dei tre, sopra medium ("bilancia accuratezza e velocità") e low ("ottimizzato per velocità e costo"). Anche preserve_thinking è attivo di default in ogni scenario. I token di ragionamento vengono fatturati come token di output: entrambe le impostazioni predefinite convogliano quindi la spesa sulla tariffa da $6 prima ancora di aver scritto un prompt.
Le due leve che incidono sul costo reale sono dunque configurate contro di voi fin dall'inizio, ma bastano parametri di richiesta per modificarle. Passare a medium o low significa evitare di pagare $6 per milione di token per un ragionamento profondo quando non serve, riservandolo ai compiti in cui porta davvero valore.
Un primo tester è stato netto sul valore di questo ragionamento, nel titolo di una discussione su r/LocalLLaMA:
Qwen 3.8 max first impressions - model is moderate and it is awful on thinking
Non va letto come un risultato di benchmark, ma come un motivo in più per provare ogni livello di effort sul proprio carico di lavoro prima di adottare l'impostazione predefinita.
Contesto fino a 1M senza sovrapprezzi
La pagina di Qwen3.8-Max indica una sola tariffa per l'input e una per l'output, senza fasce legate alla lunghezza del contesto. Gemini 3.1 Pro e GPT-5.6 Sol, invece, passano a una fascia più costosa oltre una certa soglia di contesto:
| Modello | Input (contesto breve) | Output (contesto breve) | Input (contesto lungo) | Output (contesto lungo) |
|---|---|---|---|---|
| Qwen3.8-Max | $2.00 | $6.00 | $2.00 (fino a 1M) | $6.00 (fino a 1M) |
| Gemini 3.1 Pro | $2.00 (≤200K) | $12.00 | $4.00 (>200K) | $18.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $10.00 | $45.00 |
Fino a 200K token, Gemini 3.1 Pro equivale esattamente a Qwen3.8-Max sul prezzo dell'input; oltre tale soglia raddoppia. GPT-5.6 Sol raddoppia l'input e aumenta del 50% l'output quando una richiesta entra nella fascia long context, su un listino già ristrutturato.
Con l'aumentare del contesto, quindi, la distanza si amplia invece di restare costante. Un prompt da 400K token costa $0,80 di input con Qwen3.8-Max, $1,60 con Gemini 3.1 Pro e $4,00 con GPT-5.6 Sol. È qui che il vantaggio si accumula: pipeline documentali, sessioni agentiche lunghe e analisi di repository completi. Nelle brevi interazioni in chat, invece, l'effetto è quasi irrilevante.
Il confronto con i modelli scelti da Alibaba per i benchmark
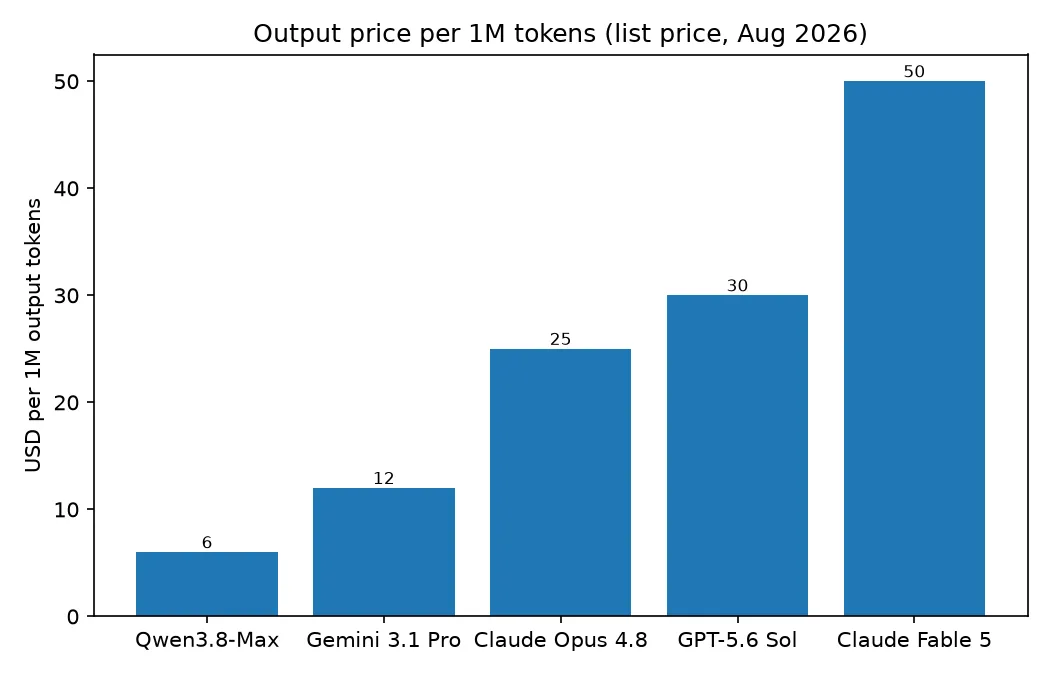
Nel confronto diretto, $6 per l'output sono meno di un quarto dei $25 di Claude Opus 4.8 e un quinto dei $30 di GPT-5.6 Sol. Claude Fable 5, a $50, costa oltre otto volte tanto. Resta da capire se il divario di capacità giustifichi quel sovrapprezzo; Alibaba sostiene di no pubblicando una tabella con 28 benchmark:
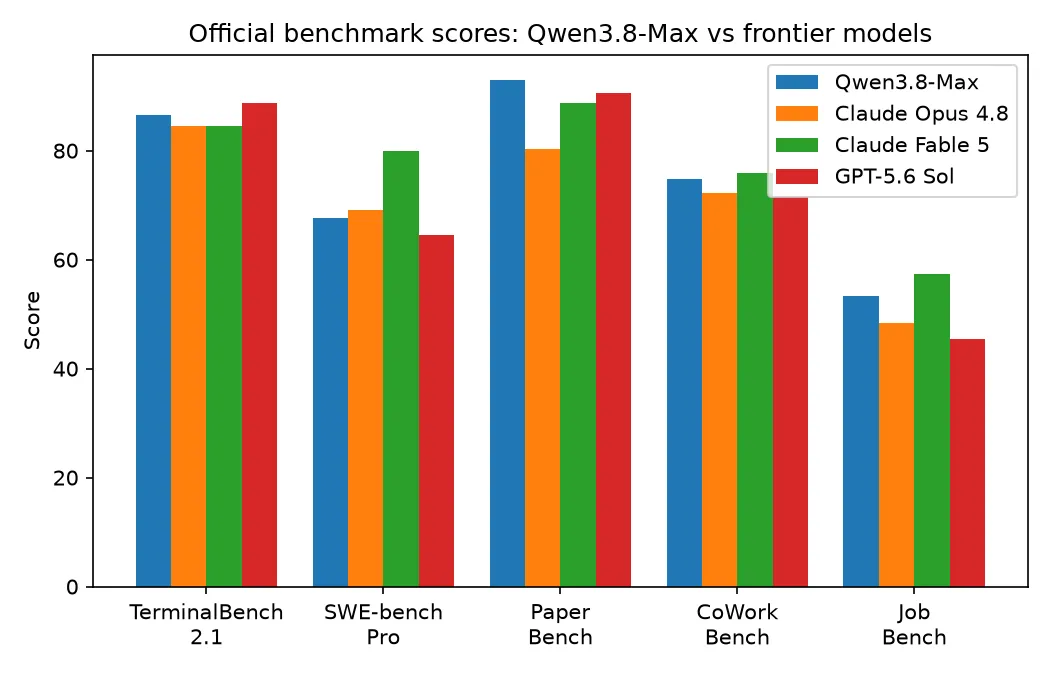
Qwen3.8-Max guida PaperBench con 93,0, contro 90,5 di GPT-5.6 Sol e 88,8 di Fable 5; primeggia anche su JobBench, 53,4 contro 48,4 di Opus 4.8, e supera di poco entrambi i modelli Claude su Terminal Bench 2.1 con 86,6. Perde invece nettamente su SWE-bench Pro: l'80,0 di Fable 5 dista oltre dodici punti dal suo 67,7. Tutti questi dati sono stati eseguiti e pubblicati dal vendor sulla stessa pagina.
La scelta si delinea abbastanza chiaramente. Nei carichi agentici ad alta produzione di output — loop lunghi di tool calling, generazione di documenti, riproduzione di ricerche nel formato misurato da PaperBench — uno sconto sull'output da 4 a 8 volte cambia l'economia unitaria del progetto. Nello sviluppo software su repository estesi, il tipo di attività valutato da SWE-bench Pro, lo sconto si accompagna a una perdita concreta di capacità: pagare le tariffe di Fable 5 può ancora avere senso.
Testarlo sul proprio workload è semplice ed economico: il post di lancio di Alibaba documenta chiamate chat-completions e responses compatibili con OpenAI, oltre a un'interfaccia compatibile con Anthropic. Sono gli stessi due formati di richiesta supportati da Claude Opus 4.8 e GPT-5.6 Sol.
Cosa aggiornare subito nel codice
L'identificatore del modello è qwen3.8-max. Al 3 agosto è l'unica voce 3.8 nel catalogo dei modelli Alibaba: l'identificatore preview qwen3.8-max-preview è stato rimosso. Prima di presumere che uno sconto preview sia sopravvissuto alla GA, conviene quindi controllare il proprio provider relay.
Entrambe le interfacce sono servite da tre URL base regionali: Pechino, Singapore e Virginia, negli Stati Uniti. Questi sono i limiti che si incontreranno per primi:
| Limite | Valore |
|---|---|
| Finestra di contesto | 1M |
| Input massimo | 991.80K |
| Input massimo (thinking) | 983.61K |
| Output massimo | 131.07K |
| Richieste al minuto | 15K |
| Token al minuto | 2M |
Da notare il divario di circa 8K token fra i due limiti di input: attivare il thinking riduce non solo i token di output disponibili, ma anche lo spazio per l'input. Se i pesi arriveranno davvero la prossima settimana, il dato dei 95B di parametri attivi sarà il punto di partenza per qualsiasi confronto fra self-hosting e tariffa $2/$6.
FAQ
L'API Qwen è gratuita?
No. Qwen3.8-Max viene fatturato a consumo: $2 per milione di token in input e $6 per milione in output. L'abbonamento Token Plan venduto sulla piattaforma API di Alibaba è un prodotto separato, basato su crediti e distinto dalla fatturazione API per token.
Quanto costa Qwen Max?
Per la generazione attuale, $2 per milione di token in input e $6 per milione in output, con cache implicita dei prefissi a $0,25. Le vecchie voci qwen-max nella documentazione Alibaba Cloud si riferiscono a generazioni precedenti e hanno tariffe differenti.
Qwen3.8-Max applica un sovrapprezzo per la finestra di contesto da 1M?
No. Input e output hanno lo stesso prezzo con 5K token e con 900K token: è la differenza strutturale più evidente rispetto a GPT-5.6 Sol e Gemini 3.1 Pro.
Qwen3.8-Max costa meno di Qwen3.7-Max?
Non è possibile stabilirlo dalle pagine ufficiali. La pagina di Qwen3.7-Max mostra le cifre per token come -- dietro un indicatore di sconto del 50%, anziché pubblicare le tariffe: non esiste quindi un dato ufficiale con cui confrontarle.
Approfondimenti correlati
- Prezzi di Claude Fable 5: la fascia $10/$50 usata in questo confronto
- Come ridurre i costi token di Claude Fable 5: le stesse leve di effort e caching applicate a un altro vendor