 AIREITER
Con $0.04 per milione di token in input, l'API hosted resta la via più immediata. I nuovi checkpoint open-weight, però, rendono praticabile l'inferenza locale: bisogna solo considerare il netto divario qualitativo fra il modello da 3B e quello da 600M.
Le tre versioni di Liquid d1 non sono equivalenti
Liquid AI propone oggi tre opzioni rilevanti: il servizio proprietario hosted d1, l'open-weight d1-3B e l'open-weight sperimentale d1-omni-600M. L'azienda non ha dichiarato che il modello hosted coincida con uno dei due checkpoint scaricabili: benchmark e dati sulla latenza vanno quindi attribuiti esclusivamente al modello che li ha prodotti.
| Opzione | Accesso e prezzo | Input | Contesto pubblicato | Ideale per |
|---|---|---|---|---|
Hosted d1 | Liquid API; $0.04 per 1M di token in input, nessun addebito sui token in output | Testo e immagini direttamente tramite Liquid | 66K indicati da Vercel | Integrazione rapida, costo d'inferenza trascurabile, nessuna gestione del modello |
d1-3B | Pesi scaricabili; nessun costo del modello per token | Testo, JSON e immagini | 32.768 token | Migliore qualità in locale, visione, valutazione in produzione |
d1-omni-600M | Pesi sperimentali scaricabili; nessun costo del modello per token | Testo con immagini oppure testo con audio | 16.384 token | Ingombro ridotto, esperimenti con comandi vocali, dispositivi edge con risorse limitate |
Tutti e tre rispondono a domande tipizzate, non generano testi. noul restituisce una probabilità di sì, choice le probabilità delle opzioni nominate e score una posizione ponderata per probabilità su una scala ordinata. Sono modelli adatti a routing, moderazione, ispezione, guardrail e scoring; non sostituiscono un modello conversazionale o per il coding.
La raccomandazione è semplice: per un pilot usare d1 hosted; scegliere d1-3B quando i dati devono restare in locale o la latenza non può includere un passaggio di rete; considerare d1-omni-600M un esperimento, salvo che audio o dimensioni ridotte siano il vincolo decisivo.
Prezzi API e costi dell'esecuzione locale
L'API Liquid AI d1 costa $0.04 per milione di token in input e non addebita token in output, perché il servizio restituisce decisioni anziché testo generato. Un carico di lavoro da 100 milioni di token in input costa $4, prima di eventuali commissioni del gateway; un miliardo di token in input costa $40.
A $0.04/M token, l'hosting autonomo raramente conviene guardando solo il costo dell'inferenza. Ha senso scegliere il deployment locale per privacy, utilizzo offline, latenza on-device, personalizzazione o impiego continuativo.
I due checkpoint open non hanno un prezzo hosted ufficiale per token. Al momento della recensione, le rispettive pagine Hugging Face non indicavano alcun provider di inferenza: il prezzo di d1 hosted non va quindi presentato come prezzo di d1-3B o d1-omni-600M.
Anche le immagini vengono fatturate come input nel servizio hosted. Liquid AI indica 1,5 token per patch da 32×32 pixel: un'immagine da 1024×1024 vale quindi 1.536 token prima del testo della domanda. A $0.04/M, la sola immagine costa circa $0.00006144; ogni domanda viene fatturata come prompt distinto e include l'immagine associata.
Open-weight non significa senza vincoli né senza costi
Entrambi i repository adottano la licenza lfm1.0 di Liquid AI, non Apache 2.0 né MIT. Le condizioni generali di prezzo di Liquid AI indicano che i modelli scaricabili sono gratuiti per uso commerciale sotto i $10 milioni di fatturato annuo aziendale; le organizzazioni più grandi dovrebbero verificare le condizioni commerciali attuali, anziché dedurre il permesso dalla dicitura “open-weight”.
Nel budget per l'esecuzione locale vanno inclusi acquisto di GPU o dispositivi, capacità inattiva, monitoraggio, aggiornamenti e tempo del personale. La bolletta hosted è variabile e molto ridotta; il costo locale è in gran parte fisso.
d1-3B punta sulla qualità, omni sulle dimensioni
L'annuncio Open d1 ufficiale riporta un punteggio Decision Index v0.2.1 di 48.57 per d1-3B e 15.95 per d1-omni-600M. Liquid AI ha eseguito entrambi con lo scorer ufficiale, ma i risultati non sono stati inviati alla classifica ufficiale.
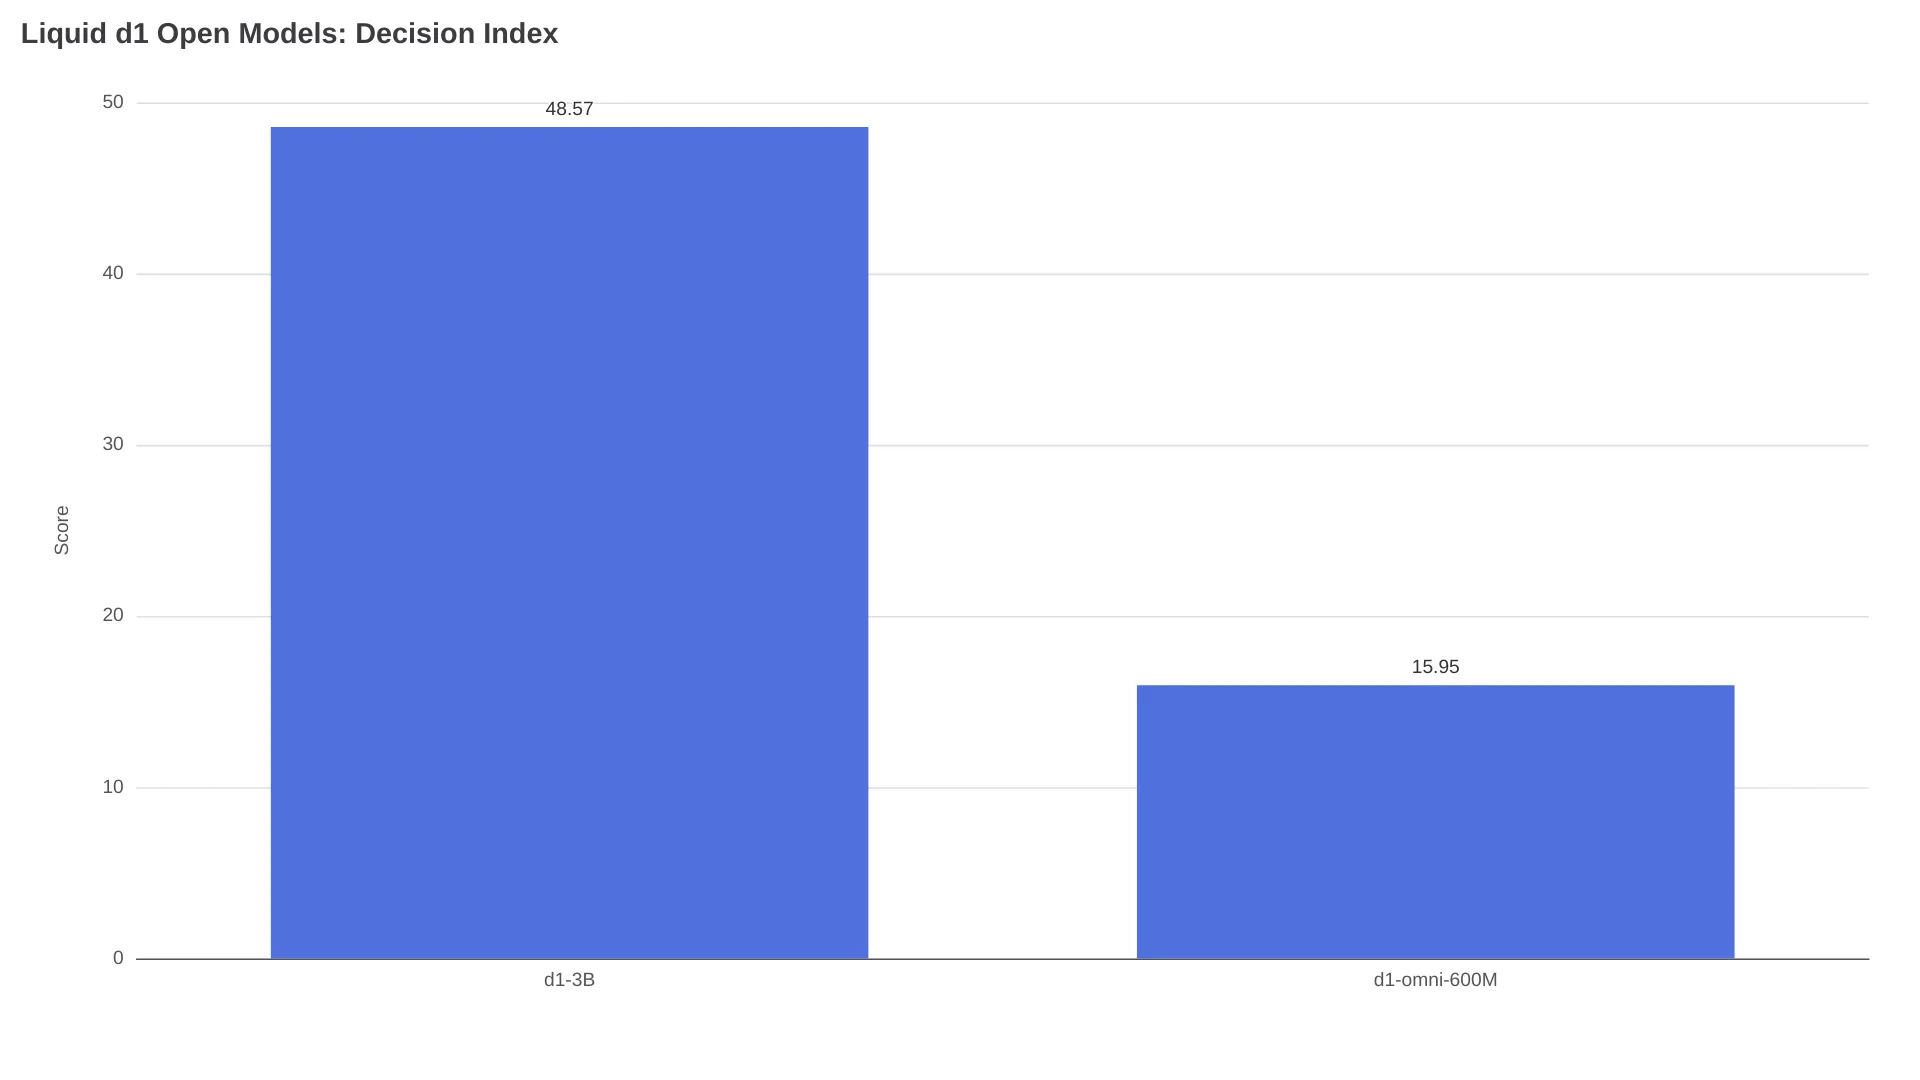
Il modello più piccolo non è scarso in ogni scenario. Su sette benchmark pubblici testuali, Liquid AI riporta medie di 82.9 per d1-3B e 78.4 per d1-omni-600M. Omni prevale su Civil Comments (95.8 contro 93.0) e PAWS-X (79.5 contro 76.9), mentre 3B guida nelle altre cinque attività elencate. Il divario molto più ampio nel Decision Index mostra che alcune buone prestazioni nella classificazione non rendono il checkpoint da 600M un sostituto generale del 3B.
| Specifica | d1-3B | d1-omni-600M |
|---|---|---|
| Numero dettagliato di parametri | 3.12B | 587M |
| Dimensioni del repository/pesi a precisione piena | Repository da 6.27 GB; pesi da 6.25 GB | Modello F32, circa 0.6B parametri |
| Contesto | 32.768 | 16.384 condivisi fra modalità |
| Spazio per il testo con immagini | Entro il contesto del modello | Testo dello stato e della domanda limitato a 896 token con immagini |
| Audio | No | Una clip mono a 16 kHz, fino a 30 secondi |
| Immagine e audio insieme | Non applicabile | Non supportato; genera ValueError |
| Tabella ufficiale della velocità | Sì | No; release di ricerca iniziale |
La model card di d1-omni-600M afferma che il modello è stato addestrato in float32. Float16 ha mantenuto la risposta principale su 243 righe testuali, 214 di immagini e 416 audio, mentre bfloat16 ha modificato la risposta principale nello 0.8% delle righe testuali e nell'1.7% di quelle audio. Il dtype va quindi validato: non è una semplice leva di ottimizzazione.
Il deployment locale è rapido da avviare, lungo da validare
Entrambe le model card espongono system_one per un singolo stato e system_one_batch per richieste aggregate. Il percorso più breve con d1-3B richiede Transformers 5.14 o versioni successive, PyTorch, TorchVision, Pillow e il codice personalizzato fornito dal repository.
- Installare le dipendenze documentate:
pip install "transformers>=5.14" torch torchvision pillow- Caricare il modello abilitando l'esecuzione del codice remoto del repository:
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- Inviare decisioni con nome anziché un prompt conversazionale:
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])
trust_remote_code=True significa che il Python del repository viene eseguito nel processo di serving. Prima della produzione, fissare un commit verificato invece di caricare un branch in evoluzione. Il repository d1-3B rimanda inoltre a quantizzazioni per runtime compatibili con llama.cpp, Ollama e LM Studio; un artefatto quantizzato della community rappresenta una decisione distinta, sia per la supply chain sia per l'accuratezza, rispetto ai pesi BF16 ufficiali.
La model card di d1-3B riporta tempi a caldo di 8 ms per una domanda su RTX 4090, 30 ms su Apple M5 Pro e 50 ms su Jetson Orin Nano. Uno stato da 3.4K token ha richiesto 102 ms, 640 ms e 1.640 ms sugli stessi dispositivi. I dati GPU sono mediane su 20 esecuzioni; il risultato di 8 ms su 4090 usa CUDA graphs compilati, e una nuova forma di input comporta overhead di compilazione o selezione del kernel.
Non esiste una tabella ufficiale delle prestazioni per d1-omni-600M. Un porting browser ha riportato circa 180 ms per commento per quattro decisioni:
“Non l'ho ancora testato su altre macchine, solo sul mio MBP M4 Pro.” — u/FinancialAd1961 su Reddit
Il risultato ottenuto su un singolo dispositivo dimostra la fattibilità nel browser, non le prestazioni su browser, GPU, quantizzazioni o dimensioni di batch differenti.
L'API è più semplice, ma l'identità del modello conta
L'accesso hosted diretto usa il modello d1 all'indirizzo https://api.liquid.ai/decisions/v1/systemone. Vercel utilizza liquid/d1; la sua pagina indica un contesto di 66K e lo stesso prezzo di $0.04/M per l'input. L'annuncio di Liquid del 5 ottobre riportava che Vercel e OpenRouter erano allora limitati al testo, mentre l'API diretta di Liquid accettava immagini.
I checkpoint open usano metodi Python locali basati sugli stessi concetti decisionali, ma la somiglianza dell'interfaccia non dimostra un'equivalenza di comportamento. Le probabilità possono differire abbastanza da far superare a un caso una soglia di automazione. Per ogni ramo valutato, registrare ID e revisione esatti del modello, dtype, probabilità e soglia.
Una migrazione dovrebbe quindi seguire quattro passaggi:
- Creare un set etichettato dalla distribuzione reale di produzione, includendo errori ambigui e costosi.
- Eseguire gli stessi stati, schema delle domande e criteri su ogni candidato.
- Scegliere le soglie in base al costo dei falsi positivi e dei falsi negativi, non a un punteggio benchmark globale.
- Eseguire il modello vincitore in shadow mode prima di autorizzare azioni distruttive, finanziarie, di controllo accessi o legate alla sicurezza.
Quale Liquid d1 scegliere?
L'API hosted è la raccomandazione predefinita per la maggior parte dei team. Il prezzo per token è troppo basso perché un piccolo pilot giustifichi un progetto di serving locale, e consente di evitare lavoro su driver, quantizzazione, warm-up e capacità.
| Esigenza | Scelta | Motivo |
|---|---|---|
| Percorso più rapido verso la produzione | Hosted d1 | Endpoint gestito e prezzo dell'input esplicito |
| I dati non devono lasciare il dispositivo o la rete | d1-3B | Checkpoint open più solido ed esecuzione locale |
| Migliore qualità decisionale pubblicata per un modello open | d1-3B | Decision Index di 48.57 contro 15.95 |
| Classificazione di comandi audio | d1-omni-600M | È l'unica opzione qui con audio, limitato a 30 secondi |
| Ingombro sperimentale minimo | d1-omni-600M | 587M parametri, ma nessuna tabella ufficiale della latenza |
| Spiegazioni aperte o azioni generate | Nessuno dei tre | Aggiungere un modello generativo dopo la fase decisionale |
Scegliere d1-3B anziché omni, a meno che l'ingombro da 600M o il percorso audio non siano indispensabili. Una riduzione di cinque volte nel numero di parametri è interessante, ma non annulla il divario di 32.62 punti nel Decision Index né lo status sperimentale di omni.
FAQ su Liquid AI d1
Liquid AI d1 è gratuito?
Il servizio hosted d1 costa $0.04 per milione di token in input e non prevede costi sui token in output. I checkpoint open possono essere scaricati senza un costo per token, ma restano applicabili le condizioni commerciali LFM 1.0 e i costi del calcolo locale.
d1-3B e d1-omni-600M sono il modello dell'API d1 hosted?
Liquid AI non ha documentato nessuno dei due checkpoint come identico al d1 hosted. Vanno trattati come prodotti correlati, ma con ID modello, contesti, benchmark e percorsi di deployment distinti.
Posso eseguire Liquid d1 con Ollama?
La pagina del modello d1-3B rimanda a quantizzazioni destinate a llama.cpp, Ollama, LM Studio e applicazioni compatibili. Prima di sostituire il percorso Transformers ufficiale, verificare quantizzatore, revisione sorgente, supporto all'API decisionale e accuratezza.
d1-3B supporta l'audio?
No. d1-3B accetta testo, JSON e immagini. d1-omni-600M accetta testo più immagini oppure testo più una clip audio fino a 30 secondi, ma non può accettare immagini e audio nella stessa richiesta.
Quanta VRAM serve per d1 in locale?
Liquid pubblica un file di pesi BF16 da 6.25 GB per d1-3B, ma non fornisce un requisito VRAM universale. Overhead del runtime, stato dell'encoder delle immagini, lunghezza del contesto, dimensione del batch, precisione e quantizzazione modificano tutti il totale; occorre misurare la configurazione prevista anziché equiparare la dimensione del file alla VRAM di picco.
Qualunque sia il percorso scelto, validare le soglie di probabilità su dati di produzione etichettati prima di automatizzare decisioni con conseguenze rilevanti.
Approfondimento correlato: la recensione dell'API Liquid AI d1 hosted analizza più nel dettaglio endpoint diretto, fatturazione delle immagini e contratto delle richieste tipizzate.