 AIREITER
Stessa fascia, stessa finestra di contesto da un milione di token, lancio a distanza di appena tre settimane e ragionamento al massimo sforzo attivo di default. Eppure, Qwen 3.8 Max e Kimi K3 hanno costi molto diversi: Kimi K3 è più forte nel coding, ma fattura $15 per milione di token in output, ovvero 2,5× i $6 di Qwen 3.8 Max. Qwen 3.8 Max è quindi l'opzione più economica e più recente, entrata in GA il 3 agosto 2026, con vantaggi anche su grafici e computer-use. Il rovescio della medaglia è che entrambi ragionano al massimo per impostazione predefinita: la tariffa di output superiore di Kimi K3 si accumula a ogni richiesta, mentre i pesi aperti di Qwen non arriveranno prima dell'11 agosto circa.
Specifiche quasi sovrapponibili, ma la scelta divide davvero
Qwen 3.8 Max e Kimi K3 sono entrambi modelli mixture-of-experts da trilioni di parametri, con contesto da un milione di token e visione nativa, pubblicati a metà 2026 a tre settimane di distanza. Sulla carta appartengono alla stessa categoria, ed è per questo che molti confronti si riducono a una sequenza di benchmark. La decisione pratica è più circoscritta: quanto siete disposti a pagare in output per avere un vantaggio nel coding e se vi servono subito pesi aperti o solide capacità multimodali.
| Specifica | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Parametri totali | 2.4T | 2.8T |
| Attivi per token | ~95B | 104B |
| Architettura | MoE (~4% attivo) | MoE (16 di 896 esperti) |
| Finestra di contesto | ~1M (991K input massimo) | 1,048,576 |
| Visione | Sì (input testuale + immagini) | Sì (nativa) |
| Ragionamento predefinito | xhigh, thinking attivo | massimo sforzo, reasoning attivo |
| Pesi aperti | No (attesi ~11 agosto) | Sì (HF, 27 luglio, 1.56TB MXFP4) |
| Stato API | GA, 3 agosto 2026 | GA |
Fonti: confronto diretto di yottalabs, Alibaba QwenCloud via AIReiter e Moonshot platform.kimi.ai, verificate il 6 agosto 2026.
Prezzi, simulazione dei costi e modalità di accesso
Entrambi i fornitori pubblicano prezzi per token, ma la differenza non è dove suggerirebbe il numero complessivo di parametri. Si concentra sull'output, cioè la voce che assorbe la maggior parte del budget dei modelli di reasoning. Kimi K3 costa $15 per milione di token in output, contro i $6 di Qwen 3.8 Max; inoltre entrambi i modelli esplicitano il ragionamento di default, quindi questa tariffa copre sia le tracce di reasoning sia la risposta finale.
| Prezzo per 1M token | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Input (cache miss) | $2.00 | $3.00 |
| Input (cache hit) | $0.25 | $0.30 |
| Output (incluso thinking) | $6.00 | $15.00 |
| Contesto | ~1M | 1,048,576 |
Fonti: pagina del modello Alibaba QwenCloud, aggiornata il 2 agosto 2026, e Moonshot platform.kimi.ai/docs/pricing/chat-k3, verificate il 6 agosto 2026.
Prendendo un carico di coding tipico da 20M token in input, con cache hit al 60%, e 5M token in output, Kimi K3 arriva a circa $103 ($27.60 di input più $75 di output), contro circa $49 per Qwen 3.8 Max ($19 di input più $30 di output). Il divario di 2× dipende quasi interamente dall'output: la cache riduce la differenza sull'input, ma non su quella voce e, dato che entrambi i modelli usano il reasoning al massimo sforzo per impostazione predefinita, la quota di output è consistente.
L'accesso non è simmetrico. Qwen 3.8 Max è entrato in disponibilità generale nell'API Alibaba il 3 agosto 2026, ma i suoi pesi non sono pubblici: la pagina del modello indica ancora Open Source: No, con pubblicazione prevista su Hugging Face e ModelScope nella settimana dell'11 agosto (Alibaba, tramite la pagina prezzi di Qwen 3.8 Max). Kimi K3 è invece l'opzione aperta: Moonshot ha pubblicato il checkpoint MXFP4 da 1.56 TB il 27 luglio e l'API è attiva.
Kimi K3 è disponibile anche tramite l'endpoint API di Kimi K3 di AIReiter, alla tariffa ufficiale Moonshot e senza markup: utile per testare K3 accanto ad altri modelli con un'unica fattura. Qwen 3.8 Max non è ancora integrato.
Kimi K3 è avanti nel coding agentico
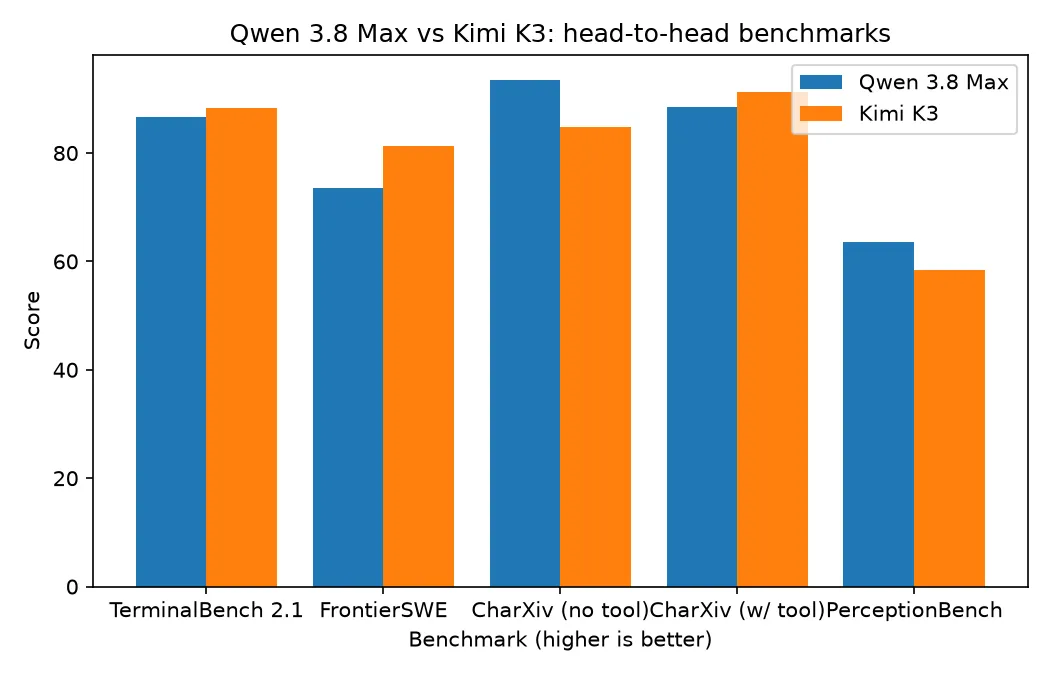
Kimi K3 è il modello da scegliere per il coding multi-step: loop agentici, refactoring di repository e task in stile SWE, dove deve invocare strumenti e riprendersi da vicoli ciechi. Nei benchmark agentici pubblici supera con regolarità Qwen 3.8 Max, con il margine più ampio proprio nelle attività più vicine al lavoro di sviluppo reale.
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| FrontierSWE | 73.5 | 81.2 |
| TerminalBench 2.1 | 86.6 | 88.3 |
| CharXiv (con strumenti) | 88.4 | 91.3 |
Fonte: confronto diretto di yottalabs, verificato il 6 agosto 2026.
Il giudizio della community segue i numeri, con la riserva sui costi che definisce questo confronto:
"K3 è di un altro livello. Qwen 3.8 gli è molto simile. Tuttavia, né l'abbonamento né i costi API sono giustificati per nessuno dei due modelli così come sono…" — r/Qwen_AI
"In questo esercizio K3 surclassa Qwen 3.8 di gran lunga; Qwen ha generato questa landing page 3 volte più velocemente di Kimi." — @filicroval su X
Kimi K3 ottiene anche un punteggio di intelligenza grezza più alto, pari a 57 nell'Artificial Analysis Intelligence Index, ma non è veloce: circa 39 token in output al secondo e 3.1 secondi al primo token (Artificial Analysis). Il compromesso è chiaro: qualità e apertura in cambio di latenza e costi maggiori.
Qwen 3.8 Max punta su multimodalità e rapporto qualità-prezzo
Qwen 3.8 Max è la scelta migliore quando il carico di lavoro richiede di leggere grafici, screenshot o di controllare un browser, e quando il costo dell'output conta più di qualche punto in più nei benchmark di coding. Supera Kimi K3 nei test su documenti e percezione, mantiene un primato verificato in un benchmark di computer-use e applica il 40% della tariffa output di Kimi K3.
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| CharXiv (senza strumenti) | 93.5 | 84.8 |
| PerceptionBench | 63.5 | 58.5 |
| OSWorld-Verified | 86.1% (SOTA) | nessun punteggio pubblico |
Fonte: confronto diretto di yottalabs, verificato il 6 agosto 2026.
Il punto debole di Qwen 3.8 Max coincide esattamente con il terreno su cui Kimi K3 eccelle e compete con i modelli closed di frontiera. Su SWE-bench Pro totalizza 67.7, molto sotto l'80 di Claude Fable 5 (tabella pubblicata da Alibaba, gestita dal fornitore), quindi non è il modello per le valutazioni di software engineering più difficili. Al momento della stesura, la sua API ha inoltre appena tre giorni di vita, essendo entrata in GA il 3 agosto 2026, e i pesi restano chiusi: chi deve fare self-hosting oggi dovrà aspettare oppure scegliere Kimi K3.
Quale scegliere in base al carico di lavoro
La scelta dipende meno da quale modello sia oggettivamente migliore e più da ciò per cui lo si chiama. La matrice seguente associa i casi d'uso più comuni a una scelta e alla relativa motivazione verificata.
| Se il vostro carico di lavoro è… | Scegliete | Perché |
|---|---|---|
| Loop agentici, refactoring di repository, task SWE (costo non prioritario) | Kimi K3 | FrontierSWE 81.2 contro 73.5, TerminalBench 88.3 contro 86.6 |
| Parsing di documenti/grafici, browser o computer-use, con attenzione ai costi | Qwen 3.8 Max | CharXiv 93.5, OSWorld 86.1% SOTA, output $6 contro $15 |
| Self-hosting oggi | Kimi K3 | Pesi su HF dal 27 luglio; quelli di Qwen arrivano intorno all'11 agosto |
FAQ
Qwen 3.8 Max è migliore di Kimi K3 per il coding?
No. Kimi K3 è in vantaggio nei benchmark di coding agentico più rilevanti, con 81.2 contro 73.5 in FrontierSWE e 88.3 contro 86.6 in TerminalBench 2.1. Per le attività di engineering multi-step, Kimi K3 è quindi la scelta più solida.
Quale costa meno tra Qwen 3.8 Max e Kimi K3?
Qwen 3.8 Max. Costa $6 per milione di token in output contro i $15 di Kimi K3, e $2 in input contro $3, con prezzi da cache hit simili: su un tipico carico di coding il divario è di circa 2×.
Quale costa meno per il coding agentico con reasoning al massimo?
Resta Qwen 3.8 Max: entrambi fatturano i token di reasoning come output al massimo sforzo, perciò la tariffa di $15/M di Kimi K3 amplia il divario proprio nel carico di coding in cui è superiore.
Entrambi supportano un contesto da un milione di token?
Sì. Qwen 3.8 Max accetta circa 991K token in input, meno quando il thinking è attivo, mentre Kimi K3 arriva a 1,048,576; entrambi dispongono nominalmente di finestre da un milione di token.
I pesi sono aperti?
Quelli di Kimi K3 sì. Moonshot ha rilasciato il checkpoint MXFP4 da 1.56 TB il 27 luglio 2026. Quelli di Qwen 3.8 Max non ancora: Alibaba li indica come chiusi, con rilascio su Hugging Face e ModelScope previsto nella settimana dell'11 agosto.
Approfondimenti correlati
- Pagina del modello Kimi K3: analisi dedicata a Kimi K3
- Prezzi API di Qwen 3.8 Max: analisi completa di prezzi e aspetti tecnici di Qwen 3.8 Max
- Qwen3.8-27B: la versione Qwen 3.8 più piccola, con pesi aperti, per il self-hosting
- Kimi K2.7 Code vs GLM 5.2: confronto affine nello stesso gruppo di modelli per coding