 AIREITER
Un download da 17GB non equivale a un agente locale comodo da usare. Qwen3.8-27B è un valido modello open weight con licenza Apache-2.0, ma il reasoning extra-elevato attivo di default può trasformare un compito rapido in una lunga attesa se quantizzazione, budget di contesto e stack di serving non sono adeguati alla macchina.
Conviene eseguire Qwen3.8-27B in locale?
Qwen3.8-27B ha senso in locale per gli sviluppatori con circa 24GB di memoria GPU o memoria unificata disponibile, che tengono alla gestione locale dei dati e accettano risposte interattive più lente rispetto a una rapida API ospitata. Il motivo principale per sceglierlo non è un singolo benchmark: è un modello dense con licenza Apache-2.0, input per immagini e video, contesto nativo da 262.144 token e reasoning configurabile, in una dimensione ancora distribuibile. La model card ufficiale di Qwen indica il rilascio al 14 agosto 2026.
Non va considerato un sostituto automatico di qualunque modello API. I risultati ufficiali sono dichiarati dal fornitore, le quantizzazioni aggressive modificano sia qualità sia velocità, e il reasoning xhigh predefinito è un'impostazione iniziale poco adatta a molte attività interattive locali.
Prima la memoria disponibile, poi i benchmark
Qwen3.8-27B è un modello dense: ogni token generato attiva l'intero modello. Per questo banda di memoria, KV cache, quantizzazione e contesto richiesto incidono in modo determinante, molto più di quanto lasci intuire la sola dimensione del file dei pesi. La card di Qwen documenta 262K token di contesto nativo, ma una sessione locale può essere configurata molto al di sotto di quel limite per conservare memoria e velocità utilizzabili. Gli esempi di serving di Qwen mostrano il massimo di 262.144 token: è un limite di capacità, non un'impostazione sensata di default per ogni macchina consumer.
| Memoria disponibile | Punto di partenza pratico | Cosa aspettarsi | Raccomandazione |
|---|---|---|---|
| 12GB | Quant aggressiva di classe Q3 con offload su CPU/RAM | Contesto breve e compromessi importanti sulla latenza | Scegliere un modello più piccolo, salvo che l'obiettivo sia sperimentare in locale |
| 16GB | Q3 aggressiva oppure quant in stile Q4 scelta con attenzione | Utilizzabile per attività brevi e supervisionate; contesto e velocità sono limitati | Testare prima di affidarle un workflow agentico |
| 24GB | Quant di classe Q4 | Il punto di ingresso pratico per coding, tool e contesto moderato | La configurazione più adatta alla maggior parte degli utenti locali di Qwen3.8-27B |
| 32GB+ | Quant di qualità superiore o più margine per il contesto | Meno compromessi su KV cache e sessioni lunghe | Preferibile per lavoro agentico continuativo |
Si tratta di indicazioni operative, non di requisiti minimi del fornitore. Utenti indipendenti riferiscono che una RTX 3060 da 12GB può eseguire una build locale e gestire il tool calling, mentre altri avvertono che un agente dense con quella VRAM ha prestazioni scarse; è proprio questo disaccordo a mostrare perché non bisogna confondere “si carica” con “funziona bene”. La discussione tra utenti reali è su r/LLM.
Una scheda da 24GB è una base per un workflow 4-bit confortevole, non una garanzia di comfort con contesti lunghi. Una valutazione incentrata sul deployment stima il fabbisogno totale di memoria a 4 bit in 17-19GB, ma avverte anche che la KV cache cresce rapidamente durante sessioni agentiche prolungate. L'analisi di Neoteric sul deployment locale è utile per pianificare, ma non è una specifica hardware ufficiale.
Perché le impostazioni predefinite possono far sembrare Qwen3.8-27B inutilizzabile
Qwen3.8-27B attiva il thinking per impostazione predefinita. La card ufficiale espone valori reasoning_effort tra cui xhigh, medium e low, oltre a enable_thinking=False per richieste senza thinking; inoltre abilita preserve_thinking di default. La sezione sulle best practice di Qwen avverte che un effort di reasoning inferiore non riduce sempre il tempo necessario a completare il compito, ma un livello elevato resta un default costoso per attività banali.
Un test locale di Simon Willison rende evidente la differenza. Con una build Q4_K_M in LM Studio, riferisce che un primo compito SVG ha usato 22.276 token di reasoning e richiesto 21 minuti con l'impostazione predefinita; disabilitando il reasoning ha ottenuto un risultato diverso in 137 secondi. La sua configurazione misurata non è un benchmark universale, ma rende concreto il rischio di una configurazione sbagliata. Leggi il test completo e le trascrizioni.
“Mi aspettavo che fosse più o meno al livello di 3.6 35b, ma più lento per via della quantizzazione pesante, e invece ha finito per surclassarlo ovunque.” u/AltruisticList6000, r/LocalLLaMA, a proposito di un esperimento Q3 su RTX 4060 Ti da 16GB.
Questo risultato positivo non elimina il compromesso. Un altro resoconto di un utente reale descrive un contesto limitato a 32K e una sessione agentica diventata inaffidabile, mentre un altro utente raccomanda istruzioni chiare e atomiche per il lavoro di programmazione locale. La discussione sul workflow è qui.
Cosa offre ufficialmente Qwen3.8-27B
Qwen3.8-27B è un modello dense vision-language nativo, non un modello MoE. La card ufficiale descrive input testuale, di immagini e video; 64 layer; una hidden dimension di 5.120; 262.144 token di contesto nativo; e licenza Apache-2.0. Documenta anche un'estensione basata su YaRN fino a 1M token, avvertendo esplicitamente che YaRN statico può penalizzare le prestazioni sui testi brevi. Le specifiche ufficiali e le indicazioni sul contesto devono avere la precedenza sui riepiloghi di rilascio di terze parti.
Il repository ufficiale cita Transformers, vLLM, SGLang, TokenSpeed e percorsi locali quantizzati come llama.cpp, Ollama e LM Studio. Il supporto del runner è importante perché il modello usa un'architettura ibrida Gated DeltaNet e Gated Attention: prima di diagnosticare un errore del modello, aggiornare il runner. Il repository quickstart di Qwen include esempi di serving compatibili con OpenAI.
Cosa dimostrano, e cosa non dimostrano, i benchmark pubblicati
Qwen riporta progressi rilevanti rispetto a Qwen3.6-27B nelle valutazioni di coding e computer use. Il grafico mostra quattro punteggi dichiarati dal fornitore nella model card ufficiale, non risultati riprodotti in modo indipendente.
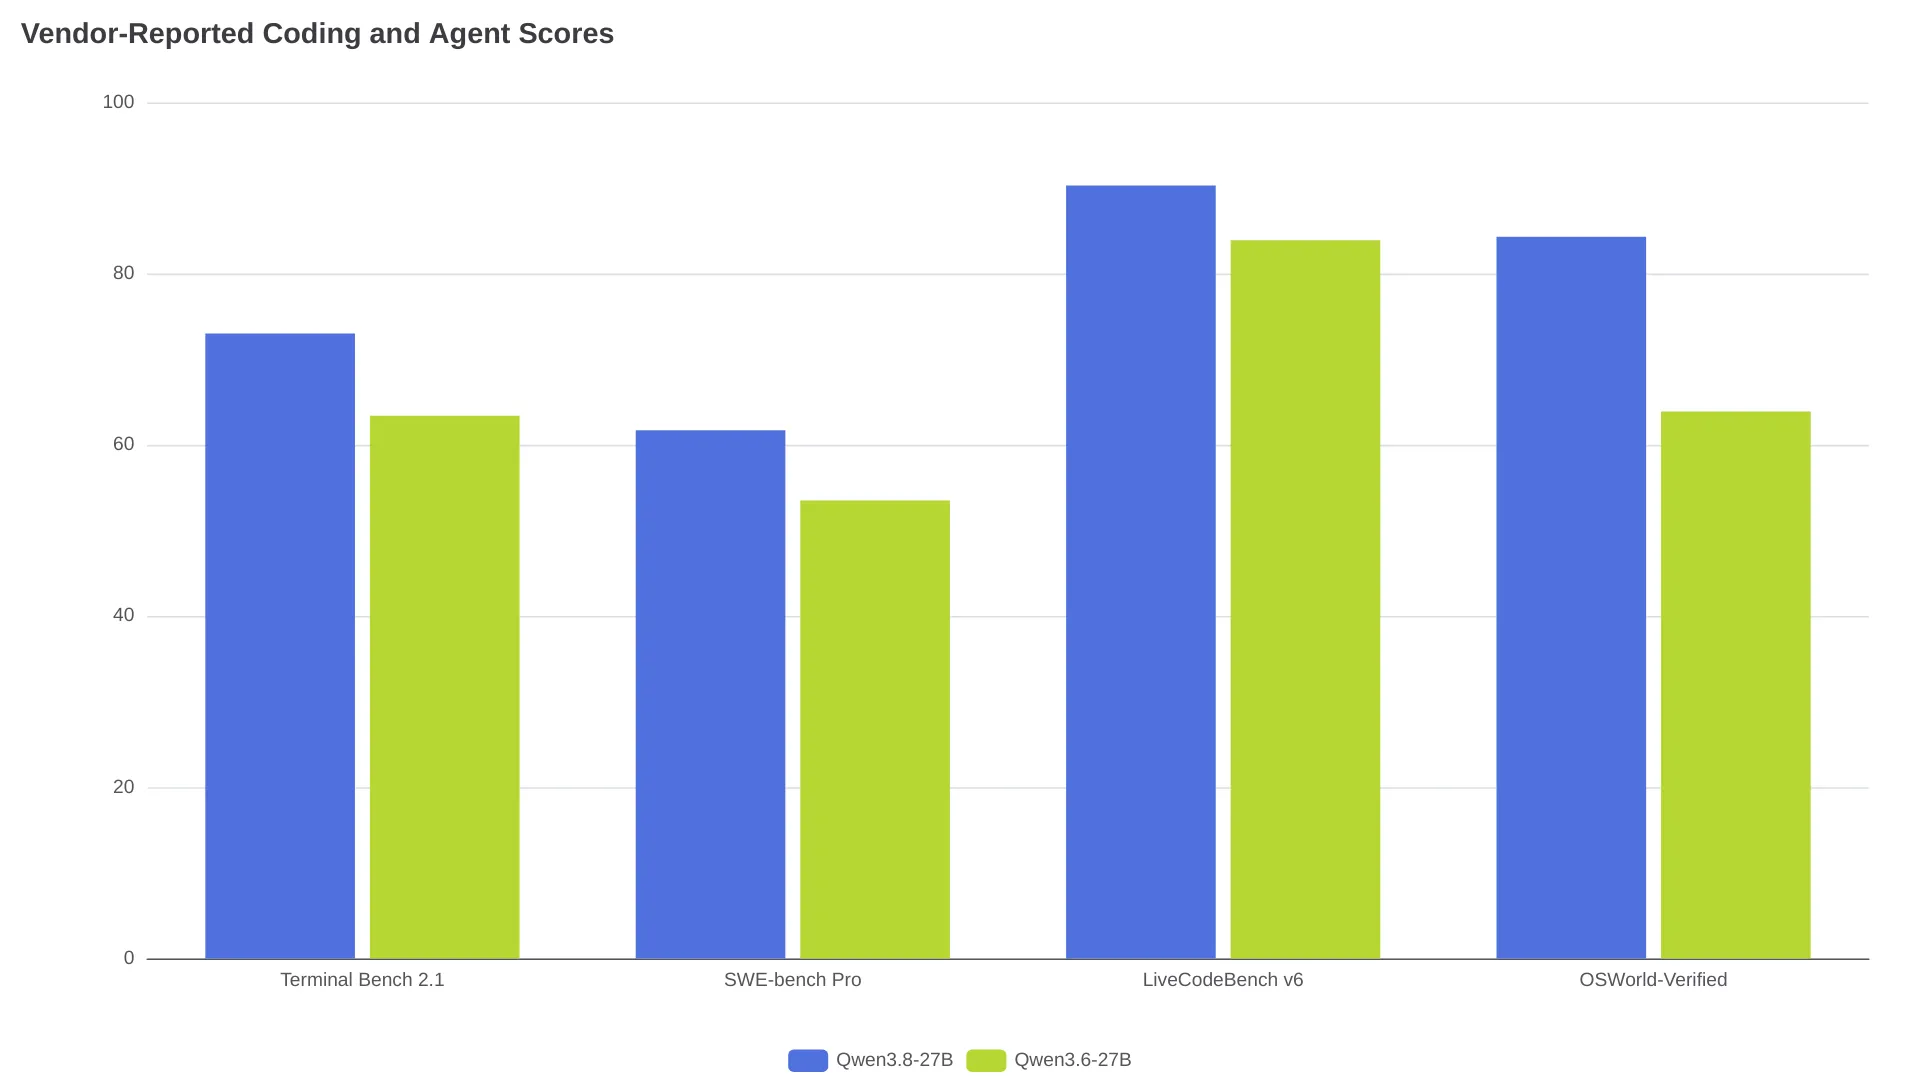
| Benchmark ufficiale | Qwen3.8-27B | Qwen3.6-27B | Come leggerlo |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Indicatore di coding agentico nel terminale |
| SWE-bench Pro | 61.7 | 53.5 | Indicatore di risoluzione di issue nei repository |
| LiveCodeBench v6 | 90.3 | 83.9 | Indicatore di valutazione del coding |
| OSWorld-Verified | 84.3 | 63.9 | Indicatore di computer use |
La model card pubblica confronto completo e metodologia. Per SWE-bench Pro e DeepSWE 1.1, Qwen dichiara di aver usato un harness Claude Code con temperature=1.0, top_p=0.95 e contesto da 256K; include inoltre benchmark interni come QwenSWEBench. Esamina la metodologia prima di confrontare i modelli. Questi numeri supportano l'idea di “un sostanziale aggiornamento ufficiale rispetto a Qwen3.6-27B”, non quella di “un sostituto universale dimostrato per un'API frontier”.
Una prima configurazione locale equilibrata
Un primo deployment locale dovrebbe privilegiare la prevedibilità rispetto al reasoning massimo. Usare un runner aggiornato, iniziare con una quant di classe Q4 su hardware di classe 24GB, impostare un limite di contesto volutamente moderato e provare task agentici brevi prima di consentire loop autonomi lunghi.
- Avviare un server compatibile con OpenAI usando un engine supportato come vLLM o SGLang. Qwen pubblica esempi con
Qwen/Qwen3.8-27B,--reasoning-parser qwen3e--tool-call-parser qwen3_coder. I comandi ufficiali sono nel repository. - Per classificazione, estrazione o piccole modifiche di codice rapide, impostare
enable_thinking=False. Qwen raccomanda per il non-thinking i valori di samplingtemperature=0.7,top_p=0.80epresence_penalty=1.5. Vedi l'esempio API ufficiale. - Per il debugging che richiede reasoning, provare
lowomediumprima dixhigh, quindi confrontare tempo totale di completamento e qualità del tool calling su un'attività reale. - Disabilitare il thinking preservato quando i task sono indipendenti. Conservarlo solo quando il contesto di reasoning multi-turn vale la pressione aggiuntiva sulla KV cache.
- Prima dell'uso non supervisionato, testare tool calling, conformità allo schema di output e rollover del contesto. Un modello che scrive buon codice con un prompt può comunque fallire in un loop agentico di lunga durata.
Quando Qwen3.8-27B non è la scelta locale giusta
Qwen3.8-27B non è la prima scelta giusta quando 12GB o meno sono un limite rigido, quando la latenza di risposta conta più del controllo locale oppure quando un agente deve operare senza supervisione con requisiti stringenti di formato. Può funzionare in configurazioni limitate, ma questo non equivale a offrire throughput interattivo affidabile o contesto sufficiente per il lavoro su repository.
I test indipendenti rilevano inoltre una tendenza a output lunghi, alta tail latency e un'aderenza non perfetta alle istruzioni rigorose. Una valutazione strutturata ha registrato 4 timeout su 49 test e un tempo di risposta P95 di 143,32 secondi sulla propria configurazione workstation. Questi dati non sono garanzie di prestazioni trasferibili, ma sono un utile avvertimento contro l'idea di trattare un modello locale da 27B come componente di automazione senza revisione. Il report di test di CrucibleMark fornisce configurazione e limiti.
Qwen3.8-27B: domande frequenti
Qwen3.8-27B è stato rilasciato ufficialmente?
Sì. Il repository ufficiale di Qwen indica il rilascio di Qwen3.8-27B su Hugging Face Hub e ModelScope al 14 agosto 2026. La timeline di rilascio di Qwen è la fonte primaria.
Qwen3.8-27B può girare su una GPU da 16GB?
Una configurazione fortemente quantizzata con contesto breve può funzionare, ma resta un deployment limitato. Le segnalazioni di utenti reali vanno da promettenti risultati Q3 su RTX 4060 Ti da 16GB agli avvertimenti che l'uso di un agente dense con poca VRAM comporta compromessi notevoli in velocità e qualità. Discussione su LocalLLaMA.
Qwen3.8-27B ha una finestra di contesto da 1M token?
Ha 262.144 token di contesto nativo. La model card descrive il contesto da 1M tramite scaling YaRN/RoPE e avverte che YaRN statico può ridurre le prestazioni sui testi brevi. Documentazione ufficiale sul contesto.
Come si disabilita il thinking di Qwen3.8-27B?
Impostare enable_thinking=False nella richiesta API, come mostrato nella model card di Qwen. Per le attività che richiedono reasoning, iniziare con low o medium invece di presumere che xhigh sia appropriato. Esempio ufficiale senza thinking.
Chi usa Qwen3.6-27B dovrebbe aggiornare?
Conviene aggiornare se l'hardware esistente supporta già la stessa classe di deployment e il carico di lavoro beneficia dei miglioramenti in coding, computer use o multimodalità. Conviene mantenere Qwen3.6-27B se lo stack attuale è stabile e il nuovo runner, la quantizzazione o il comportamento del reasoning non sono ancora stati validati sul workflow effettivo.
Scegli in base al vincolo che non puoi cambiare
| Vincolo | Prossima mossa consigliata |
|---|---|
| Gestione locale dei dati e 24GB disponibili | Eseguire Qwen3.8-27B a Q4, iniziando con reasoning basso o disattivato |
| Solo 12GB-16GB | Provare una build in stile Q3 per task brevi e supervisionati, oppure scegliere un modello più piccolo |
| Sessioni agentiche lunghe su repository | Prevedere margine di 32GB+ e validare il comportamento della KV cache prima dell'adozione |
| Risposte interattive rapide | Usare un'API ospitata o un modello locale più piccolo |
| Formattazione rigorosa o pubblicazione senza supervisione | Mantenere un livello di validazione e revisione umana; non affidarsi alla sola conformità del modello |
Qwen3.8-27B amplia ciò che un modello locale da 27B può tentare. Non elimina però il lavoro sui sistemi: scegliere la quantizzazione in base all'hardware, controllare il reasoning in modo consapevole e valutare il modello su un workflow rappresentativo, non sulla dimensione del download.