 AIREITER
Un job multi-nodo su Modal viene fatturato in base all’intera allocazione, non attraverso un abbonamento separato per il cluster. Modal Clusters è generalmente disponibile, ma il conto continua a dipendere da GPU, CPU, memoria, storage e traffico di rete consumati da ogni container.
Prezzi di Modal Clusters in un minuto
La pagina ufficiale dei prezzi di Modal e l’annuncio della disponibilità generale descrivono un modello di fatturazione basato sull’utilizzo e l’entry point @modal.clustered per avviare insieme più container. RDMA è un’opzione che modifica il percorso di comunicazione, non la formula di base dei prezzi.
numero di GPU × secondi GPU × tariffa GPU + secondi CPU + GiB-secondi di memoria + storage + eventuale traffico in uscita
Questa formula è fondamentale perché un cluster moltiplica l’intera allocazione dei nodi. Se un job richiede quattro nodi con otto GPU H100 per nodo, il calcolo parte da 32 H100, non da un coordinatore più alcuni worker “gratuiti”.
Cosa aggiunge Modal Clusters al listino
Il rilascio GA di Modal del 1° ottobre 2026 trasforma l’esecuzione multi-nodo in una primitiva gestita. size stabilisce il numero di container, mentre rdma=True abilita il percorso di comunicazione ad alta velocità dove supportato (annuncio di Modal).
La documentazione descrive un meccanismo di gang scheduling: Modal prova a posizionare insieme il gruppo richiesto, invece di avviare un job parziale che non potrebbe procedere. Tra i workload supportati rientrano il training distribuito, il fine-tuning, l’inferenza model-parallel e le architetture prefill/decode che richiedono una comunicazione sincronizzata tra le GPU.
Anche la documentazione sui cluster chiarisce alcuni limiti pratici: le GPU vengono allocate per nodo intero, i cluster composti solo da CPU non sono supportati e il fallimento o il preemption di un container può far fallire la chiamata clustered. Viene restituito solo l’output del rank 0, quindi i job lunghi devono salvare i checkpoint al di fuori del container.
Le tariffe GPU che determinano il costo di Modal Clusters
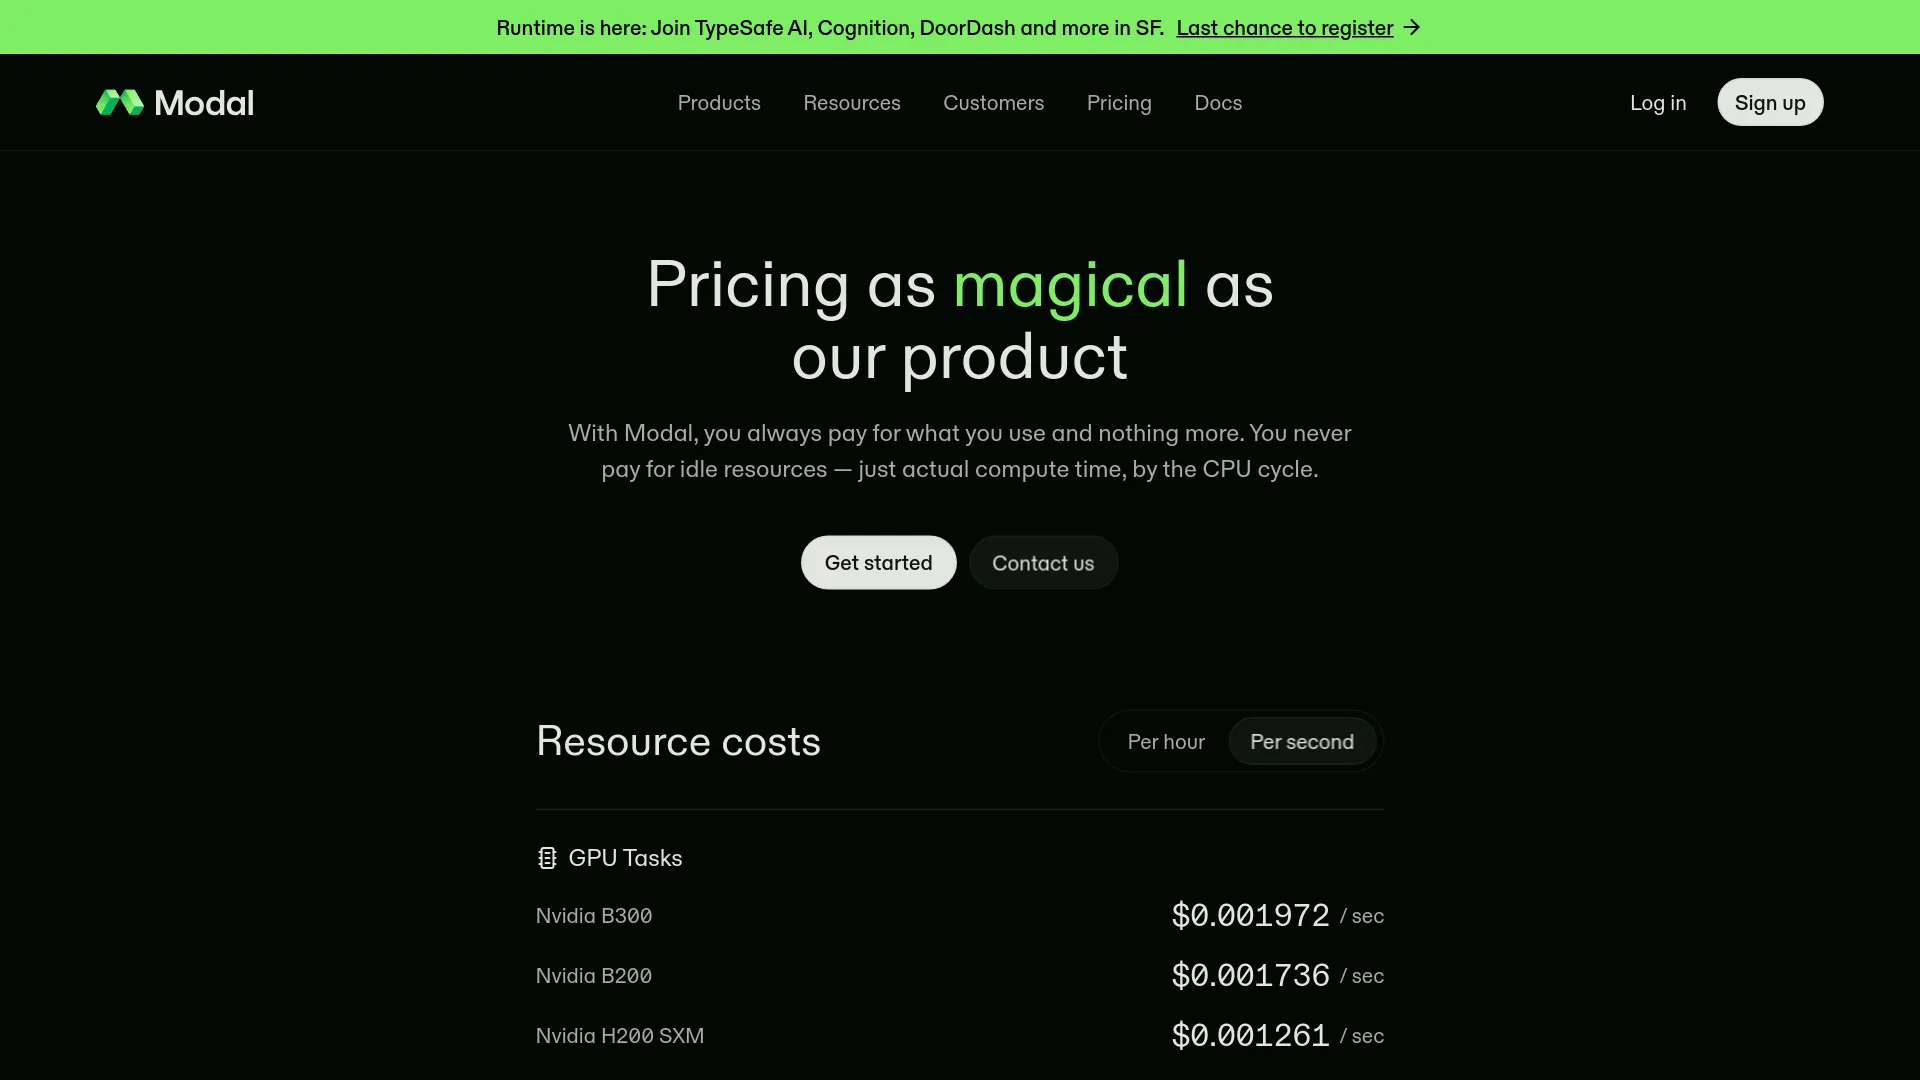
Le tariffe pubbliche qui sotto sono il punto di partenza più utile per una stima. I valori orari sono calcolati a partire dai prezzi al secondo ed escludono CPU, memoria, storage e possibili moltiplicatori regionali.
| GPU | Al secondo | Circa per GPU-ora |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modal indica inoltre una tariffa CPU di $0.0000131 per core fisico al secondo e una tariffa memoria di $0.00000222 per GiB-secondo. I volumi costano $0.09 per GiB al mese, con il primo 1 TiB gratuito. Il traffico di rete in uscita è indicato a $0.04 per GiB oltre la franchigia inclusa. Prima di avviare un job di grandi dimensioni, verifica sempre i valori aggiornati sul listino ufficiale.
Esempio pratico: quattro nodi con otto H100
Immaginiamo un job di training distribuito con size=4 e H100:8 su ciascun nodo.
- Quattro nodi × otto GPU = 32 GPU H100.
- 32 × $3.95 all’ora = circa $126.40 all’ora di soli costi GPU.
- Considera $126.40 come il costo minimo delle GPU; CPU, memoria, storage e traffico in uscita vanno aggiunti.
È questo il valore da confrontare con la capacità riservata o dedicata. Il vantaggio del serverless è che il cluster può ridimensionarsi dopo il picco; non significa che un cluster completamente occupato diventi economico.
I limiti del piano possono contare più del listino
Una funzionalità disponibile per tutti non equivale a una capacità illimitata. I piani workspace pubblicati da Modal includono vincoli di concorrenza e di piattaforma che possono impedire l’avvio di un cluster grande prima ancora che il prezzo diventi il problema principale.
| Piano | Costo della piattaforma | Credito di calcolo incluso | Concorrenza GPU pubblicata |
|---|---|---|---|
| Starter | $0/mese | $30/mese | 10 GPU |
| Team | $250/mese | $100/mese | 50 GPU |
| Enterprise | Personalizzato | Personalizzato | Personalizzato / limiti più elevati |
Un esperimento con 32 H100 utilizza già 32 GPU, quindi il piano Starter non può supportare l’esempio precedente con un limite di concorrenza di 10 GPU. Il piano Team può rientrare nel numero di GPU sulla carta, ma disponibilità effettiva, selezione della regione e hardware richiesto continuano a influenzare la pianificazione.
Non confondere il credito Starter da $30 con 30 ore-GPU gratuite. Alla tariffa H100 indicata equivale a circa 7,6 ore-GPU H100, prima di conteggiare le altre risorse del job.
Quando Modal Clusters conviene davvero
Modal Clusters dà il meglio di sé quando il job è grande, intermittente e troppo oneroso da mantenere sempre provisioned. Un picco di training che dura alcune ore e poi si spegne beneficia maggiormente dello scale-to-zero rispetto a un cluster che resta attivo per settimane.
Sceglilo per:
- Fine-tuning distribuito in cui tutti i nodi devono partire insieme.
- Brevi sessioni di training con capacità GPU costosa.
- Inferenza multi-nodo che richiede RDMA o parallelismo del modello.
- Team Python che altrimenti dovrebbero gestire Kubernetes, SLURM o una configurazione RDMA manuale.
Una funzione Modal su singolo nodo è più adatta quando il modello entra in una sola macchina. L’infrastruttura dedicata o riservata merita un confronto serio quando l’utilizzo è prevedibile, il workload richiede uno SLA fisso o l’obiettivo principale è ottenere il costo più basso per GPU-ora su base continuativa.
Anche una discussione tra utenti aiuta a tracciare un confine utile. In un thread dedicato alla computer vision, u/Substantial_Camel735 ha consigliato di mantenere la ricerca vettoriale su un VPS invece di eseguirla sui worker Modal (discussione su Reddit). È il parere architetturale di un singolo professionista, non un benchmark valido per l’intera piattaforma.
“Stiamo per abbandonare Modal, ma quel design mi sembra corretto; non userei però i worker Modal per eseguire la ricerca: la farei sul tuo VPS interrogando il tuo vector DB.” — u/Substantial_Camel735, r/computervision
I controlli operativi da fare prima di un grande lancio
- Moltiplica l’allocazione completa. Controlla
size × GPU per nodo, poi confronta il totale con la concorrenza del workspace. - Parti dal cluster più piccolo che abbia senso. Un test su due nodi può far emergere problemi di immagini, NCCL, rank e rendezvous prima che un lancio da 32 GPU moltiplichi il conto.
- Tieni separato il debug di RDMA da quello dell’applicazione. Se il workload lo consente, valida il job distribuito senza RDMA; poi abilita
rdma=Truee misura il percorso sensibile alla comunicazione. - Salva i checkpoint su storage persistente. Il fallimento o il preemption di un rank può far fallire l’intera chiamata; un retry senza checkpoint potrebbe ripetere tutto il job costoso.
- Metti a budget CPU, memoria e traffico in uscita. Il calcolo delle GPU è solo la prima voce della fattura, soprattutto quando dataset o output attraversano i confini regionali.
- Decidi se il vincolo regionale è davvero necessario. Limitare il posizionamento può ridurre il pool disponibile per la pianificazione e modificare il moltiplicatore di prezzo; considera la località un requisito da misurare e verificalo nella documentazione aggiornata sui prezzi regionali.
RDMA non compare come costo separato nei prezzi ufficiali di Modal. Il suo valore è nelle prestazioni: il training sincronizzato e i trasferimenti di KV cache di grandi dimensioni possono diventare limitati dalla rete se eseguiti sul normale TCP. Il compromesso è che hardware e posizionamento compatibili con RDMA possono ridurre la disponibilità.
Domande frequenti su Modal Clusters
Esiste un costo separato per l’API di Modal Clusters?
Non è pubblicato alcun sovrapprezzo specifico per i cluster. Modal fattura le risorse utilizzate da ogni container: GPU, CPU, memoria, storage e traffico di rete applicabile.
Qual è la dimensione massima di un cluster?
Il materiale relativo alla disponibilità generale indica cluster pubblici fino a 32 nodi o 256 GPU; per esigenze superiori è necessario rivolgersi a Modal (annuncio GA). Restano comunque validi i limiti di concorrenza del workspace e la capacità disponibile.
Modal Clusters può eseguire inferenza?
Sì, ma il workload deve adattarsi al modello di esecuzione clustered. L’inferenza multi-nodo o model-parallel è un caso d’uso più adatto rispetto a un normale endpoint HTTP; le web function clustered hanno alcuni limiti, tra cui il fatto che il traffico venga consegnato al rank 0 (documentazione sui cluster).
La scelta più pratica
| Il tuo workload | Punto di partenza consigliato |
|---|---|
| Il modello entra in una GPU o in un nodo | Funzione Modal standard |
| Breve picco di training multi-nodo sincronizzato | Modal Clusters, dopo un test di piccole dimensioni |
| Utilizzo completo, prevedibile e di lunga durata | Confronta capacità GPU dedicata o riservata |
| Ricerca o database accanto all’inferenza GPU | Mantieni separato il servizio dati, salvo che le misurazioni giustifichino la colocazione |
| Requisiti stringenti di rete privata o self-hosting | Valuta un modello di deployment diverso |
Modal Clusters semplifica l’avvio dell’orchestrazione GPU multi-nodo, ma non la rende automaticamente più economica. Il provisioning serverless e l’ergonomia Python possono far risparmiare tempo di sviluppo, mentre utilizzo continuativo, vincoli regionali e retry dell’intero cluster possono incidere pesantemente sulla fattura. Calcola prima il numero complessivo di nodi; solo dopo confronta il sovrapprezzo della comodità con la capacità dedicata.