 AIREITER
Un utente di Claude Code ha ricalcolato a listino API un mese di utilizzo del piano Max: il risultato è stato $7.470, contro una fattura da $200. Il problema non è una tariffa per token fuori scala. È che l'accesso a consumo elimina il tetto che l'abbonamento imponeva senza renderlo troppo evidente, mentre i flussi di lavoro basati su agenti reinviano molti più token di quanti ne digiti normalmente in una chat.
Quanto è grande il divario secondo gli sviluppatori
I rapporti condivisi dagli utenti mostrano proporzioni elevate e abbastanza costanti. Un thread su r/ClaudeAI che ricostruisce i log delle sessioni di Claude Code ha stimato per un mese di utilizzo Max circa $7.470 a prezzo di listino API, contro un abbonamento da $200. In un altro thread dedicato al confronto tra abbonamento e API, un utente con un piano da $200 ha valutato lo stesso carico tra $5.000 e $20.000 al mese.
Sono stime degli utenti, non dati sottoposti a verifica. In entrambi i casi, però, il modello di consumo che pesa di più è lo stesso: un agente che passa ripetutamente al setaccio un repository.
"Sono sul piano API enterprise per la mia azienda tramite Claude Code e posso dirti per esperienza diretta che, su progetti più grandi, è facilissimo spendere $100–$200 a sessione di costi API anche programmando normalmente." — u/andywidjaja, r/ClaudeAI
Un piano a pagamento e una chiave API sono due prodotti diversi
Anthropic lo dice senza giri di parole. Il suo articolo del centro assistenza, aggiornato il 16 marzo 2026, definisce i piani Claude e Claude Console "prodotti separati, progettati per scopi diversi" e specifica che un abbonamento a pagamento "non include l'accesso alle API Claude o alla Console". Anche OpenAI mantiene la stessa separazione, gestendo la fatturazione di ChatGPT e della piattaforma API attraverso sistemi distinti.
Il modo più utile per capire la differenza è guardare cosa viene venduto:
| Piano chat a pagamento | Chiave API | |
|---|---|---|
| Unità venduta | Un posto per un utente umano | Volume di token elaborati |
| Tetto | Finestra mobile di 5 ore più limiti settimanali | Nessuna quota inclusa; restano validi i limiti di velocità e di spesa |
| Accesso | App web, desktop e mobile | Il tuo codice |
| Struttura del prezzo | Fisso mensile | Variabile, per token |
| Alimentare un prodotto proprio | Non è ciò per cui viene venduto | È esattamente lo scopo |
La pagina dei prezzi di Claude indica Pro a $20 al mese con fatturazione mensile oppure $17 al mese con fatturazione annuale ($200 in anticipo), mentre Max parte da $100 al mese e offre 5× o 20× l'utilizzo di Pro per ogni sessione di cinque ore. Anthropic non pubblica un numero di messaggi per questi livelli, perché il consumo varia in base alla lunghezza della conversazione, al modello e alle funzioni utilizzate. Il confronto mette quindi a fronte una quantità misurata e una non misurata.
Nella stessa pagina c'è un altro indizio: Claude Enterprise abbina un costo mensile di $20 per postazione a un utilizzo fatturato alle tariffe API. Per i clienti più intensivi, il consumo torna quindi a essere misurato a consumo.
Quanti token compra davvero un dollaro di abbonamento
Convertire il prezzo del piano in token rende concreto il divario. Queste sono le tariffe ufficiali per milione di token (MTok), ricavate dalla documentazione sui prezzi della piattaforma Claude e dalla pagina dei prezzi API di OpenAI, verificate il 1° ottobre 2026.
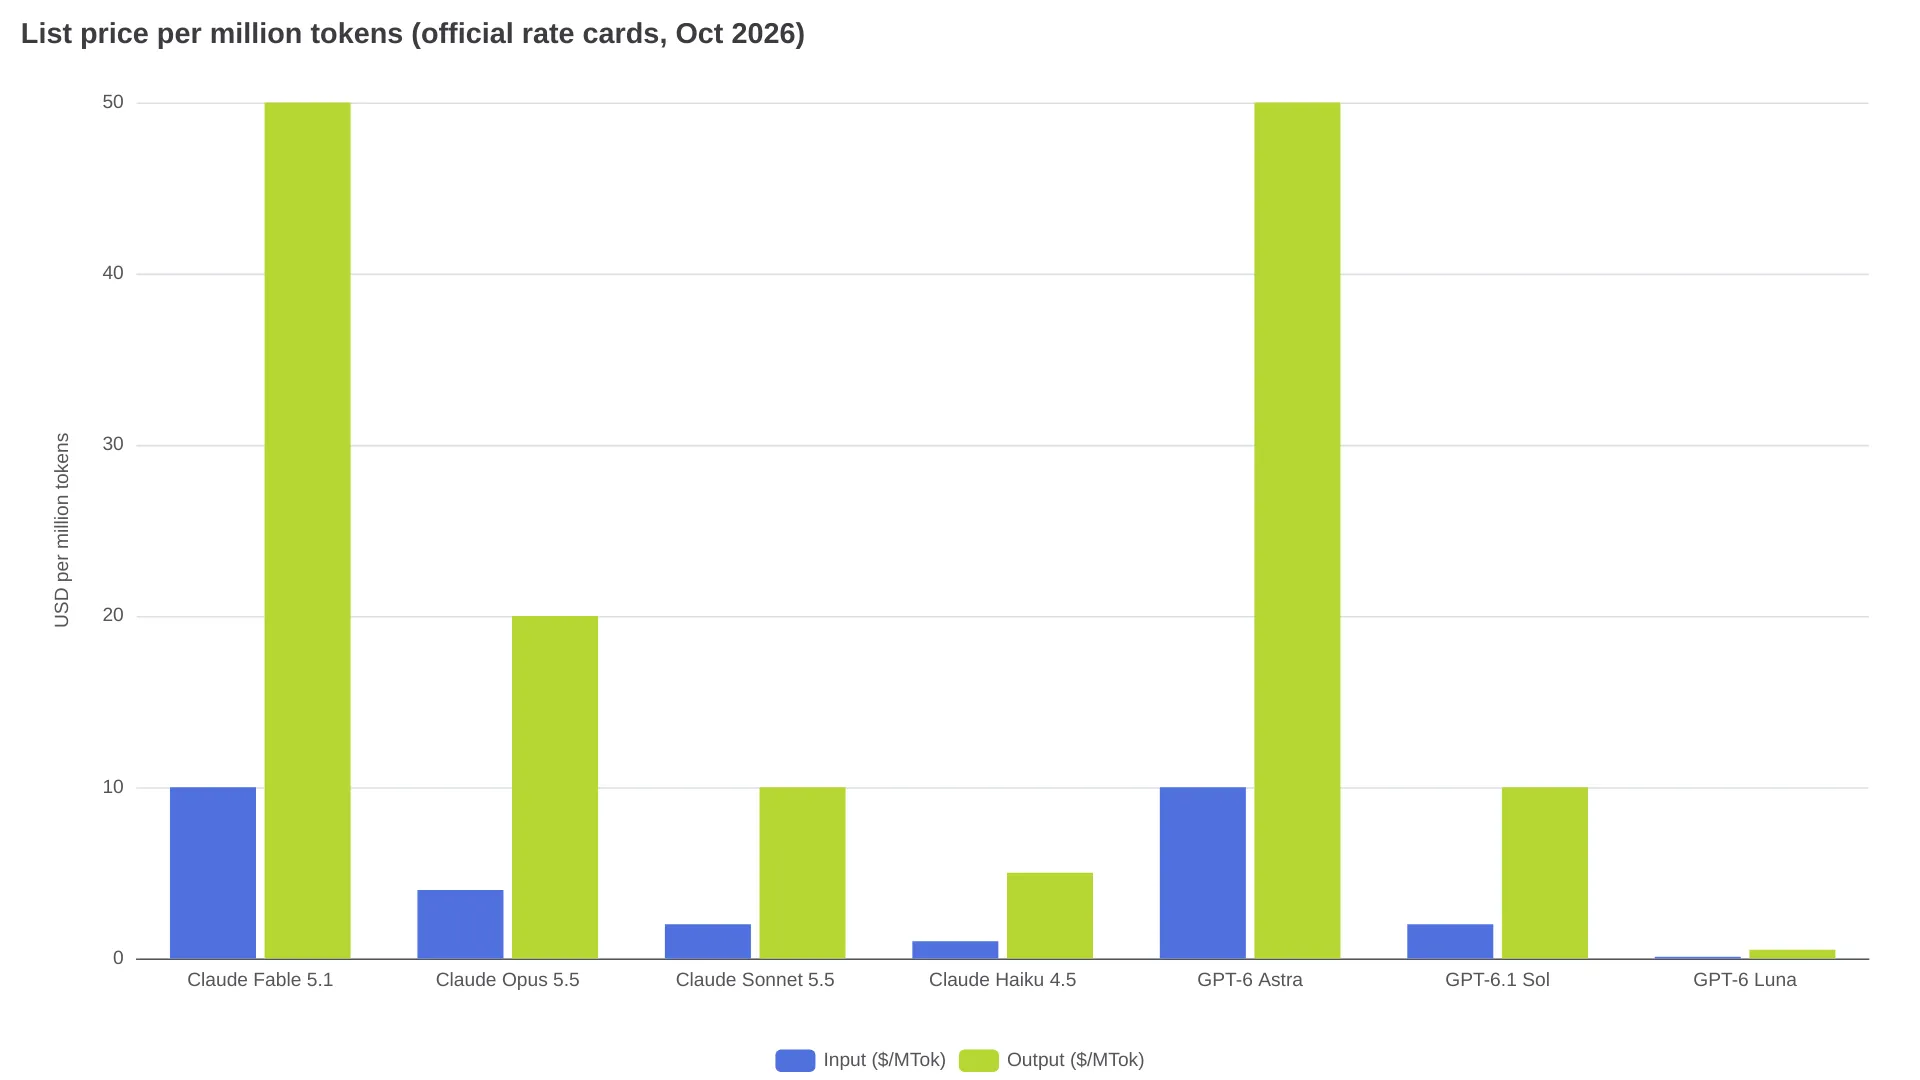
| Modello | Input | Output | Lettura cache | Batch (in/out) |
|---|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | $0.25 | $5 / $25 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $2 / $10 |
| Claude Sonnet 5.5 | $2 | $10 | $0.20 | $1 / $5 |
| Claude Haiku 4.5 | $1 | $5 | $0.10 | $0.50 / $2.50 |
| GPT-6 Astra | $10 | $50 | $1.00 | $5 / $25 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $1 / $5 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.05 / $0.25 |
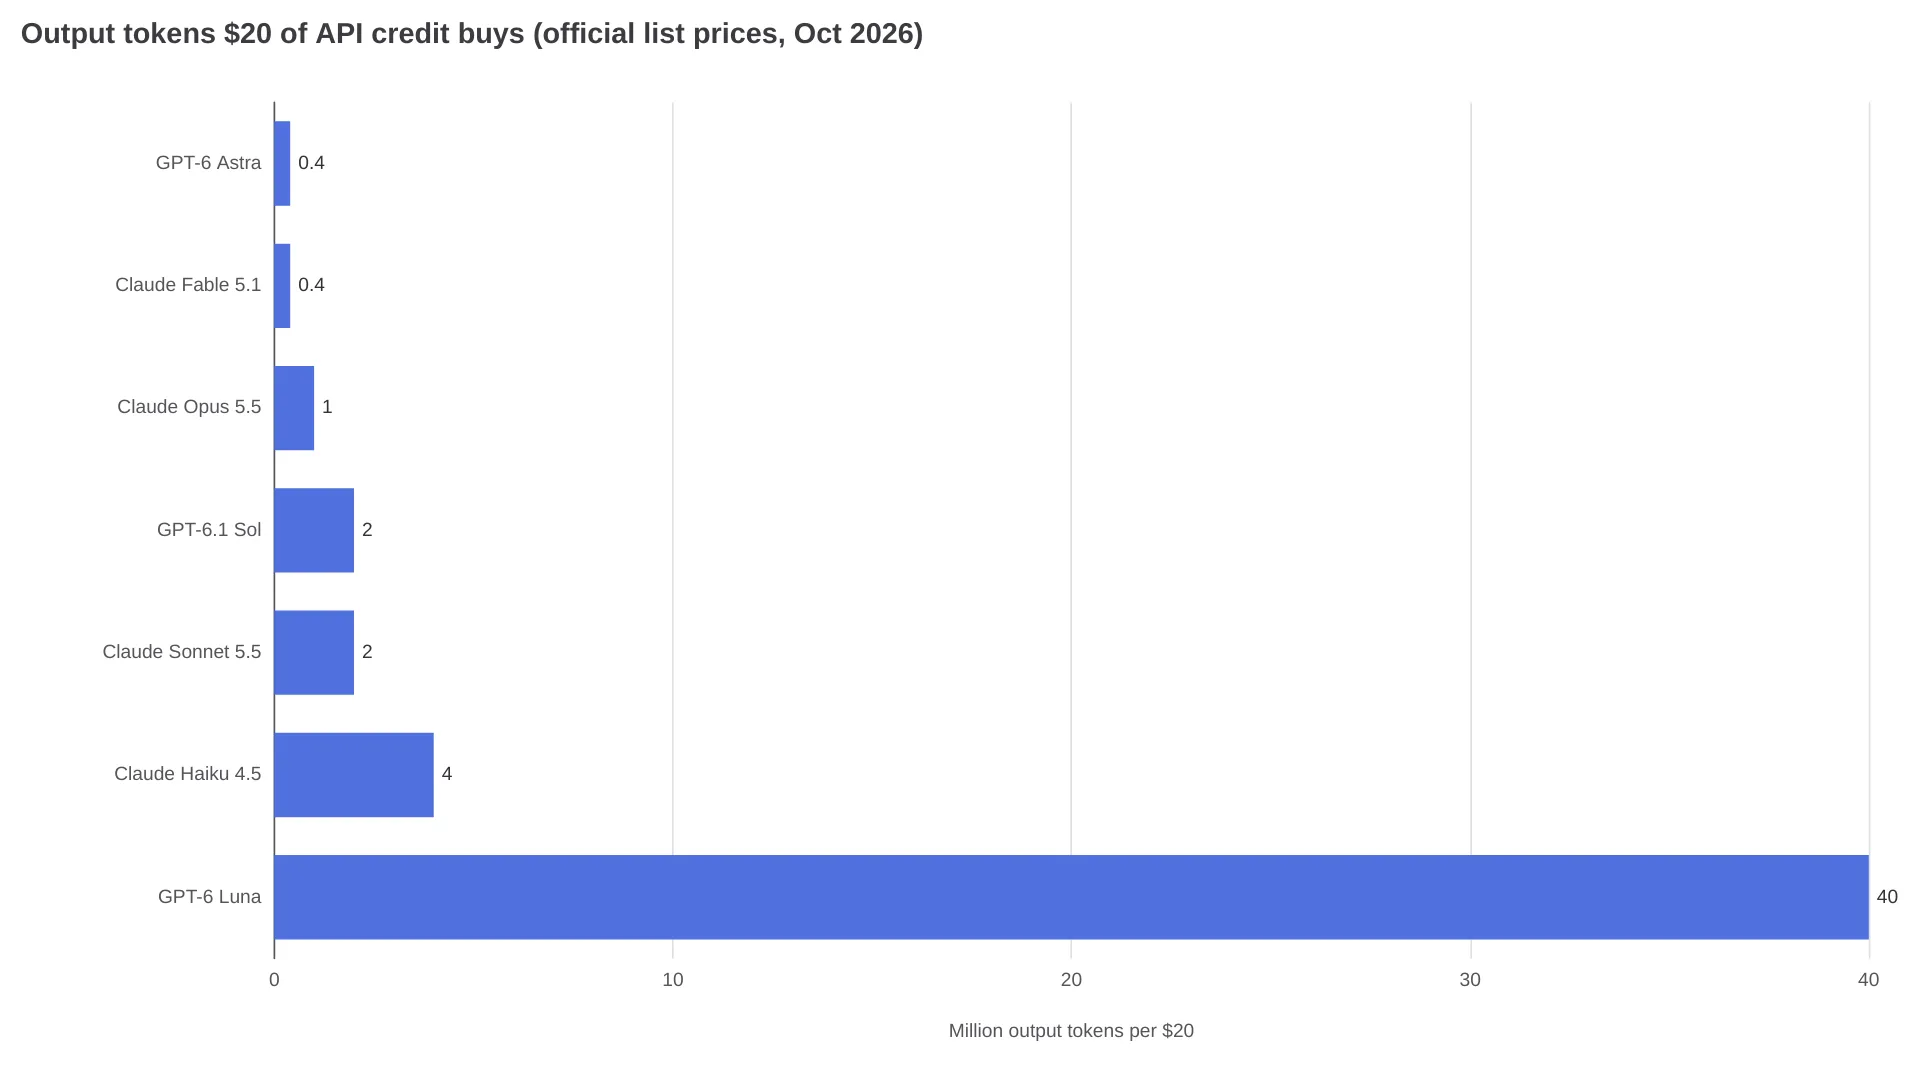
Per un carico simile a quello di una chat, con qualche migliaio di parole di contesto e qualche centinaio di parole in risposta, $20 di credito Sonnet 5.5 coprono circa 10 milioni di token in input oppure 2 milioni di token in output. Il tuo calcolo parte dai quattro campi presenti nella risposta API: (input nuovo × tariffa input) + (input in cache × tariffa lettura cache) + (scritture cache × tariffa scrittura) + (output × tariffa output), a cui si aggiungono i moltiplicatori per batch, contesti lunghi e regione. Registra questi quattro valori per ogni endpoint per una settimana e otterrai una stima mensile da confrontare con il costo di una postazione.
Dove finiscono davvero i token
Quattro fonti ricorrenti di spesa imprevista in token restano nascoste dietro il listino. Le ultime tre sono documentate nell'analisi di LLM Cost Lab sui costi fuori listino.
- La trascrizione, reinviata a ogni turno. Nelle integrazioni chat basate su richieste, il client reinvia la cronologia. Il ventesimo turno porta quindi con sé dall'uno al diciannovesimo. Se ogni turno aggiunge una quantità simile di contesto, il volume in input cresce grosso modo con il quadrato della lunghezza della conversazione. Ecco perché quell'analisi calcola una sessione da 20 turni a $0.163, contro $0.063 ipotizzati per chiamate indipendenti: una differenza di 2,6×.
- Il prompt di sistema, moltiplicato per ogni chiamata. Un prompt di sistema da 2.000 token ripetuto in 1 milione di richieste genera 2 miliardi di token in input prima ancora che l'utente scriva qualcosa.
- I token di ragionamento che non vedi. Nei modelli che fatturano come output le tracce di ragionamento nascoste, questi token possono essere diverse volte più numerosi della risposta visibile. Misurare solo i caratteri restituiti porta quindi a sottostimare la fattura.
- Risultati degli strumenti, retry e generazioni scartate. Se il modello li ha generati, li paghi: anche la risposta rifiutata dal validatore JSON e la chiamata parallela lanciata per prima e poi scartata.
Anche i token economici possono dominare una fattura, ed è questo che spesso disorienta chi guarda il proprio pannello dei consumi. Nel thread da $7.470, un commentatore ha notato che le letture dalla cache costituivano il 48% del totale, pur essendo il tipo di token meno costoso del listino.
"è già il tipo di token più economico delle API, quindi se domina comunque il totale dopo aver applicato i prezzi di listino, significa che il carico consiste soprattutto nel rileggere il contesto a ogni turno" — u/YoanEdwin, r/ClaudeAI
Applichiamo le tariffe di Opus 5.5 a un turno di agente con 150k token di contesto del repository e 2k token di output: la struttura della spesa diventa evidente.
| Opus 5.5, sessione da 60 turni, 150k di contesto + 2k di output per turno | Costo |
|---|---|
| Input nuovo per turno, senza cache hit (150k @ $4) | $0.60 |
| Lettura dalla cache per turno al posto dell'input nuovo (150k @ $0.20) | $0.03 |
| Output per turno (2k @ $20) | $0.04 |
| Una scrittura cache di 1 ora per sessione (150k @ $8) | $1.20 |
| Totale sessione, senza cache | $38.40 |
| Totale sessione, con cache | $5.40 |
Due sessioni con cache al giorno per 22 giorni lavorativi fanno circa $238: più di un piano da $200. Senza cache, lo stesso mese supera $1.600. La tariffa non è cambiata; è cambiato il numero di token.
Non ci sono due livelli, ma tre
La maggior parte dei confronti si ferma a piano contro API. Esiste però un terzo livello, che gli utenti incontrano quando esauriscono la quota: i crediti per l'utilizzo aggiuntivo venduti all'interno del prodotto in abbonamento.
Le segnalazioni su r/codex collocano questo livello al di sopra dei prezzi API puri. Un utente Pro ha registrato circa 16 milioni di token consumati tramite crediti acquistati per circa $40, stimando poi lo stesso volume a circa $12 alle tariffe API di listino.
"sì, il prezzo dei crediti è quasi predatorio. $50 per una singola landing page è assurdo quando con le API costerebbe circa $2." — u/AbjectBug5885, r/codex
Sono stime degli utenti, non tariffe universali, e il prezzo delle ricariche varia in base al fornitore e al piano. Nei casi Codex citati sopra, il livello delle ricariche costava circa 3× la spesa API equivalente a listino: vale la pena confrontarlo con i propri numeri prima di acquistare crediti per la seconda settimana consecutiva.
Le cinque leve che cambiano il conto
Ogni leva ha una tariffa ufficiale, quindi i calcoli possono essere verificati direttamente sulle pagine dei fornitori.
- Prompt caching, includendo il sovrapprezzo di scrittura. La documentazione sui prezzi di Anthropic indica che una scrittura in cache di 5 minuti costa 1,25× l'input base, mentre una scrittura di 1 ora costa 2×. Le letture costano 0,1× la tariffa base (0,05× su Opus 5.5, 0,025× su Fable 5.1). Una scrittura da 5 minuti si ripaga dopo una lettura; quella da 1 ora dopo due. Se viene scritta una sola volta e poi mai letta, costa più del non usare affatto la cache. Conta anche l'ordine, non solo l'attivazione: prima i contenuti stabili, poi le variazioni dell'utente, altrimenti il prefisso non corrisponde più. Per il debug del tasso di hit, consulta questa guida al prompt caching.
- Usa il batch per tutto ciò che può aspettare. Entrambi i fornitori dimezzano il prezzo di listino per l'elaborazione asincrona: Opus 5.5 scende a $2/$10, Sonnet 5.5 a $1/$5. La copertura è però disomogenea: LLM Cost Lab conta 26 modelli su 83 monitorati che espongono un livello batch scontato. Verifica quindi che il tuo modello lo supporti prima di progettare il sistema su questa base. La parte operativa è spiegata nel nostro approfondimento sui prezzi delle batch API.
- Scegli il modello in base al compito. Classificazione, instradamento e decisioni di retrieval raramente richiedono un modello di punta. Haiku 4.5 a $1/$5 contro Fable 5.1 a $10/$50 significa una differenza di 10× per passaggi che producono dieci token.
- Limita l'output, non soltanto
max_tokens. L'output costa 5× l'input in quasi tutte le righe della tabella precedente. Uno schema che vieta il preambolo sostituisce un po' di overhead strutturale con la prosa che altrimenti pagheresti, mentremax_tokensfunziona meglio come limite di sicurezza che come strumento di formattazione: una risposta troncata potrebbe richiedere un secondo tentativo a pagamento. - Controlla i moltiplicatori aggiuntivi. Il livello long-context di OpenAI raddoppia le tariffe di input per i contesti brevi, mentre la modalità Fast raddoppia di nuovo il prezzo standard. Anthropic applica 1,1× per l'inferenza vincolata agli Stati Uniti e la sua documentazione sui prezzi specifica che Claude 4.7 e versioni successive usano un tokenizer più recente, che produce circa il 30% di token in più a parità di testo. Il prompt non è cambiato; è cambiato il contatore.
C'è poi un'opzione strutturale che resta fuori dall'elenco: instradare il traffico programmatico attraverso un unico endpoint a consumo, invece di mantenere un rapporto di fatturazione separato con ogni fornitore. È questo lo scopo dell'endpoint Claude API di AIReiter. Alle tariffe di listino, un mese di eccedenza con 40 milioni di token di input in classe Sonnet e 8 milioni di output costa $80 + $80: confrontarlo con una seconda postazione richiede circa un minuto.
Quale conviene acquistare
| La tua situazione | Acquista | Perché |
|---|---|---|
| Chat, ricerca e codice occasionale in un'app | Solo piano a pagamento | Spesa limitata, app incluse, utilizzo ben al di sotto dei limiti del piano |
| Programmazione agentica in solitaria, una macchina | Prima il piano, poi una chiave a consumo per l'eccedenza | Il piano assorbe la maggior parte del carico; la chiave elimina l'attesa del reset settimanale |
| Stai distribuendo un prodotto usato da altre persone | Solo API | Una postazione copre un essere umano; i tuoi utenti hanno bisogno del proprio volume di utilizzo |
| Job periodici in batch: valutazioni, backfill, classificazione | API con livello batch | 50% di sconto sul listino, la latenza è irrilevante |
| Acquisti già crediti aggiuntivi quasi ogni settimana | Confronta l'eccedenza con una chiave | Il prezzo dei crediti segnalato dagli utenti era superiore alle tariffe API di listino |
Domande frequenti
Un piano ChatGPT o Claude a pagamento include crediti API?
No. Il centro assistenza di Anthropic specifica chiaramente che un piano Claude a pagamento "non include l'accesso alle API Claude o alla Console"; OpenAI fattura ChatGPT e la piattaforma API attraverso sistemi separati. Pagare entrambi significa avere due voci distinte.
Pago anche i token di ragionamento che non vedo?
Sì, nei modelli che espongono il thinking o il ragionamento esteso. Questi token vengono fatturati alla tariffa di output senza comparire nel corpo della risposta, quindi controlla l'oggetto usage.
Pago l'intera conversazione a ogni turno?
Sì, a meno che una cache hit non copra il prefisso ripetuto. In assenza di una funzione di stato lato server, il client reinvia la cronologia che vuole rendere visibile al modello. Questa cronologia viene fatturata come nuovo input alla tariffa del modello, oppure alla tariffa di lettura dalla cache quando il prefisso corrisponde.
Una richiesta fallita o ripetuta genera comunque un costo?
Secondo l'analisi sulla fatturazione di LLM Cost Lab, una richiesta che raggiunge il modello e restituisce una risposta viene fatturata anche se l'applicazione scarta il risultato dopo un errore dello schema o un timeout del client. Fanno eccezione le richieste rifiutate prima della generazione.
Il compromesso che nessuno ha ancora risolto
I piani limitano la spesa, ma razionano l'accesso; le chiavi a consumo fanno l'opposto. Senza un valore in token pubblicato per la quota di un piano, per rispondere alla domanda "cosa costa meno per me?" serve una settimana di traffico reale, strumentato e calcolato sulla base della tabella qui sopra.
Approfondimenti correlati: L'API LLM più economica nel 2026 · Guida ai prezzi delle API Claude