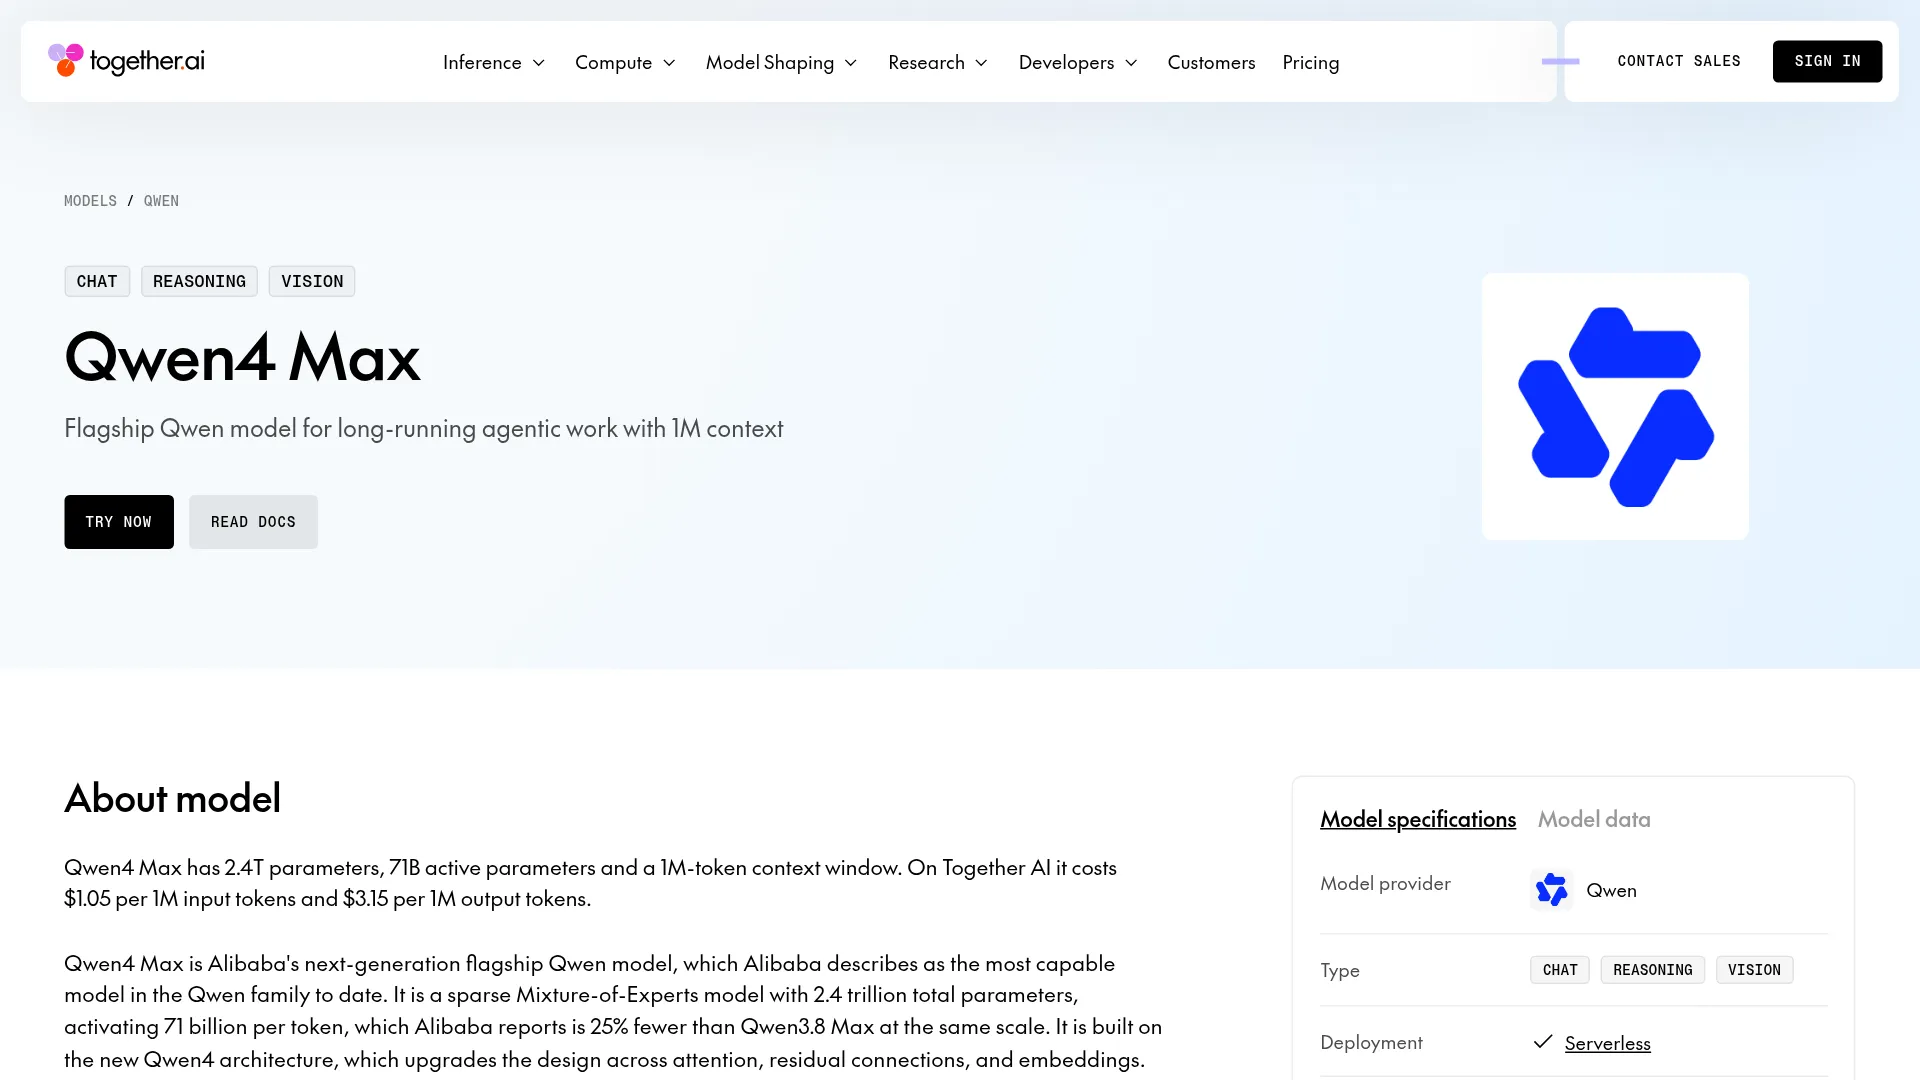
Together AI propone Qwen4 Max a $1.05 per 1M di token in input e $3.15 per 1M di token in output. La promozione indicata è valida fino al 22 novembre 2026: controllate la pagina aggiornata per il momento del passaggio, dopodiché il listino sarà di $1.50 e $4.50. Durante la promo Together AI è l'opzione più economica; in seguito, a parità di prezzo, saranno cache, latenza e routing a fare la differenza.
L'endpoint Qwen/Qwen4-Max, il contesto da 1M e i prezzi promozionali sono riportati nella pagina del modello di Together AI e nel post di lancio di Together AI del 21 novembre 2026.
Cosa si ottiene con $0.69: 344 file in una sola richiesta
Together AI ha inviato in un'unica richiesta tutti i 344 file di Tornado, per un totale di 652,519 token in input, insieme a una segnalazione di un bug WebSocket, senza retrieval né tool (post di lancio di Together AI). Qwen4 Max ha individuato il problema, proposto una patch e superato sia i nuovi test sia tutti i 1,673 test già presenti: primo token in 54 secondi, completamento in 72 secondi (post di lancio di Together AI).
L'esecuzione è costata circa $0.69 in promo o $0.98 a listino, quasi interamente per l'input. Memorizzando nella cache una porzione ripetuta di circa 630k token, il costo dell'input è sceso da circa $0.66 a $0.03 e il tempo al primo token da 54 a 8 secondi. La cache, però, è fornita con modalità best effort (post di lancio di Together AI).
"tested it via Alibaba's Token Plan, it performed better than DeepSeek 4.1Flash (on couple of coding tasks + remote instance work) but it took forever to finish." — u/FlounderRecent su r/Qwen_AI
Prezzi di Together AI, tutti in una tabella
Together AI pubblica la data di fine della promo, ma non indica né l'orario né il fuso (pagina del modello): meglio verificare prima di avviare un'elaborazione consistente. Il costo si calcola così: input / 1M x tariffa dell'input + output e reasoning / 1M x tariffa dell'output, applicando la tariffa dedicata ai token in cache per l'input memorizzato.
| Fascia di prezzo | Input / 1M | Input in cache / 1M | Output / 1M |
|---|---|---|---|
| Promo Together AI (fino al 22 novembre 2026) | $1.05 | $0.0525 | $3.15 |
| Listino Together AI | $1.50 | $0.075 | $4.50 |
L'input in cache costa il 5% dell'input normale. I token di ragionamento vengono conteggiati come output (post di lancio di Together AI).
| Carico di lavoro | Input | Output | Costo promo | Costo a listino |
|---|---|---|---|---|
| Sessione di coding agentico | 60,000 | 4,000 | $0.0756 | $0.108 |
| Richiesta sull'intero repository Tornado | 652,519 | ~2,000 stimati | ~$0.69 | ~$0.98 |
| Ripetizione con ~630k token di prompt in cache | ~630,000 in cache | ridotto | ~$0.03 per l'input | ~$0.047 per l'input |
Il valore dell'output nella riga dedicata a Tornado è approssimativo, perché il numero di token di reasoning fatturati varia in base al livello di effort.
Contesto da 1M su Together AI: il dato dichiarato non coincide sempre con l'input utilizzabile
Qwen4 Max pubblicizza 1M di token condivisi tra prompt, reasoning e output. Un'istantanea di un gateway indica circa 984k token di input utilizzabili (Sovyron); Vercel limita l'output a 384k, includendo il reasoning nel conteggio. Oltre i 900k token di input, lasciate un margine di circa 100k.
Tre dettagli di Together AI che possono far fallire la prima richiesta
1. Le richieste non-streaming restituiscono streaming_required. Together AI accetta solo lo streaming (post di lancio). Una richiesta non-streaming restituisce HTTP 400. La soluzione è usare "stream": true oppure stream=True.
2. Il thinking è attivo di default e viene fatturato come output. Nel flusso, delta.reasoning e delta.content sono separati (post di lancio). Per estrazioni semplici e meno costose, si può disattivare:
response = client.chat.completions.create(
    model="Qwen/Qwen4-Max",
    messages=messages,
    stream=True,
    reasoning={"enabled": False},
)
"reasoning_effort": "max" aumenta il livello di effort per i compiti più complessi (post di lancio).
3. Solo serverless, cache best effort e nessun segreto nel prompt. Non sono disponibili fine-tuning né endpoint dedicati (post di lancio). La cache è automatica, ma best effort. L'esempio elenca ogni file tracciato da git ls-files (post di lancio): prima di inviare un intero repository, eliminate quindi eventuali segreti.
Together vs QwenCloud vs OpenRouter: dove conviene chiamarlo
| Provider | Input / 1M | Output / 1M | Lettura cache / 1M | Note |
|---|---|---|---|---|
| Together AI promo | $1.05 | $3.15 | $0.0525 | Fino al 22 novembre; Qwen/Qwen4-Max, solo serverless e solo streaming |
| Together AI listino | $1.50 | $4.50 | $0.075 | Stesso endpoint dopo la promo |
| QwenCloud | $1.50 | $4.50 | $0.075 | Accesso diretto a Qwen alla tariffa indicata per Singapore |
| OpenRouter tramite Ailyre / CloudTweaks | $1.425 | $4.275 | ~$0.071 | Routing globale; istantanee del 20-22 novembre |
| Deep Infra / Novita AI tramite Sovyron | $1.413 | $4.24 | ~$0.071 | La tariffa non promozionale più bassa nell'istantanea Sovyron del 17 novembre |
| Vercel AI Gateway | $1.50 | $4.50 | $0.08 in lettura / $1.88 in scrittura | Istantanea riportata: latenza di 3.3s, 52 tok/s, cache hit del 93%; credito da $5 |
Finché dura la promo, Together AI è l'opzione più economica per i prompt ripetuti. Dopo la scadenza, le istantanee citate indicano Deep Infra o Novita AI tra le alternative non promozionali più convenienti, mentre OpenRouter e Vercel chiedono un piccolo sovrapprezzo in cambio di routing e strumenti aggiuntivi.
Avviare una richiesta in streaming su Together AI
curl -X POST "https://api.together.ai/v1/chat/completions" \
  -H "Authorization: Bearer $TOGETHER_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "Qwen/Qwen4-Max", "messages": [{"role": "user", "content": "Hi"}], "stream": true}'from together import Together
client = Together()
response = client.chat.completions.create(
model="Qwen/Qwen4-Max",
messages=[{"role": "user", "content": "Explain this diff in 3 bullets."}],
stream=True,
)
for chunk in response:
print(chunk.choices[0].delta.content or "", end="")Per lavorare sull'intero repository, inserite i file del progetto nel messaggio di sistema come voci === FILE: path === e aggiungete la segnalazione del bug nel messaggio dell'utente; poi fate lo streaming della patch (post di lancio).
Conviene usare Together AI per instradare Qwen4 Max?
| Carico di lavoro | Instradamento consigliato questa settimana | Perché |
|---|---|---|
| Analisi dell'intero repository (300-650k token in input) | Promo Together AI | Passaggio da circa $0.69, senza pipeline di retrieval |
| Cicli ripetuti sulla stessa codebase | Together AI (qualsiasi fascia) | Il costo della ripetizione è sceso da ~$0.66 a ~$0.03; TTFT da 54s a 8s |
| Tracce di reasoning con molto output | La tariffa verificata più bassa per l'output; disattivate il reasoning quando la qualità lo consente | Il thinking viene fatturato come output a $3.15-$4.50 |
| Carichi sensibili alla regione | Controllate la documentazione regionale di QwenCloud prima di scegliere il routing | Together AI non offre endpoint dedicati né fine-tuning |
| Failover e test in playground | OpenRouter / Vercel AI Gateway | Routing, retry e credito Vercel da $5 |
Nel test Tornado citato, il prompt a freddo da 650k token ha impiegato 54 secondi per restituire il primo token: è uno scenario più adatto al batch o all'analisi notturna che ai cicli interattivi in un IDE. La cache ha aiutato la richiesta ripetuta, non il primo passaggio: mettete quindi in conto il costo e i tempi dell'avvio a freddo.
FAQ
Qual è l'ID esatto del modello Together AI?
Qwen/Qwen4-Max su https://api.together.ai/v1/chat/completions.
Posso fare fine-tuning di Qwen4 Max su Together AI?
No: al momento della pubblicazione il modello è solo serverless, senza fine-tuning né endpoint dedicato (post di lancio).
Quando termina la promo di Together AI?
È valida fino al 22 novembre 2026, ma non è stato pubblicato alcun orario di scadenza; controllate la pagina del modello prima di avviare un'elaborazione consistente.
Together AI è più economico di QwenCloud Singapore?
Durante la promo sì ($1.05/$3.15 contro $1.50/$4.50); dopo la scadenza i prezzi coincidono e la scelta dipenderà da cache, latenza e routing.