I grafici dei servizi hosted promettono 280 token al secondo, ma sui primi laptop la velocità reale oscilla tra 8 e 220 tok/s, a seconda dell'hardware e del runtime. Inkling 2 Mini è un'opzione molto valida per gli agenti di coding offline: un modello open-weights da 26,4B che occupa circa 20 GB. Prima di scaricarlo, però, conviene conoscere i suoi limiti nella chat, nell'accuratezza fattuale e nell'accesso via API.
Per chi ha senso Inkling 2 Mini e chi dovrebbe lasciar perdere
Inkling 2 Mini dà il meglio in uno scenario preciso e rende meno in diversi altri: prima dei benchmark conta quindi il tipo di lavoro da svolgere. L'assistenza al coding offline con strumenti e ricerca è il suo terreno ideale; chat prolungate e utilizzo esclusivamente via API lo sono molto meno.
| Il tuo scenario | Verdetto su Mini |
|---|---|
| Agente di coding offline su un Mac da 32 GB o più, oppure su DGX Spark | Scelta azzeccata: i risultati migliori arrivano proprio qui |
| Lavoro privato con contesto lungo (fino a 1M di token nominali) | Vale la pena provarlo: nella pratica, parti da un contesto di 32K |
| Chat multi-turno o rispetto rigoroso delle istruzioni | Meglio lasciar perdere: qui Qwen3.8-27B misura risultati migliori |
| Utilizzo tramite API hosted oggi | Meglio lasciar perdere: non esiste ancora un listing serverless, solo tariffe per sampling e fine-tuning |
Il resto della recensione mette in fila i numeri dietro questa differenza: cosa cambia con il looping, quali benchmark resistono a un'analisi più attenta, quale velocità aspettarsi in locale e cosa si compra davvero con il prezzo indicato.
Che cos'è Inkling 2 Mini e come funziona il looping
Thinking Machines Lab ha pubblicato Inkling 2 Mini il 20 novembre 2026 come modello open-weights con licenza Apache 2.0. I pesi sono disponibili su Hugging Face con il nome thinkingmachines/Inkling-2-Mini. Il modello accetta input testuali e immagini, produce testo e dichiara un contesto massimo di 1 milione di token.
| Specifiche | Inkling 2 Mini |
|---|---|
| Uscita | 20 novembre 2026, Thinking Machines Lab |
| Licenza | Apache 2.0 |
| Parametri | 26,4B totali / 3,4B attivi per token / 5,4B effettivi con il looping |
| Layer | 24 memorizzati; i 12 centrali vengono eseguiti 3 volte per token (6 + 3x12 + 6 = 48 applicazioni) |
| Routing MoE | 8 esperti su 128 per token, per layer |
| Precisione | NVFP4 per 20 layer, MXFP8 per gli ultimi 4; checkpoint da circa 20 GB (19,5 GB + 0,64 GB per il predictor) |
| Contesto / modalità | Fino a 1M di token; input testuale e immagini, output testuale |
| Obiettivi per l'uso locale | Mac con almeno 32 GB di memoria tramite Ollama, oppure un NVIDIA DGX Spark secondo la scheda del modello |
Il valore di 3,4B indica i parametri attivi memorizzati; considerando i tre passaggi del loop, il calcolo effettivo arriva a circa 5,4B. Riutilizzare gli stessi pesi mantiene compatto il file, ma aumenta il lavoro necessario per ogni token, come spiega il tutorial tecnico di Hugging Face.
Il looping aggiunge calcolo, non conoscenza memorizzata. Nell'annuncio di lancio, il laboratorio presenta Mini come meno forte dei modelli Inkling più grandi nel recupero di informazioni fattuali, perché la conoscenza cresce soprattutto con il numero totale di parametri. Ecco perché ricerca e strumenti sono così importanti per questo modello.
I benchmark più solidi e quelli da prendere con le pinze
Tutti i punteggi riportati qui sotto arrivano dai test realizzati dal laboratorio con i propri harness, tramite la scheda del modello su Hugging Face: Mini prevale nel coding con strumenti e nella ricerca, mentre pareggia o resta indietro nel ragionamento, nella visione e nella disciplina conversazionale.
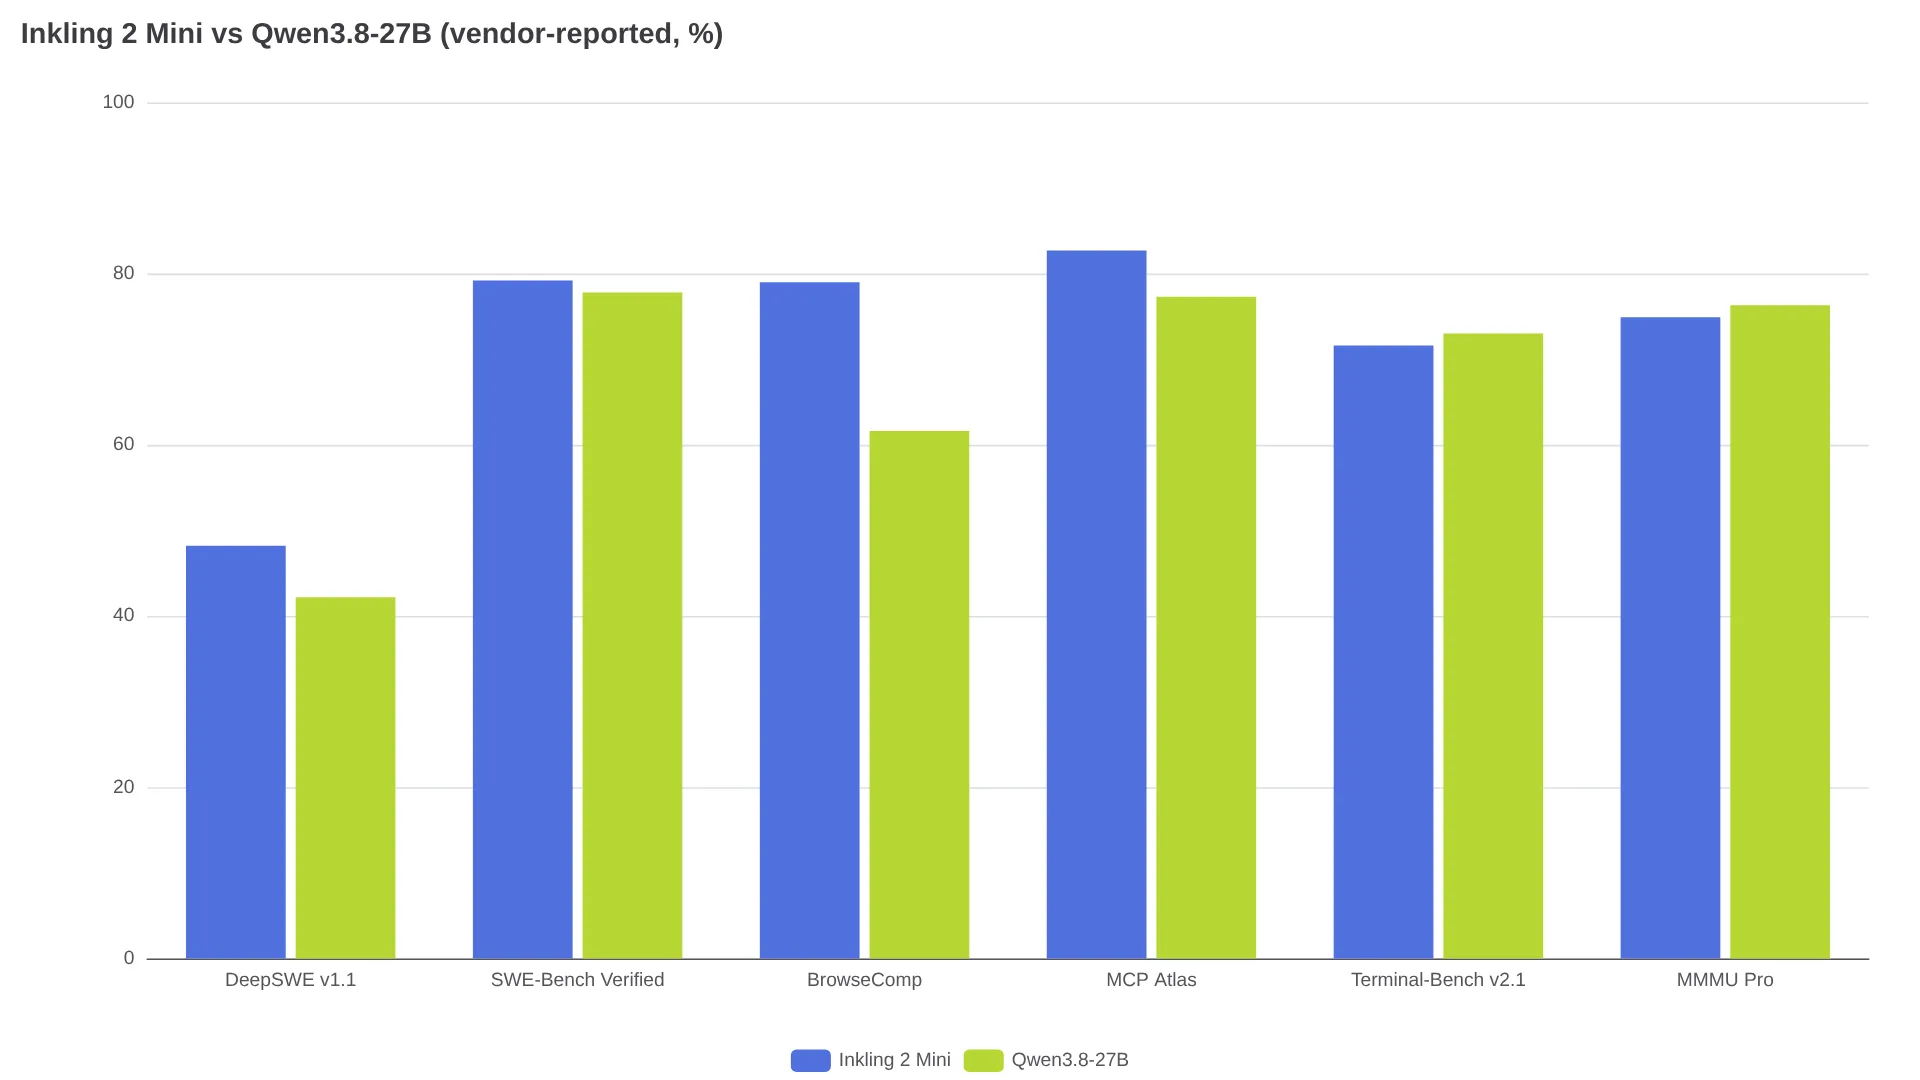
Mini è davanti a Qwen3.8-27B in DeepSWE v1.1, con il 48,2% contro il 42,2%; in SWE-Bench Verified, con il 79,2% contro il 77,8%; in BrowseComp, con il 79,0% contro il 61,6%; e in MCP Atlas, con l'82,7% contro il 77,3%. Artificial Analysis assegna a entrambi i modelli 20,1 nel proprio Intelligence Index, ma Mini completa il test in 9,0 minuti contro i 38,2 di Qwen. ARC Prize riporta l'84,5% su ARC-AGI-1 e il 49,3% su ARC-AGI-2 con il livello di ragionamento più alto.
L'altra faccia della medaglia, secondo la stessa scheda del modello, è il distacco nei test in cui Mini perde: HLE-Diamond 15,2% contro 15,3%, MMMU Pro 74,9% contro 76,3%, Terminal-Bench v2.1 71,6% contro 73,0%. Il divario sull'accuratezza fattuale è più ampio: nel punteggio AA-Omniscience di risposte non allucinate Mini arriva al 63,4%, contro il 71,4% di Qwen. Anche ComplexConstraints (33,4%) e MultiChallenge (50,0%) finiscono dietro Qwen.
In locale la velocità non è un numero unico
Il listing ufficiale di Ollama e la scheda del modello indicano un Mac con 32 GB o un DGX Spark, ma il supporto ancora acerbo ai modelli looped fa variare molto le prestazioni reali. La velocità in hosting, pari a 280 tok/s secondo Artificial Analysis, dice poco su quella ottenibile da un laptop.
| Configurazione | Velocità riportata | Fonte |
|---|---|---|
| Test hosted (Artificial Analysis) | 280 tok/s | Misurazione di terze parti |
| RTX 4090, vLLM patchato + FP8/NVFP4 + drafter | ~190-220 tok/s | Utente Reddit, solo dopo la patch (117 in baseline) |
| MacBook Pro M5 Max | ~125 tok/s | @alexocheema |
| MacBook Pro M1 Max da 64 GB, quantizzazione a 4 bit | ~20 tok/s | Utente di Hacker News gregsadetsky, citato nella recensione del lancio di eesel |
| Prime build di llama.cpp, hardware vario | ~5-10 tok/s | Discussione su r/LocalLLM |
"Non sono riuscito nemmeno a fargli superare i 5 t/s." — u/KURD_1_STAN, discussione di confronto su r/LocalLLM
Il supporto del runtime e la quantizzazione spiegano gran parte della forbice: le build più recenti gestiscono i layer looped meglio di quelle del primo giorno, mentre la scelta della quantizzazione modifica l'ingombro. La configurazione 4-bit consigliata occupa circa 17,6 GB, a cui aggiungere un vision projector da 639 MB, secondo la guida di Unsloth ripresa da Crewmark; i contesti lunghi fanno poi aumentare la pressione sulla KV cache.
In un test di abbinamento dei pagamenti con la stessa latenza, Qwen ha raggiunto un'accuratezza del 98,2% senza falsi abbinamenti, mentre Mini si è fermato al 96,9% con cinque falsi abbinamenti:
"Abbiamo testato Inkling 2 Mini contro Qwen3.8-27B sul nostro vero flusso di lavoro per l'abbinamento dei pagamenti... Qwen: 98,2% di accuratezza, 0 falsi abbinamenti... Inkling: 96,9%, 5 falsi abbinamenti... Per questo lavoro resta Qwen." — @exebat3 (post)
La lezione pratica è semplice: comincia da un contesto di 32K, riducilo se la memoria scarseggia e verifica che la build del runtime supporti i layer looped prima di trarre conclusioni sulla qualità.
Il prezzo, senza un pulsante per acquistarlo
Le tariffe di Tinker riportate nella pagina del modello su Artificial Analysis sono di 0,15 $ per milione di token in input, 0,015 $ per quelli in cache e 0,50 $ per l'output; il fine-tuning costa 0,75 $ (64K) e 1,50 $ (256K). Applicando queste cifre al consumo misurato, si arriva a 0,59 $ per ogni task dell'index, contro i 3,53 $ di Qwen3.8-27B.
Quei 0,59 $ sono una stima, non un prezzo hosted effettivamente acquistabile. Al momento della recensione Mini non compariva in alcun listing di inferenza serverless, come documenta il controllo di eesel su Tinker e OpenRouter. Inoltre, durante il test dell'index Mini ha generato 161M token in output, contro una mediana di 85,7M: la maggiore verbosità riduce parte del vantaggio sul costo per token. Per il self-hosting, conviene confrontare hardware, elettricità e costi di configurazione con una API hosted di Qwen o con un'API frontier.
Due impostazioni che determinano il risultato
Il livello di ragionamento va da nessuno (0.0) a minimal (0.1), low (0.2), medium (0.7), high (0.9, impostazione predefinita) e xhigh/max (0.99). Secondo la scheda del modello, il valore minimo non disattiva completamente il ragionamento.
Abbassare il livello può essere la scelta migliore: nella discussione su Terminal-Bench di r/LocalLLM, il test su un sottoinsieme di 13 task realizzato da un utente ha ottenuto 10/13 con un livello low, mentre il livello medium andava ripetutamente in timeout. Separatamente, un tester di Hacker News citato nella recensione di eesel ha consumato 19.200 token di ragionamento senza strumenti e non ha completato il lavoro; attivando la ricerca ha prodotto una soluzione con il nome sbagliato dell'hook.
Imposta un limite ai token di output e ai turni dell'agente, esegui l'accesso al file system in una sandbox e richiedi una revisione umana prima di usare il modello in produzione. La scheda del modello avverte del rischio di azioni distruttive senza conferma e di loop di ragionamento bloccati, soprattutto durante il debugging del codice.
Il compromesso da accettare prima del download
Mini ottiene più calcolo senza un checkpoint più grande riutilizzando i layer centrali, e il laboratorio distribuisce anche un checkpoint di ricerca a looping variabile per studiare questo comportamento (tutorial). I problemi segnalati sono concreti: loop durante il debugging, un passaggio al giapponese a metà risposta segnalato da un utente e chiamate agli strumenti che richiedono limiti precisi. Scaricalo per il coding offline, purché tu imposti le dovute protezioni; se ti serve una chat accurata o un'API pronta all'uso, è meglio aspettare.
Domande frequenti
Inkling 2 Mini può funzionare su un laptop?
Sì, con la build giusta: su un Mac Apple silicon con almeno 32 GB tramite Ollama o una versione recente di llama.cpp, idealmente in 4-bit (circa 17,6 GB più il projector). Aspettati circa 20 tok/s su un M1 Max più datato e oltre 100 tok/s su hardware M5; i runtime non patchati possono scendere a una manciata di token al secondo, come mostra la tabella precedente.
Inkling 2 Mini è migliore di Qwen3.8-27B?
Per gli agenti di coding sì, per la chat no. Il grafico sopra è chiaro: Mini è davanti in DeepSWE, SWE-Bench Verified, BrowseComp e MCP Atlas; Qwen prevale in Terminal-Bench v2.1, MMMU Pro, accuratezza fattuale e rispetto delle istruzioni con vincoli. Tutti i dati sono riportati dai produttori tramite la scheda del modello.
Perché le fonti parlano sia di 3,4B sia di 5,4B parametri attivi?
3,4B sono i parametri attivi memorizzati; 5,4B aggiunge i tre passaggi del loop, da circa 1,0B ciascuno. Usa 5,4B per stimare il calcolo e 3,4B per la memoria.
Posso usare Inkling 2 Mini tramite un'API hosted oggi?
No: al momento della recensione non esisteva un endpoint serverless first-party. Tinker pubblica le tariffe per sampling e fine-tuning, ma non un listing serverless per Mini, secondo il controllo di eesel. Puoi eseguire localmente i pesi di Hugging Face oppure aspettare che il modello venga aggiunto ai servizi hosted.
Come posso fermare i loop di ragionamento?
Prova innanzitutto il livello low (0.2), limita i token di output e i turni dell'agente e usa gli strumenti in una sandbox, come suggerisce la scheda del modello.
Per approfondire: recensione di Inkling 2 Small e prezzi API per il fratello da 594B a cui Mini risponde; Miglior LLM per gli agenti di coding nel 2026 per inserire Mini nel panorama delle opzioni per agenti; guida a llama.cpp v1.0 per il runtime da cui Mini dipende in locale.