Un agente può conoscere centinaia di strumenti senza portarsi dietro, a ogni richiesta, tutti i relativi schemi dei parametri. È la promessa di Tool Retrieval nella Gemini API: nomi e descrizioni restano disponibili, mentre gli schemi completi vengono caricati soltanto per i tool necessari al compito. C'è però un rovescio della medaglia: ogni ricerca richiede un ulteriore passaggio del modello. Se l'agente cerca tool a ogni turno, il conto può salire anziché scendere.
Google ha lanciato la funzionalità in preview il 19 novembre 2026, esclusivamente nella Interactions API. Introduce il tool tool_search e il flag defer_loading: true. I tool differiti mostrano nome e descrizione, ma tengono il JSON dei parametri fuori dal contesto. Non è previsto un costo dedicato: si applicano le normali tariffe per input, input in cache e output.
Perché 200 tool potevano pesare 164.000 token prima ancora della prima chiamata
A incidere sul costo del prompt non è solo il numero di tool, ma soprattutto la dimensione dei loro schemi. Con cataloghi estesi, gli schemi possono finire per dominare l'intero contesto.
Un'analisi tecnica indipendente della documentazione Google riporta un confronto indicativo: circa 164.000 token di input senza differimento contro circa 23.650 con Tool Retrieval per una libreria da 200 tool, quando per ogni richiesta ne vengono usati solo pochi. Sono valori arrotondati tratti da quell'analisi, non un benchmark: il punto è smettere di pagare per gli schemi che non verranno mai usati.
C'è poi la precisione nella scelta. Decine di schemi simili che competono nello stesso contesto moltiplicano le occasioni di selezionare il tool sbagliato. Google presenta Tool Retrieval come un aiuto sia per il carico di token sia per l'accuratezza della selezione. Non sono però stati pubblicati dati sull'accuratezza: va quindi considerata un'ipotesi da verificare sui propri task.
Come funziona Gemini Tool Retrieval: tool_search e defer_loading
La configurazione richiede due frammenti dichiarativi sintetici: un elemento tool_search pari a {"type": "tool_search"} e "defer_loading": true su ogni tool da differire. La struttura completa della richiesta è mostrata nell'analisi della documentazione. Il modello continua a vedere nome e descrizione di ogni tool differito. Secondo la guida a defer_loading, se è impostato short_description il modello vede quel testo; in caso contrario, vede la prima frase della descrizione completa.
Il flusso lato server avviene tutto in una sola richiesta:
- Il modello emette
tool_search_call, per esempio richiedendoissue_refund. - L'API restituisce
tool_search_resultcon lo schema completo. - Il modello emette la vera
function_call(nell'esempio di rimborso di Google compaionoorder_id: "A-1042"eamount: 40con il modellogemini-4-hydrogen). - Il codice dell'app esegue l'operazione e restituisce
function_result.
Registra tutto in interaction.steps. Se viene caricato il tool sbagliato, la prima cosa da controllare nella traccia sono nomi o descrizioni troppo vaghi.
Server o client: una richiesta oppure un round trip in più
| Modalità | Chi esegue la ricerca | Indice da creare | Round trip aggiuntivi | Quando usarla |
|---|---|---|---|---|
| Lato server (predefinita) | Gemini | Nessuno — "There's no index to build or host." | Nessuno, nella stessa richiesta | Librerie grandi e perlopiù statiche; interi server MCP |
Lato client ("execution": "client") | La tua app | Il tuo registro o indice di embedding | Uno per ogni ricerca | Permessi per utente, registri privati, tool aggiunti durante la conversazione |
Il recupero lato server non richiede un indice ospitato e si completa nella stessa risposta. Secondo l'analisi della documentazione, impostare defer_loading: true su un tool mcp_server differisce tutti i tool esposti da quel server.
La modalità client usa tool_search con "execution": "client" (nell'esempio il nome è search_tools, con una stringa query obbligatoria). L'app restituisce le corrispondenze in un function_result, quindi prosegue con client.interactions.create includendo previous_interaction_id. Sempre secondo l'analisi citata, è consentito un solo tool_search per richiesta e le due modalità non sono combinabili.
Scegli la modalità client quando l'autorizzazione dipende dall'utente o le integrazioni possono comparire nel corso della conversazione: una ricerca lato server su un catalogo condiviso non applica da sola il filtro dei permessi per utente, secondo l'analisi citata. La stessa analisi indica inoltre che la modalità client consente di far comparire tool a conversazione avviata senza dichiararli tutti in anticipo.
I conti di Gemini Tool Retrieval: 26 token subito, poi un altro passaggio completo
Come chiarisce l'annuncio di Google, Tool Retrieval non comporta un addebito separato: "Tool Retrieval has no separate charge." Restano quattro voci a consumo, secondo l'analisi sull'economia dei token:
tool_searchaggiunge un piccolo blocco fisso di token di input a ogni richiesta.- L'analisi citata stima circa 26 token per ogni riga con nome e descrizione di un tool differito.
- Ogni ricerca lato server avvia un altro passaggio del modello sul contesto corrente, fatturato tramite
total_tool_use_tokensper un volume vicino ai token di input del prompt, al netto dei cache hit, secondo l'analisi. - Ogni schema caricato continua a essere fatturato come input per il resto della conversazione e non può essere rimosso.
| Carico di lavoro (stime illustrative dall'analisi citata) | Senza retrieval | Con retrieval | Esito |
|---|---|---|---|
| 200 tool, pochi usati per task | ~164.000 token | ~23.650 token | Risparmio |
| 10 tool, contesto da 30k, ricerca quasi a ogni turno | ~68.000 token | ~92.830 token | Costa di più |
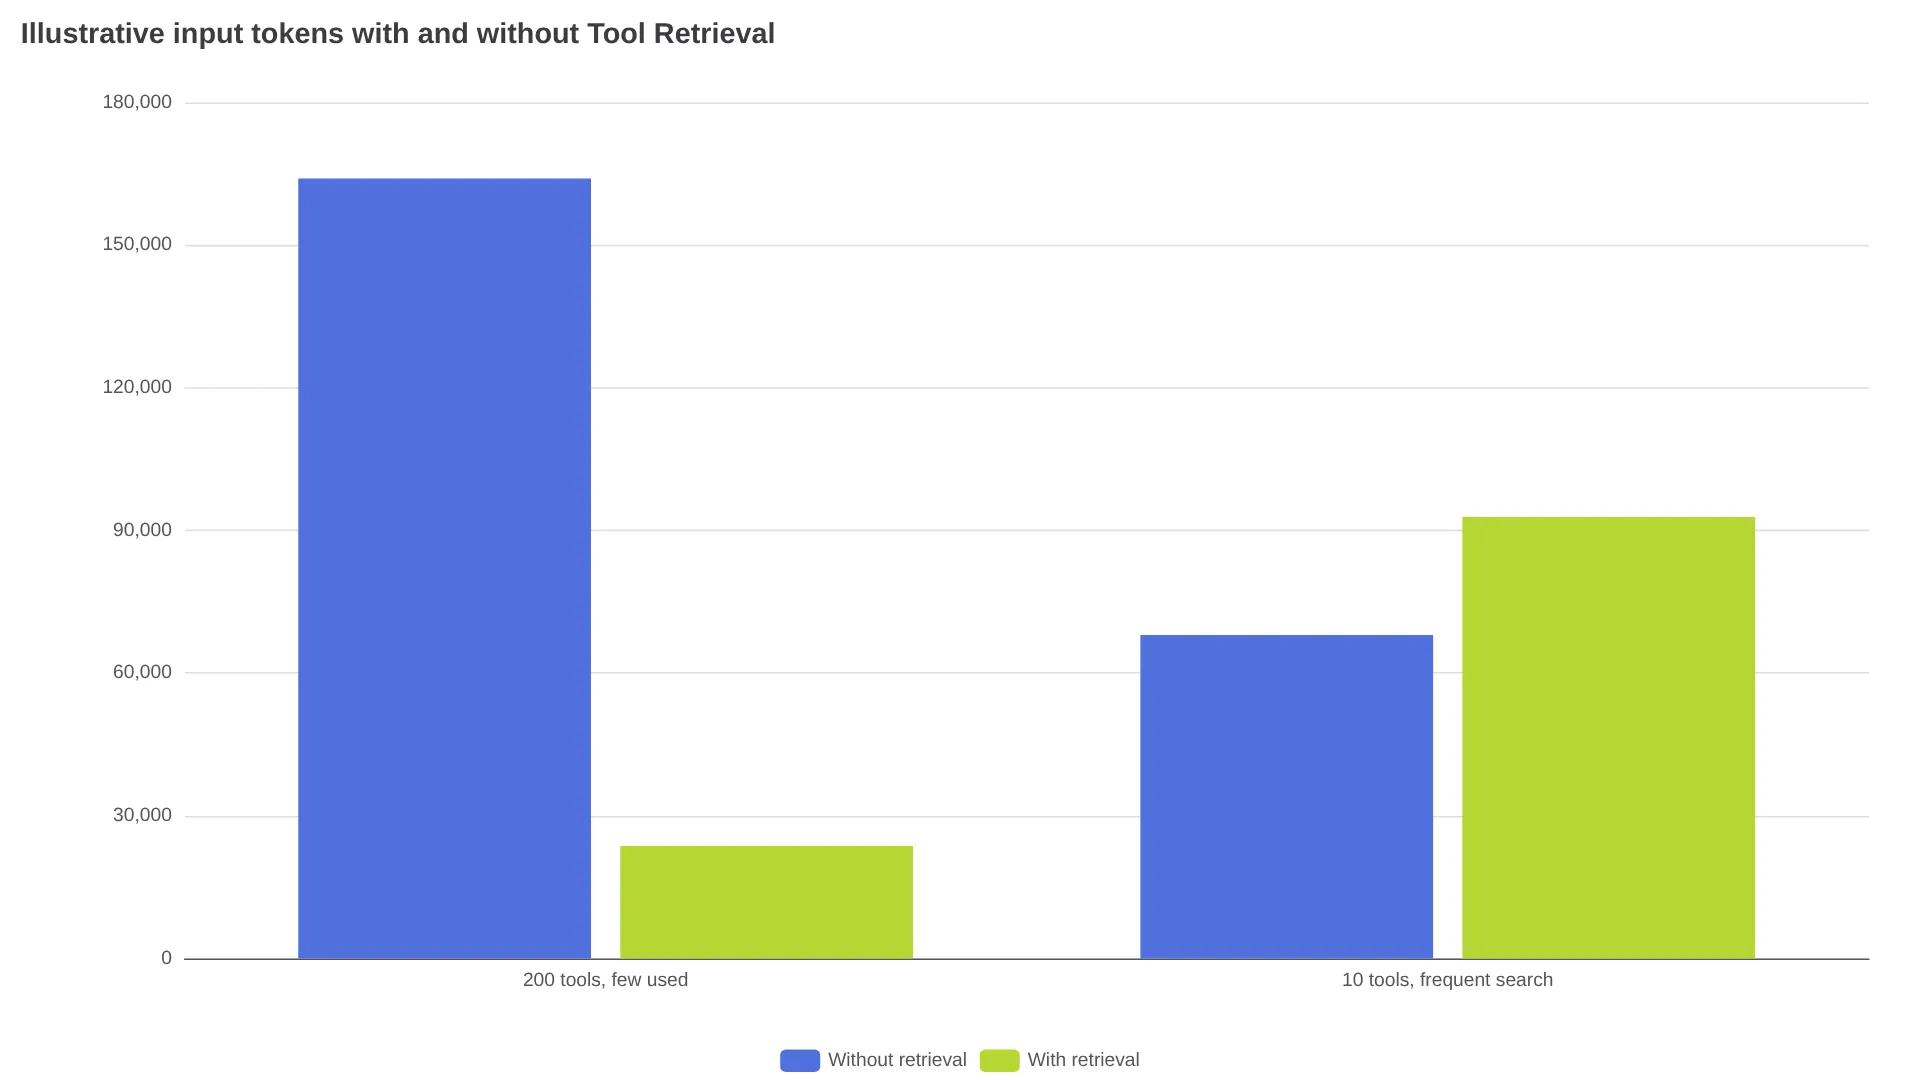
Il consiglio di Google, nello stesso annuncio, è netto: "Measure it against your own traffic."
"In modalità server... ogni ricerca lato server aggiunge un altro passaggio del modello sul contesto corrente... Perciò una grande libreria in cui ogni task usa pochi tool può trarne vantaggio. Una piccola libreria con una conversazione lunga e ricerche frequenti può invece costare di più." — @tekroch
Il differimento può rendere più stabile il prefisso in cache, ma può anche far scendere il prompt sotto la soglia minima per la cache. Secondo l'analisi citata, conviene quindi monitorare il tasso di cache hit insieme ai token di input.
Quando differire i tool e quando lasciarli già caricati
Con librerie piccole, conviene prima confrontare il caricamento statico: frequenza delle ricerche e dimensione degli schemi contano più di qualsiasi soglia basata sul numero di tool. Per cataloghi ampi in cui ogni task usa 1–3 tool, differisci lato server la coda lunga e mantieni non differiti i tool usati più spesso, cioè quelli presenti nella maggior parte delle richieste. Se i tool sono specifici per utente o compaiono a chat iniziata, usa la modalità client e considera un round trip per ogni ricerca.
Le note di implementazione citate elencano tre casi critici da gestire:
- Non differire un tool menzionato nelle istruzioni di sistema o nell'output di un altro tool: il modello potrebbe chiamarlo senza effettuare una ricerca e il turno successivo può fallire.
- Le funzioni differite devono comunque includere
parameterscompleti nella richiesta; limitarsi a nome e descrizione può restituire uno schema vuoto e non invocabile. - Nelle app stateless, ripeti a ogni turno senza modifiche
tool_search_call,tool_search_result, firme e l'intero arraytools.
La qualità della descrizione determina il recupero: prima di vedere lo schema, il modello sceglie tra nomi e descrizioni. "Search customer invoices by date range" è facilmente recuperabile; "Invoice helper" entra in collisione con altri tool. Il differimento non è un confine di sicurezza: nomi e descrizioni dei MCP differiti restano visibili come input del prompt, mentre i tool caricati operano con i permessi concessi, secondo l'analisi di sicurezza.
Cosa manca ancora nella preview
È una preview disponibile solo nella Interactions API, sulla superficie v1beta. Non supporta generateContent; secondo l'analisi della documentazione, usare defer_loading con un modello non supportato restituisce HTTP 400.
La copertura dei modelli è oggi più ristretta di quanto suggerisca l'annuncio: Google parla di Gemini 3.6 e versioni successive, inclusi tutti i modelli Gemini 4, mentre l'analisi citata riferisce che la documentazione live elenca attualmente gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash e gemini-3.6-flash. Prima di dare per scontato il supporto dei modelli affini, verifica la documentazione per quello che usi. Non è stata annunciata una data per la disponibilità generale. Anthropic ha introdotto la stessa idea di defer_loading in beta nel novembre 2025; le differenze di Google sono il differimento MCP lato server e la modalità client, secondo la copertura del lancio.
| Forma della libreria | Modalità da scegliere | Prima azione |
|---|---|---|
| Piccola e stabile | Caricamento statico | Misura i token degli schemi prima di aggiungere complessità |
| 50–200 tool, pochi usati per task | Differimento lato server | Differisci la coda lunga, mantieni caricati i tool più usati |
| Tool per utente o aggiunti a chat in corso | Retrieval lato client | Crea una ricerca che tenga conto dei permessi |
| Tutti i tool usati a ogni turno | Caricamento statico | L'overhead della ricerca probabilmente supera il risparmio |
Rilascia inizialmente una sola porzione della coda lunga, poi confronta token di input, total_tool_use_tokens, latenza e successo del task con e senza differimento, usando task identici.
FAQ
Tool Retrieval funziona con generateContent?
No. Solo Interactions API su v1beta.
Quali modelli lo supportano?
È stato annunciato per Gemini 3.6 e versioni successive, incluso Gemini 4; l'analisi citata riferisce però che la documentazione live lo restringe attualmente a modelli che includono gemini-4-hydrogen e gemini-3.6-flash. Verifica la documentazione per il modello esatto.
Può aumentare la mia spesa?
Sì. Nel carico di lavoro illustrativo citato con 10 tool, il consumo sale da ~68.000 a ~92.830 token quando le ricerche avvengono quasi a ogni turno.