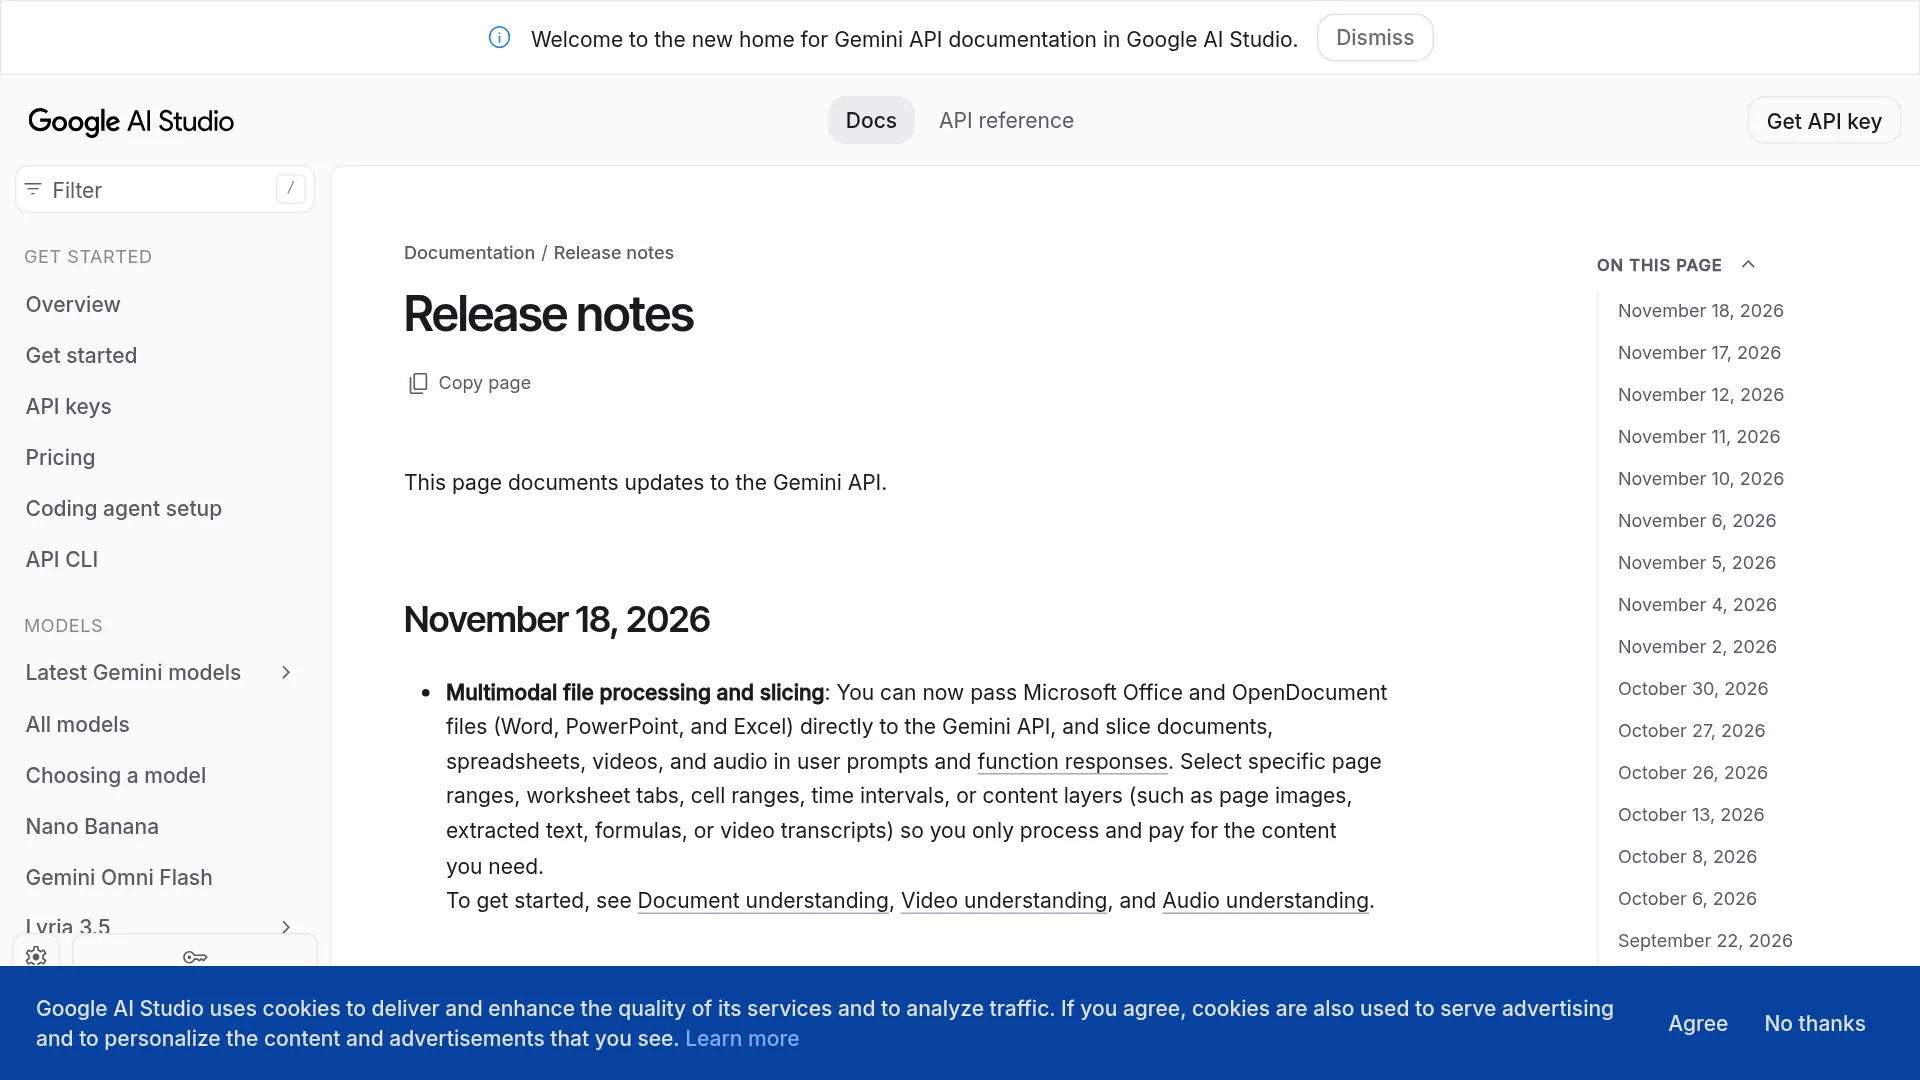
Se prima di chiamare le Gemini API convertivi ogni cartella di lavoro in CSV, puoi finalmente smettere. Dal 18 novembre 2026 le Gemini API accettano direttamente file Word, Excel e PowerPoint e, secondo la formulazione di Google, permettono di «elaborare e pagare solo» la sezione selezionata (changelog di Google AI Studio).
Il risparmio, però, richiede selettori espliciti: in caso contrario potrebbe essere ancora elaborato l'intero file, come osserva il lettore @zg0820.
Perché il vecchio approccio a Excel non funzionava
In precedenza, il comportamento documentato leggeva soltanto il primo foglio di lavoro come CSV. Per gestire il resto bisognava quindi riordinare i fogli oppure dividere la cartella di lavoro:
«La documentazione dice ancora che viene letto solo il primo foglio di un file XLSX, come CSV.» — @aitrackerbot
La voce del 18 novembre sostituisce questo workaround con l'input diretto per i formati Office e OpenDocument, aggiungendo la possibilità di selezionare porzioni del contenuto nei prompt e nelle risposte delle funzioni (analisi di DocsWatch).
Cosa cambia davvero con l'aggiornamento del 18 novembre
La nuova voce aggiunge due elementi all'espansione del 5 novembre, che aveva introdotto il supporto a PPT, ODP e ODS:
- Input diretto per Office e OpenDocument. I file Word, PowerPoint ed Excel possono essere inviati senza convertirli in PDF o testo.
- Selezione del contenuto. Puoi indicare intervalli di pagine, schede del foglio di lavoro, intervalli di celle A1, intervalli temporali o livelli specifici come immagini delle pagine, testo estratto, formule e trascrizioni.
La selezione funziona sia nei prompt sia nelle parti FunctionResponse: uno strumento può quindi restituire un singolo intervallo di un foglio invece dell'intera cartella di lavoro (riepilogo di AI Index).
Quali file puoi inviare e con quali modelli
La pagina di Firebase sui requisiti di input, aggiornata al 18 novembre 2026 UTC, collega il supporto ai file Office ai modelli Gemini 4.x (documentazione Firebase AI Logic):
| Famiglia | Estensioni | Tipo MIME |
|---|---|---|
| Word | .doc, .docx, .dotx | application/msword, application/vnd.openxmlformats-officedocument.wordprocessingml.document, application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt, .pptx | application/vnd.ms-powerpoint, application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls, .xlsx | application/vnd.ms-excel, application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt, .odp, .ods | application/vnd.oasis.opendocument.text, application/vnd.oasis.opendocument.presentation, application/vnd.oasis.opendocument.spreadsheet |
| Formati di base | .pdf, .txt | application/pdf, text/plain |
Limiti ufficiali, che la selezione non modifica:
- 50 MB per file, 1.000 pagine per file e 3.000 file di documenti per richiesta.
- 20 MB complessivi per richiesta con dati inline in base64; per file più grandi servono URL di Cloud Storage.
Nota non verificata della community, riportata separatamente: un lettore del changelog segnala un limite specifico per i file Office intorno a 2.000 pagine o diapositive (@lawson_ste3476). Google non lo ha documentato: non progettare i tuoi flussi facendo affidamento su questo dato.
Word e PowerPoint: intervalli di pagine e scelta del livello
DocumentMetadata è stato osservato nei documenti Discovery pubblici v1beta/v1alpha, ma non nella versione stabile v1 (analisi dello schema di ORIENS):
startPage: prima pagina, indice a partire da 1, inclusa.endPage: ultima pagina, indice a partire da 1, inclusa.contentLayers:PAGE_IMAGE(immagine renderizzata; secondo quanto riportato, è il valore predefinito quando i metadati sono presenti ma i livelli sono vuoti) oppurePAGE_TEXT(testo estratto).
Scegli PAGE_IMAGE per layout, diapositive e pagine scansionate; usa PAGE_TEXT per testo ricercabile, ad esempio nei contratti. Firebase descrive così il modello sottostante: i PDF vengono trattati come immagini, con una pagina che conta come un'immagine, mentre le immagini con entrambi i lati pari o inferiori a 384 px costano 258 token (documentazione Firebase AI Logic).
Excel: fogli, intervalli di celle e tre modalità di livello
SpreadsheetMetadata si associa alla parte del file fornita tramite inline_data o file_data, all'interno di un Part di input o di un FunctionResponsePart, secondo lo schema Discovery (analisi dello schema di ORIENS):
sheetIndex: ordine del foglio nella cartella di lavoro, a partire da 1. Il testo Discoveryv1betaindica tutti i fogli quando il campo viene omesso; il testo degli SDK Python e JavaScript indica invece il primo foglio. Impostalo sempre.visibleCells: intervallo A1, ad esempioA1:G35; se omesso, indica l'area occupata del foglio selezionato.contentLayers:DATA(valori, celle unite e formattazione),FORMULAS(espressioni e risultati calcolati),VISUAL(immagine renderizzata). Il valore predefinito riportato è[DATA, FORMULAS].
Per gli audit usa DATA insieme a FORMULAS; per il layout e il contesto delle celle unite aggiungi VISUAL; per una singola ricerca mantieni l'intervallo visibleCells il più ristretto possibile.
Invia solo la sezione utile: esempio Python con REST
I nomi dei campi corrispondono alla revisione Discovery 20261116; la struttura è in beta e non è presente nella versione stabile v1, quindi verifica tutto con l'SDK installato prima di usarla in produzione.
import os
from google import genai
import requests

client = genai.Client()  # reads GEMINI_API_KEY
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])
Per Word basta sostituire il contenuto con "documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]} e usare il tipo MIME di .docx. PowerPoint utilizza la stessa struttura documentMetadata, con il tipo MIME di .pptx e i numeri delle diapositive al posto delle pagine.
Il calcolo dei costi: quando la selezione conviene davvero
Nel changelog e nelle note sui prezzi di Firebase non esiste uno SKU separato per la selezione: il risparmio corrisponde ai token di input evitati, calcolati alle tariffe standard. Il changelog indica per gemini-4-hydrogen un costo di 1,50 $ per 1 milione di token di input.
Stima indicativa per un report di 200 pagine in cui interessano soltanto le pagine 12–18 (il valore di 800 token per pagina di testo è un'ipotesi per questo esempio, non una tariffa documentata):
- Prima: 200 pagine come immagini x almeno 258 token per immagine di pagina = 51.600 token di input. Costo: 51.600 / 1.000.000 x 1,50 $ = 0,0774 $.
- Dopo: 7 pagine come testo estratto x 800 token ipotizzati = 5.600 token di input. Costo: 5.600 / 1.000.000 x 1,50 $ = 0,0084 $.
- Risparmio: circa 89% sull'input di questa richiesta, prima di conteggiare i token di output. Sostituisci il dato con la densità di pagine misurata sui tuoi documenti.
Misura la dimensione degli intervalli sulla tua cartella di lavoro: tante chiamate piccole e selezionate possono costare più di un unico intervallo scelto bene (@zg0820).
Come renderlo affidabile: checklist per verifica e migrazione
Il fatto che un upload vada a buon fine non dimostra che il parsing sia riuscito. Verifica ogni pipeline:
- Dimostra che il parsing funziona. Chiedi di restituire il numero di righe, il nome del foglio o il numero di pagine e confrontalo con la fonte.
- Imposta ogni selettore.
sheetIndex,visibleCellsoppure l'intervallo di pagine, econtentLayers. - Abbina il livello alla domanda. Grafici e layout richiedono
VISUALoPAGE_IMAGE; gli audit richiedonoDATApiùFORMULAS; la ricerca richiedePAGE_TEXT. - Prova in staging i comportamenti fuori intervallo. Lo schema non specifica se una pagina o un intervallo non valido generi un errore, venga corretto automaticamente o restituisca nulla.
- Rispetta i limiti di upload. Un file da 60 MB continua a superare il limite di 50 MB. Per file oltre 20 MB inline usa URL di Cloud Storage.
- Migra in quest'ordine. Sostituisci gli splitter Excel con
sheetIndexpiùvisibleCells; i rasterizzatori di report con intervalli di pagine ePAGE_TEXT(riservandoPAGE_IMAGEal layout); le risposte degli strumenti che restituiscono file interi con risposte di funzione selezionate.
Gli aspetti che le fonti citate non chiariscono: la gestione di righe nascoste, celle unite, grafici, immagini incorporate e file protetti da password, con macro o danneggiati non è descritta nell'annuncio della selezione né nella pagina Firebase sui requisiti di input linkata sopra. Verificali sui tuoi modelli.
FAQ
Posso selezionare contenuti anche nelle risposte delle funzioni?
Sì. Gli strumenti possono restituire un URI del file insieme a SpreadsheetMetadata o DocumentMetadata, così il modello vede soltanto l'estratto richiesto: una soluzione adatta ai flussi basati su agenti e documenti.
Quale versione delle API supporta la selezione?
È stata osservata nelle revisioni Discovery v1beta e v1alpha 20261116, ma non nella versione stabile v1. Fissa le versioni e prova il comportamento sul modello destinato alla produzione.
Perché Gemini dice di non riuscire a vedere il file che ho caricato?
Controlla tipo MIME, dimensioni e selettori espliciti confrontandoli con la tabella e i limiti riportati sopra. Poi chiedi al modello di restituire i nomi dei fogli o il numero di pagine, così puoi confermare che il parsing sia riuscito.
Approfondimento: la guida alle Gemini 4 Carbon e Hydrogen API per scegliere il modello alla base di una pipeline Office.