Per chi paga a token, la scelta tra Gemini 4 Neon e Carbon dipende prima di tutto dal calendario. Fino al 30 novembre Carbon è più economico; dal 1° dicembre Neon costa il 25% in meno. Google ha lanciato Gemini 4 Neon il 18 novembre 2026 a $3 per 1M di token in input e $15 per 1M in output, con una finestra di 1M di token e senza piano gratuito.
Il cambio di prezzo del 30 novembre è ciò che conta davvero
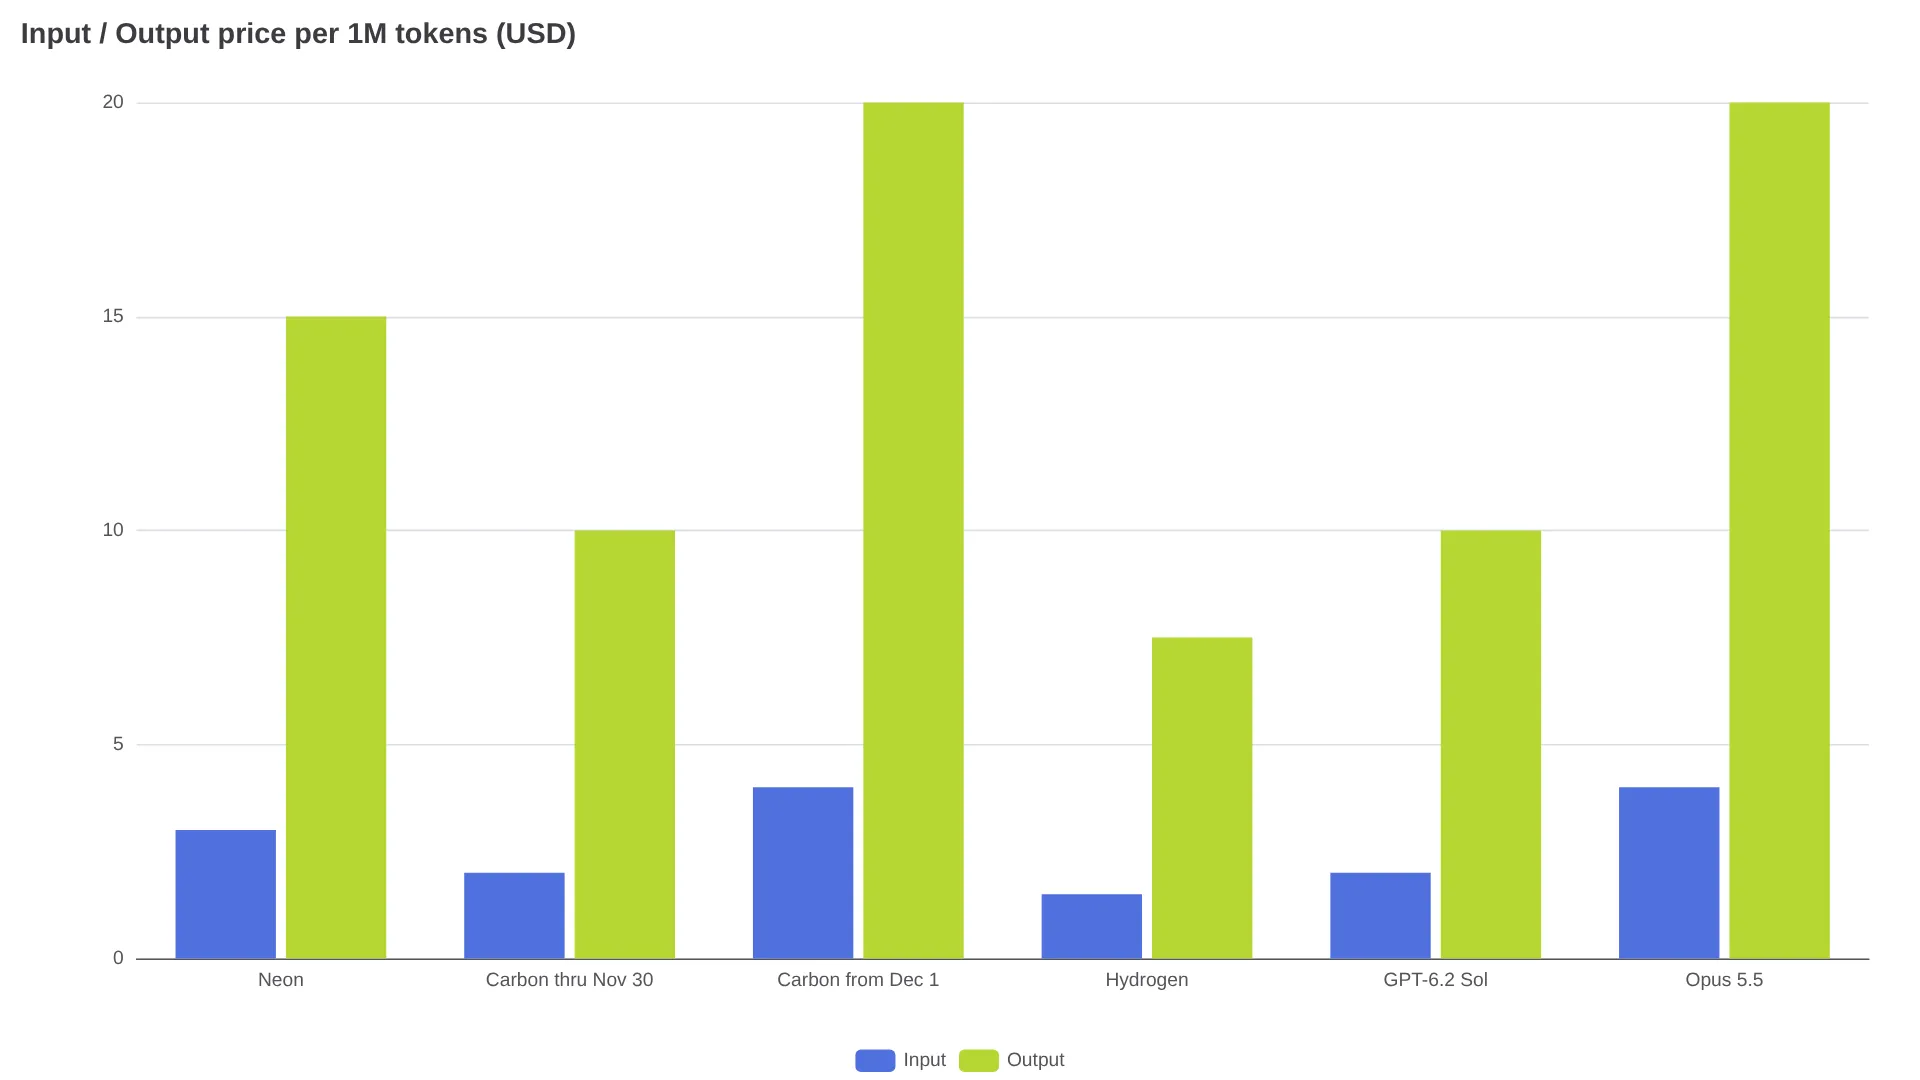
Per capire il prezzo dell'API Gemini 4 Neon bisogna guardare le date. Fino al 30 novembre 2026, Gemini 4 Carbon costa $2 in input e $10 in output per 1M di token grazie al prezzo di lancio; dal 1° dicembre Carbon e Argon passano a $4 / $20. A quel punto Neon, a $3 / $15, risulta esattamente il 25% più economico per token (confronto prezzi). Fino al 30 novembre, invece, Neon costa il 50% in più di Carbon alle tariffe promozionali.
Google propone il confronto in termini di costo per task: dichiara un costo per task inferiore del 32% rispetto a Carbon con reasoning high e un risparmio di almeno il 36% a xhigh contro concorrenti non identificati (analisi del lancio). Per il budget conviene usare le tariffe pubblicate di $3/$15: i dati sul costo per task sono dichiarati da Google e non indicano un riferimento nominato.
Dove si colloca Neon nella gamma Gemini 4
Gemini 4 Neon è la proposta intermedia: offre più profondità di reasoning rispetto a Hydrogen e, secondo il posizionamento del modello su OpenRouter, si avvicina alla qualità di Carbon con un'esecuzione più rapida. Carbon era la scelta frontier predefinita per il coding, Argon il modello flagship per il reasoning in ambito matematico e scientifico, mentre Hydrogen è il modello da alto volume a $1.50 / $7.50 (indice prezzi). Neon supporta quattro livelli di reasoning — low, medium, high e xhigh — e high è quello predefinito (specifiche del provider).
Al lancio, secondo l'annuncio di Google e l'approfondimento sul lancio, la disponibilità era questa:
| Piattaforma | Accesso a Neon |
|---|---|
| Gemini API | Sviluppatori a pagamento, model ID gemini-4-neon (scheda catalogo) |
| AI Studio / app Gemini / Antigravity | Piano a pagamento, Google AI Pro e Ultra |
L'etichetta Neon in Antigravity va interpretata con cautela. Gli utenti del thread su Antigravity segnalano che, in alcune sessioni, la voce dell'orchestratore potrebbe ancora risolversi in un system prompt Carbon; una risposta riassume così: "its just the orchestrator. not neon" (thread). Finché Google non pubblicherà una mappatura dei build ID, per la fatturazione va considerato il model ID dell'API, non l'etichetta dell'interfaccia.
Cosa si ottiene davvero con $3/$15
Le tariffe standard sono $3.00 per l'input, $15.00 per l'output e $0.15 per l'input in cache ogni 1M di token (annuncio ufficiale), senza scaglioni lungo l'intero contesto da 1,048,576 token (verifica prezzi). Gli indici di terze parti riportano Batch a $1.50 / $7.50, Flex a $1.50 / $7.50 e Priority a $5.40 / $27.00 (specifiche e tabella del provider), ma al lancio Google non aveva pubblicato Neon Batch/Flex/Priority sulla sua pagina generale dei prezzi. Fino a un aggiornamento di quella pagina, conviene quindi trattare Neon come disponibile solo in Standard (analisi del lancio).
Formula riutilizzabile: costo = input nuovo / 1M × $3 + input in cache / 1M × $0.15 + output, thinking incluso / 1M × $15.
Tre regole di fatturazione cambiano il prezzo di listino (analisi del lancio e riferimento prezzi):
- I token di thinking sono fatturati come output. L'output a $15 pesa più di ogni altra voce del conto.
- La cache è solo implicita: prompt di almeno 4,096 token e sconto del 95% sull'input in cache idoneo. Non esiste una cache esplicita
cachedContentsné un costo di scrittura della cache. - L'output sincrono è limitato a 65,536 token (specifiche). Per output più lunghi serve l'esecuzione in background.
I prompt brevi, sotto i 4,096 token, non beneficiano affatto della cache (riferimento prezzi). Un bot di assistenza con 1,200 token in input non può accedere alla tariffa di $0.15.
Quanto costano due carichi di lavoro simulati
Le simulazioni usano conteggi di token fissi ed escludono retry e lunghezza variabile del reasoning. Il punto centrale è il peso dell'output. Tutte le righe applicano gli stessi rapporti di cache alle rispettive tariffe di listino dei modelli nella tabella prezzi di lancio.
Sessione di coding: 50 chiamate, 80,000 token in input per chiamata, 90% dalla cache, 2,500 token in output per chiamata incluso il thinking. Totali: 400,000 token di input nuovo, 3.6M in cache, 125,000 in output.
| Modello | Costo della sessione |
|---|---|
| Gemini 4 Neon $3/$15 | $3.62 ($1.20 nuovo + $0.54 in cache + $1.88 output = $3.615) |
| Carbon fino al 30 novembre $2/$10 | $2.41 |
| Carbon dal 1° dicembre $4/$20 | $4.82 |
| Hydrogen $1.50/$7.50 | $1.81 |
| GPT-6.2 Sol $2/$10 | $2.41 |
Supporto su larga scala: 10,000 conversazioni al giorno per 30 giorni, 6,000 token in input ciascuna con il 75% idoneo alla cache e 500 token in output ciascuna. Totali: 450M nuovi, 1.35B in cache, 150M in output.
| Modello | Costo mensile |
|---|---|
| Gemini 4 Neon $3/$15 | $3,802.50 (di cui $2,250 in output) |
| Carbon fino al 30 novembre $2/$10 | $2,535.00 |
| Carbon dal 1° dicembre $4/$20 | $5,070.00 |
| Hydrogen $1.50/$7.50 | $1,901.25 |
| GPT-6.2 Sol $2/$10 | $2,535.00 |
Neon costa 2x Hydrogen per token e il 50% in più di Sol a $2/$10. Per vincere sul costo per task deve quindi completare i task con meno token o meno retry. I benchmark citati (Intelligence Index 61 al terzo posto, Coding Agent Index al primo) sono dichiarati dal vendor e non dimostrano un costo reale per task inferiore (riepilogo benchmark).
Il prezzo dei token non coincide con la quota
Le percentuali mostrate nell'app non si traducono in dollari API. Un utente Pro riferisce che le sessioni Neon con contesto lungo consumano l'1-2% per messaggio:
Also tried switching existing conversations with long context to Neon and seeing 1-2% usage per message, looks like this one might actually be usable on the Pro plan! — u/biblecrumble (thread)
La quota dell'app dipende da finestre di cinque ore, livello di thinking e chiamate agli strumenti. La fatturazione API conta ogni token elaborato, thinking incluso, più il grounding Search separatamente per ogni query (analisi del lancio). Per il lavoro via API il budget va calcolato in dollari con le tabelle sopra; per l'abbonamento, invece, sulla base dei propri test high e xhigh.
Il passaggio richiede una riga, poi tre correzioni
Chi usa Carbon, Argon o Hydrogen può migrare cambiando il model ID in gemini-4-neon (analisi del lancio). Restano però tre aspetti che possono far fallire le chiamate (analisi del lancio):
- Impostare esplicitamente
thinking_level. Neon usa high come valore predefinito. - Rimuovere i campi
cached_content. La cache esplicita non è supportata. - Rimuovere
temperature,top_p,top_k. I valori fuori intervallo restituiscono HTTP 400, gli altri vengono ignorati.
Per output lunghi, inoltre, alzare max_output_tokens verso 65,536 oppure usare l'esecuzione in background.
Conviene passare subito o sfruttare Carbon fino in fondo?
| Scenario | Scelta |
|---|---|
| Rilascio prima del 30 novembre, serve il massimo reasoning | Restare su Carbon a $2/$10 e testare Neon in parallelo |
| Agenti in produzione a dicembre, contesto lungo | Neon a $3/$15 è il candidato al prezzo di listino: validare successo dei task e retry prima del passaggio |
| Chat semplice ad alto volume | Restare su Hydrogen a $1.50/$7.50, l'unica opzione con piano gratuito in questo gruppo (indice prezzi) |
| Prezzo di listino frontier più basso oggi | GPT-6.2 Sol a $2/$10, se lo stack consente OpenAI |
| Serve una traccia documentale per Batch | Attendere: Neon Batch non è pubblicato |
FAQ
Quanto costa l'API Gemini 4 Neon?
$3 in input, $15 in output e $0.15 per input in cache ogni 1M di token, secondo Google.
Quali sono i limiti di contesto e output?
1,048,576 token in input; 65,536 token in output sincrono.
Esiste un piano gratuito?
No. Neon è solo a pagamento; Hydrogen mantiene un piano gratuito.
Batch, Flex o Priority sono disponibili?
Google non li aveva pubblicati al lancio; gli elenchi di terze parti indicano $1.50/$7.50 per Batch/Flex e $5.40/$27 per Priority. Verificare prima di pianificare il budget.
Come funziona la cache?
Solo implicita, con minimo di 4,096 token e sconto del 95% sull'input in cache idoneo.
Qual è il model ID?
gemini-4-neon.
Neon, Hydrogen o Carbon: quale usare?
Hydrogen per volumi economici; Carbon fino al 30 novembre per i token frontier meno costosi; Neon dal 1° dicembre per reasoning avanzato al 25% in meno rispetto alla tariffa Carbon di $4/$20.
Quanto costa una richiesta con 2,000 token in input e 500 in output?
$0.0135 a listino, prima della cache. Il thinking viene fatturato come output.