Sulla carta, GPT-6.2 Astra costa quattro volte GPT-6.2 Sol: $8 contro $2 per un milione di token in input, $40 contro $10 in output. Ma il costo reale dipende dal lavoro. Nei dati FrontierCode riportati più sotto, Sol gestisce il coding ordinario a circa un quinto della spesa ($1.29 contro $5.97); Astra, invece, stacca Sol di circa 4–10 punti nei test specialistici più impegnativi, dove una singola esecuzione riuscita può evitare vari tentativi.
Prezzi OpenAI e disponibilità dei modelli
OpenAI propone Astra per i progetti più complessi e Sol per il lavoro quotidiano (annuncio di lancio). I consumi del piano e la spesa API sono due contatori distinti: l'uso di ChatGPT/Codex non paga le chiamate API, e le chiamate API non erodono le quote del piano. Entrambi i modelli hanno una finestra di contesto di 1,050,000 token, con fino a 922,000 token in input e 128,000 in output per richiesta; accettano testo e immagini in input e restituiscono testo. Gli ID modello sono gpt-6.2-astra e gpt-6.2-sol nelle API Responses e Chat Completions.
Prezzi API Standard, per milione di token:
| Modello | Input | Input in cache | Scrittura cache (30 min) | Output |
|---|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $10.00 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra (predecessore) | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol (predecessore) | $2.00 | $0.10 | $2.50 | $10.00 |
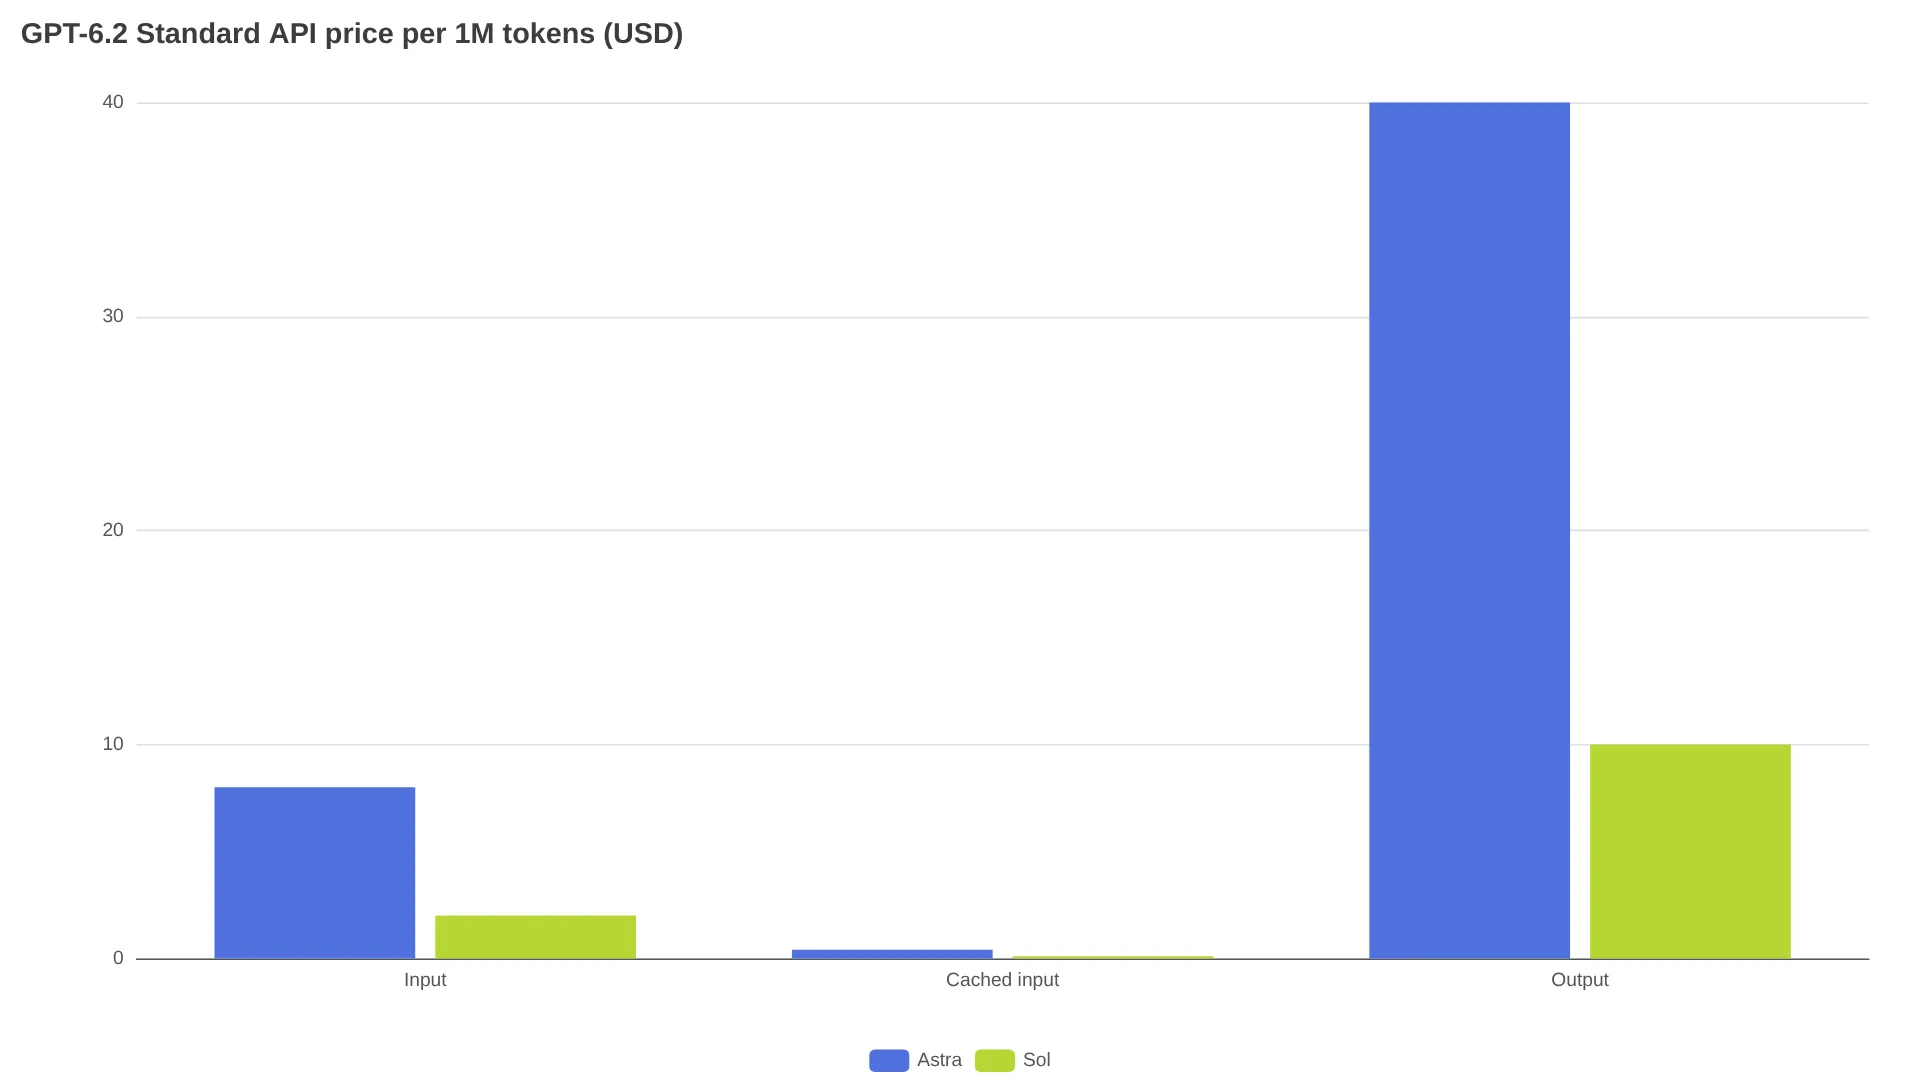
Astra costa il 20% in meno di GPT-6 Astra per input e output, e il 60% in meno per l'input in cache. Sol mantiene i prezzi di GPT-6.1 Sol. Al lancio, il 17 novembre 2026, entrambi sono generalmente disponibili via API; Batch costa il 50% in meno di Standard e le finestre background hanno uno sconto del 30–40% (riepilogo delle fasce di GenAI Brief).
Tre fattori che fanno salire il conto
1. Scrivere nella cache non è gratis. Le letture dalla cache costano il 5% dell'input ($0.40 per Astra, $0.10 per Sol). La scrittura nella cache costa 1.25x l'input per un TTL di 30 minuti ($10.00 per Astra, $2.50 per Sol) e 2.5x per la conservazione di 12 ore, secondo la tabella tariffaria di GenAI Brief. Esempio: riscrivere 108,000 token di cronologia dopo un cache miss costa 108,000 × $10/M = $1.08 su Astra oppure 108,000 × $2.50/M = $0.27 su Sol, prima dell'output.
2. Oltre 272,000 token cambia il prezzo dell'intera richiesta. Superati 272K token in input, l'input raddoppia ($8 a $16 per Astra, $2 a $4 per Sol) e l'output aumenta di 1.5x ($40 a $60 per Astra, $10 a $15 per Sol). Nel test tariffario di GenAI Brief, aggiungere 20K di cronologia e oltrepassare la soglia ha fatto salire un turno Astra da $0.344 a $0.624: +81% a fronte del 7% di input in più. Riassumi o tronca la cronologia prima di 272K; se così cambia il prefisso in cache, metti in conto un cache miss.
3. Le fasce di velocità moltiplicano tutti i costi. Fast costa 2x Standard. Ultrafast costa 3x fino al 28 febbraio 2027, poi 6x dal 1 marzo 2027 in avanti (solo residenza USA; Standard/Fast/Batch supportano USA e UE), secondo le regole delle fasce di GenAI Brief e la documentazione OpenAI sulle fasce di elaborazione. A 3x, l'output di Astra costa $120/M; a 6x arriva a $240/M.
Conta il costo per task, non quello per token
A parità di token, Astra costa 4x Sol. Può convenire soltanto se consuma meno token, richiede meno tentativi o evita costose correzioni umane. La regola del pareggio è semplice: a pari quantità di token, un tentativo Astra deve sostituire più di quattro tentativi Sol, oppure ridurre di circa il 75% i token pesati, per risultare più economico nella spesa API diretta.
Costi per task riportati da varie fonti (benchmark, impostazioni di effort e metodi di calcolo sono diversi: usali per cogliere la tendenza e verifica con i tuoi replay):
| Fonte / carico di lavoro | Astra | Sol | Cosa indica |
|---|---|---|---|
| Artificial Analysis Intelligence Index, effort massimo | 62 a $4.00/task, 10.4 min (GPT-6 Astra: 57 a $6.24) | 57 a $1.01/task, 7.9 min | Sol eguaglia il punteggio 57 di GPT-6 Astra a circa un sesto del costo per task di $6.24 |
| FrontierCode 2.0 tramite DataCamp, effort massimo | 44.2% a $5.97/task | 43.8% a $1.29/task | 0.4 punti di scarto a circa 5x il costo per task; in questi dati sul coding, Astra non supera la soglia |
| Harvey LAB-AA / SecureSWE / Terminal-Bench-Science tramite DataCamp | 15.0% / 65.7% / 77.1% | 11.1% / 55.6% / 68.0% | Qui il vantaggio di Astra è più ampio: vale la pena testarla per legale, codice sicuro e scienza |
| BenchCAD 2.1 Core tramite DataCamp | 82.5% | 73.1% | Il divario CAD di circa 9 punti giustifica un test di Astra per il lavoro CAD |
| Ricostruzione di slide di DataCamp, test a esecuzione singola | $0.22, 4,968 token in output | $0.07, dimensioni dei font esatte | Nessuna differenza visibile di qualità in questo task basato su template; Sol ha vinto sul costo |
| Agents' Last Exam secondo il riepilogo DataCamp dei numeri OpenAI, Sol High vs vecchio Astra Max | — | Sol High 72.0% a $0.69/task contro GPT-6 Astra Max 73.1% a $8.99 | Circa 1 punto in meno a circa 1/13 del costo in questa configurazione |
Esempio con i calcoli corretti: se un tentativo Sol costa $0.10 e ottiene 2 successi ogni 3, Sol costa $0.15 per risultato accettato; Astra, a $0.40 per tentativo, non può batterlo solo grazie al tasso di successo. Astra vince quando il tasso di successo di Sol crolla, per esempio 1 successo in 5 tentativi ($0.50 per risultato accettato) contro Astra che riesce al primo tentativo ($0.40). OpenAI riporta il 22% di token in output in meno per Astra su GDPval v2; considera le affermazioni del fornitore come indicative.
Parti da Sol per coding di routine e agenti ad alto volume; testa Astra per attività legali, CAD o lunghe esecuzioni scientifiche. Instrada verso Astra solo quando total spend / accepted tasks, incluse ripetizioni e correzioni, è inferiore.
Prefisso stabile: la chiave per non riscrivere tutto
Modificare a metà conversazione istruzioni, strumenti, schemi o output precedenti può invalidare la cache e attivare un nuovo ragionamento in GPT-6.2.
Per mantenere la cache del prefisso (note di integrazione di GenAI Brief, documentazione dei modelli OpenAI):
- Aggiungi un nuovo messaggio developer o
configuration_update, invece di riscrivere i messaggi iniziali. - Aggiungi strumenti con
additional_toolsoppure regolali contool_choice/allowed_tools, senza sostituire la lista degli strumenti a metà thread. - Riduci i vecchi output degli strumenti e le immagini prima del primo invio.
- Prima di spostare traffico in produzione, fai diagnosi con Prompt Cache Diagnostics e
input_transformationsdi Responses (prefix_mismatch).
Checklist di migrazione per Astra e Sol
Secondo la guida alla migrazione di EpiFive e le regole di integrazione di GenAI Brief, verificate rispetto al confronto tra modelli di OpenAI:
- Sostituisci
modelcongpt-6.2-astraoppuregpt-6.2-sol. - Inizia con
reasoning.effort: medium(Responses) oppurereasoning_effort: medium(Chat Completions).noneviene rifiutato; usalowper chiamate a bassa latenza. - Elimina
temperature,top_pelogprobs/top_logprobsdalle richieste. Sposta il tool calling nella Responses API. - Se esegui la migrazione da GPT-5.5 o precedente, sostituisci
prompt_cache_retentionconprompt_cache_options.ttl: "30m"e prevedi la spesa per la scrittura in cache. - Con Zero Data Retention,
storeviene trattato comefalse: reinvia in ordine gli elementi di output precedenti, inclusi gli elementi di reasoning crittografati. - Esegui il replay di 30 task brevi per modello (tasso di successo, tentativi, token in output, costo per risultato accettato), più una sessione lunga con agente e prefisso stabile rispetto a una modifica del prefisso (tasso di cache hit, costo totale del task).