Dal 19 novembre 2026 basta una chiave API per entrare in un mondo giocabile generato da Google. Il problema è che una demo di due minuti costa circa $12 e, dopo un minuto, il mondo comincia a perdere pezzi. La Genie 4 API è disponibile tramite Gemini Interactions API e Google AI Studio: vale la pena provarla per prototipi interattivi brevi, non ancora per giochi persistenti.
Genie 4 API: cosa è arrivato il 19 novembre
Google ha annunciato l'accesso per gli sviluppatori il 19 novembre 2026 attraverso la Interactions API di Gemini API (v1beta) e Google AI Studio, un giorno dopo l'accesso a Project Genie per gli abbonati AI Ultra, aperto il 18 novembre. L'identificativo del modello è models/genie-4, come indicato nella documentazione di AI Studio per Genie.
Per accedere serve una chiave Gemini API con piano a pagamento. Genie 4 non offre un livello gratuito e Google identifica questa superficie come v1beta: formato delle richieste e quote possono quindi cambiare.
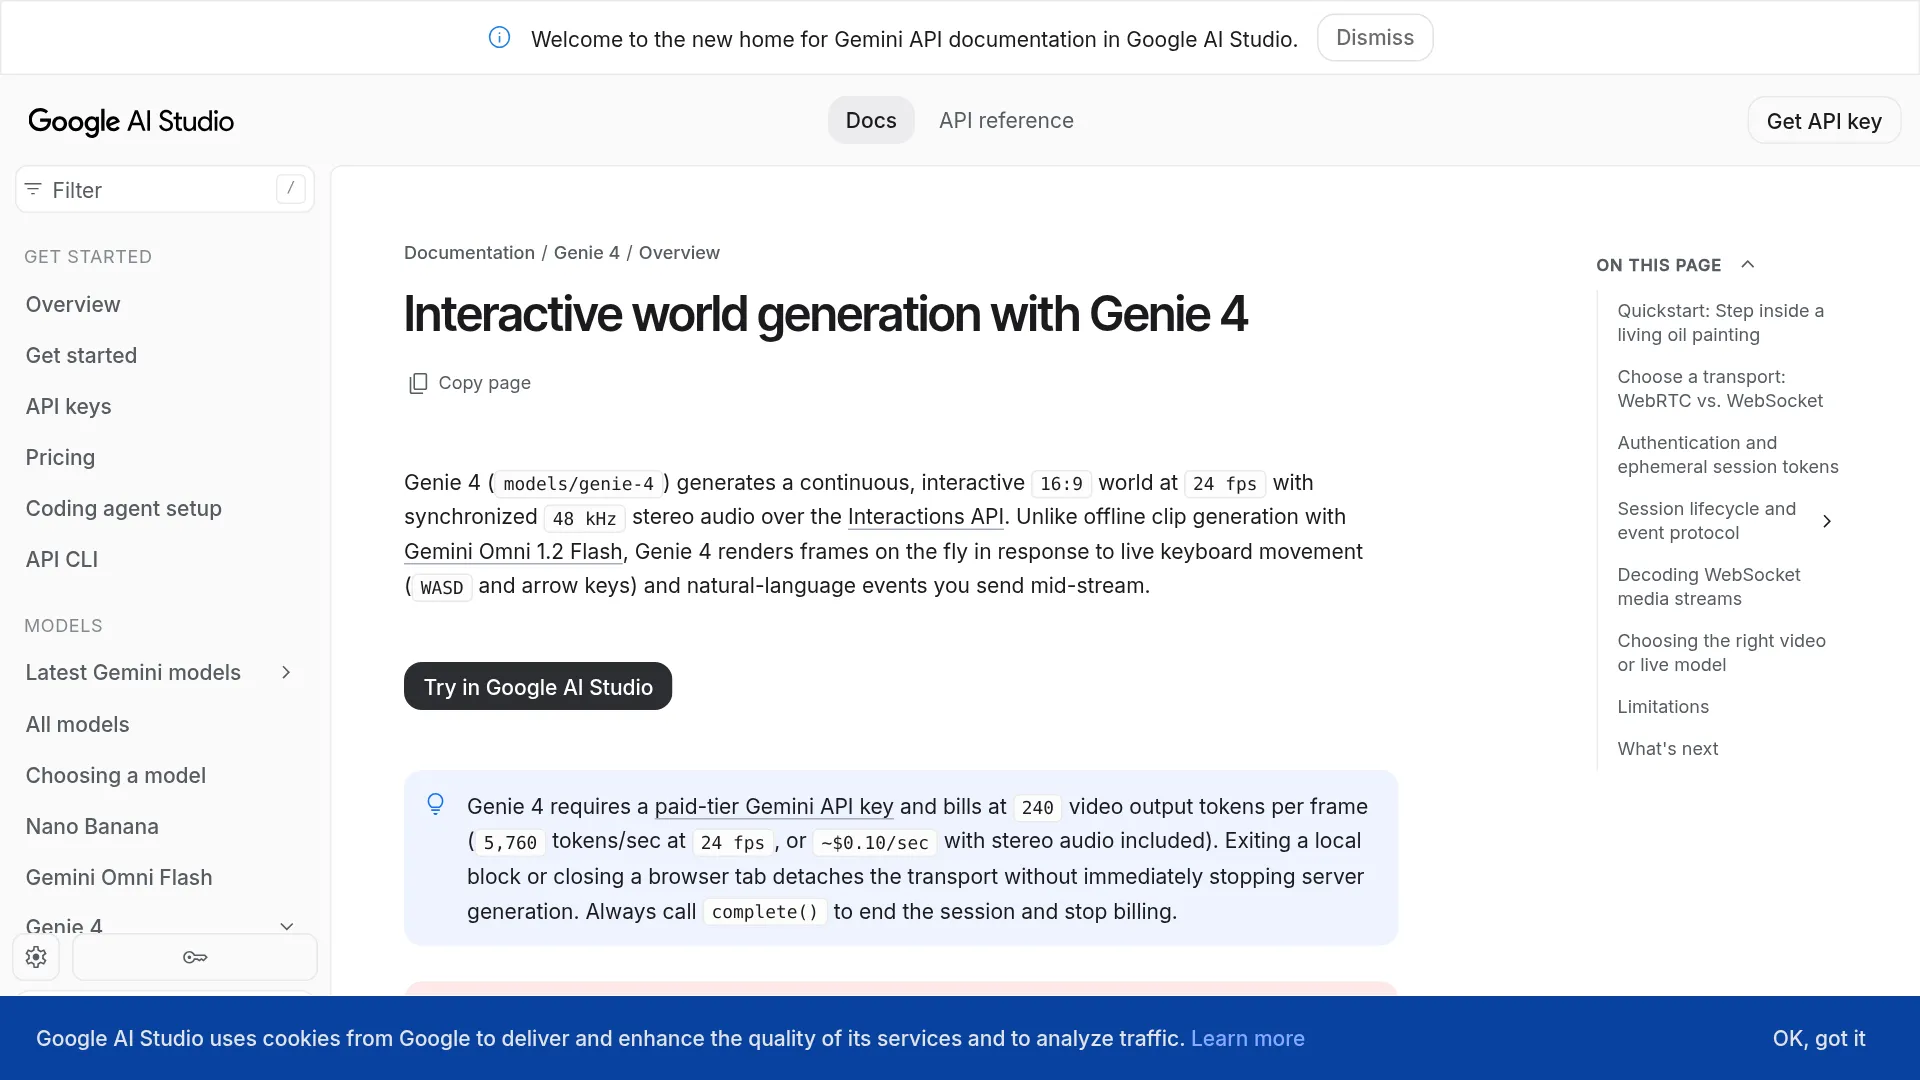
Genie 4 genera un mondo continuo in 16:9, a 1280x720 e 24 fps, con audio stereo sincronizzato a 48 kHz, comprensivo di atmosfera, effetti e dialoghi dei personaggi, secondo l'annuncio ufficiale. Il mondo può partire da un prompt testuale, da un'immagine di riferimento in 16:9 o da entrambi. Durante la sessione l'utente può muoversi con WASD o i tasti freccia e usare prompt testuali per cambiare meteo, illuminazione, oggetti ed eventi. A differenza della generazione video offline, Genie 4 renderizza i fotogrammi in risposta agli input dal vivo.
Quanto costa davvero una sessione Genie 4
Il prezzo di Genie 4 è calcolato in token, ma per capire la spesa conviene ragionare in secondi. La documentazione di AI Studio per Genie indica $1.50 per milione di token in input, $9.00 per milione di token testuali in output e $17.50 per milione di token video in output, con il video fatturato a 240 token per fotogramma. La documentazione riporta una stima effettiva aggregata di circa ~$0.10 al secondo per lo stream completo.
| Utilizzo | Tariffa applicata |
|---|---|
| Token in input | $1.50 / 1M token |
| Token testuali in output | $9.00 / 1M token |
| Token video in output | $17.50 / 1M token |
| Consumo video a 24 fps | 240 x 24 = 5,760 token / secondo |
| Costo effettivo dello streaming | stima aggregata di ~$0.10 / secondo secondo la documentazione |
È il video a far girare soprattutto il contatore: 5,760 / 1,000,000 x $17.50 = $0.1008 al secondo solo per i token video. Per questo la documentazione arrotonda a ~$0.10 al secondo il costo combinato di video e audio. Si tratta di circa $6.05 al minuto e circa $12.10 per una sessione completa di 120 secondi, prima di aggiungere token dei prompt e dei dialoghi.
Per fare un budget: una demo su landing page con dieci visite da 30 secondi consuma ~300 secondi, cioè circa $30 di generazione del mondo. Un'ora di generazione continua costa circa $363. E poi c'è il secondo limite, oltre al budget: le quote. Secondo il riepilogo del lancio di AICoder, il Tier 1 consente 2 sessioni simultanee e 50 richieste al giorno, il Tier 2 5 e 250, il Tier 3 10 e 1.000. Prima di fare test di carico, controlla il tuo tier nella documentazione sui limiti di velocità: le quote beta possono cambiare.
Anche i test più semplici vengono fatturati. Conviene quindi partire dal playground Live di AI Studio e passare solo dopo a un'integrazione con chiave API.
WebRTC o WebSocket: scegli in base a dove fai il rendering
| Funzionalità | WebRTC | WebSocket |
|---|---|---|
| Ideale per | Giocare nel browser con controllo da tastiera | Elaborazione lato server, registrazione, media personalizzati |
| SDK | @google/genai in JavaScript/TypeScript nel browser | google-genai in Python async, @google/genai in Node |
| Media | Video RTP nativo + audio Opus verso <video> | step.delta JSON con JPEG in base64 + PCM Int16 a 48 kHz |
| Comportamento della latenza | Più bassa; UDP + buffer anti-jitter | Più alta; blocco head-of-line di TCP in caso di perdita |
| Limite del payload | Limite SCTP di 64 KB; controllare la dimensione finale del seed codificato | Payload JSON più grandi accettati |
Il confronto tra i due trasporti segue la documentazione di AI Studio per Genie: WebRTC è la scelta predefinita per giocare nel browser con la massima reattività, mentre WebSocket è pensato per acquisizione e pipeline personalizzate.
Il pattern sicuro è lo stesso in entrambi i casi, come spiega la sezione sull'autenticazione della documentazione di Genie. Il server chiama interactions.create, genera un token effimero valido per una singola sessione e invia al browser soltanto l'ID dell'interazione insieme a quel token. Mai inserire una chiave a lunga durata nel codice client. Il WebSocket standard del browser non può aggiungere l'header x-goog-api-key, quindi le connessioni dal browser usano il token di sessione auth_tokens/....
Il ciclo di vita minimo della sessione, secondo la documentazione sul ciclo di vita delle sessioni:
- Server:
interactions.createconmodels/genie-4. - Server: genera un
auth_tokenvalido per una singola sessione e invia ID + token al browser. - Client: esegue
interactions.connectvia WebRTC o WebSocket. - Client: invia esattamente un
world_setupconworld_prompte un'eventualereference_imagein 16:9. - Client: controlla il mondo con gli eventi da tastiera
user_actione gli eventi testualiinput. - Client o server: chiama
complete()per interrompere generazione e fatturazione.
I tasti mantenuti premuti continuano ad applicarsi fino a key_up; il client dovrebbe quindi disattivare l'auto-ripetizione del sistema operativo. Nell'esempio della documentazione, le azioni personalizzate associate a E, Q o Spazio non hanno un comportamento di salto incorporato: vengono invece trasformate in input testuali descrittivi.
La vera trappola è nella fatturazione, non nella struttura del codice. Come spiega la sezione sul ciclo di vita nella documentazione, complete() ferma la generazione lato server e la fatturazione, mentre cancel() interrompe tutto immediatamente. detach(), invece, chiude soltanto il socket locale e non va considerato un modo affidabile per fermare i costi. Chiudere una scheda del browser scollega il trasporto, ma non garantisce l'arresto della generazione. Chiama sempre esplicitamente complete() o cancel().
Con WebRTC bisogna prestare attenzione alle immagini seed. La documentazione segnala un limite SCTP di 64 KB e consiglia di mantenere piccola la dimensione finale del seed codificato in base64, all'incirca metà del budget dopo l'espansione di ~33% dovuta a base64. Controlla nel codice la dimensione del payload codificato, senza fidarti soltanto della risoluzione: per i seed troppo grandi è meglio usare WebSocket.
4 limiti pronti a mandare in crisi la demo
Secondo la sezione sui limiti, il modello lavora su una finestra temporale mobile invece di mantenere un grafo persistente della scena 3D. Prima di promettere qualcosa agli utenti, progetta tenendo conto di quattro vincoli.
1. Limite rigido di 120 secondi. Ogni sessione termina dopo 120 secondi, come indicato dai limiti della documentazione. Collegare sessioni nuove può allungare l'esperienza complessiva, ma non conserva lo stato esatto della scena, perché le sessioni non riprendono da dove erano state interrotte. La configurazione iniziale del mondo richiede alcuni secondi prima del primo fotogramma; nel quickstart della documentazione si parla di ~5–9 secondi.
2. Deriva dopo 60–90 secondi e reset quando si distoglie lo sguardo. La documentazione avverte che la stabilità visiva può peggiorare dopo 60–90 secondi. Inoltre, guardare altrove per oltre 8 secondi o ruotare di 360 gradi può spostare punti di riferimento, porte o pulsanti. Nell'esempio del canale, girarsi di 180 gradi e tornare indietro può riorganizzare gli edifici sullo sfondo. Insegne, indicatori, orologi e quantità precise sono i primi elementi a deformarsi. La documentazione consiglia di descrivere cambiamenti continui invece di ricorrere a stacchi netti di camera, e di ripetere prompt brevi per ~1.5 secondi lasciando un cooldown di ~2 secondi, perché la pianificazione del mondo campiona il testo ai confini degli step.
3. Latenza e sensibilità alla regione. Genie 4 viene servito da Stati Uniti, Europa occidentale e Giappone. Secondo la documentazione, la risposta migliore si ottiene con un round trip inferiore a ~150 ms in Nord America, Europa occidentale/centrale ed Asia orientale. Oltre quella soglia i comandi diventano poco reattivi e il frame rate può calare. Posiziona i relay backend vicino a una regione di servizio e misura la latenza WebRTC dalla geografia di riferimento. Con un round trip basso, la risposta alla tastiera è documentata in ~0.2–0.5 secondi, mentre gli eventi testuali richiedono ~1–2 secondi.
4. Canvas fisso e contenuti bloccati. L'output è vincolato a 16:9, 720p e 24 fps. Niente modalità verticale, frame rate configurabile, input dal vivo da microfono o webcam, function calling, grounding con Search, output strutturati o ripresa della sessione. Prompt o seed con persone identificabili, personaggi pubblici o proprietà intellettuale di marchi possono essere bloccati o interrompere lo stream. Ogni output include un watermarking impercettibile SynthID.
"Sembra bello, non è robaccia, ma non mi interessano gli esempi specifici e curati da Google... Voglio vedere un tizio qualunque di nome Steve usarlo dal vivo su YouTube, magari prendendo spunti dalla chat, e capire quanto funziona senza esempi scelti ad arte" — u/RobXSIQ, che chiede test live senza copione invece di demo curate
Fai questo test senza copione prima del lancio: entra, guarda altrove per 10 secondi, ruota di 360 gradi, invia tre eventi testuali in conflitto uno dopo l'altro e osserva cosa cambia posizione.
Conviene costruire su Genie 4 questa settimana?
Genie 4 dà il meglio in mondi brevi, controllabili e usa-e-getta. La tabella comparativa nella documentazione di Google ne delimita l'uso rispetto a due modelli della stessa famiglia: Gemini Omni 1.2 Flash per clip offline e Gemini 3.8 Live per agenti vocali.
| Obiettivo | Scelta | Perché |
|---|---|---|
| Prototipo giocabile, walkthrough spaziale, toy per browser, playground per agenti | Genie 4 via Interactions API | Controllo live a 24 fps + audio nativo; è l'opzione del confronto che supporta WASD e testo durante l'esecuzione |
| Clip rifinita da 3–15 s, modifica/estensione fino a 30 s, upscale a 1080p/4K | Gemini Omni 1.2 Flash via Interactions API | Workflow di modifica offline con fino a 6 immagini di riferimento; editing offline e risoluzione di output superiore |
| Agente vocale con microfono/fotocamera, strumenti e grounding | Gemini 3.8 Live via Live API | Comprensione bidirezionale di audio/video + tool calling; Genie 4 non offre nessuna di queste funzioni |
I primi casi d'uso sensati sono moodboard interattive, spike di level design, sandbox per robot o agenti in cui un mondo fittizio e sicuro è preferibile a uno reale, e demo per eventi sotto i due minuti. Sono invece scelte poco adatte per stato persistente in multiplayer, inventari o insegne precise, sessioni di addestramento lunghe, esperienze mobile a schermo intero in verticale e tutto ciò che richiede seed riproducibili.
Esiste un livello gratuito per Genie 4 API?
No. Genie 4 richiede una chiave Gemini API con piano a pagamento e la documentazione indica un costo effettivo di circa $0.10 al secondo per il mondo trasmesso in streaming con audio.
Il browser può chiamare Genie 4 senza esporre la chiave API?
Sì, usando token effimeri. Il server crea l'interazione e genera un token valido per una singola sessione; il browser si connette con quel token a breve durata, mai con la chiave a lunga durata.
Una sessione Genie 4 può durare più di 2 minuti?
No. Le sessioni sono limitate a 120 secondi, la stabilità spesso peggiora dopo 60–90 secondi e le sessioni non possono essere riprese. Per flussi più lunghi puoi concatenare sessioni nuove, sapendo però che lo stato della scena non verrà trasferito esattamente.
Chiudere la scheda interrompe la fatturazione di Genie 4?
Non in modo affidabile. Secondo la documentazione, chiudere la scheda scollega il trasporto, mentre la generazione lato server può continuare. Chiama sempre complete() o cancel() per fermare la fatturazione.
Checklist operativa prima del lancio: crea le interazioni lato server, genera token per singola sessione, invia un solo world_setup, disattiva l'auto-ripetizione dei tasti, metti a budget ~$0.10/sec più i token dei dialoghi, posiziona i relay vicino alle regioni di servizio USA/UE/JP e chiudi ogni sessione con complete(). Il compromesso è tra la sensazione di "camminare dentro il prompt" e una memoria breve con fatturazione al secondo.