Con high, Neon offre qui il miglior rapporto qualità-prezzo per gli agenti che lavorano su contesti lunghi e devono ridurre al minimo le risposte errate; Astra e Sol restano più economici per singola attività. Questa è una sintesi realizzata al lancio, basata su specifiche ufficiali, classifiche e test indipendenti. Non ho eseguito personalmente test con Neon.
Neon è un Carbon più veloce per gli agenti, ma con un compromesso preciso
Gemini 4 Neon è stato lanciato il 18 novembre 2026 con il nome gemini-4-neon. Secondo Google e 9to5Google, si colloca al centro della gamma Gemini 4, tra Hydrogen e Carbon. Google dichiara tempi di completamento end-to-end inferiori a quelli di Carbon e un costo per attività più basso; anche alcuni membri di DeepMind lo descrivono come più economico e veloce di Carbon (@_mohansolo). Neon è al terzo posto nell'Artificial Analysis Index, con 61 in modalità xhigh, e al secondo posto in Agent Arena, con 1336 punti su oltre 4.200 sessioni. Nei materiali di lancio consultati non erano pubblicati punteggi Arena ottenuti sullo stesso tabellone da Opus 5.5 e Fable 5.2; il confronto diretto qui sotto usa quindi le posizioni negli indici e i test sulla stessa attività.
Prezzi, finestra di contesto e disponibilità
Neon costa 3 $ per milione di token in input, 15 $ in output e 0,15 $ per l'input memorizzato nella cache, secondo Google. Il contesto arriva a 1.048.576 token, mentre una singola risposta può contenere al massimo 65.536 token. I livelli di ragionamento sono low / medium / high (predefinito) / xhigh e vengono fatturati come output: i livelli più alti possono consumare più token di ragionamento e far aumentare il conto. Il livello predefinito high è documentato nell'analisi dei livelli di DataCamp e nelle note sull'API di SpringPrompt.
Il servizio è riservato ai piani a pagamento e non offre un livello gratuito, secondo il controllo dell'API di eesel. Per quanto riguarda la disponibilità, Google e 9to5Google indicano: API a pagamento in AI Studio, Gemini per le aziende, Antigravity (Pro/Ultra), app Gemini (Pro/Ultra, che sostituisce Argon), Android Studio e Cursor. Su Cursor raggiunge il 63,7% con il livello di sforzo predefinito di CursorBench, contro il 57,3% di Hydrogen, secondo Cursor.
| Modello | Input / output per 1M | Ragionamento predefinito |
|---|---|---|
| Gemini 4 Neon | 3 $ / 15 $, cache 0,15 $ | high |
| Gemini 4 Hydrogen | 1,50 $ / 7,50 $ | high |
| Gemini 4 Carbon | 2 $ / 10 $ fino al 30 novembre, poi 4 $ / 20 $ | medium |
| Claude Opus 5.5 | 4 $ / 20 $, impostazione massima testata | massima testata |
| GPT-6.2 Sol | 2 $ / 10 $, impostazione massima testata | massima testata |
I prezzi dei concorrenti e le indicazioni sulle impostazioni migliori sono quelli raccolti nella tabella comparativa di eesel. Dal 1° dicembre Neon costa il 25% in meno per token rispetto a Carbon. Dettagli: prezzi di Neon.
Usa l'API per fissare il livello di ragionamento; per una gestione automatica della quota, scegli l'app o Antigravity. Le segnalazioni sulla quota sono solo indicazioni aneddotiche utili a pianificare: circa l'1–3% della quota Pro per chat contro circa il 5% per un'esecuzione di 10 minuti con 3 sub-agent, secondo le segnalazioni degli utenti.
Benchmark a confronto con Opus 5.5, Fable 5.2 e Sol
I punteggi sono dichiarati dai fornitori tramite Google e raccolti da eesel e DataCamp.
| Test | Neon | Concorrente | Indicazione |
|---|---|---|---|
| Vals Index | 70,9%, n. 2 | Fable circa 71,3% | Quasi al vertice |
| AutomationBench | 56,3%, n. 1 | Opus 42,5%, Sol 41,3% | In testa sugli agenti |
| GraphWalks 256K–1M | 95,2% | Opus 66,8%, Sol 80,1% | In testa sui contesti lunghi; riproduci prima il file più esteso, perché alcuni utenti di Argon segnalano riassunti eccessivi (discussione) |
| Terminal-Bench 4.1 | 65,2% | Opus 65,8% | Quasi pari, Opus +0,6 |
| FrontierCode 2.0 | 46,2% | Opus 47,3% | Opus +1,1 |
| CursorBench 4.1 | 63,7–65,4% | Opus 58,1% | Neon è avanti con lo sforzo predefinito |
Il costo per attività ribalta il semplice confronto dei prezzi per token, secondo Artificial Analysis tramite eesel:
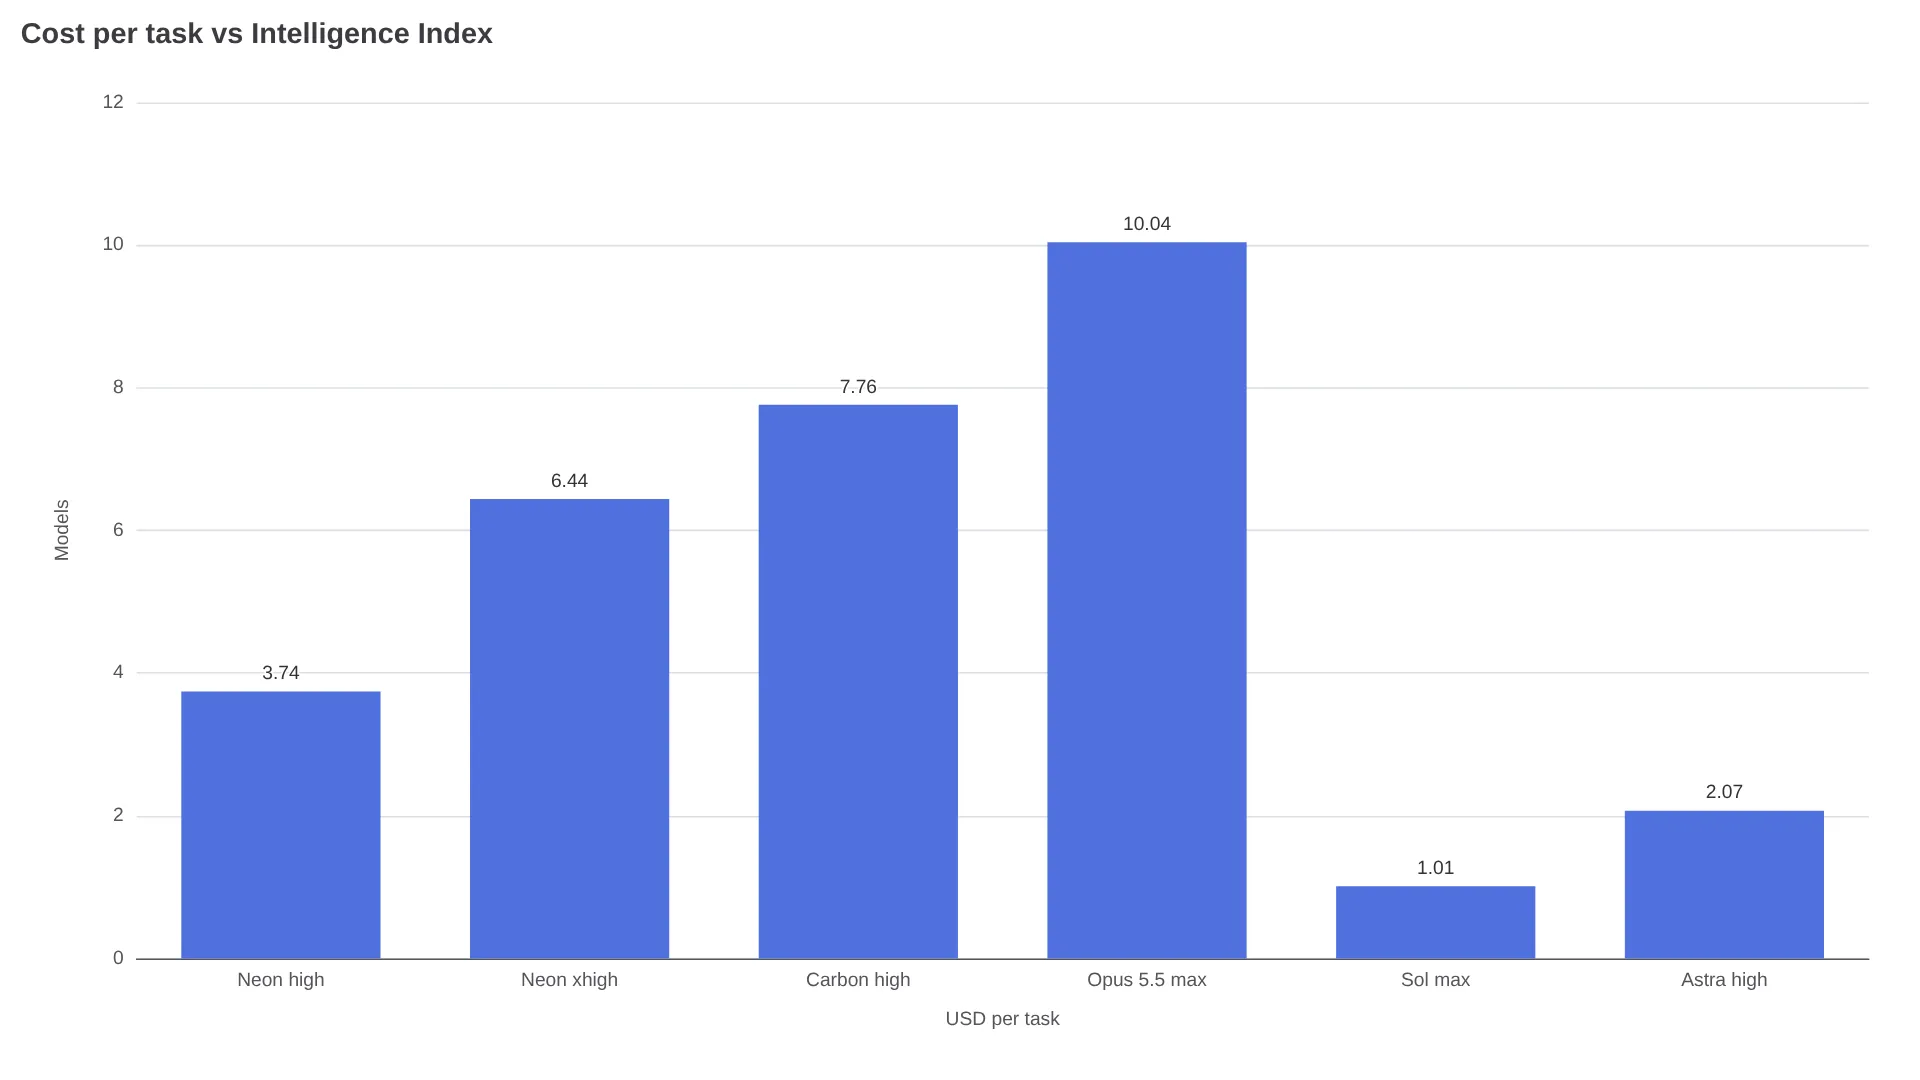
Neon high ottiene 59,6 con 3,74 $ in 14,8 minuti; Carbon high arriva a 60,0 con 7,76 $ in 37,2 minuti; Opus al massimo raggiunge 59,1 con 10,04 $; Astra high arriva a 60,1 con 2,07 $; Sol al massimo ottiene 57,3 con 1,01 $. Neon in modalità xhigh raggiunge 61,4 con 6,44 $ in 21,5 minuti. Usa high, a meno che 1,8 punti in più non valgano 2,70 $ e 6,7 minuti.
Neon contro Fable 5.2: i primi risultati suggeriscono di dividere i ruoli
Nel SWE-sweep con harness del provider (harness Antigravity), Neon raggiunge il 39,0% contro il 10,1% di Opus e l'8,3% di Sol. Con l'harness mini-SWE condiviso, i risultati sono 12,8% per Neon, 11,6% per Sol e 3,6% per Opus, secondo DataCamp. Una parte consistente del divario riportato dai titoli dipende dall'harness, non dal modello in sé.
"Sto usando Fable 5.2 come orchestratore e sviluppatore, con Neon come agente di coding, ed è lo stack migliore che abbia mai usato." — u/1969Stingray (discussione)
In modo aneddotico, gli utenti sembrano preferire Fable per l'orchestrazione e Neon per l'implementazione; verifica però il comportamento sul tuo repository. Nel test AA-Omniscience, Neon registra il 14% di risposte errate invece di rifiutarsi di rispondere, contro il 50% di Opus, il 55% di Sol e il 58% di Astra e Fable. La copertura corretta è però del 59–60%, contro il 66% di Astra e il 77% di Fable, secondo eesel.
Test pratici: scacchi, cataloghi e 105 bug reali
| Test | Risultato | Limite |
|---|---|---|
Pagina di scacchi, 3 esecuzioni medium (DataCamp) | Neon 3/3 a 0,83–1,06 $; Carbon 1/3, due esecuzioni hanno raggiunto il limite di 65K; 16 partite, zero mosse illegali | Una sola attività; Carbon probabilmente completa il lavoro con la modalità in background |
| CatalogBench fattuale (SpringPrompt) | 78,6% di contenuti pronti alla pubblicazione x3, primo su 35; recupera le specifiche direttamente dalle confezioni | Vendite 32,1%, presentazioni al 24° posto, sondaggi al 22° posto sul piano del budget |
| 105 bug reinseriti (@PawelHuryn) | Neon xhigh 63 contro Astra 62,7, Fable 58 e Carbon 57,3 | Un solo tester |
SpringPrompt ha usato OpenRouter con medium, mentre l'API Google usa high come impostazione predefinita: per questo la verbosità cambia. Esistono anche segnalazioni isolate di problemi di fuga dei dati in AI Studio (discussione). Per le chat, i tempi misurati da eesel indicano 56,5 secondi per il primo token con Neon xhigh; per le risposte interattive è quindi meglio preferire medium o Hydrogen.
La scelta giusta dipende dal carico di lavoro
| Carico di lavoro | Scelta | Motivo |
|---|---|---|
| Agenti complessi, documenti lunghi, refactoring | Neon high | 59,6 con 3,74 $, n. 2 in Agent Arena, 3/3 negli scacchi |
| Build con l'orizzonte più lungo | Carbon, secondo il posizionamento della famiglia definito da Google | Google riserva Carbon ai progetti più complessi; qui non è disponibile un test sulla stessa attività che lo dimostri |
| Orchestrazione + coding | Fable come leader + Neon per il coding | Configurazione ibrida aneddotica descritta sopra; va verificata prima |
| Minima spesa per attività | Sol al massimo, 1,01 $; Astra high, 2,07 $, con un punteggio superiore | Entrambi hanno registrato tassi più elevati di risposte errate in AA-Omniscience |
| Chat interattiva | Hydrogen o Neon medium | La latenza del primo token in xhigh è troppo alta per la chat |
| Uso in ambiti regolamentati | Attendere la documentazione | Il rapporto completo sulla sicurezza era ancora atteso il 19 novembre; procedi all'approvazione solo dopo aver verificato i documenti richiesti |
Provalo in autonomia in un pomeriggio
Esegui lo stesso prompt, sugli stessi file e con lo stesso budget di ragionamento, usando Neon high, la tua impostazione attuale e un'alternativa economica. Registra successo, costo, tempo e risposte errate. Per il tuo carico di lavoro, un confronto del genere vale più di qualsiasi classifica. Per i calcoli su Opus: recensione di Opus 5.5, recensione di Fable 5.2.