 AIREITER
Un agente di coding che analizza i file, esegue i test e corregge iterativamente il proprio lavoro può consumare da 50.000 a 200.000 token per ogni issue risolta. Con GPT-5.6 Sol, che costa $30/M in output, bastano i soli token generati per portare il costo di un task fra $1.50 e $6. DeepSeek V4 Pro dichiara invece $0.87/M in output, circa 1/34 del prezzo, ma la sua affidabilità nelle sequenze multi-step non è stata ancora valutata in modo indipendente con la stessa profondità riservata a Claude o GPT. Qui mettiamo a confronto sei modelli sulla base dei benchmark di coding pubblicati, dei prezzi API verificati, dei limiti di contesto e del workflow agentico per cui sono più indicati.
Sei LLM da considerare per gli agenti di coding nel 2026
Per ogni modello incrociamo dati da benchmark ufficiali o classifiche pubbliche con i prezzi API verificati ad agosto 2026. Quando manca un punteggio pubblicato per l'esatto modello in classifica, indichiamo esplicitamente come proxy la variante più vicina disponibile.
1. Claude Opus 5 — Il riferimento per la qualità
Claude Opus 5 mantiene la famiglia Claude ai vertici della classifica ufficiale SWE-bench Verified. Il predecessore Claude 4.5 Opus ha ottenuto il 76,8% con l'harness mini-SWE-agent: un proxy utile per stimare la fascia di prestazioni di Opus 5, anche se non sono ancora disponibili risultati SWE-bench Verified specifici per Opus 5. Il modello offre una finestra di contesto da 1 milione di token e un output massimo di 128K token. A $5/M in input e $25/M in output, è l'opzione mainstream più costosa di questa selezione. Se un refactoring fallito su più file costa più tempo umano di quanto costino i token, Opus 5 è la scelta giusta. Per modifiche ripetitive e ad alto volume, no.
2. GPT-5.6 Sol — Specialista dei task da terminale
GPT-5.6 Sol (model ID gpt-5.6-sol) costa $5/M in input e $30/M in output, con una finestra di contesto da 1,05 milioni di token. Nel confronto di benchmark pubblicato da xAI, GPT-5.6 Sol Max guida il gruppo su Terminal-Bench v3.0 con il 34,6% contro il 26% di Grok 4.6, e su DeepSWE v1.1 con il 73%. Sono i benchmark più rilevanti per gli agenti che lavorano dal terminale. Il rovescio della medaglia è il prezzo: con $30/M in output, Sol è il modello più caro della lista. OpenAI riporta inoltre punteggi SWE-bench Pro del 64,6% per Sol e del 63,4% per Terra, la variante di fascia intermedia: un riferimento utile per chi cerca un'opzione OpenAI meno costosa per task meno impegnativi.
3. Grok 4.6 — Il miglior rapporto valore/prezzo per agenti di lunga durata
Grok 4.6, rilasciato il 12 agosto 2026, è pensato per workflow agentici prolungati. Secondo l'annuncio di xAI, eguaglia GPT-5.6 Sol Max nell'Artificial Analysis Intelligence Index con 61 e lo supera su CursorBench v3.2 (69,9% contro 67,2%), FrontierCode v1.1 (61,3% contro 60,6%) e APEX-Agents (57,5% contro 56,7%). A $2/M in input e $6/M in output, offre prestazioni nei benchmark paragonabili a GPT-5.6 Sol Max a circa un quinto del costo in output. Il suo punto debole è l'esecuzione pura da terminale: su Terminal-Bench v3.0 totalizza il 26%, nettamente dietro al 34,6% di Sol Max. Se il tuo workflow è incentrato sull'IDE, ad esempio Cursor o Grok Build, anziché sul terminale, Grok 4.6 è l'opzione con il miglior equilibrio fra qualità e prezzo della lista. Una variante "fast" raddoppia i prezzi a $4/$12 in cambio di minore latenza. La finestra di contesto è di 500K token.
4. DeepSeek V4 Pro — Il cavallo di battaglia per contenere i costi
DeepSeek V4 Pro è il modello di fascia frontier più economico disponibile via API: $0.435/M in input e $0.87/M in output, mentre l'input in cache scende a $0.003625/M. La finestra di contesto da 1 milione di token e l'output massimo di 384K token lo rendono adatto anche a task sull'intero repository. Non esistono benchmark pubblicati che valutino DeepSeek V4 Pro contro Claude o GPT in scenari agentici multi-step con la stessa profondità dell'harness; prima di affidargli refactoring complessi, conviene quindi verificarne l'affidabilità nelle tool call e nelle sessioni lunghe nel proprio setup. Per team con budget limitato, o come modello di primo passaggio in una configurazione con routing, l'economia è molto interessante. Per i refactoring multi-file più difficili, dove l'affidabilità conta più del costo dei token, bisogna aspettarsi un'escalation.
5. Gemini 3.1 Pro — Per leggere repository molto grandi
La Preview di Gemini 3.1 Pro di Google costa $2/M in input e $12/M in output per prompt sotto i 200K token; oltre tale soglia, il prezzo sale a $4/$18. Il suo tratto distintivo è la capacità di contesto: con una finestra da 2 milioni di token, la più ampia fra i modelli qui elencati, è adatto a leggere un intero codebase in un unico passaggio. Come proxy della fascia attesa per 3.1 Pro, Gemini 3 Flash ha raggiunto il 75,8% su SWE-bench Verified in uno snapshot di giugno 2026 pubblicato da Tembo, secondo solo a Claude 4.5 Opus. La costanza di Gemini nelle tool call durante loop agentici estesi non è stata benchmarkata con la stessa profondità di Claude o GPT: testalo nel tuo harness prima di distribuirlo in workflow multi-step.
6. Kimi K3 — L'alternativa open-weight per gli agenti
Kimi K3 di Moonshot AI ha ottenuto il 70,8% su SWE-bench Verified nello stesso snapshot di giugno 2026, sotto GLM-5 (72,8%) e MiniMax M2.5 (75,8%) fra i modelli open-weight. Essendo un modello open-weight, può essere eseguito in self-hosting dai team il cui codice non può uscire dalla rete aziendale. Anche l'API hosted di Moonshot offre K3, ma il prezzo specifico dipende dalla configurazione di deployment. Per setup agentici locali con GPU adeguate, K3 abbinato a un harness leggero come OpenCode consente di avere un coding agent capace senza costi API per token.
Prezzi API e costo per issue risolta
Il prezzo per token racconta solo metà della storia. La metrica che conta davvero è il costo per task completato: quanto si spende per risolvere una vera issue GitHub attraverso un loop agentico.
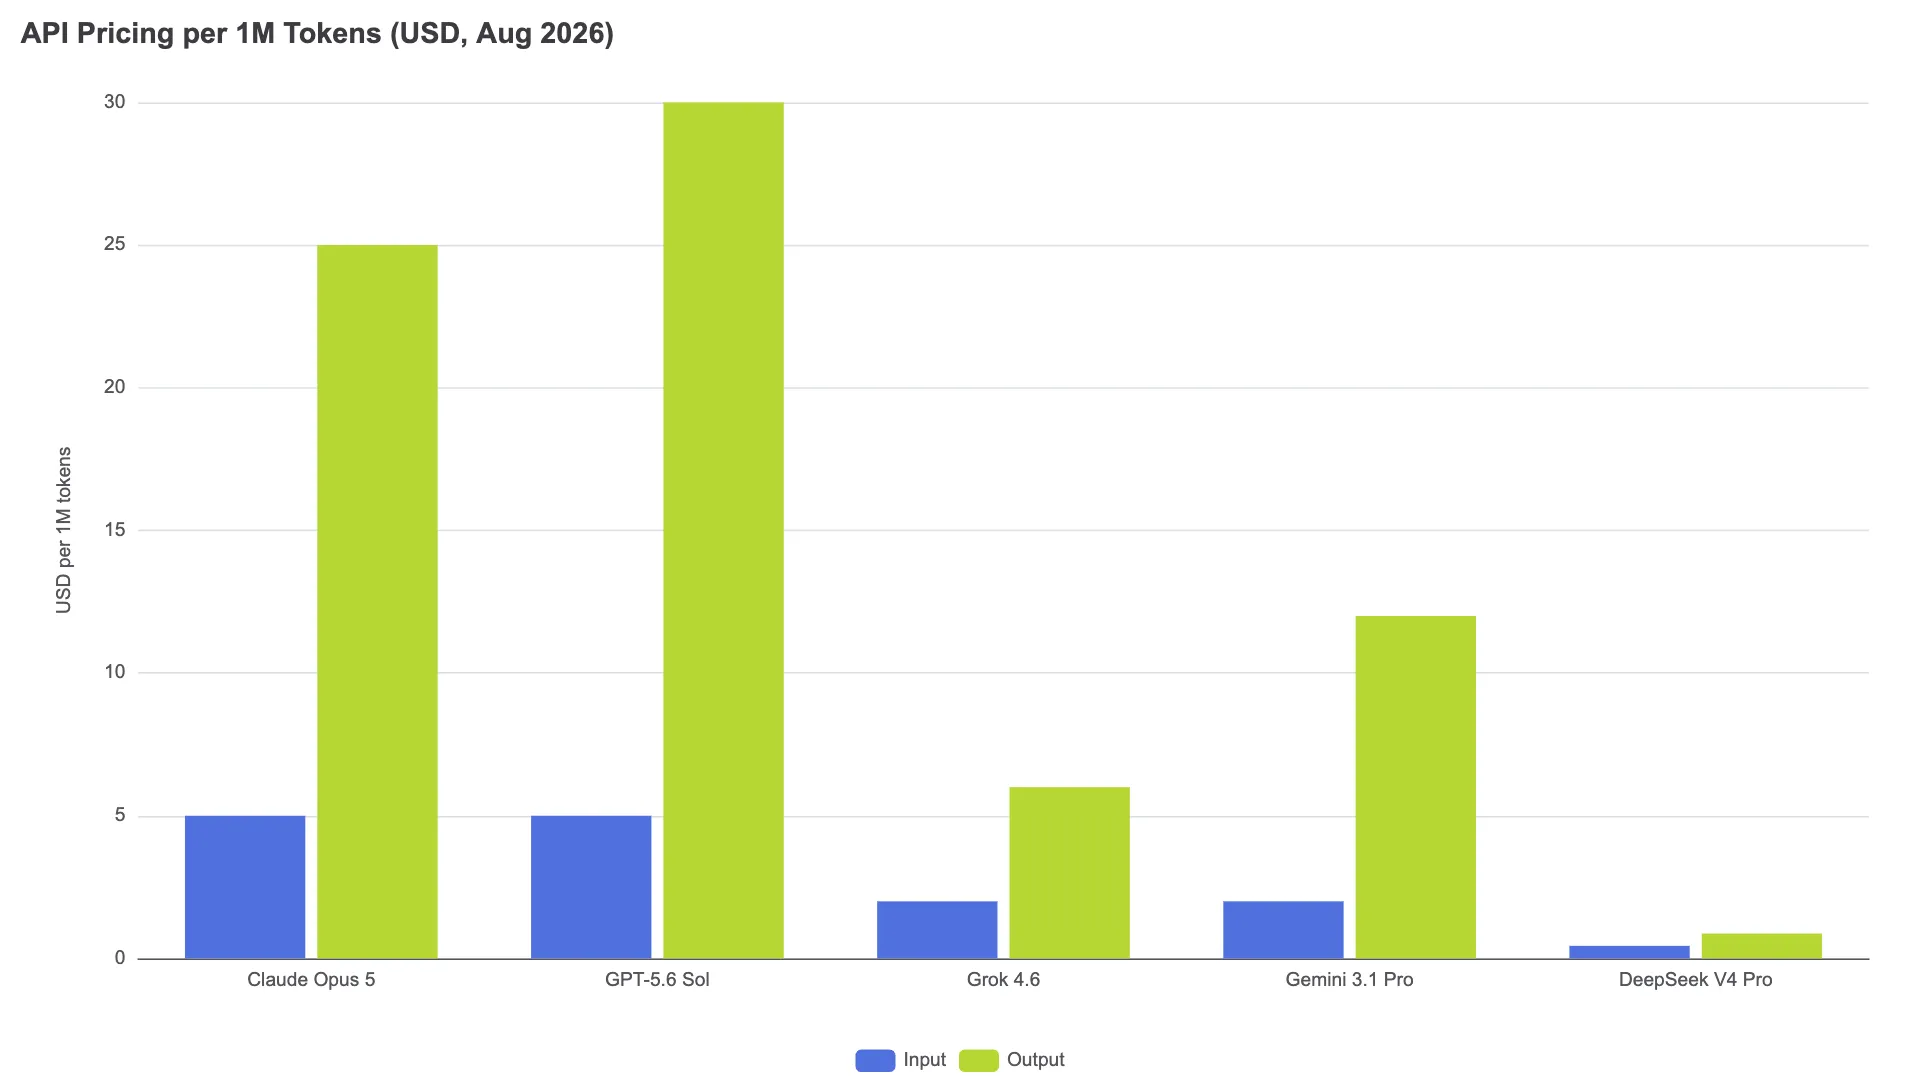
Un tipico loop agentico — lettura dei file, pianificazione, modifiche, esecuzione dei test e correzione degli errori — richiede all'incirca 50K–200K token per issue risolta; l'output rappresenta dal 30% al 50% del totale. Sono stime di settore tratte dalle analisi dei loop agentici di Tembo e da altre fonti: il consumo effettivo dipende dalle dimensioni del repository, dalla durata della suite di test e dall'efficienza dell'harness. Usando il punto medio di 125K token totali, cioè 75K in input e 50K in output, ecco quanto costa risolvere una issue con ciascun modello:
| Modello | Costo input | Costo output | Totale per task |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3 non compare nella tabella perché il suo costo dipende interamente dall'uso dell'API hosted di Moonshot oppure dal self-hosting sulle proprie GPU: non esiste un unico prezzo di listino comparabile. Grok 4.6 occupa una posizione particolarmente favorevole a $0.45, eguagliando il punteggio di GPT-5.6 Sol Max nell'Artificial Analysis Intelligence Index a circa un quarto del costo per task di Sol.
Queste stime non includono retry, sconti sui token in cache, overhead delle tool call e infrastruttura. Un modello che richiede più tentativi o più correzioni umane per task finirà per costare più di quanto suggerisca il suo prezzo per token. Ecco perché il routing — affidare il lavoro ordinario a DeepSeek o Grok e passare i refactoring difficili a Opus — può rendere meglio della scelta di un solo modello.
Quale modello scegliere in base al workflow dell'agente
Non esiste un modello adatto a ogni flusso di lavoro. Ecco quale integrare per ciascun tipo di attività agentica.
Iterazioni rapide e modifiche di routine. Usa Gemini 3.5 Flash ($1.50/$9 per M token) o Claude Sonnet 5 per attività frequenti e a basso rischio: spiegazioni di errori, piccole aggiunte a funzioni, stub di test e aggiornamenti della documentazione.
Refactoring profondi e architettura. Claude Opus 5 è la scelta per modifiche su più file, dipendenze fra moduli o decisioni architetturali in cui un'ipotesi sbagliata può costare ore di debug. I suoi punti di forza sono la precisione nel seguire le istruzioni e la coerenza del contesto nelle sessioni lunghe.
Agenti autonomi di lunga durata. Grok 4.6 è stato progettato proprio per questo caso d'uso. Secondo l'annuncio di xAI, lo sviluppo si è concentrato su traiettorie agentiche sostenute e comportamenti di autocontrollo. A $0.45 per task, puoi lasciarlo lavorare più a lungo senza la pressione sui costi generata da GPT-5.6 Sol a $1.88 per task. Nei workflow dominati dal terminale, il vantaggio di GPT-5.6 Sol su Terminal-Bench, con il 34,6%, lo rende la scelta più prudente.
Budget ridotto e self-hosting. DeepSeek V4 Pro via API è l'impostazione predefinita per i team attenti ai costi, a $0.077 per task. Le organizzazioni che non possono inviare codice ad API esterne possono invece eseguire in self-hosting un modello open-weight come Kimi K3 (70,8% su SWE-bench Verified) o MiniMax M2.5 (75,8%). Il mondo open-weight ha ridotto il divario rispetto ai leader closed-weight a pochi punti percentuali su SWE-bench Verified.
L'harness può limitare il modello più di quanto sembri
L'harness usato dall'agente — Claude Code, Codex CLI, Cursor o uno strumento open source come OpenCode — controlla quattro aspetti su cui il modello non interviene: gestione del contesto, cioè quando compattare e cosa conservare; definizioni e routing degli strumenti; schemi di recupero dagli errori; flussi di revisione e approvazione. Come osserva l'analisi di Tembo, il punteggio di un modello con un harness controllato come mini-SWE-agent può non riflettere il suo tasso di risoluzione reale in un setup configurato diversamente. Per confrontare i modelli, i benchmark che mantengono costante l'harness sono quindi più utili dei punteggi pubblicati dai vendor, nei quali si mescolano i miglioramenti del modello e quelli dell'harness.
Prima di cambiare modello, verifica il tuo harness. Controlla che l'agente compatti il contesto in modo efficace, che le definizioni degli strumenti siano pulite e che il recupero dagli errori ritenti con criterio anziché entrare in loop.
FAQ
Qual è l'LLM più economico per gli agenti di coding?
DeepSeek V4 Pro, a $0.435/M in input e $0.87/M in output, è l'opzione di fascia frontier meno costosa e porta il costo a circa $0.08 per task agentico risolto.
Come posso testare i modelli per agenti di coding sul mio repository?
Scegli 20–30 issue rappresentative dal backlog reale, includendo bug fix, nuove funzionalità e refactoring. Esegui ogni modello con l'harness scelto sugli stessi task. Misura tre metriche: tasso di risoluzione, cioè se la patch dell'agente supera i test; consumo di token per task; tempo di completamento. Una valutazione specifica sul repository è più predittiva di qualunque benchmark pubblico.