 AIREITER
Al lancio della dashboard, OpenRouter ha comunicato un cache hit rate complessivo della piattaforma dell'82,8% (@OpenRouter). Nelle discussioni della community emerge però un quadro molto diverso: hit rate sotto l'1% (@miolini) e fatture da 10 a 32 volte più alte del previsto (r/openrouter). Il prompt caching di OpenRouter può davvero abbattere il costo dell'input, ma prima vanno risolti quattro precisi punti di rottura. Il più importante è far sì che le richieste consecutive restino sullo stesso provider con cache calda. C'è inoltre un limite invalicabile: se il prompt è sotto la soglia minima di token prevista dal provider, non verrà mai memorizzato in cache, qualunque sia la configurazione.
Quando OpenRouter considera valida una cache hit
Il prompt caching riutilizza un prefisso stabile del prompt già elaborato dal provider: i token di input ripetuti vengono quindi fatturati a prezzo scontato anziché a tariffa piena. La cache risiede sullo specifico endpoint del provider che ha gestito la richiesta iniziale; ecco perché il routing conta quanto la struttura del prompt. È un livello distinto dal response caching, che restituisce gratuitamente una richiesta completa identica prima ancora che avvenga il routing.
| Prompt caching | Response caching | |
|---|---|---|
| Cosa riutilizza | Il prefisso stabile di qualsiasi richiesta | Una richiesta identica byte per byte (SHA-256 del body normalizzato) |
| Come si attiva | Per lo più automatico; cache_control per Anthropic, Qwen e Gemini | Header X-OpenRouter-Cache: true o preset |
| Costo | Token in cache a 0,1–0,5x l'input | Hit gratuiti, miss fatturati normalmente |
| Durata | In genere 3–5 min, fino a 1h (Anthropic) | 300s di default, intervallo 1–86.400s |
| Cosa lo blocca | Modifica del prefisso, cambio provider, minimo di token | Qualsiasi modifica al JSON, rotazione della chiave API, ZDR dell'account |
Il response caching è particolarmente utile per retry, test unitari e chiamate identiche ripetute nei workflow agentici. L'ordine delle proprietà JSON fa parte della chiave di cache, quindi anche una banale modifica nella serializzazione produce un miss. Il riferimento principale per il funzionamento lato provider è la guida al prompt caching di OpenRouter:
Costi del prompt caching su OpenRouter, provider per provider
Le letture dalla cache costano ovunque solo una frazione del normale input, ma la scrittura che crea la cache può avere un sovrapprezzo: 1,25x il normale input su Anthropic con TTL predefinito di 5 minuti, 2x con l'opzione da 1 ora. Il caching conviene quando lo stesso prefisso viene riletto abbastanza spesso da ammortizzare la scrittura; per una richiesta isolata può costare più che non usare la cache. Su Claude Sonnet 4.6, l'input in cache costa $0.30/M contro $3.00/M dell'input nuovo, secondo gli esempi numerici di OpenRouter.
Moltiplicatori di scrittura e lettura per provider, dalla stessa fonte:
| Provider | Scrittura cache | Lettura cache | Note |
|---|---|---|---|
| Anthropic | 1,25x (5 min) / 2x (1h) | 0,1x | TTL selezionabile per breakpoint |
| OpenAI, pre-GPT-5.6 | Gratuita | 0,25–0,5x | Automatica da 1.024 token |
| OpenAI GPT-5.6+ | 1,25x | 0,25–0,5x | Ora supporta breakpoint espliciti |
| Google Gemini | Gratuita | 0,25x | Implicita su 2.5+, TTL di ~3–5 min |
| Grok | Gratuita | 0,25x | Automatica |
| Moonshot | Gratuita | 0,25x | Automatica |
| Groq | Gratuita | 0,5x | Solo modelli Kimi K2 |
| DeepSeek | 1,0x | 0,1x | Scritture fatturate come input normale |
| Alibaba Qwen | 1,25x | 0,1x | Richiede cache_control esplicito |
| Z.AI | Gratuita | ~0,2x | Lo storage in cache è indicato come gratuito per un periodo limitato |
Il tutorial di OpenRouter calcola il caso di 10.000 token ripetuti per sei turni: 6,0x il costo di un singolo turno senza cache, 1,75x con cache Anthropic da 5 minuti e sticky routing, 2,25x con un provider senza costo di scrittura e letture a 0,25x. Il modello non considera messaggi in crescita né token di output.
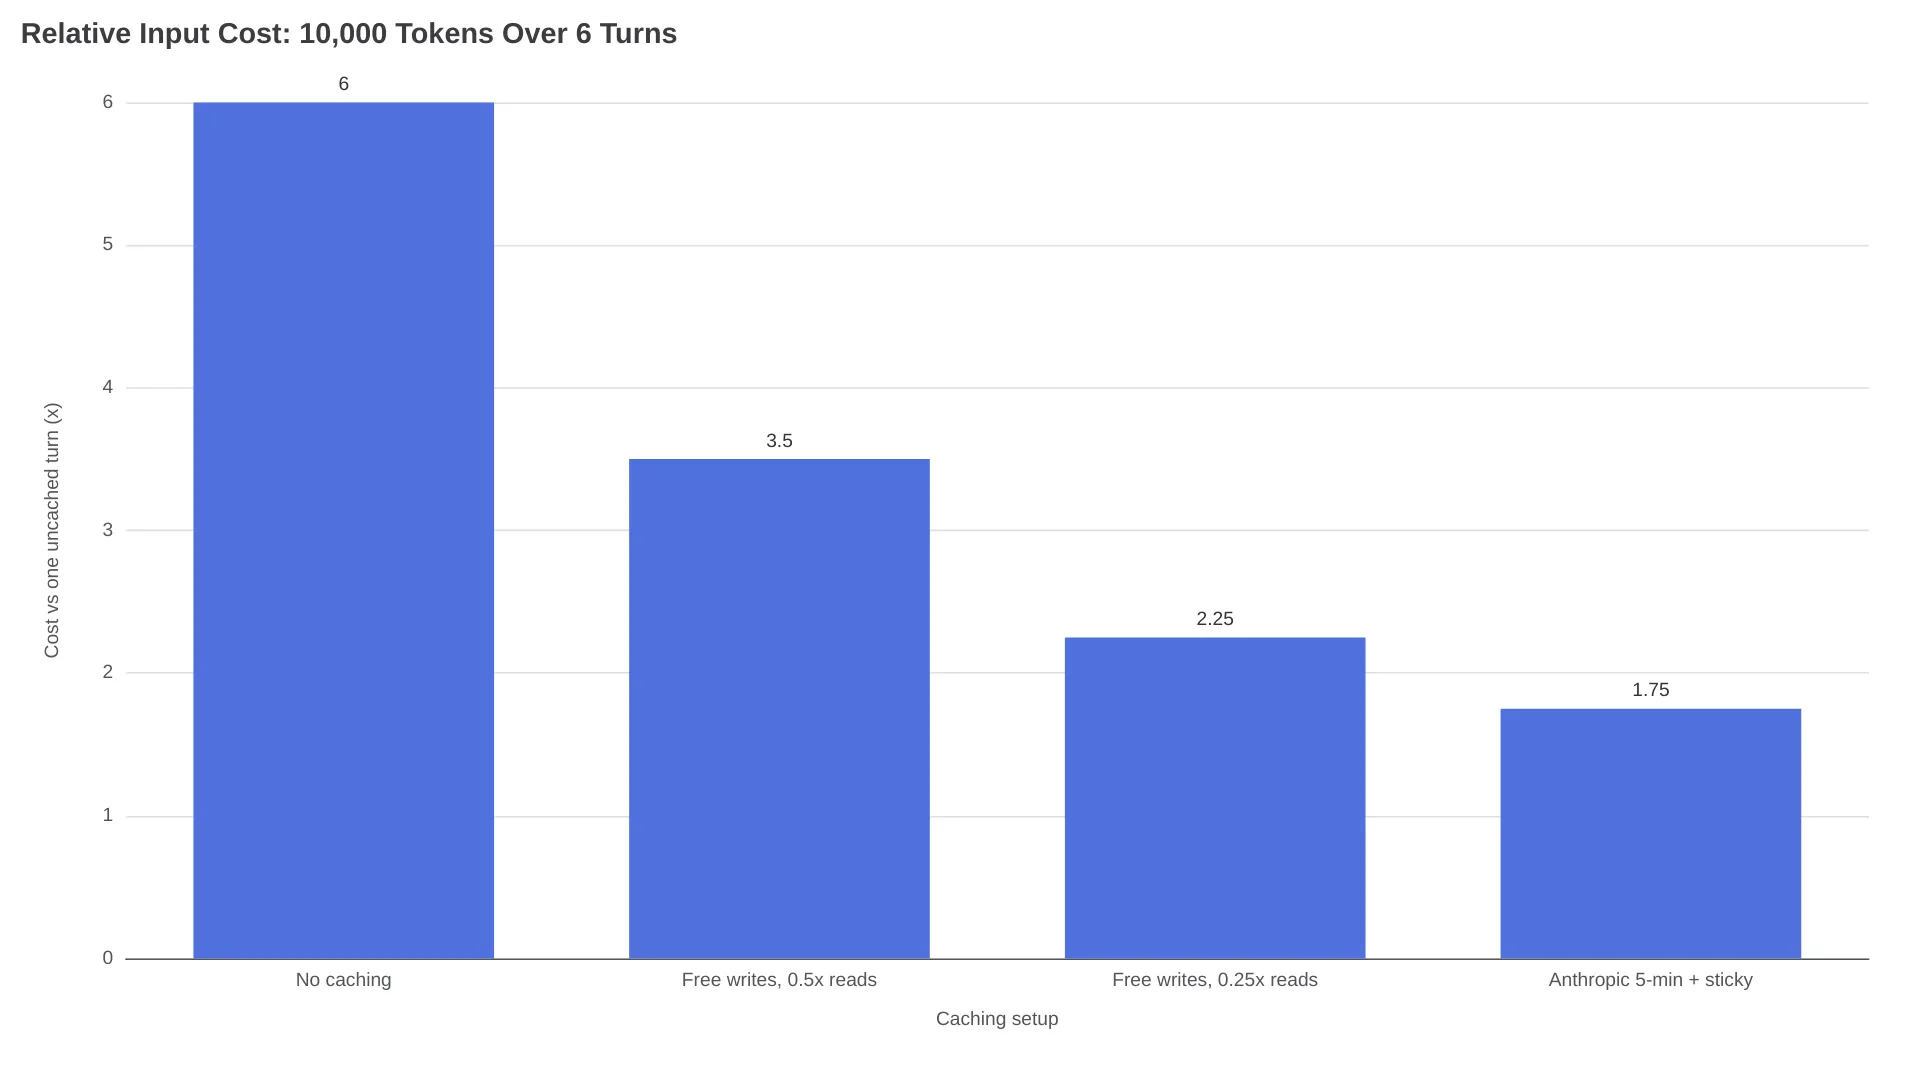
La costosa scrittura Anthropic prevale al sesto turno perché le letture a 0,1x incidono già dal secondo, e il divario aumenta con l'accumularsi dei turni. Lo scenario si ribalta soltanto se il TTL di 5 minuti scade fra un turno e l'altro: si paga di nuovo la scrittura a 1,25x a ogni richiesta, per 7,5x in sei turni, peggio che senza caching. Un provider con scrittura gratuita e input a 1,0x, invece, si limita a eguagliare il 6,0x senza cache.
Prima di fare debug, misurate: tre numeri che confermano un hit
Ogni risposta OpenRouter contiene il verdetto nell'oggetto usage: cached_tokens, cache_write_tokens e cache_discount. Il significato dei campi è documentato nella guida al caching di OpenRouter. Controllarli prima di modificare qualunque parametro permette di distinguere un vero cache miss da una sorpresa di fatturazione. Se cached_tokens è maggiore di zero, la richiesta ha colpito una cache calda; se è zero, non l'ha fatto, indipendentemente da ciò che mostra la dashboard Activity.
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
Quella risposta corrisponde a un hit del 99,8%: 10.318 dei 10.339 token del prompt arrivano dalla cache. cache_write_tokens compare sulla prima richiesta che produce una cache; cache_discount indica quanto è stato risparmiato e può diventare negativo nelle scritture Anthropic, perché il sovrapprezzo di scrittura a 1,25x è un costo reale che le letture successive recuperano. Gli stessi valori sono disponibili nella vista dettagliata della generazione in Activity, come spiega la nostra guida alla dashboard Activity, oppure tramite /api/v1/generation.
I metadati grezzi sono la fonte di verità, non l'interfaccia. Un utente di SillyTavern ha inseguito un problema di cache inesistente finché non ha controllato direttamente i log:
"I metadati raw di OpenRouter dicono chiaramente
native_tokens_cached: 0[e]usage_cache: null." — u/HauntingWeakness
Se quei tre numeri restano a zero giorno dopo giorno, una delle quattro modalità di errore seguenti sta svuotando la cache.
Quattro motivi per cui una cache calda si raffredda
La documentazione di OpenRouter e l'esperienza della community convergono su quattro cause frequenti dei crolli nel tasso di hit: prompt sotto la soglia minima, scadenza del TTL tra i turni, modifica del prefisso e deriva del provider. Ciascuna lascia una traccia riconoscibile nei log e richiede una correzione diversa.
1. Il prompt non raggiunge il minimo previsto dal provider
I provider che supportano il prompt caching applicano una soglia di token specifica per modello: un system prompt di 900 token non verrà mai memorizzato su alcun modello Claude, e aggiungere testo riempitivo è esplicitamente sconsigliato («Non aggiungere testo di riempimento alla richiesta solo per forzarlo», recita il tutorial di OpenRouter). Le soglie variano fino a un fattore quattro nel catalogo:
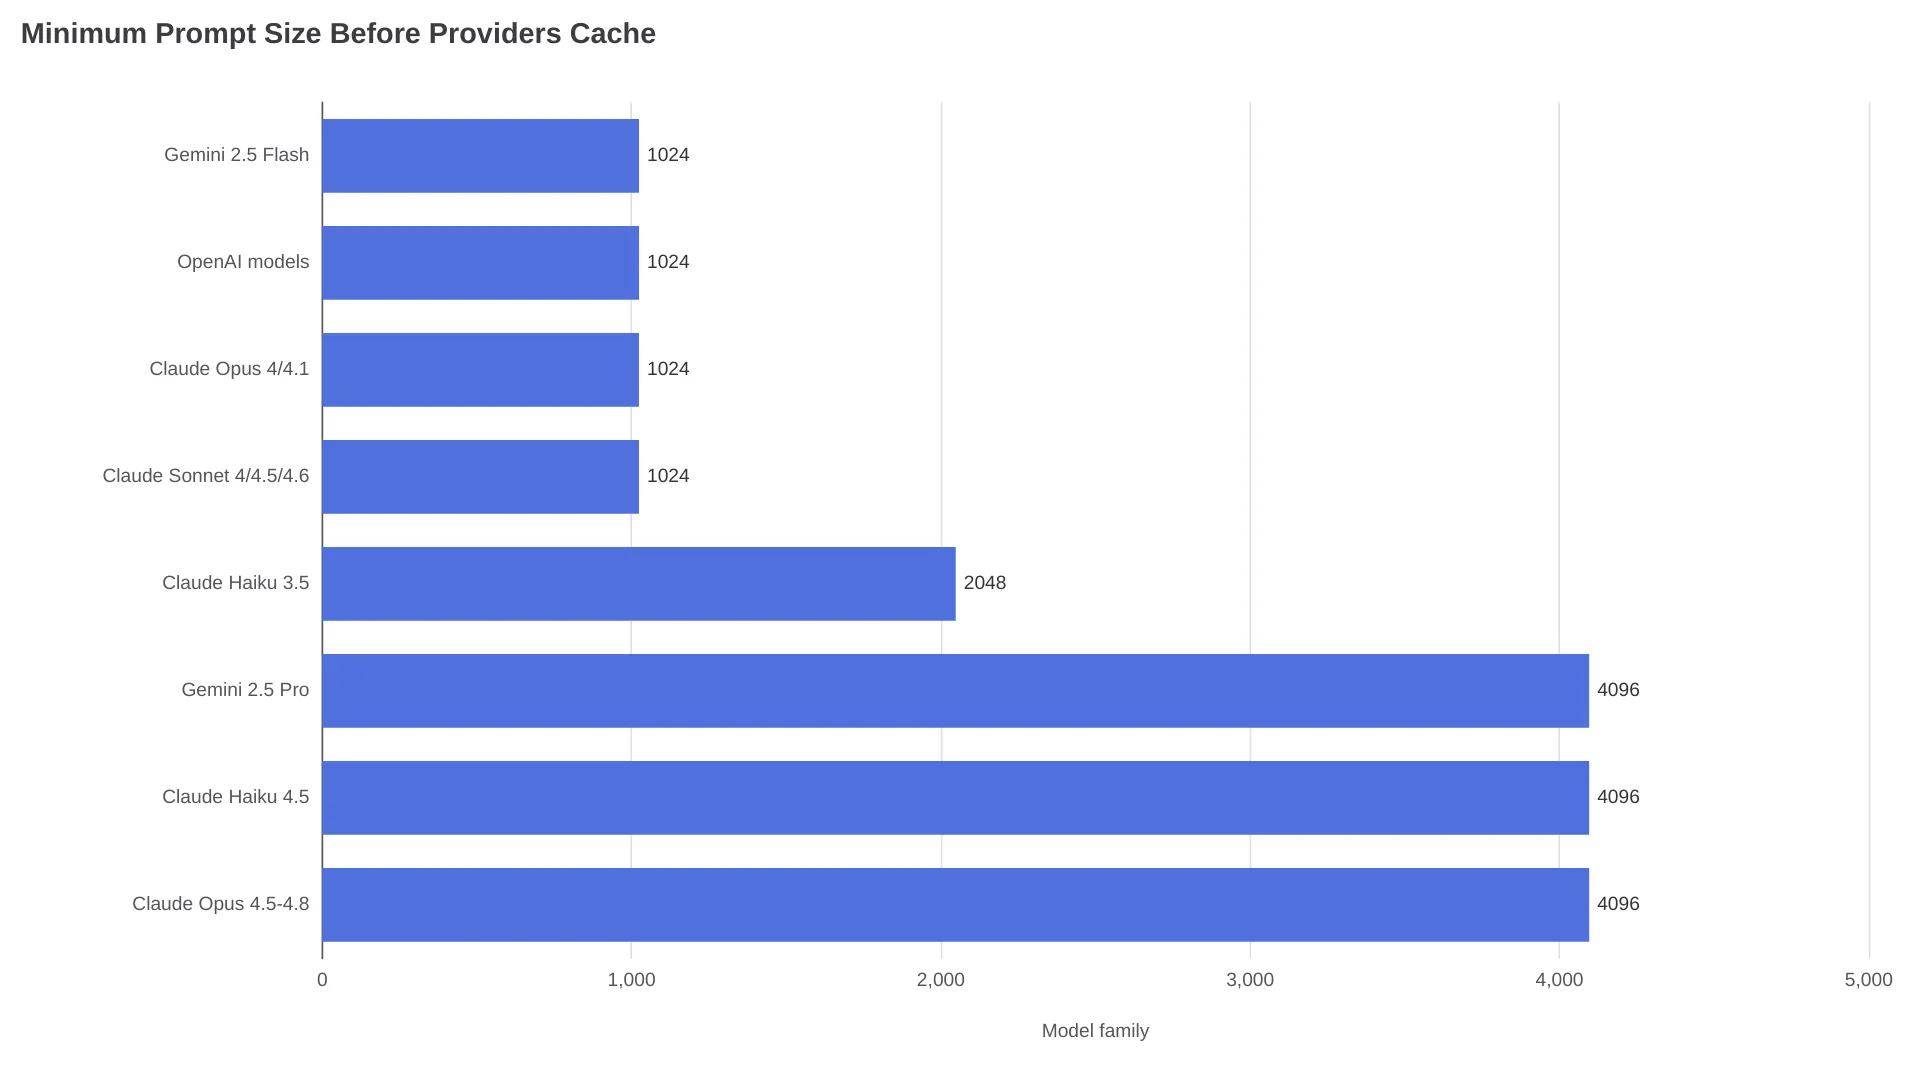
Secondo le note sui provider di OpenRouter, Claude Opus 4.5–4.8 e Haiku 4.5 richiedono 4.096 token prima che qualsiasi contenuto possa entrare in cache; Sonnet 4/4.5/4.6 e Opus 4/4.1 richiedono 1.024; Gemini 2.5 Pro richiede 4.096 token, mentre Gemini 2.5 Flash ne accetta 1.024; i modelli OpenAI memorizzano dalla soglia di 1.024 token. Un carico di lavoro basato su prompt brevi con Opus 4.8 non è strutturalmente memorizzabile: la soluzione è concentrare il materiale statico, come schemi degli strumenti, documenti di riferimento e few-shot, in un unico prefisso, oppure scegliere un modello con soglia più bassa.
2. La cache è scaduta tra un turno e l'altro
La cache predefinita di Anthropic dura 5 minuti; il TTL di 1 ora costa una scrittura a 2x. La cache implicita di Gemini resta disponibile per circa 3–5 minuti e, punto cruciale, le letture non riavviano il timer, secondo il tutorial di OpenRouter. La sessione sticky che mantiene la richiesta sullo stesso provider termina dopo 10 minuti di inattività. I loop agentici che elaborano per 5–6 minuti tra una chiamata e l'altra superano tutte queste finestre:
"OpenRouter è ottimo per testare i modelli. Per gli agenti in produzione è silenziosamente pessimo. Il segreto sporco? Nei carichi di lavoro reali il caching è di fatto zero." — @ran_cohenn, a proposito di intervalli agentici di 5–6 minuti che fanno scadere l'affinità sticky e producono cache miss completi più costose scritture di cache
Il TTL Anthropic da 1 ora con scrittura a 2x è preferibile al ripagare 1,25x ogni cinque minuti, a condizione che la sessione prosegua entro l'ora. Con pause utente di venti minuti, nessun TTL disponibile copre l'intervallo e il caching aiuta soltanto all'interno di una raffica di turni.
3. Il prefisso è cambiato senza che ve ne accorgeste
OpenRouter genera la chiave di conversazione predefinita calcolando l'hash del primo messaggio di sistema e del primo messaggio non di sistema; qualunque modifica all'inizio del prompt invalida la cache da quel punto in avanti. I responsabili ricorrenti sono contesto RAG iniettato prima del system prompt, timestamp o ID richiesta inseriti nel primo messaggio, definizioni degli strumenti riscritte a ogni chiamata e app di chat frontend che inseriscono messaggi a metà cronologia.
"Il tasso di cache miss aumenta se qualcosa all'inizio del prompt cambia continuamente." — u/Exact_Law_6489
A volte il cambiamento arriva da strumenti che non avete scritto voi. «Ho scoperto che Claude Code mi causava problemi di cache hit, credo per come inietta gli strumenti», racconta u/askchris. Gemini aggiunge due insidie: OpenRouter usa soltanto l'ultimo breakpoint cache_control inviato, e considera l'istruzione di sistema come contenuto in cache immutabile. Il materiale dinamico va quindi spostato in un messaggio utente successivo, non aggiunto in coda al system prompt. La correzione è sempre la stessa: prima system prompt statico, schemi degli strumenti e documenti di riferimento; per ultime le variazioni per richiesta.
4. La richiesta è finita su un provider senza cache calda
OpenRouter instrada il traffico su oltre 70 provider (secondo il suo tutorial), e la cache del prompt è locale all'endpoint che l'ha scritta. Lo sticky routing riporta i follow-up al provider con cache calda, ma solo se le sue letture di cache costano meno dell'input normale; inoltre, un provider.order manuale annulla completamente lo stickiness. Anche un errore del provider rilascia il pin.
I dati raccolti dalla community su questo problema sono netti:
- @bruceforai ha misurato lo stesso nome di modello su provider diversi, trovando cache hit rate dal 95,3% fino allo 0%, con prezzi della cache di alcuni provider terzi pari a 10x la tariffa ufficiale.
- @Bryan_1269 ha ottenuto un hit rate molto basso su GLM 5.2 tramite OpenRouter e oltre l'85% con il prompt identico direttamente via Fireworks.
- @miolini, parlando del routing tramite OpenRouter: "il cache hit rate è davvero pessimo, tipo meno dell'1%."
La posizione ufficiale di OpenRouter è che il pin funzioni: «quando un modello o provider vi serve dalla cache, restate fissati a quello fino alla scadenza della cache» (@OpenRouter). È quanto indicano anche i documenti, e suggerisce che il fattore da gestire sia la variabilità dei provider, non il pinning.
Dove inserire cache_control e cosa può rimuoverlo
I modelli Anthropic su OpenRouter supportano due modalità di cache: un unico oggetto cache_control di primo livello, che avanza automaticamente con la crescita della conversazione e che OpenRouter raccomanda per le chat multi-turno; oppure breakpoint espliciti sui singoli blocchi di contenuto, fino a quattro, per materiale fisso voluminoso come schemi degli strumenti, documenti RAG, dump CSV o character card. La forma di primo livello funziona con Anthropic nativo, Vertex, Azure e Bedrock: OpenRouter la traduce in un breakpoint finale perché l'API Bedrock non accetta il campo di primo livello. Per impostare un TTL esplicito servono Chat Completions o l'API Anthropic Messages, non Responses.
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k token di schemi degli strumenti e documenti di riferimento>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
OpenAI funziona diversamente: il caching è automatico da 1.024 token e i marker espliciti prompt_cache_breakpoint esistono solo su GPT-5.6 e versioni successive. Si impostano su un blocco input_text o text, con un TTL minimo di 30 minuti quando ne viene richiesto uno.
OpenRouter traduce fra i vari formati, secondo le note sui provider: un marker Anthropic cache_control diventa un breakpoint OpenAI, un breakpoint OpenAI diventa un marker Anthropic predefinito di 5 minuti e i valori TTL non vengono mai trasferiti. Qwen richiede marker cache_control espliciti, conserva la cache per 5 minuti e li supporta solo su modelli specifici, tra cui qwen3-max, qwen-plus e qwen3-coder-plus; snapshot come qwen3.5-plus-02-15 sono esclusi.
Esiste anche una modalità di errore meno evidente: alcuni client e gateway tra l'applicazione e OpenRouter eliminano i campi non standard prima dell'inoltro:
"Quando l'Anthropic prompt caching scende a zero dietro i gateway, di solito è un bug di marshalling. ... i marker cache_control vengono rimossi silenziosamente prima dell'inoltro a OpenRouter. Non si possono astrarre i provider eliminando le loro estensioni di schema." — @SiddharthInk_
Verificate che il marker arrivi a destinazione: ispezionate i metadati della richiesta raw nel dettaglio della generazione Activity, oppure inviate una richiesta di test con curl, senza componenti intermedi che possano interferire. Uno strumento che appiattisce i messaggi in un unico blob distrugge i breakpoint anche se li avete posizionati correttamente. Il repository di esempi di OpenRouter include sample eseguibili per TypeScript, Vercel AI SDK ed Effect che preservano i marker.
Bloccare il provider con session_id e provider order
Un'identità di sessione stabile è la leva di routing più efficace: session_id fissa le richieste successive al provider che ha gestito la prima richiesta andata a buon fine, prima ancora che venga rilevato un cache hit. Senza, lo stickiness inizia solo dopo il primo hit rilevato e l'identità predefinita, un hash del primo messaggio di sistema più il primo messaggio non di sistema, viene silenziosamente ricalcolata a ogni mutazione del prefisso, ossia la modalità di errore 3. Lo conferma la documentazione sul routing di OpenRouter.
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}
Alcuni dettagli pratici: session_id va nel body della richiesta o nell'header x-session-id; se sono presenti entrambi, prevale il body. Il limite è di 256 caratteri e, se nessuno dei due viene indicato, OpenRouter usa come fallback la chiave prompt_cache_key in stile OpenAI.
Due avvertenze dalla documentazione: gli errori del provider rilasciano il pin, e le righe della Batch API vengono eseguite in modo concorrente e fuori ordine, quindi la scrittura della cache di una riga non è visibile alla successiva. Condividete un prefisso "ttl": "1h" tra i batch o riscaldatelo prima con una richiesta sincrona. La guida ad Auto Router spiega il riutilizzo best-effort del modello risolto da parte di Auto Router.
Se il solo pinning non basta, limitate esplicitamente il set di provider:
"La soluzione che ho trovato è impostare un elenco preferito di provider da usare in ordine di preferenza." — u/nabil9506
Un elenco provider.order di due o tre provider con letture dalla cache economiche sacrifica parte dell'ampiezza del failover in favore della località della cache: uno scambio ragionevole per i carichi di lavoro agentici. u/welcome_to_milliways definisce il carico della configurazione manuale «un difetto piuttosto fondamentale di OR»; che si condivida o meno il giudizio, questo è l'attuale contratto operativo.
Quando il caching tramite router non conviene
Il prompt caching tramite OpenRouter smette di convenire in tre situazioni riconoscibili: prompt che non raggiungono mai la soglia di token del modello, sessioni con pause più lunghe di ogni TTL disponibile e richieste isolate il cui sovrapprezzo di scrittura non viene mai ammortizzato da una lettura scontata. Ce n'è poi una quarta: strumenti che non potete modificare e che rimuovono cache_control prima che raggiunga il router. @grapeot inquadra bene la posta in gioco: quando il caching fallisce a livello di gateway, il divario di costo è di un ordine di grandezza e supera di molto la stessa commissione di routing.
Per carichi di lavoro in cui la cache è critica e nessuna delle correzioni si applica, un singolo upstream fisso è meglio di un router: il comportamento della cache è deterministico e non c'è pinning da gestire. Un endpoint API Claude diretto con il caching nativo di Anthropic è la via d'uscita più lineare quando la deriva del provider non è risolvibile.
Zero Data Retention a livello di account disabilita completamente il response caching; per il prompt caching con ZDR, il riferimento da consultare è l'analisi di OpenRouter sul fatto che il caching implicito costituisca o meno data retention.
L'ordine giusto per risolvere il problema
Fare debug seguendo l'ordine delle misurazioni permette di recuperare gran parte del risparmio con meno modifiche: prima la verifica, poi si procede lungo lo stack dal prompt al routing e infine al TTL.
| # | Azione | Cosa chiarisce |
|---|---|---|
| 1 | Leggere cached_tokens e cache_discount su alcune richieste reali | Problema di hit rate oppure aspettativa di prezzo errata |
| 2 | Confrontare la dimensione del prompt con la soglia di token del modello | Esclude subito il caso «mai memorizzabile in cache» |
| 3 | Congelare il prefisso: system prompt statico, schemi e documenti prima; timestamp e RAG dopo | Elimina la categoria delle invalidazioni silenziose |
| 4 | Passare session_id in ogni richiesta di una conversazione | Pinning del provider dal primo turno, non dopo il primo hit |
| 5 | Impostare provider.order su due o tre provider con letture dalla cache economiche | Elimina la deriva tra provider |
| 6 | Aggiungere "ttl": "1h" (Anthropic) o passare a un provider senza costo di scrittura per le sessioni lunghe | Gestisce la scadenza tra i turni |
I passaggi 1–3 eliminano le classi di errore controllabili dal codice; i passaggi 4–6 riconciliano le segnalazioni sotto l'1% con il dato dell'82,8%. Per approfondire: la guida ai prezzi di OpenRouter per capire come i token in cache finiscono in fattura, la guida ad Auto Router per il comportamento di model pinning e la guida alla dashboard Activity per monitorare il tasso di hit nel tempo.