 AIREITER
Il 17 agosto 2026 OpenRouter ha raccontato un caso difficile da ignorare: un suo modello in anteprima arrivava a costare circa 6,2 mila dollari al mese, quasi 25 volte il costo medio dell'organizzazione. Il 98% della spesa dipendeva da una sola chiave API usata da una pipeline batch. Il dashboard Activity, lanciato proprio quel giorno, serve a far emergere errori di questo tipo in pochi minuti invece che dopo mesi. La parte grafica funziona bene: spesa, token, percentuale di cache hit e dettaglio delle singole richieste sono raccolti nello stesso posto. L'Analytics API, ancora in beta, è più acerba: qui ne analizziamo anche i limiti meno evidenti.
La lezione da 6,2 mila dollari: cosa intercetta il dashboard Activity di OpenRouter
Il caso interno presentato nel post di lancio fotografa esattamente il problema che questi strumenti vogliono prevenire. In un mese, un modello in anteprima ha consumato 6.185 dollari per 250 milioni di token (circa 24,7 dollari per milione di token, con un cache-hit rate del 7,6%). Il dettaglio per chiave API ha poi rivelato che la chiave batch-pipeline ne concentrava 6.067, distribuiti su 127 milioni di token e 37.000 richieste: circa 48 dollari per milione di token per un'attività batch ad alto volume e bassa complessità. La correzione è stata una semplice sostituzione del modello (qui il breakdown completo nel cookbook sul controllo dei costi).
Insieme al dashboard sono arrivati anche la vista Explore per creare query personalizzate, Trends per individuare variazioni, Guardrails per gli eventi legati a prompt injection e dati sensibili, i log a livello di richiesta, la beta Analytics API e la skill openrouter-analytics installabile da GitHub per gli agenti di coding.
Le domande a cui risponde ogni scheda di Activity
Il dashboard Activity di OpenRouter è organizzato attorno alle domande da risolvere, non a una serie di menu. Le tre schede principali coprono quasi tutto il lavoro sui costi, ma ognuna ha uno scopo diverso.
Overview: quanto abbiamo speso?
Overview mette subito in evidenza cinque metriche: spesa totale, numero di richieste, volume di token, cache-hit rate e costo medio per milione di token. Ognuna include uno sparkline e il confronto con il periodo precedente. Più sotto trovi i principali utenti e le app, la spesa per modello, la ripartizione tra crediti OpenRouter e spesa BYOK stimata, oltre al conteggio dei token di prompt e completamento. È la scheda da tenere aperta quando serve capire semplicemente a quanto ammonta il conto.
Trends: cosa è cambiato rispetto al periodo precedente?
Trends ordina le variazioni, non i valori assoluti, considerando modelli, utenti, chiavi API e app. È pensata per scoprire un agente che ha iniziato a spendere troppo, un modello diventato improvvisamente popolare o uno strumento interno passato da esperimento a impostazione predefinita. Overview segnala ciò che costa; Trends mostra cosa ha iniziato a costare.
Explore: come posso analizzare i dati a modo mio?
Explore è il generatore di query. Tra le metriche disponibili ci sono spesa, richieste, diverse categorie di token, cache-hit rate, costo medio per milione di token, spesa BYOK rispetto ai crediti, oltre a latenza P50/P90/P99 e throughput.
Si possono usare al massimo due dimensioni per volta, scegliendole tra modello, provider, chiave API, app, utente, workspace, paese, regione, lunghezza del contesto, sessione, generazione, ID personalizzati e classificatori. Gli intervalli temporali vanno dal minuto al mese; i grafici possono essere a barre, a linee o a punti; ogni grafico può essere salvato privatamente oppure condiviso con tutta l'organizzazione. Due avvertenze: una terza dimensione viene rifiutata senza mezzi termini e nei log il contenuto di prompt e completamenti compare solo se il logging privato di input/output era stato attivato prima dell'esecuzione della richiesta.
Esportare in CSV o PDF senza passare dall'API
Per contabili e fogli di calcolo l'API non è necessaria. La pagina Activity permette di esportare gli stessi dati aggregati in report riepilogativi o dettagliati, in due formati e senza scrivere codice. La procedura ufficiale per l'esportazione prevede cinque passaggi:
- Apri la pagina Activity.
- Scegli il periodo e un raggruppamento (modello, chiave API o autore).
- Apri il menu delle opzioni nell'angolo in alto a destra.
- Seleziona Esporta in….
- Scegli CSV o PDF.
L'esportazione predefinita è un riepilogo con spesa, token e richieste. Per ottenere un report dettagliato, apri prima una scheda metrica specifica e poi avvia l'esportazione: in questo caso il dato viene suddiviso secondo il raggruppamento scelto. Il periodo selezionato determina automaticamente l'intervallo secondario:
| Filtro temporale | Intervallo secondario |
|---|---|
| 1 ora | al minuto |
| 1 giorno | all'ora |
| 1 mese | al giorno |
| 1 anno | al mese |
La documentazione mette in chiaro anche due dettagli. Nei report la spesa BYOK è una stima basata sulle tariffe di mercato dei provider e può quindi non coincidere con la fattura esterna effettiva, perché non considera gli sconti specifici del provider. I token di ragionamento vengono addebitati all'interno dei token di completamento, ma sono riportati separatamente: la quota destinata al “pensiero” resta visibile senza essere conteggiata due volte.
La prima query all'Analytics API in cinque minuti
L'Analytics API espone gli stessi dati elaborati da Explore, attraverso due endpoint. È dichiaratamente in beta: prima di lanciare query conviene quindi verificare cosa supporta davvero.
La barriera della management key
Gli endpoint Analytics richiedono una management key; con una normale chiave di inferenza si riceve HTTP 403. Vale anche il contrario, come spiega il cookbook sul controllo dei costi: le management key non possono effettuare richieste ai modelli. Questo riduce il danno potenziale in caso di fuga della chiave, anche se chiunque la possieda può comunque vedere il dettaglio completo della spesa dell'organizzazione. Il consiglio del cookbook è diretto: trattala come qualsiasi altra credenziale.
Prima i metadati, poi la query
GET /api/v1/analytics/meta restituisce metriche, dimensioni, operatori di filtro e granularità attualmente supportati. È bene interrogarlo prima di ogni esecuzione automatizzata, perché il supporto può cambiare durante la beta. L'endpoint per le query vere e proprie è POST /api/v1/analytics/query. Questo è l'esempio cURL riportato nella documentazione:
curl -X POST https://openrouter.ai/api/v1/analytics/query \
  -H "Authorization: Bearer <management-key>" \
  -H "Content-Type: application/json" \
  -d '{
    "metrics": ["request_count"],
    "dimensions": ["model"],
    "granularity": "day",
    "limit": 100,
    "time_range": {
      "start": "2026-08-01T00:00:00Z",
      "end": "2026-08-08T00:00:00Z"
    }
  }'
Nelle risposte, le righe sono annidate sotto data.data e accompagnate da un blocco metadata con query_time_ms, row_count e truncated. Il cookbook documenta query d'esempio completate in 17 ms per una singola riga: sono quindi chiamate leggere, descritte come di sola lettura e gratuite oltre ai normali costi d'uso. Gli errori documentati sono 400 (query non valida), 401 (autenticazione assente), 403 (tipo di chiave errato), 408 e 500.
Quattro query per scovare la spesa anomala
Il cookbook ufficiale propone cinque ricette. Riordinate come percorso operativo, diventano una procedura efficace per cercare dove finiscono i soldi.
1. Quale modello consuma di più? La prima query del cookbook richiede total_usage, request_count, tokens_total e cache_hit_rate, raggruppati per model e ordinati per spesa:
{
  "metrics": ["total_usage", "request_count", "tokens_total", "cache_hit_rate"],
  "dimensions": ["model"],
  "order_by": { "metric": "total_usage", "direction": "desc" },
  "limit": 10,
  "time_range": { "start": "2026-07-01T00:00:00Z", "end": "2026-08-01T00:00:00Z" }
}
Il dato derivato più utile è il costo effettivo per milione di token: total_usage / tokens_total × 1e6. Confrontalo con la tariffa media, calcolata con la stessa formula ma senza dimensioni. L'euristica del cookbook è chiara: un modello che costa un multiplo elevato della media è il candidato più probabile da indagare. È così che è emersa l'anomalia del modello in anteprima, arrivata a 25 volte la tariffa media.
2. Quale chiave API è responsabile? Aggiungi un filtro sullo slug esatto del modello e raggruppa per api_key_id. Nei risultati gli ID vengono associati a etichette leggibili, ed è così che batch-pipeline è comparsa con 6.067 dollari dei 6.185 del problema. Conviene raggruppare per api_key_id, invece di filtrare per il nome risolto della chiave, e usare il campo user_email restituito per confrontare la spesa con i registri interni.
3. In cosa si è trasformata concretamente la spesa? Suddividi la spesa giornaliera nelle sue componenti:
| Metrica | Significato |
|---|---|
usage_upstream | costo grezzo dell'inferenza |
usage_cache | risparmio della cache (o costo di scrittura nella cache) |
usage_data | sconti, generalmente negativi |
usage_web | sovrapprezzo per la ricerca sul web |
usage_file | sovrapprezzo per l'elaborazione dei file |
Un rapporto prompt/completamento vicino a 20:1 segnala un contesto sovradimensionato, mentre una quota elevata di token di ragionamento indica che stai pagando capacità di elaborazione forse non necessarie. Il traffico più promettente per la cache è quello dominato dai prompt e con un cache-hit rate basso; se il tasso è già alto, è meglio esaminare il mix di modelli. I prompt lunghi sono la norma, non un'eccezione: un'analisi dei dati pubblici di OpenRouter nella categoria programmazione ha rilevato che il 93,4% di quei token era costituito da input.
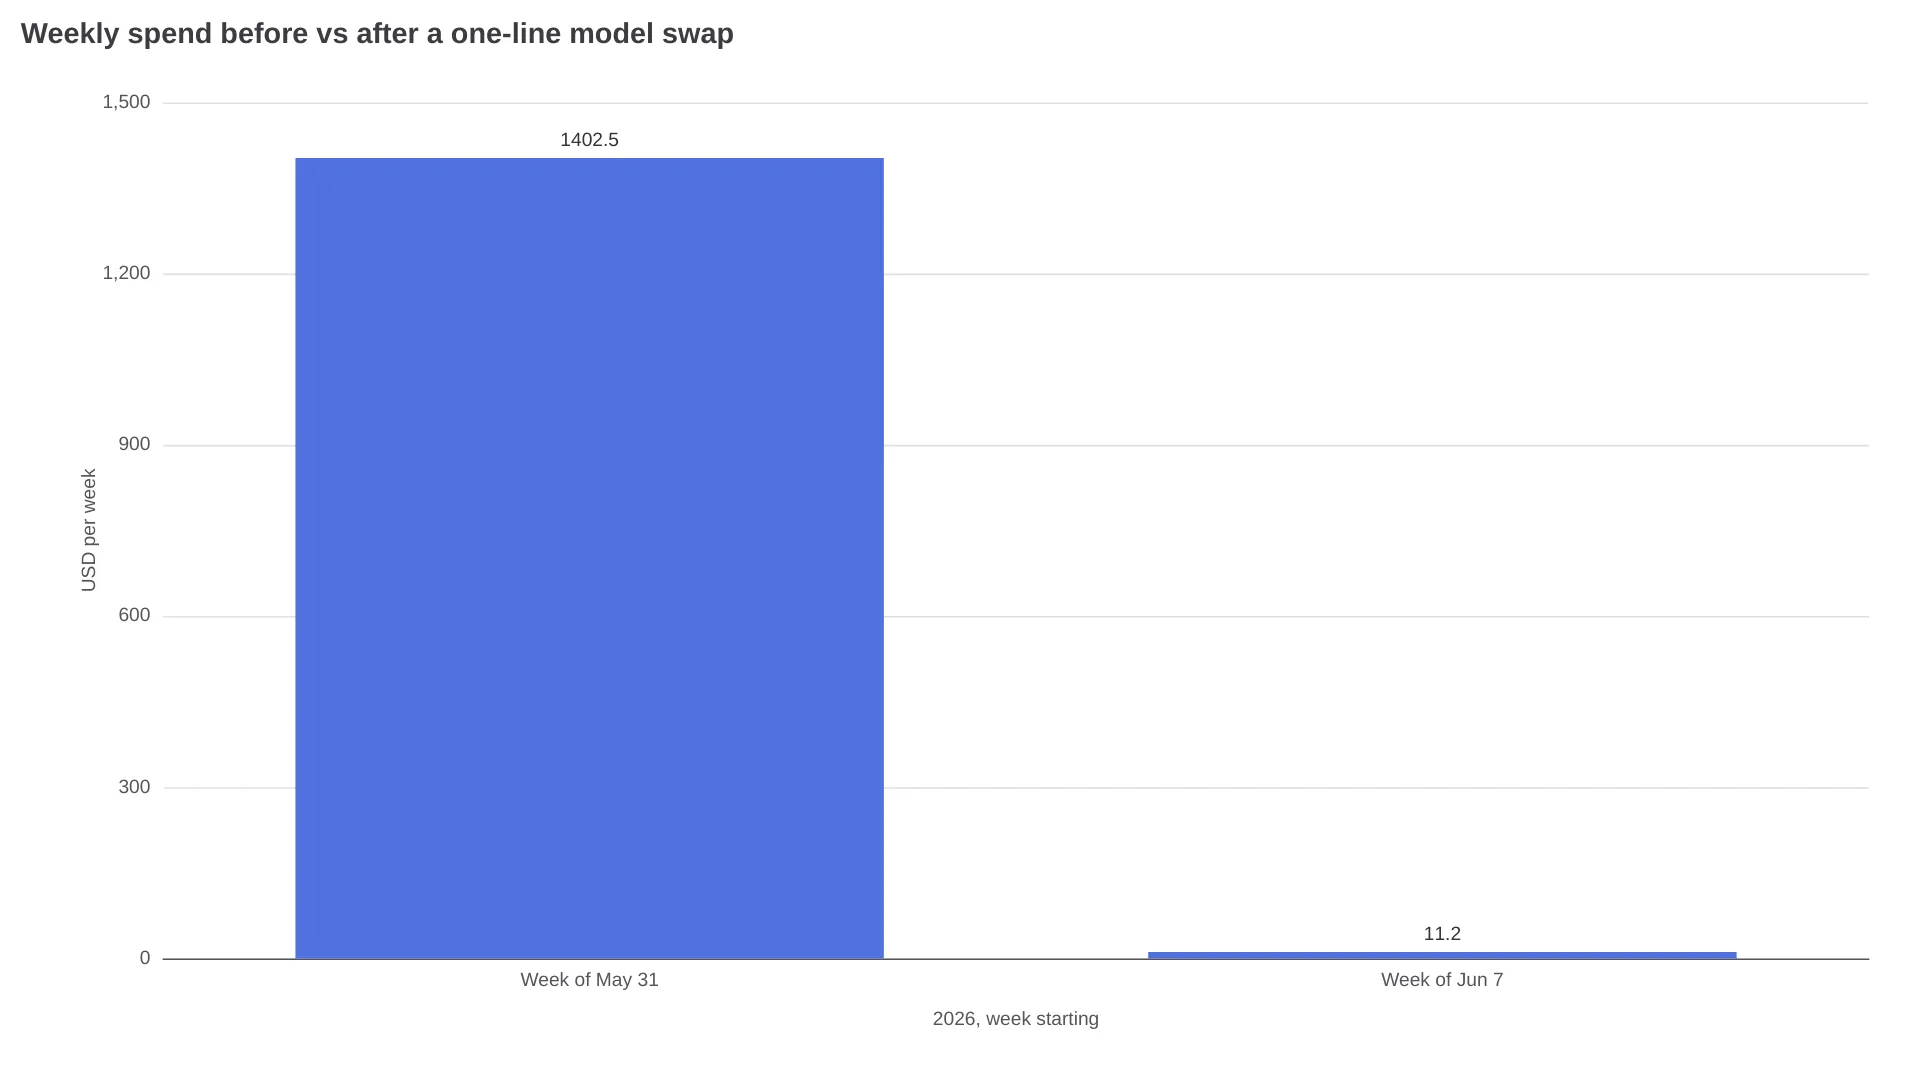
4. La correzione ha funzionato davvero? Ripeti la query 1 come serie temporale settimanale, raggruppando per api_key_id. Nell'esempio ufficiale, la chiave batch-pipeline passa da 1.402,50 dollari nella settimana del 31 maggio a 11,20 dollari nella settimana del 7 giugno. Quando il modello viene sostituito correttamente, il grafico mostra un precipizio, non una discesa graduale.
Se dopo la prima query la soluzione è passare a un modello più economico, la decisione si concretizza nel livello di routing di OpenRouter. Per i compromessi tra routing automatico e routing fissato rimandiamo alla nostra guida all'auto router di OpenRouter.
Sei insidie della beta che la documentazione non evidenzia
L'API funziona come previsto una volta costruita una query corretta. I problemi qui sotto sono comunque documentati, solo dispersi tra le note a margine del cookbook.
- Tre dimensioni restituiscono 400. Il limite è due; per
model × key × dayservono più query oppure una diversa granularità temporale. group_limitpuò troncare silenziosamente i segmenti temporali. Se lo lasci vuoto, OpenRouter calcola automaticamente un valore sicuro; se lo imposti troppo basso, alcune settimane spariscono dalle serie temporali. Senza dimensioni, il parametro viene ignorato del tutto.- Le metriche di conteggio a volte arrivano come stringhe. La documentazione mostra numeri, ma l'API può restituire stringhe: il parser deve gestire entrambi i casi.
- I nomi delle colonne delle serie temporali sono ambigui. Lo stesso intervallo può comparire come
date__dayoppurecreated_at__day, a seconda della struttura della query. - Le componenti di costo inutilizzate restituiscono
null, non zero. Qualsiasi script di aggregazione deve prevedere il controllo dei valori nulli. metadata.truncated: trueindica che i totali sono parziali. Aumentalimit(il valore predefinito è 1.000), oppure restringi l'intervallo temporale e ripeti la query.
Dashboard, API o una pipeline personalizzata?
Gli strumenti nativi coprono le domande relative al singolo account. Il self-hosting ha senso solo quando si va oltre quel perimetro:
| Ti serve… | Usa |
|---|---|
| Una panoramica su spesa, token e cache rate | Activity Overview |
| Capire cosa è cambiato e cosa sta crescendo | Trends |
| Analisi occasionali e condivisione | Explore + esportazione CSV/PDF |
| Report programmati, avvisi e dashboard interne | Analytics API |
| Aggregazione tra più provider, budget per utente e rilevamento personalizzato delle anomalie | Una pipeline personalizzata basata su log d'uso e webhook |
La strada del self-hosting è già ben battuta. Come racconta un utente di r/FinOps:
"Ho costruito il mio tracker dei costi AI in Obsidian perché il prezzo di un modello è passato da pochi centesimi a 3 € in una notte."
Quel thread e la discussione su r/openrouter intitolata "I prezzi per i contesti lunghi dovrebbero essere più trasparenti" partono dallo stesso problema: le stime locali si allontanano dagli importi fatturati a causa di routing, caching, token di ragionamento e prezzi per i contesti lunghi. Il dato registrato dal dashboard Activity è quello autorevole; se scegli il self-hosting, usalo per riconciliare i conti invece della tua tabella prezzi.
Un metodo più leggero per attribuire i costi, suggerito da un builder con sei mesi di esperienza sulla piattaforma, consiste nell'aggiungere agli header delle richieste X-Title, così ogni app o esperimento compare in Activity con il proprio nome. Se invece la spesa è già distribuita tra più provider e non concentrata su un singolo router, una configurazione con API unificata (tra cui AIReiter) risolve il problema dell'aggregazione prima ancora che si presenti.
FAQ
Serve una management key per il dashboard Activity?
No. Il dashboard è disponibile nell'interfaccia web con il normale accesso all'account; la management key serve solo per gli endpoint dell'Analytics API (/api/v1/analytics/meta e /api/v1/analytics/query).
L'OpenRouter Analytics API è gratuita?
Il cookbook descrive il flusso Analytics come di sola lettura e gratuito: stai interrogando i tuoi dati d'uso, non pagando ogni chiamata. L'inferenza a cui quei dati si riferiscono continua naturalmente ad avere un costo.
Quanto è storico il dato sulle attività di OpenRouter?
Il precedente /api/v1/activity endpoint copre i 30 giorni UTC completati precedenti. La documentazione della nuova Analytics API non indica un limite di conservazione (gli esempi coprono un mese), quindi la disponibilità dello storico su periodi più lunghi resta non verificata: per i dati da conservare, esporta i CSV.
Perché nei log di Activity non vedo prompt e risposte?
Il dettaglio di prompt e completamento esiste solo per le richieste con logging privato di input/output attivato al momento dell'invio — l'annuncio lo dice esplicitamente: senza questa impostazione, il contenuto storico dei prompt non è disponibile. I totali vengono registrati, il contenuto è facoltativo.
Il compromesso da considerare nel prezzo
Tutto ciò che abbiamo visto è già utilizzabile e la sola query 1 è sufficiente a giustificare una configurazione di cinque minuti. Il rischio aperto è la deriva dello schema: si tratta di una beta dichiarata, quindi metriche e dimensioni supportate possono cambiare. La stessa OpenRouter raccomanda alle automazioni di rileggere /meta prima di dare per valido lo schema. Inserisci un controllo sui metadati nei cron job invece di fissare a mano i nomi dei campi: la visibilità del dashboard resterà affidabile anche mentre l'API è ancora in crescita.
Approfondimenti: guida all'auto router di OpenRouter · I migliori modelli OpenRouter gratuiti per programmare · Guida ai prezzi di OpenRouter