托管环境的图表显示速度可达每秒 280 个 token,但在笔记本上实际运行时,速度会根据硬件和运行时环境落在 8-220 tok/s 之间。Inkling 2 Mini 是一款适合离线编码代理的开源权重模型,参数规模为 26.4B,模型文件约 20GB。不过,在下载之前,你需要先了解它在聊天、事实准确性和 API 可用性方面的不足。
谁适合用 Inkling 2 Mini,谁最好绕开它
Inkling 2 Mini 有一类任务表现出色,也有几类任务并不擅长。因此,比起先看跑分,更应该先看自己的工作负载。带工具和搜索的离线编码辅助是它的主场;以聊天为主,或者只能通过 API 使用的场景,则不太适合。
| 你的工作负载 | 对 Mini 的判断 |
|---|---|
| 在 32GB 以上的 Mac 或 DGX Spark 上运行离线编码代理 | 非常合适:目前最好的成绩都来自这里 |
| 私有长上下文任务(名义上最高 1M tokens) | 值得测试:实际使用建议从 32K 上下文开始 |
| 多轮聊天或严格遵循指令 | 不建议:Qwen3.8-27B 在这里的表现更好 |
| 现在就使用托管 API | 不建议:还没有无服务器服务列表,目前只有采样和微调价格 |
下面的评测会展开这些差异背后的数据:循环结构改变了什么,哪些跑分经得起推敲,本地运行到底有多快,以及这个价格究竟买到了什么。
Inkling 2 Mini 是什么,循环结构如何工作
Thinking Machines Lab 于 2026 年 11 月 20 日发布了 Inkling 2 Mini,采用 Apache 2.0 开源权重。模型权重托管在 Hugging Face,名称为 thinkingmachines/Inkling-2-Mini。它支持文本和图像输入、文本输出,标称最大上下文为 1-million-token。
| 规格 | Inkling 2 Mini |
|---|---|
| 发布时间 | 2026 年 11 月 20 日,Thinking Machines Lab |
| 许可证 | Apache 2.0 |
| 参数 | 总计 26.4B / 每个 token 激活 3.4B / 循环后的有效参数量 5.4B |
| 层数 | 存储 24 层;中间 12 层每个 token 运行 3 次(6 + 3x12 + 6 = 48 次应用) |
| MoE 路由 | 每层每个 token 从 128 个专家中选择 8 个 |
| 精度 | 20 层使用 NVFP4,最后 4 层使用 MXFP8;模型文件约 20GB(19.5GB + 0.64GB predictor) |
| 上下文 / 模态 | 最高 1M tokens;输入文本 + 图像,输出文本 |
| 本地运行目标 | 通过 Ollama 在内存 32GB 以上的 Mac 上运行,或按照模型卡的说明使用一台 NVIDIA DGX Spark |
3.4B 指的是存储状态下的激活参数;把三次循环计算也算进去后,有效计算量约为 5.4B。权重重复使用让模型文件保持紧凑,但也增加了每个 token 的计算量,具体原理见 Hugging Face 的技术解析。
循环增加的是计算量,而不是模型存储的知识。发布公告称,与更大的 Inkling 模型相比,Mini 在事实回忆方面更弱,因为知识量主要取决于总参数规模。这也是搜索和工具对它格外重要的原因。
哪些跑分值得参考,哪些应该打个折扣
以下成绩全部来自实验室通过 Hugging Face 模型卡公布的自有测试工具。Mini 在工具驱动的编码和搜索任务上占优,但在推理、视觉和聊天纪律性方面持平或落后。
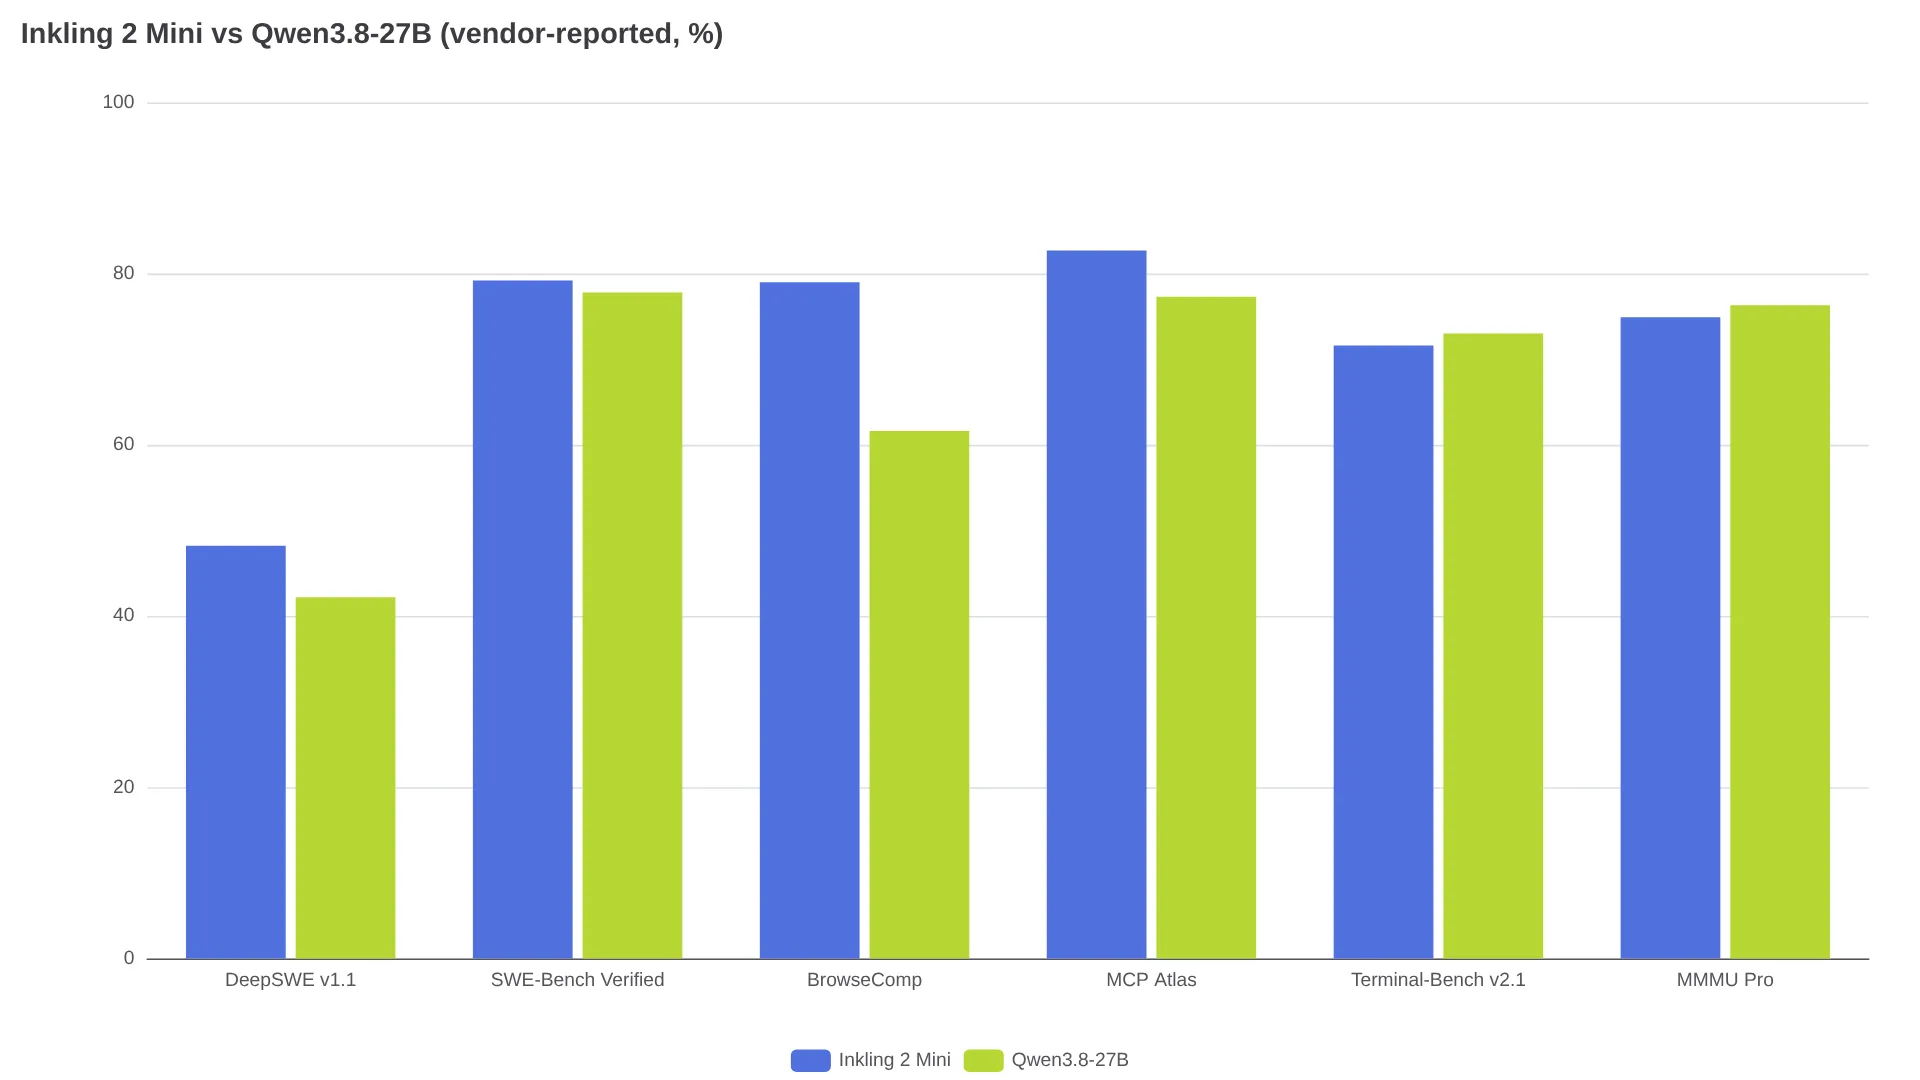
Mini 在 DeepSWE v1.1 中取得 48.2%,高于 Qwen3.8-27B 的 42.2%;SWE-Bench Verified 中为 79.2%,高于 77.8%;BrowseComp 中为 79.0%,高于 61.6%;MCP Atlas 中为 82.7%,高于 77.3%。Artificial Analysis 的 Intelligence Index 给两款模型的评分都是 20.1,但 Mini 完成该指数任务只用了 9.0 分钟,Qwen 则用了 38.2 分钟。ARC Prize 报告显示,在最高推理设置下,Mini 在 ARC-AGI-1 和 ARC-AGI-2 上分别取得 84.5% 和 49.3%。
但根据同一份模型卡,Mini 在另一半测试中落后:HLE-Diamond 为 15.2% 对 15.3%,MMMU Pro 为 74.9% 对 76.3%,Terminal-Bench v2.1 为 71.6% 对 73.0%。事实准确性差距更明显:AA-Omniscience 非幻觉率为 63.4%,Qwen 则为 71.4%。ComplexConstraints(33.4%)和 MultiChallenge(50.0%)同样落后于 Qwen。
本地运行的速度,不能只看一个数字
官方 Ollama 页面和模型卡给出的目标设备是 32GB Mac 或 DGX Spark,但早期对循环模型的支持并不成熟,实际速度差异很大。托管环境的吞吐量(Artificial Analysis 测得 280 tok/s)并不能很好地预测笔记本上的表现。
| 配置 | 报告速度 | 来源 |
|---|---|---|
| 托管环境评测(Artificial Analysis) | 280 tok/s | 第三方测量 |
| RTX 4090,打过补丁的 vLLM + FP8/NVFP4 + drafter | 约 190-220 tok/s | Reddit 用户,打补丁后(基线为 117) |
| M5 Max MacBook Pro | 约 125 tok/s | @alexocheema |
| M1 Max MacBook Pro 64GB,4-bit 量化 | 约 20 tok/s | Hacker News 用户 gregsadetsky,经由 eesel 的发布评测引用 |
| 早期 llama.cpp 构建版本,各类硬件 | 约 5-10 tok/s | r/LocalLLM 讨论串 |
“甚至没法让它跑到 5 t/s。”——u/KURD_1_STAN,r/LocalLLM 对比讨论串
运行时支持和量化方式解释了很大一部分速度差异:当前构建版本对循环层的处理比首发当天的版本更好,而量化方案会改变模型占用空间。根据 Unsloth 指南(由 Crewmark 转述),推荐的 4-bit 版本约占 17.6GB,另加一个 639MB 的视觉投影器;上下文变长后还会进一步增加 KV cache 的内存压力。
在一次延迟相同的支付匹配测试中,Qwen 的准确率为 98.2%,没有错误匹配;Mini 的准确率为 96.9%,出现了 5 个错误匹配:
“我们在真实的支付匹配工作负载上测试了 Inkling 2 Mini 和 Qwen3.8-27B……Qwen:98.2% 准确率,0 个错误匹配……Inkling:96.9%,5 个错误匹配……这个任务还是用 Qwen。”——@exebat3(原帖)
实际使用时,建议从 32K 上下文开始;如果遇到内存压力就调低,并在评价模型质量之前确认运行时构建版本支持循环层。
没有结算按钮的价格
根据 Artificial Analysis 模型页面引用的 Tinker 价格,输入 token 为每百万 0.15 美元,缓存输入为 0.015 美元,输出为 0.50 美元;微调价格则为 0.75 美元(64K)和 1.50 美元(256K)。按照实测 token 用量计算,完成一次指数任务的成本为 0.59 美元,而 Qwen3.8-27B 为 3.53 美元。
0.59 美元只是估算值,并不是现在可以直接购买的托管价格。在评测时,Mini 还没有出现在任何无服务器推理服务列表中;eesel 的评测也记录了对 Tinker 和 OpenRouter 的核查结果。另一个问题是,Mini 在指数测试中生成了 161M 个输出 token,而中位数为 85.7M,因此单价优势会被更高的输出量抵消一部分。如果选择自托管,最好把硬件、电费和部署成本,与托管版 Qwen 或前沿模型 API 放在一起比较。
决定成败的两个设置
推理强度从 none(0.0)到 minimal(0.1)、low(0.2)、medium(0.7)、high(0.9,默认值),再到 xhigh/max(0.99)。根据模型卡,设为最低值也不能完全关闭推理。
推理强度调低反而可能更好:在 r/LocalLLM 的 Terminal-Bench 讨论中,一位用户在 13 个任务的子集上使用 low 强度得分 10/13,而 medium 强度多次超时。另一方面,eesel 评测引用的一位 Hacker News 测试者表示,在不使用工具时,模型消耗了 19,200 个思考 token 仍未完成任务;开启搜索后虽然给出了方案,但使用了错误的 hook 名称。
请限制输出 token 数和代理回合数,对文件系统访问进行沙箱隔离,并要求人工审核后再投入生产环境。模型卡提醒,模型可能在没有确认的情况下执行破坏性操作,也可能陷入推理循环,尤其是在调试代码时。
下载前必须接受的取舍
Mini 通过重复使用中间层,在不增大模型文件的情况下获得更多计算量;实验室还发布了一个可变循环研究检查点,用于研究这种行为(见技术解析)。它的失败模式也相当具体:调试时陷入循环、用户报告的回复中途切换成日语,以及需要严格约束的工具调用。如果你的目标是带防护措施的离线编码,可以下载;如果你需要稳妥的聊天体验或一键可用的 API,则建议等待。
常见问题
Inkling 2 Mini 能在笔记本上运行吗?
可以,但需要合适的构建版本:通过 Ollama 或当前版本的 llama.cpp,在内存 32GB 以上的 Apple 芯片 Mac 上运行;最好使用 4-bit 版本(约 17.6GB,另加投影器)。老款 M1 Max 的预期速度约为 20 tok/s,M5 硬件则可达到 100+ tok/s;未经补丁处理的运行时可能只有个位数速度(见上表)。
Inkling 2 Mini 比 Qwen3.8-27B 更好吗?
对于编码代理,是;对于聊天,不是。看上面的图表:Mini 在 DeepSWE、SWE-Bench Verified、BrowseComp 和 MCP Atlas 中领先;Qwen 则在 Terminal-Bench v2.1、MMMU Pro、事实准确性和受约束指令方面领先。所有数据均为厂商通过模型卡公布的成绩。
为什么资料里既有 3.4B,也有 5.4B 激活参数?
3.4B 是存储状态下的激活参数量;5.4B 则是在此基础上加上三次循环,每次约 1.0B。评估计算量时使用 5.4B,评估内存占用时使用 3.4B。
现在可以通过托管 API 调用 Inkling 2 Mini 吗?
不可以。在评测时,还没有第一方无服务器端点。根据 eesel 的核查,Tinker 提供采样和微调价格,但没有 Mini 的无服务器服务列表。你可以本地运行 Hugging Face 权重,或者等待托管平台支持。
如何阻止推理循环?
按照模型卡的建议,先尝试 low(0.2)强度,同时限制输出 token 数和代理回合数,并对工具进行沙箱隔离。
相关文章:阅读 Inkling 2 Small 评测与 API 价格,了解 Mini 的 594B 兄弟模型;阅读 2026 年最佳编码代理 LLM,看看 Mini 在各类代理模型中的位置;阅读 llama.cpp v1.0 指南,了解 Mini 在本地运行所依赖的运行时。