如果你的项目建立在 browser-use 0.x 之上,升级到 1.0 后,架构和默认配置都会发生变化:原来的 24 个浏览器操作被一个持久化 Python REPL 取代,而 Browser() 现在代表云端浏览器。本指南依据 1.0.7 的发布说明、MIGRATING.md以及 11 月 20 日发布的工程文章,带你完成版本固定、首次运行和 0.x 迁移。
5 分钟跑通 1.0
先固定版本。1.0.0 于 2026 年 11 月 10 日发布;截至 11 月 20 日,1.0.7 已是稳定标签,1.0.8rc1 则处于预发布阶段(发布页)。README 明确提醒:不要使用 >=,因为不同次版本之间可能存在 API 破坏性变更。
uv add 'browser-use==1.0.7'
# or
pip install 'browser-use==1.0.7'
环境要求很明确:Python 3.11 或更高版本,且低于 4.0(README、PyPI)。所有依赖都使用 == 固定版本,有利于复现环境,但如果你的应用还需要其他版本的 pydantic、mcp 或 google-genai,就可能发生冲突。
先完成一次认证。在 cloud.browser-use.com 创建密钥,然后导出环境变量,或运行登录助手:
export BROWSER_USE_API_KEY=bu_...
# or
browser-use login
登录信息会保存到 ~/.config/browser-harness/auth.json,CLI、MCP server 和 browser-harness 共用这份凭据(MIGRATING.md)。在容器中使用 BROWSER_USE_AUTO_LOGIN=true;在 SSH 或无头环境下,1.0.8 候选版本会输出一个链接和审批码,你可以在另一台设备上完成确认(1.0.8rc1 说明)。
首次运行只需三行:
from browser_use import Agent

result = Agent(
    "Find the number of stars of the browser-use repo"
).run_sync()

print(result.final_result())
不过,这段代码默认会产生费用:它使用 Browser Use Cloud 浏览器和默认网关模型(README 路径 1 / 路径 3、MIGRATING.md 默认配置)。如果只是想零成本测试云端功能,请一开始就传入 Browser('chromium') 和你自己的 llm。
取代 24 个操作的到底是什么
browser-use 0.x 给模型的是一份操作菜单:每一步都从 DOM 快照中选择一个动作。1.0 直接取消了这份菜单,改为提供一个主要的 python 工具——一个持久化 REPL,其中预先导入了 browser-harness 辅助函数和原生 cdp(),底层基于 Pydantic AI(工程文章):
async def python(ctx: RunContext[Session], code: str) -> list[Any]:
    """Run Python in the persistent REPL
    (browser-harness helpers and raw cdp() pre-imported)."""
这次删改涉及 554 个文件:删除 136,905 行、增加 29,601 行,Python 文件数量也从 178 个降到了 43 个(工程文章)。
最直观的例子是处理卡死页面:Agent 调用 Page.stopLoading,阻断卡住的脚本,重新加载页面,找到页面私有的 JSONP 接口,然后分批获取 730 个日期,只重试失败的批次,最终返回 4,720 行数据。整个过程没有为任何一个步骤准备专用工具(工程文章)。
团队保留的原则是:只有当模型读过一次代码后仍无法自行重写时,才值得为它制作辅助函数。CAPTCHA 是例外。在一次小规模 staging 测试中,仅靠文字指令处理 hCaptcha 的结果是 0/3,而专用的 solve_captcha 工具达到 6/6,因为这个工具可以切换页面本身无法触达的求解器开关(工程文章)。
至于成本和速度,别只看标题结论。11 月 20 日的文章称,在 11 月 8 日进行的一次 200 任务测试中,3 个相同模型在 1.0 上的得分高出 14–33 分,成本降低到 0.x 的 1/2.7–1/5.2;实际计分任务为 180 个。文章也明确提醒:每个模型只运行了一次,而且默认配置发生了变化,因此这些收益不能全部归功于工具重设计(工程文章)。
更可比的结果范围更窄。1.0.4 的得分为 76.1,1.0.3 为 76.0;批量截图裁剪保留了提示缓存后,模型成本从每个任务 $0.434 降至 $0.208(1.0.4 说明)。在 BU Bench v2 中,1.0 的 ultrafast 得分为 62.5,成本 $0.070,用时 650 秒;Browser Use Pi 则为 56.3、$0.082 和 743 秒。作者表示,排除服务商错误后,这个差距已经没有统计意义。合理预期是更便宜、更快,而不是自动变得更聪明。
会悄悄影响账单和浏览器的默认值
下表整理自 MIGRATING.md 和 1.0.6 发布说明,反映的是 1.0.7,以及许多旧指南没有提到的 1.0 中期默认模型切换。
| 设置 | 0.x | 1.0.7 |
|---|---|---|
llm=None | 必须提供模型 | 通过 Browser Use 网关使用 bu-4.0 |
bu-4.0 价格 | 不适用 | 输入 $1.80 / 1M,输出 $9.00 / 1M |
bu-fast 价格 | 不适用 | 输入 $0.12 / 1M,输出 $0.60 / 1M |
Browser() | 本地 Chromium | Browser Use 云端浏览器 |
| 本地浏览器 | 默认使用 | 必须显式指定 Browser('chromium') |
| API key | 每个服务商一个 | 统一使用一个 BROWSER_USE_API_KEY |
max_steps | 500 | 100(其中一步预留给结果交付) |
| Agent 超时 | 未指定 | 1,700 秒,不含启动和关闭时间 |
| Judge | 手动启用 | 默认 judge=True |
| 推理 / 模式 | 不适用 | bu-fast / bu-ultrafast 使用 reasoning='medium'、mode='ultrafast' |
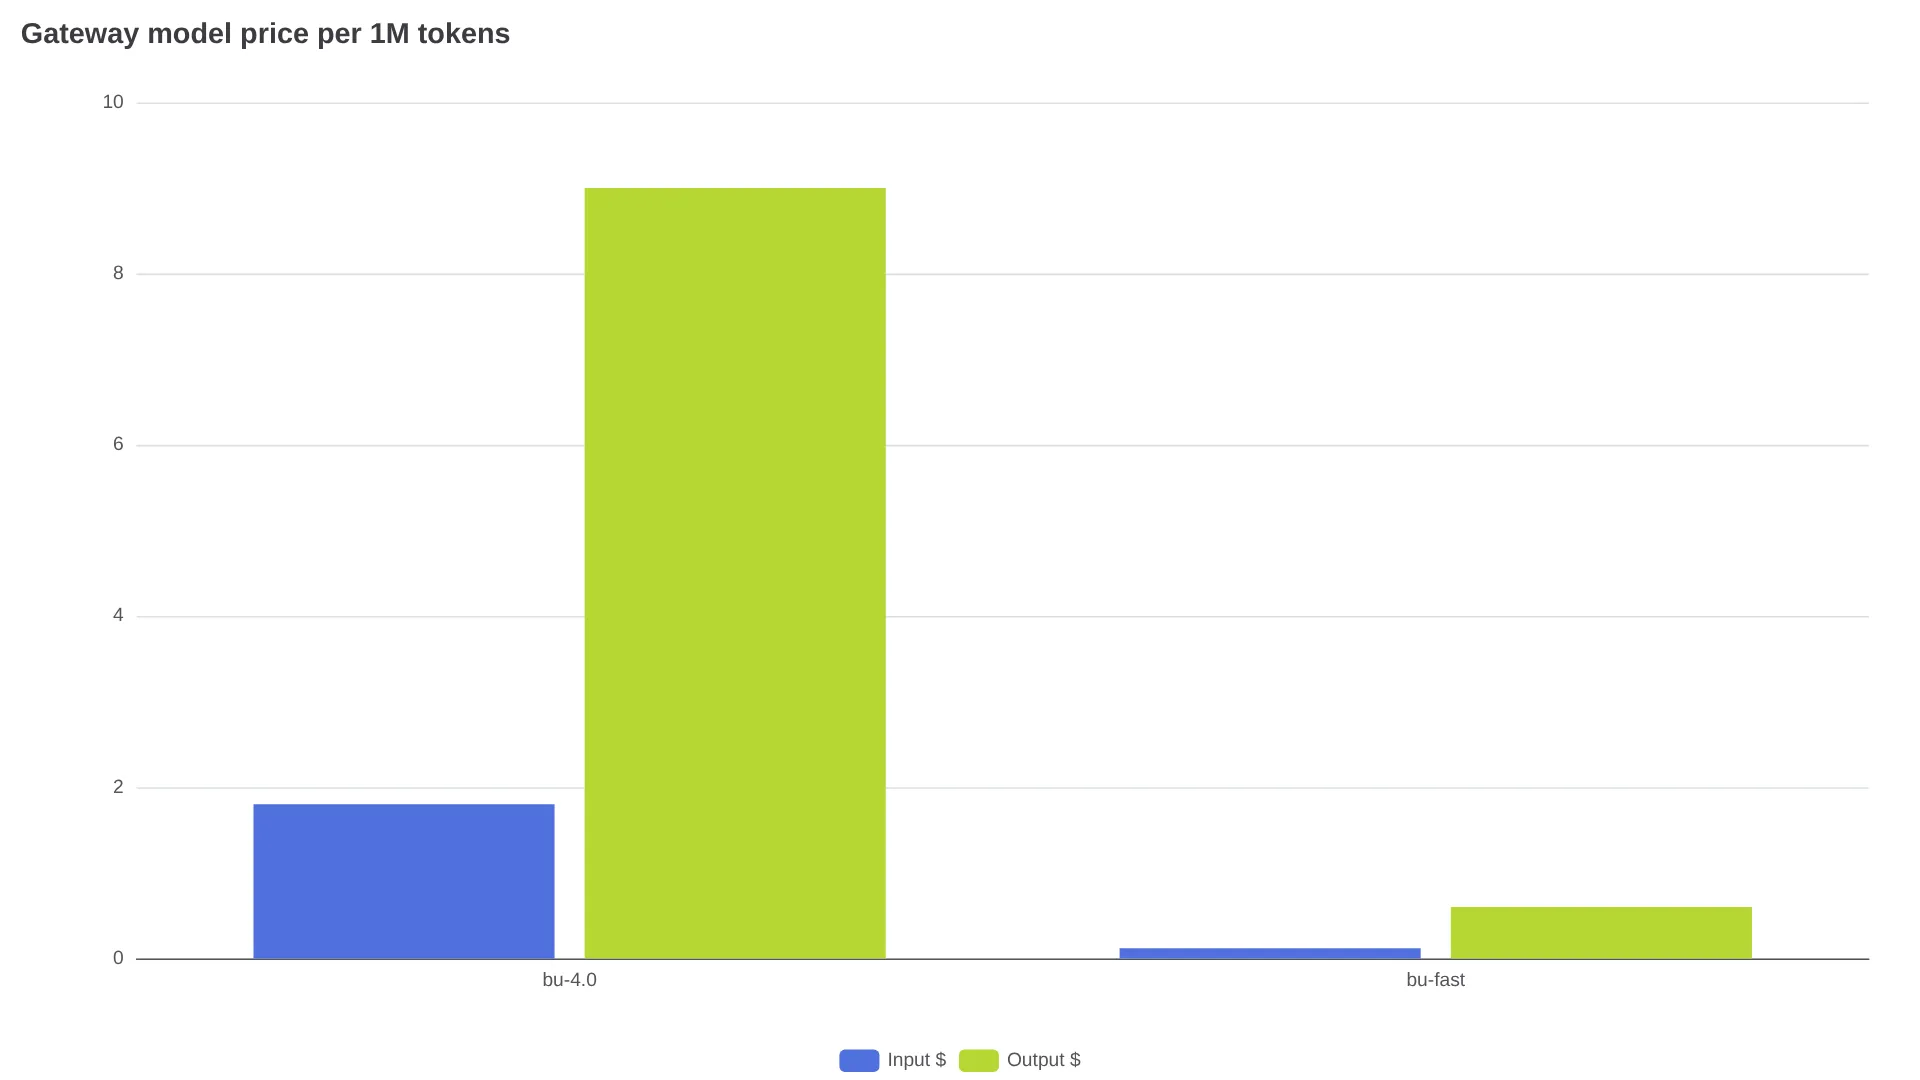
有三个坑尤其需要注意。第一,默认模型在 1.0 期间发生过切换:1.0.5 及更早版本默认使用 bu-fast,而 1.0.6 将默认值改成了 bu-4.0,token 价格提高到原来的 15 倍。项目自己的示例显示,同一个简短测试使用 bu-4.0 成本为 $0.022,使用 bu-fast 则为 $0.0014。如果想保留旧版本的成本水平,请显式传入 llm='bu-fast'。第二,现在直接使用 Browser() 会创建云端浏览器,价格为每浏览器小时 $0.06,此外还要支付模型和搜索费用(README);云端浏览器也无法访问 localhost 或私有 IP(MIGRATING.md)。第三,一步对应一次模型请求和一个 Python 单元,因此较低的 100 步上限同时也起到了费用上限的作用;现在 max_steps < 1 或 timeout <= 0 会在浏览器启动前直接失败(MIGRATING.md)。
Judge 是另一项容易被忽略的费用。只要运行至少完成一步,系统就会让你自己的模型额外发起一次低成本请求,处理最多 120,000 个字符的运行轨迹;如果启用了视觉,还会附带最后 4 张不同的图片,包括最终页面,而且这些内容会以未脱敏形式发送(MIGRATING.md)。结果会写入 result.judgement,其中包括 success、failure_reason、gotchas 以及 bot/CAPTCHA 标记,费用则计入 result.cost_usd。可以用 judge=False 关闭它,也可以传入包含预期答案的 judge_context;如果截图绝不能离开你的边界,再设置 use_vision=False。
必须本地运行时,别让浏览器走云端
浏览器选型应该由网络环境决定,而不是习惯。下面的模型标识是 README 本地浏览器示例中的演示性服务商模型(README):
from browser_use import Agent, Browser, ChatOpenAI

agent = Agent(
    "Summarize the dashboard at http://localhost:3000",
    llm=ChatOpenAI("gpt-6-luna"),
    browser=Browser("chromium"),
)
print(agent.run_sync().final_result())
需要访问 localhost、私有网络或自定义视口时,应使用 Browser('chromium');如果云端设备指标不会改变实际页面视口,也应选择它。使用 Browser('chrome') 可以驱动已经打开、并保留现有登录状态的 Chrome;Browser('chrome', profile='Work') 会启动一个带登录信息的临时副本,但不会将 Sync 写回。Windows 用户还需要先退出原有 Chrome,因为它会锁定 cookies(MIGRATING.md)。如果你需要托管式隐身、代理、CAPTCHA 处理或完全不配置本地环境,云端仍然是更合适的默认选项(README),只是要把浏览器时长费用和 token 费用分开预算。
自定义模型仍然可以使用,但传入方式很重要(MIGRATING.md):
- 网关别名:
bu-4.0、bu-4.0-mini、bu-4.0-pro、bu-fast、bu-ultrafast、bu-smart - 服务商:
ChatOpenAI、ChatAnthropic、ChatGoogle,或 Pydantic AI 字符串,例如groq:llama-3.3-70b-versatile - Azure:使用
llm='azure:<deployment>',并设置AZURE_OPENAI_ENDPOINT、AZURE_OPENAI_API_KEY和OPENAI_API_VERSION
将 LangChain chat 对象作为 Agent(llm=...) 传入现在会抛出 TypeError;像 bu-2-0 这样的已弃用网关名称,也会在浏览器启动前被拒绝。每个并行 Agent 都需要自己的 Browser();两个 Agent 共享同一个实例会抛出 RuntimeError,但可以让一个设置了 keep_alive=True 的浏览器按顺序复用(MIGRATING.md)。
别靠猜迁移:让错误信息告诉你怎么改
1.0 有意采用了快速失败策略。被移除的导入会抛出带有替代方案的 ImportError,不支持的 Agent(...) 参数会抛出 TypeError,任何 1.0 无法执行的配置都会在浏览器启动或产生费用前报错(MIGRATING.md)。另一小部分选项——包括 use_vision=True、vision_detail_level、max_actions_per_step、flash_mode、max_failures、highlight_elements 以及类似调优参数——仍可接受,但会被忽略,并且每项只发出一次警告。use_vision=False 仍然有效,因为它会阻止截图发送给模型。
启动之后,行为则相反:run() 通常会返回错误结果而不是抛出异常,其中 status='error',详细信息位于 result.error。只有取消操作仍会继续向外传播异常。因此,检查逻辑也要跟着调整:
# 0.x
history = await agent.run(max_steps=500)
ok = history.is_successful()

# 1.0
result = await agent.run(max_steps=100)
ok = result.is_done() and result.success is not False
现在 is_done() 只表示运行已经结束;成功与否由模型通过 finish(result, success) 给出判断,而当模型没有作出判断时,is_successful() 会返回 None。旧版逐步历史辅助方法——包括 action_names()、model_actions()、extracted_content()、save_as_playwright_script() 以及 MIGRATING.md 中“已移除历史 API”部分列出的其他方法——都已消失。现在应改为读取 result.messages、result.status、result.partial、agent.workspace 中的文件,以及 result.judgement。
迁移可以先做三处修改:把 max_steps 从 Agent(...) 移到 agent.run(max_steps=...);将已删除的回调(on_step_start、pause、stop、multi_act、save_history)改用 INFO 级别的 logging.getLogger('browser_use'),或设置 BROWSER_USE_LOGGING_LEVEL=warning;重新规划密钥范围。现在,域名限定的密钥只会在匹配页面上注入,以 bu_2fa_code 结尾的名称会被当作 TOTP 种子,旧式的 <secret>name</secret> 占位符会报错,必须改成 type_secret('name')。密钥值在单元格和结果中会被脱敏为 <secret:name>,但这只是脱敏,不是沙箱,因为模型生成的 Python 仍然可以读取这些值(MIGRATING.md)。如果还需要时间,可以先执行 pip install 'browser-use<1' 固定在 0.x,再在分支中迁移。
“browser use is more a python framework for building your own browsing agent” —— r/ClaudeCode 上的 u/Starks1293
这句话也符合 Reddit 讨论中用户对它的描述:这是一个用于构建浏览 Agent 的框架,常见于需要处理机器人防护网站、并希望进行代码级控制的场景。不过,可靠性仍然取决于模型和网站;一篇生产环境报告称,在基础表单填写任务中,系统用了五分钟并经历了九个失败步骤。
上线前要看:Judge、密钥与不稳定的现实
如果要深入使用,真正值得关注的是:
- 通过
output_model_schema获取类型化结果,并从result.structured_output读取 - 工作区上传,以及通过
result.downloads访问workspace/downloads - 域名控制(
allowed_domains、prohibited_domains、block_ip_addresses),它们约束的是遵循指令的模型,并不能把网络变成沙箱 - 通过
web_search=True可选启用网页搜索,费用按搜索次数计入result.cost_usd - 通过
browser-use --cli-mcp、browser-use skill install和browser-use --doctor使用 CLI/MCP
把 1.0 当作一个快速演进中的框架来使用:固定精确版本,在长任务中加入 judge_context,用 checkpoint('titles.json', titles, partial=True) 保存部分进度;不可信任务则放进容器运行,因为域名限制和密钥脱敏都不等于隔离(README)。
现在迁移、固定版本,还是继续留在 0.x?
| 情况 | 建议 |
|---|---|
| 新建 Agent 项目,可以使用云端 | 从 ==1.0.7 开始,保留 bu-4.0 默认值,并保持 Judge 开启 |
| 对成本敏感的批处理任务 | 传入 llm='bu-fast' 和 judge=False,扩容前先测量 |
| localhost / 内网 / 自定义视口 | 使用 Browser('chromium') 加你自己的模型,绝不要使用裸 Browser() |
| 已有 0.x 生产项目 | 在主分支固定 browser-use<1,利用快速失败报错在分支中迁移 |
| CAPTCHA 密集型流程 | 为专用求解器留出预算;团队测试中仅靠文字指令的结果是 0/3 |
你将获得一个能够阻断卡死脚本、调用从未封装过的私有 API 的 Agent,但也会失去固定操作菜单带来的约束。如果你的网站适合这种取舍,就迁移;否则,对于已有生产系统,在评估期间继续固定 browser-use<1 仍然是更稳妥的选择。
常见问题
browser-use 1.0 有哪些新变化?
一个带有 browser-harness 辅助函数和原生 CDP 的持久化 Python REPL,取代了 0.x 的 24 个操作菜单,库的规模也减少了约 80%(Python 文件从 178 个降至 43 个)。默认配置改为 Browser Use Cloud、网关模型,以及统一的 BROWSER_USE_API_KEY。
我的 0.x 代码会失效吗?
常见入口(Agent、Browser、run()、final_result())仍然存在,但被移除的导入和选项会在计费前抛出 ImportError 或 TypeError,max_steps 已移到 run(),而 Browser() 现在表示云端浏览器。想继续使用 0.x,可以固定 browser-use<1;否则建议先创建分支再迁移。
还能使用自己的模型和本地浏览器吗?
可以。你可以传入 ChatOpenAI、ChatAnthropic、ChatGoogle 等服务商,或传入 Pydantic AI 字符串;使用 Browser('chromium') 可启动全新的本地浏览器,使用 Browser('chrome') 则可以驱动已经打开的 Chrome。云端浏览器无法访问 localhost。
browser-use 1.0 需要哪个 Python 版本?
Python 3.11 或更高版本,且低于 4.0。精确固定的依赖版本可能与其他软件包冲突,因此建议先在全新的虚拟环境中安装。
如何关闭运行 Judge?
传入 judge=False 可跳过额外的评估请求;也可以传入包含验收标准的 judge_context,让它的判断更有参考价值。如果 Judge 不应发送截图,再设置 use_vision=False。