如果你在意长上下文 Agent 的错误率,Neon high 是这里性价比最出色的选择;不过按单任务成本计算,Astra 和 Sol 更便宜。本文汇总了发布当天的官方规格、排行榜和独立测试,我没有亲自运行 Neon。
Neon 是更快的 Carbon,但取舍也很明确
Gemini 4 Neon 于 2026 年 11 月 18 日以 gemini-4-neon 发布。根据 Google 和 9to5Google 的信息,它定位在 Hydrogen 和 Carbon 之间,是 Gemini 4 系列的中档型号。Google 表示,Neon 的端到端完成速度快于 Carbon,同时每个任务的成本更低;DeepMind 员工也称它比 Carbon 更便宜、更快(@_mohansolo)。在 Artificial Analysis Index 中,Neon 以 xhigh 得分 61,排名第 3;在 Agent Arena 中,它在 4,200 多次会话里以 1336 分排名第 2。本次查阅的发布材料没有公布 Opus 5.5 和 Fable 5.2 在同一块 Arena 榜单上的成绩,因此下文的直接比较会结合 Index 排名和相同任务测试。
价格、上下文窗口与可用平台
根据 Google 的信息,Neon 的价格为:输入 $3/百万 token,输出 $15/百万 token,缓存输入 $0.15/百万 token。上下文窗口为 1,048,576 tokens,单次响应上限为 65,536 tokens。它提供 low / medium / high(默认)/ xhigh 四档思考级别,并按输出计费:级别越高,可能消耗越多推理 token,也会推高账单。DataCamp 的级别说明和 SpringPrompt 的 API 笔记均确认默认级别为 high。
根据 eesel 的 API 检查,Neon 仅面向付费用户,没有免费层。根据 Google 和 9to5Google 的信息,它可通过 AI Studio 中的付费 API、Gemini for business、Antigravity(Pro/Ultra)、Gemini app(Pro/Ultra,取代 Argon)以及 Android Studio 使用;Cursor 也已支持 Neon。在 CursorBench 默认工作量下,Neon 得分 63.7%,而 Hydrogen 为 57.3%,数据来自 Cursor。
| 模型 | 每 1M token 的输入 / 输出价格 | 默认思考级别 |
|---|---|---|
| Gemini 4 Neon | $3 / $15,缓存输入 $0.15 | high |
| Gemini 4 Hydrogen | $1.50 / $7.50 | high |
| Gemini 4 Carbon | 11 月 30 日前 $2 / $10,此后 $4 / $20 | medium |
| Claude Opus 5.5 | $4 / $20,测试采用最高设置 | 测试采用最高设置 |
| GPT-6.2 Sol | $2 / $10,测试采用最高设置 | 测试采用最高设置 |
竞品价格和最佳设置标签整理自 eesel 的对比表。从 12 月 1 日起,Neon 的每 token 价格比 Carbon 低 25%。详情见:Neon 定价。
如果需要锁定思考级别,建议使用 API;如果更看重托管配额,则可以使用应用或 Antigravity。配额方面的报告只能作为非正式的规划参考:根据用户反馈,单次聊天大约消耗 Pro 配额的 1–3%,而一次 10 分钟、包含 3 个子 Agent 的运行约消耗 5%。
Neon 对比 Opus 5.5、Fable 5.2 与 Sol
以下成绩由 Google 提供,并由 eesel 和 DataCamp 汇总。
| 测试 | Neon | 竞品 | 结论 |
|---|---|---|---|
| Vals Index | 70.9%,第 2 名 | Fable 约 71.3% | 接近顶尖 |
| AutomationBench | 56.3%,第 1 名 | Opus 42.5%,Sol 41.3% | Agent 领先 |
| GraphWalks 256K–1M | 95.2% | Opus 66.8%,Sol 80.1% | 长上下文领先;建议先用你最长的文件重放测试,因为部分 Argon 用户反馈存在过度总结问题(讨论串) |
| Terminal-Bench 4.1 | 65.2% | Opus 65.8% | 几乎打平,Opus 高 0.6 |
| FrontierCode 2.0 | 46.2% | Opus 47.3% | Opus 高 1.1 |
| CursorBench 4.1 | 63.7–65.4% | Opus 58.1% | 默认工作量下 Neon 领先 |
根据 Artificial Analysis 经 eesel 整理的数据,单任务成本会改变只看 token 单价得出的结论:
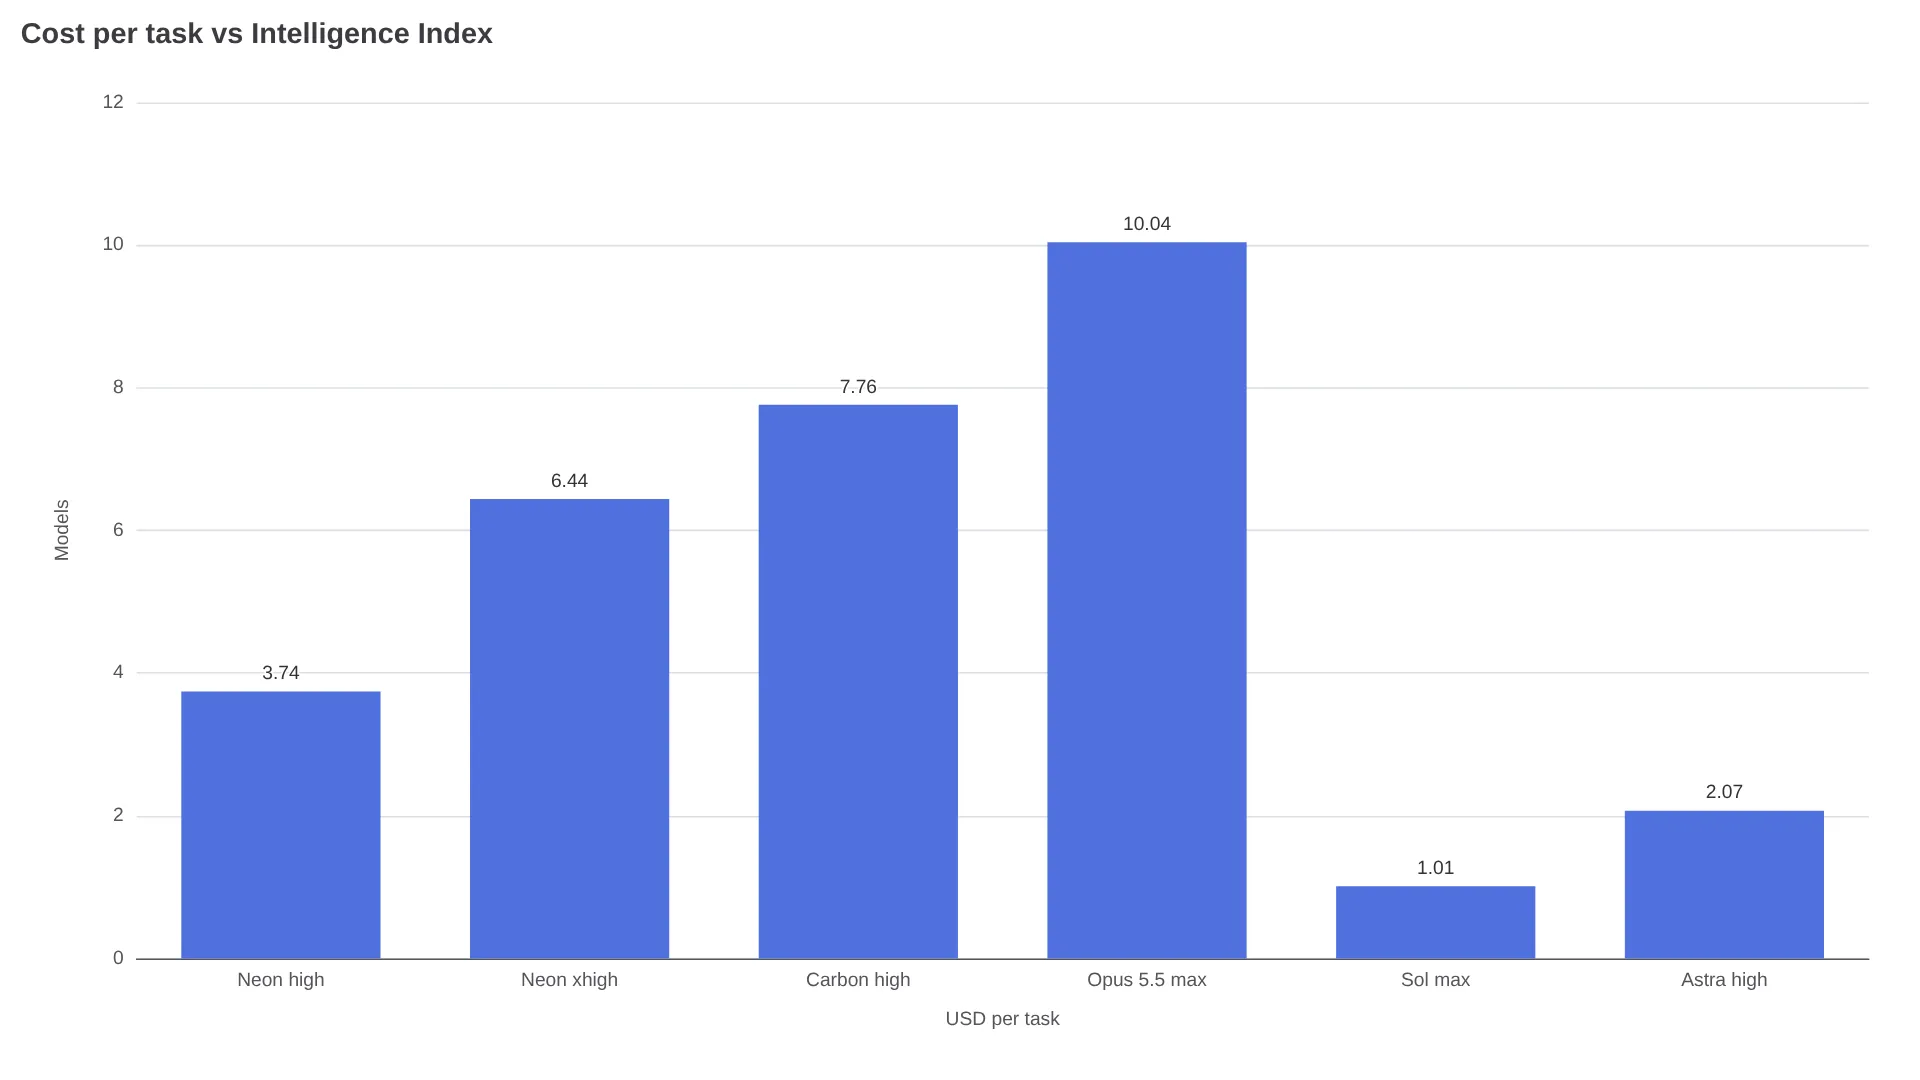
Neon high 得分 59.6,成本 $3.74,耗时 14.8 分钟;Carbon high 得分 60.0,成本 $7.76,耗时 37.2 分钟;Opus 最高设置得分 59.1,成本 $10.04;Astra high 得分 60.1,成本 $2.07;Sol 最高设置得分 57.3,成本 $1.01。Neon xhigh 可得 61.4 分,成本 $6.44,耗时 21.5 分钟。除非你认为多 1.8 分值得多花 $2.70、并多等 6.7 分钟,否则使用 high 就够了。
Neon 对比 Fable 5.2:早期反馈显示,分工协作更合适
在供应商提供的 SWE-sweep 测试中(使用 Antigravity harness),Neon 得分 39.0%,Opus 为 10.1%,Sol 为 8.3%。在共享的 mini-SWE harness 中,Neon 为 12.8%,Sol 为 11.6%,Opus 为 3.6%,数据来自 DataCamp。这里显著的差距,很大程度上来自 harness,而不完全是模型本身。
“我让 Fable 5.2 负责协调和开发,让 Neon 充当编码 Agent。这是我用过的最佳技术栈。”——u/1969Stingray(讨论串)
从用户反馈来看,Fable 更适合做协调,Neon 更适合负责实现;但最终还是要在自己的代码仓库上验证。在 AA-Omniscience 测试中,Neon “答错而不是拒答”的比例为 14%,低于 Opus 的 50%、Sol 的 55%,以及 Astra 和 Fable 的 58%;不过它给出正确答案的覆盖率只有 59–60%,低于 Astra 的 66% 和 Fable 的 77%,数据来自 eesel。
实测:国际象棋、商品列表与 105 个真实 Bug
| 测试 | 结果 | 局限 |
|---|---|---|
棋类页面,medium,运行 3 次(DataCamp) | Neon 3/3,成本 $0.83–$1.06;Carbon 1/3,其中两次触及 65K 上限;共 16 局,零次非法走法 | 只有一个任务;Carbon 可能通过后台模式完成 |
| CatalogBench 事实准确性(SpringPrompt) | 连续 3 次达到 78.6% 的可发布水平,在 35 个模型中排名第 1;能够从包装上读取规格 | 销售场景 32.1%,演示文稿第 24 名,调查问卷在预算限制下排名第 22 |
| 105 个重新植入的 Bug(@PawelHuryn) | Neon xhigh 得分 63,Astra 62.7,Fable 58,Carbon 57.3 | 只有一名测试者 |
SpringPrompt 使用的是 OpenRouter 的 medium,而 Google API 默认采用 high,因此输出详细程度并不相同。另有关于 AI Studio 出现孤立泄漏问题的报告(讨论串)。如果主要用于聊天,eesel 的计时数据显示 Neon xhigh 首 token 延迟为 56.5 秒,因此交互式回复更适合使用 medium 或 Hydrogen。
按工作负载选择
| 工作负载 | 选择 | 原因 |
|---|---|---|
| 复杂 Agent、长文档、代码重构 | Neon high | 得分 59.6,成本 $3.74;Agent Arena 第 2 名;棋类测试 3/3 |
| 最长链路的构建任务 | Carbon,依据 Google 对产品家族的定位 | Google 将 Carbon 留给最困难的项目;本文没有相同任务的验证测试 |
| 协调 + 编码 | Fable 负责协调 + Neon 负责编码 | 上文提到的非正式混合方案;应先自行验证 |
| 最低单任务成本 | Sol 最高设置 $1.01;Astra high 为 $2.07,但得分更高 | 两者在 AA-Omniscience 中的错误答案比例都更高 |
| 交互式聊天 | Hydrogen 或 Neon medium | xhigh 的首 token 延迟对聊天来说太高 |
| 受监管场景 | 等待更多文档后再决定 | 截至 11 月 19 日,完整安全报告仍未发布;只有在满足你所需文档要求的情况下才应批准使用 |
用一个下午完成自己的测试
为 Neon high、你当前使用的默认模型以及一个便宜的替代方案,准备相同的提示词和文件,并设置相同的思考预算。记录成功率、成本、耗时和错误答案数量。对于你的实际任务队列来说,这样的对比比任何排行榜都更有参考价值。Opus 相关计算见:Opus 5.5 评测;Fable 5.2 评测。