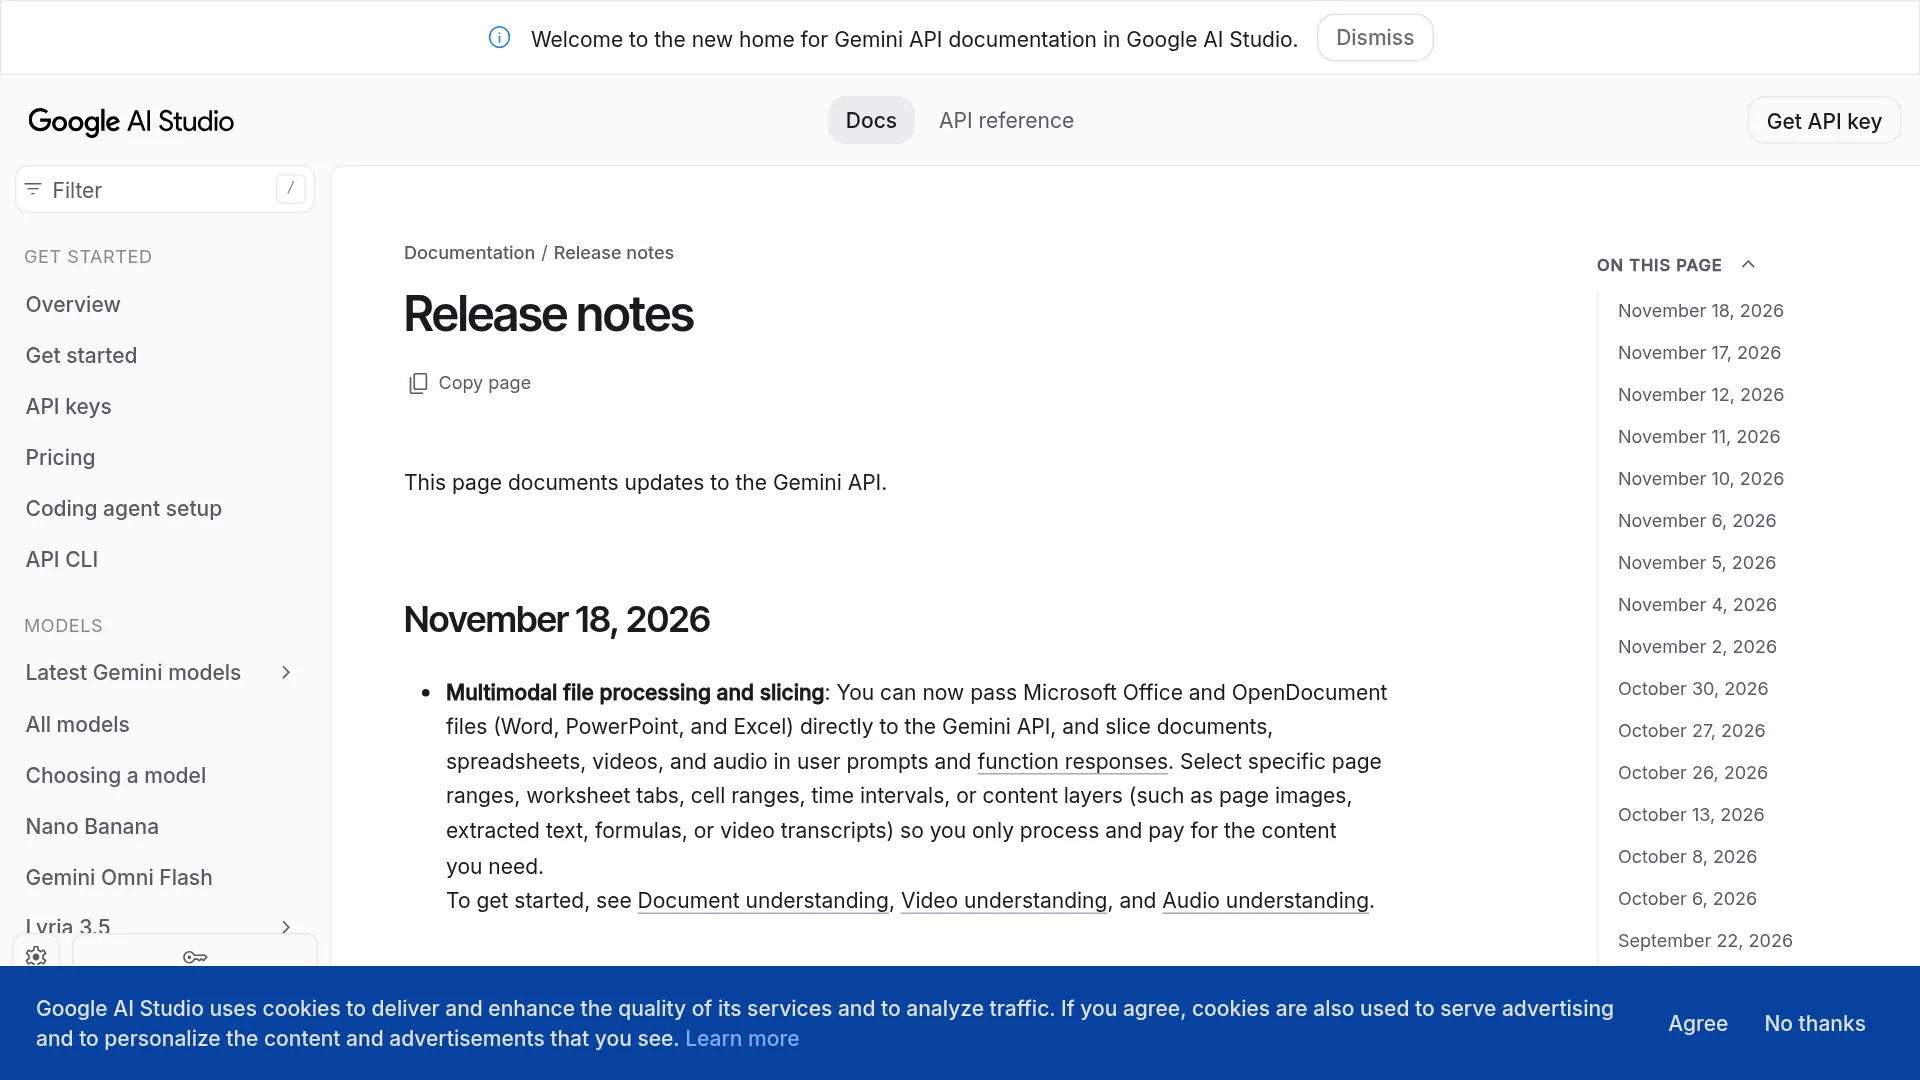
过去,把 Excel 工作簿转成 CSV 再调用 Gemini API 几乎是标准操作;现在这一步可以省掉了。自 2026 年 11 月 18 日起,Gemini API 已能直接接收 Word、Excel 和 PowerPoint 文件。Google 的说法是:你只需“处理并支付”所选择的内容片段(Google AI Studio changelog)。
不过,节省成本的前提是明确指定选择器。正如读者 @zg0820 提醒的那样,如果不指定范围,系统仍可能处理整个文件。
以前处理 Excel,问题出在哪
旧版文档中的行为是:XLSX 只会读取第一个工作表,并按 CSV 处理。因此,开发者往往不得不调整工作表顺序,或把一个工作簿拆成多个文件:
“文档至今仍写着:XLSX 只读取第一个工作表,并将其作为 CSV。”—— @aitrackerbot
11 月 18 日的更新取消了这类绕行方案:Office 和 OpenDocument 文件可以直接作为输入,同时支持在提示词和函数响应中按内容切片(DocsWatch analysis)。
11 月 18 日更新到底带来了什么
在 11 月 5 日已扩展支持 PPT、ODP 和 ODS 的基础上,这次更新主要增加了两项能力:
- 直接输入 Office 与 OpenDocument 文件。无需先转成 PDF 或文本,Word、PowerPoint 和 Excel 文件可直接发送。
- 内容切片。可以选择页面范围、工作表标签、A1 单元格区域、时间区间,或页面图像、提取文本、公式、转录文本等内容层。
切片不仅可用于提示词,也可用于 FunctionResponse 部分。因此,工具无需返回整个工作簿,只返回某个工作表区域即可(AI Index summary)。
现在能传哪些文件,适用于哪些模型
Firebase 的输入要求页面于 2026 年 11 月 18 日 UTC 更新,其中将 Office 支持与 Gemini 4.x models 绑定(Firebase AI Logic docs):
| 类别 | 扩展名 | MIME 类型 |
|---|---|---|
| Word | .doc, .docx, .dotx | application/msword, application/vnd.openxmlformats-officedocument.wordprocessingml.document, application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt, .pptx | application/vnd.ms-powerpoint, application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls, .xlsx | application/vnd.ms-excel, application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt, .odp, .ods | application/vnd.oasis.opendocument.text, application/vnd.oasis.opendocument.presentation, application/vnd.oasis.opendocument.spreadsheet |
| 基础格式 | .pdf, .txt | application/pdf, text/plain |
官方限制如下,内容切片不会提高这些上限:
- 单个文件最大 50 MB、每个文件最多 1,000 页、每个请求最多 3,000 个文档文件。
- 内联 base64 数据的请求总大小上限为 20 MB;更大的文件需要使用 Cloud Storage URL。
另有一条未经证实的社区信息,需要与官方限制区分看待:一位更新日志读者称,Office 文件可能存在约 2,000 页或幻灯片的专属上限(@lawson_ste3476)。Google 尚未正式说明这一点,因此不要以它作为系统设计依据。
Word 与 PowerPoint:可选页面范围,也可指定内容层
公开的 v1beta/v1alpha Discovery 文档中已观察到 DocumentMetadata,但稳定版 v1 尚未包含该字段(ORIENS schema report):
startPage:起始页,页码从 1 开始,包含该页。endPage:结束页,页码从 1 开始,包含该页。contentLayers:PAGE_IMAGE表示渲染后的图像;当提供 metadata 但未指定层时,据称它是默认值。PAGE_TEXT表示提取出的文本。
需要理解排版、幻灯片或扫描页时,选择 PAGE_IMAGE;处理合同等可搜索文字时,选择 PAGE_TEXT。Firebase 也说明了底层模型的处理方式:PDF 会按图像处理,每页计作一张图像;长宽均不超过 384 px 的图像消耗 258 tokens(Firebase AI Logic docs)。
Excel:工作表、单元格范围与三种内容层
根据 Discovery schema(ORIENS schema report),SpreadsheetMetadata 可附加在通过 inline_data 或 file_data 提供的文件部分上,适用于输入 Part 或 FunctionResponsePart:
sheetIndex:工作簿中的顺序,从 1 开始计数。Discoveryv1beta文本称省略时读取全部工作表,Python 和 JavaScript SDK 文本则称只读取第一个工作表。建议每次都显式设置。visibleCells:A1 区域,例如A1:G35;省略时表示所选工作表的已使用区域。contentLayers:DATA为值、合并单元格和格式;FORMULAS为公式表达式及计算结果;VISUAL为渲染图像。据称默认值为[DATA, FORMULAS]。
审计场景使用 DATA 加 FORMULAS;需要查看布局和合并单元格上下文时增加 VISUAL;单项查询则应把 visibleCells 收紧到最小范围。
只发送需要的片段:Python REST 示例
以下字段名对应 Discovery revision 20261116。这一结构仍属 beta,稳定版 v1 中并不存在,因此生产环境使用前应先与已安装的 SDK 核对。
import os
from google import genai
import requests

client = genai.Client()  # reads GEMINI_API_KEY
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])
Word 文件只需改为使用 "documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]},并替换为对应 .docx MIME 类型。PowerPoint 使用同样的 documentMetadata 结构,搭配 .pptx MIME 类型和幻灯片页码。
切片什么时候真能省钱:这样算成本
更新日志和 Firebase 定价说明中都没有单独的切片 SKU。节省的金额就是按标准费率少处理的输入 tokens。更新日志记录的 gemini-4-hydrogen 输入价格为每 100 万 tokens $1.50。
假设一份报告有 200 页,但只需要第 12 至 18 页,下面给出一个示意计算。这里每个文本页 800 tokens 的数字仅为示例假设,并非官方费率:
- 切片前:200 页按图像处理,每页图像最低 258 tokens,即 51,600 个输入 tokens。成本:51,600 / 1,000,000 x $1.50 = $0.0774。
- 切片后:7 页提取文本,按假设的每页 800 tokens 计算,共 5,600 个输入 tokens。成本:5,600 / 1,000,000 x $1.50 = $0.0084。
- 节省:在不计输出 tokens 的前提下,这次请求的输入成本约降低 89%。实际应替换为你测得的页面内容密度。
工作簿应自行基准测试不同范围大小:大量极小的切片请求,合计成本可能高于一次选择得当的较大范围请求(@zg0820)。
迁移前后的验证清单
上传成功,不等于文件已被正确解析。每条处理链路都应完成以下验证:
- 先确认解析结果。让模型返回行数、工作表名称或页数,再与原始文件对照。
- 所有选择器都明确设置。包括
sheetIndex、visibleCells或页面范围,以及contentLayers。 - 内容层要匹配任务。图表与版式需要
VISUAL或PAGE_IMAGE;审计需要DATA加FORMULAS;搜索需要PAGE_TEXT。 - 在预发布环境测试越界行为。schema 没有说明无效页面或范围会报错、被截断,还是返回空结果。
- 不要忽略上传上限。60 MB 文件仍会因 50 MB 限制而失败。内联数据超过 20 MB 时使用 Cloud Storage URL。
- 按这个顺序迁移。将 Excel 拆分器改为
sheetIndex加visibleCells;将报告栅格化流程改为搭配PAGE_TEXT的页面范围选择,仅在需要版式时保留PAGE_IMAGE;将整文件工具返回改为切片后的函数响应。
上述引用来源未说明的事项包括:隐藏行、合并单元格、图表、嵌入图像,以及受密码保护、启用宏或已损坏文件的处理方式。切片公告和上文链接的 Firebase 输入要求页面均未覆盖这些情况,应使用自己的模板进行验证。
FAQ
函数响应里的内容也能切片吗?
可以。工具可以返回文件 URI,并附带 SpreadsheetMetadata 或 DocumentMetadata,让模型只看到所需摘录。这很适合 Agent 文档工作流。
哪个 API 版本支持切片?
已在 v1beta 和 v1alpha 的 Discovery revision 20261116 中观察到,稳定版 v1 尚未支持。上线前请固定版本,并在目标模型上完成测试。
为什么 Gemini 说它看不到我上传的文件?
先根据上方表格和限制检查 MIME 类型、文件大小及明确设置的选择器,然后让模型返回工作表名称或页数,以确认解析是否成功。
延伸阅读:Gemini 4 Carbon vs Hydrogen API guide,了解如何为 Office 文件处理管线选择模型。