Google 在三天内连续发布了两款 Gemini 4 模型:Carbon 于 2026 年 11 月 10 日上线,Hydrogen 则在 11 月 12 日跟进。把它们简单理解成“Carbon 聪明、Hydrogen 快”很方便,但也可能让你多花钱:在一项视频定位基准中,单价低 25% 的 Hydrogen 最终跑出 $35.35 的账单,高于 Carbon 的 $27.94,原因是它生成了 2.6 倍的输出 Token。
两者均可通过 Gemini API 和 AI Studio 使用,模型 ID 分别为 gemini-4-carbon 与 gemini-4-hydrogen;拥有统一的 1,048,576 Token 上下文窗口,支持文本、图片、音频、视频和 PDF 输入,并输出文本(OpenRouter 实时对比)。Carbon 是面向前沿、长链路推理的模型;Hydrogen 则是其蒸馏而来、针对速度优化的版本,适合日常执行任务。Google 在Carbon 发布文章和Hydrogen 发布文章中给出的定位是:Carbon 负责规划,Hydrogen 也可在其下层承担执行。
单价更低,实际任务成本却输了
这里引用的公开端到端测试来自 Agnify 的 grounded-video QA 基准:模型需找出问题指定的对象,在关键帧中框选,并持续追踪该对象。测试涵盖 300 个问题、1.9 小时视频,两个模型各自接收相同的 7.6M 输入 Token。这个视频工作负载的结果,足以说明只看每 Token 单价有多误导人。
| 模型 | HOTA | 对象识别正确率 | 单次运行成本 | 每视频小时成本 |
|---|---|---|---|---|
| GPT-6.1 Terra | 0.6169 | 94.3% | — | $8.19 |
| Gemini 4 Carbon | 0.6016 | 94.3% | $27.94 | $14.60,12 月 1 日起为 $29.20 |
| Gemini 4 Hydrogen | 0.6006 | 95.1% | $35.35 | 约 $18.50,价格不变 |
| Claude Opus 5.5 | 0.5944 | 92.7% | — | $43 |
Carbon 与 Hydrogen 的 HOTA 只差 0.001,且置信区间重叠,统计上可视为平手;在同一样本中,它们也与 Terra、Sol 和 Opus 5.5 打成平手。但 Hydrogen 生成了 3.19M 输出 Token,Carbon 则为 1.23M;在单对象框选的第 3 阶段,中位输出分别为 387 Token 和 47 Token。有一个泡沫字母案例中,Hydrogen 消耗 62,138 Token 后框错字母,得分 0.36;Carbon 仅用 80 Token,得分却达到 0.70。Agnify 完整报告估算,若将 Hydrogen 的第 3 阶段输出控制到 Carbon 的量级,整次运行成本可降至约 $24。
Vercel 的工作负载指南有一条原则完全适用:相同的 Token 单价,不等于相同的任务成本。应该衡量每个被接受任务的成本,并把重试一并算进去,而不是只比较每百万 Token 的报价。
Google 这两款模型各自适合什么
Vercel 的指南将 Argon 定位为综合、知识型工作的默认起点,适合信息综合与知识任务(Vercel)。以此为参照,Carbon 是难题调试和开放式科学问题的升级选项,Hydrogen 则面向高频、流程明确的常规工作。关于 Argon 的详情,可参阅我们的 Carbon vs Argon 和 Hydrogen vs Argon 指南。
真正值得关注的是二者的协作架构。按Vercel 对 eve 路由的介绍及DataCamp 的 Hydrogen 概览,Antigravity 的 Orchestrator 模式可先让 Carbon 以只读方式完成规划,再把文件修改和测试执行交给 Hydrogen;遇到阻塞时,控制权会回到 Carbon。据称,这种组合能在接近 Carbon 的 Terminal-Bench 成功率下,将配额消耗减少 24%,完成时间缩短 19%:规划只调用一次前沿模型,大量执行则交给高速模型。
两款模型都属于闭源权重模型(OnlySOTA),支持多模态输入、文本输出和推理能力(OpenRouter)。Carbon 提供 low、medium、high 三档思考级别,默认是 medium;Hydrogen 额外提供 xhigh,默认则是 high。同名档位在两款模型上并不代表相同算力,因此每次测试都应记录模型和具体档位。
12 月 1 日后,价格关系彻底变了
Carbon 当前的标价带有促销属性,Hydrogen 的价格则保持不变。这一差异对实际采购决策的影响,可能大过任何一项基准分数。
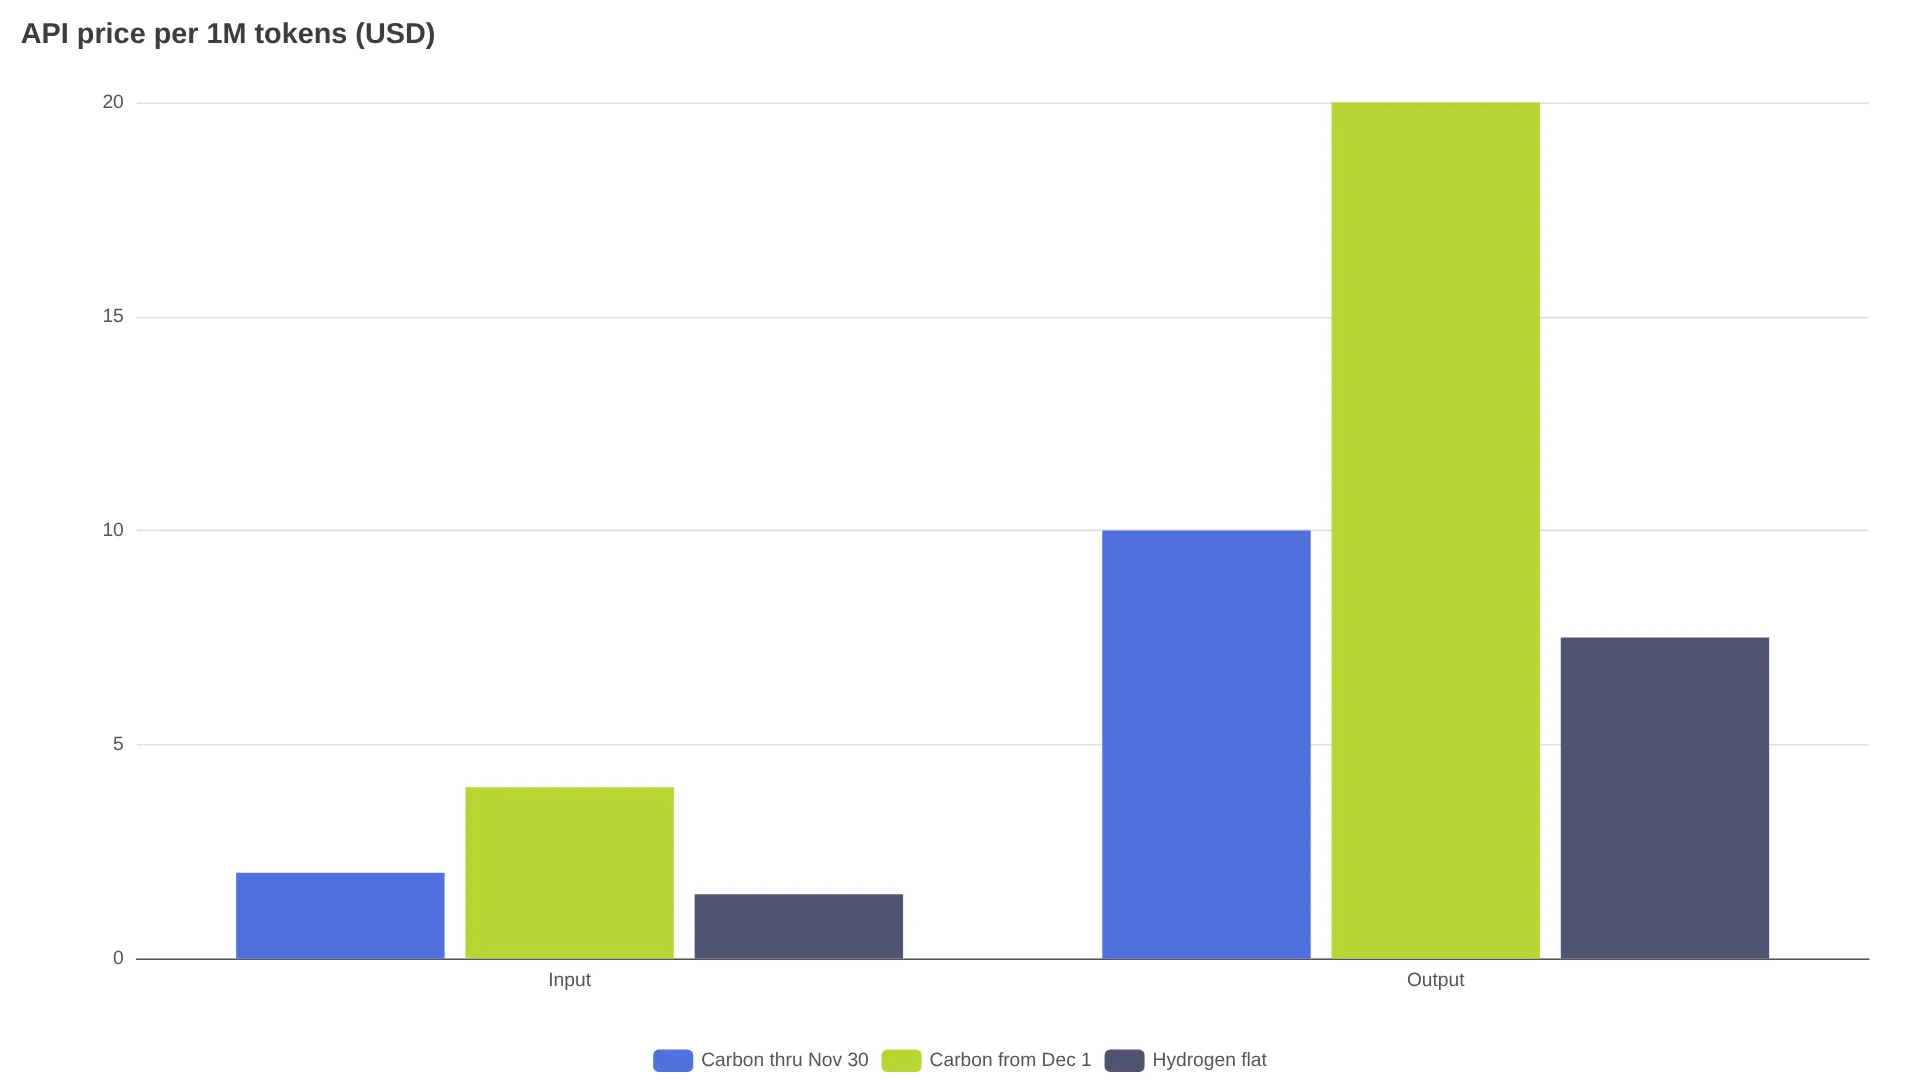
| 档位 | Carbon 截至 11 月 30 日 | Carbon 自 12 月 1 日起 | Hydrogen |
|---|---|---|---|
| 输入 / 1M | $2.00 | $4.00 | $1.50 |
| 输出 / 1M | $10.00 | $20.00 | $7.50 |
| 缓存输入 / 1M | $0.10 | $0.20 | $0.075 |
| 输入+输出批处理 | $1.00 / $5.00 | $2.00 / $10.00 | 取决于提供商 |
| 输入+输出优先级处理 | $3.60 / $18.00 | $7.20 / $36.00 | 取决于提供商 |
价格来源:Google 的首发费率见 LiteLLM 上线首日说明和 Cloud 价格表;Hydrogen 的固定价格见 DataCamp 与 AI Studio 文档。输出价格包含思考 Token,因此 Carbon 的深度推理会产生双重成本:一方面消耗更多 Token,另一方面又遇上 12 月的价格翻倍。
截至 11 月,Carbon 的视频任务运行在每 Token 单价相同的前提下,比 Argon 低 9%,因为它使用的 Token 更少。到了 12 月,只要输出冗长度接近,Hydrogen 在任何工作负载上都会更便宜。按 3:1 的输入输出混合比例计算(OnlySOTA),Hydrogen 为 $3.00/M,Carbon 在 11 月为 $4.00/M、12 月起为 $8.00/M。如果想通过同一把密钥调用两款模型,Gemini 4 Carbon API 页面可路由至其中任一模型。
速度和思考档位,直接决定 Agent 体验
根据 OpenRouter 的对比实时中位数,Carbon 的 p50 延迟为 11.32 秒、吞吐量为 57 Token/s;Hydrogen 则为 1.68 秒和 144 Token/s。Hydrogen 的首响应速度约快 6.7 倍,吞吐量约为 2.5 倍,这会直接影响交互式 Agent 的体感。
| Hydrogen 档位 | 单任务成本 | Intelligence Index | 适用场景 |
|---|---|---|---|
low | 约 $0.29 | 27 | 简单、高频任务 |
medium | 约 $0.80 | 41 | 看重速度的常规工作 |
high(默认) | 约 $1.87 | 51 | 大多数编程和 Agent 任务 |
xhigh | 约 $3.16 | 54 | 仅用于更困难的多步骤问题 |
以上估算来自 Artificial Analysis,并由 DataCamp 转述。从 high 升至 xhigh,每任务成本增加 69%,却只多 3 个指数点,而且简单提示词还可能出现过度思考。
接入 API 时需要规避的几个特性(DataCamp):
thinking_budget和MINIMAL会返回 HTTP 400;应改用thinking_leveltemperature参数会被忽略- 同步输出上限为 65,536 Token(根据Agnify 的测试,Carbon 上限更低,为 32,768)
- Hydrogen 属于短期 GA 模型,至少会提前 45 天通知退役
基准成绩要按任务看,不要只看奖杯
| 来源 | Carbon | Hydrogen | 对比对象 |
|---|---|---|---|
| Intelligence Index(OnlySOTA) | 60.0,第 2/57 | 53.9,第 7/57 | — |
| Arena Agent | 0.164,第 3/65 | 0.149,第 5/65 | — |
| Terminal-Bench 4.0(OnlySOTA) | 64.5%,第 3/59 | 56.4%,第 12/59 | Sonnet 5.5 64%(AA 独立数据) |
| Arena Code | 1768,第 4/157 | 1704,第 11/157 | — |
| Arena Text | 1526,第 1/421 | 1490,第 15/421 | — |
| Agents' Last Exam(DataCamp) | 77.4% | 71.6% | Argon 69.0% |
| AA-Omniscience 幻觉率 | — | 8% | 捏造陈述比 Flash 3.8 少 5 倍(Google,经 DataCamp 转述) |
OnlySOTA 汇总第三方榜单,并不自行运行测试(OnlySOTA)。Google 经由 DataCamp 发布的调整后 Terminal-Bench 4.1 数据为:Hydrogen 57.0%,Flash 18.2%,Sonnet 63.9%。结论很明确:Hydrogen 在 Agent 编程上具有竞争力,但若工作主要围绕终端环境,它并不是最佳选择。
眼下真正的限制是能不能用到
模型 ID 已经稳定:gemini-4-carbon、gemini-4-hydrogen。Hydrogen 的文档覆盖全部 API 层级,包括带速率限制的免费层(DataCamp、AI Studio 文档)。Carbon 则需要付费 API,并受 Ultra 门槛限制(Carbon 发布文章)。实际推出过程并不平滑:根据应用和账号不同,Hydrogen 可能出现、消失,或自动替换 Flash(r/GeminiAI 发布讨论)。详细情况可见我们的 Hydrogen 定价与发布状态追踪。
任何迁移计划都应把配额报告纳入成本考量:
“昨天的限制还更宽松。我付费订了 Pro。今天一个提示词,例如写一章约 6-7k 字的内容,就会吃掉约 4-5%。昨天 Hydrogen 出现时,3 章内容在 5 小时配额内大约只用了 2%。5 小时的限制简直是笑话。”—— u/Neat_Reaction9164,r/GeminiAI
“我今天一直在用它和 Sonnet 写代码。Hydrogen 确实很强,效率也出人意料地高;Sonnet 的表现则有好有坏,还撞到了使用限额……但现在下结论还太早。”—— u/mmmtv,r/GeminiAI
请用实际上线时采用的准确路径进行测试,例如 AI Studio、Antigravity、Cursor 或 API。套餐层级、集成方式和思考档位都会显著改变有效配额。若使用自动路由,也别忘了把决策调用计入延迟和成本:Vercel 的 eve 模式会在每轮调用 google/gemini-decision-1,并以 Argon 作为回退。
按你的工作负载这样选
大多数 API 使用场景都可归入以下三类:
- 日常高频任务直接选 Hydrogen。适合具有可检查 diff 的常规代码修改、格式已稳定的数据提取、单一来源问答和高频分诊。固定使用
high,在medium下做回归测试;只有明确证明多步骤场景需要时,才启用xhigh。 - 把最难的 10% 升级给 Carbon。例如多个解释互相竞争、修补可能掩盖症状的根因分析、需要设计区分性测试的冲突实验,以及修正案会覆盖提案的文档集合。接受它的延迟,也接受 12 月后的价格。
- 让两者协作。Carbon 以只读方式规划,Hydrogen 负责编辑和测试,发生阻塞时 Carbon 接管。该方案据称可将配额消耗降低 24%,完成速度提升 19%。
目前尚未解决的取舍是输出冗长风险。在 Agnify 的测试中,Hydrogen 默认 high 会输出 89 至 201 个思考 Token,而 Carbon 默认档位为 51 至 64 个。请设置输出上限,并在自己的提示词上测量实际生成 Token。现阶段,为 Hydrogen 做预算时应按实际输出 Token 计算,而不是只看标价 Token。
常见问题
Carbon 的推理能力比 Hydrogen 强吗?
是。Intelligence Index 为 60.0 对 53.9,Terminal-Bench 4.0 为 64.5% 对 56.4%,Arena Text 排名为第 1 对第 15;但视频 QA 的 HOTA 基本持平,为 0.6016 对 0.6006。
哪个更便宜?
Hydrogen 的价格固定,为每 1M Token 输入 $1.50、输出 $7.50。Carbon 截至 11 月 30 日为 $2/$10,12 月 1 日起为 $4/$20。
哪个更快?
Hydrogen:中位延迟 1.68 秒,对比 Carbon 的 11.32 秒;吞吐量为 144 Token/s,对比 57 Token/s。
上下文窗口一样吗?
一样,两者均为统一的 1,048,576 Token。
Carbon 可以规划、Hydrogen 可以执行吗?
可以,可通过 Antigravity Orchestrator,或使用 gemini-decision-1 做逐轮路由。
思考档位怎么选?
Carbon 选 medium,Hydrogen 选 high;只有当验收率可量化地提升时,才保留 xhigh。