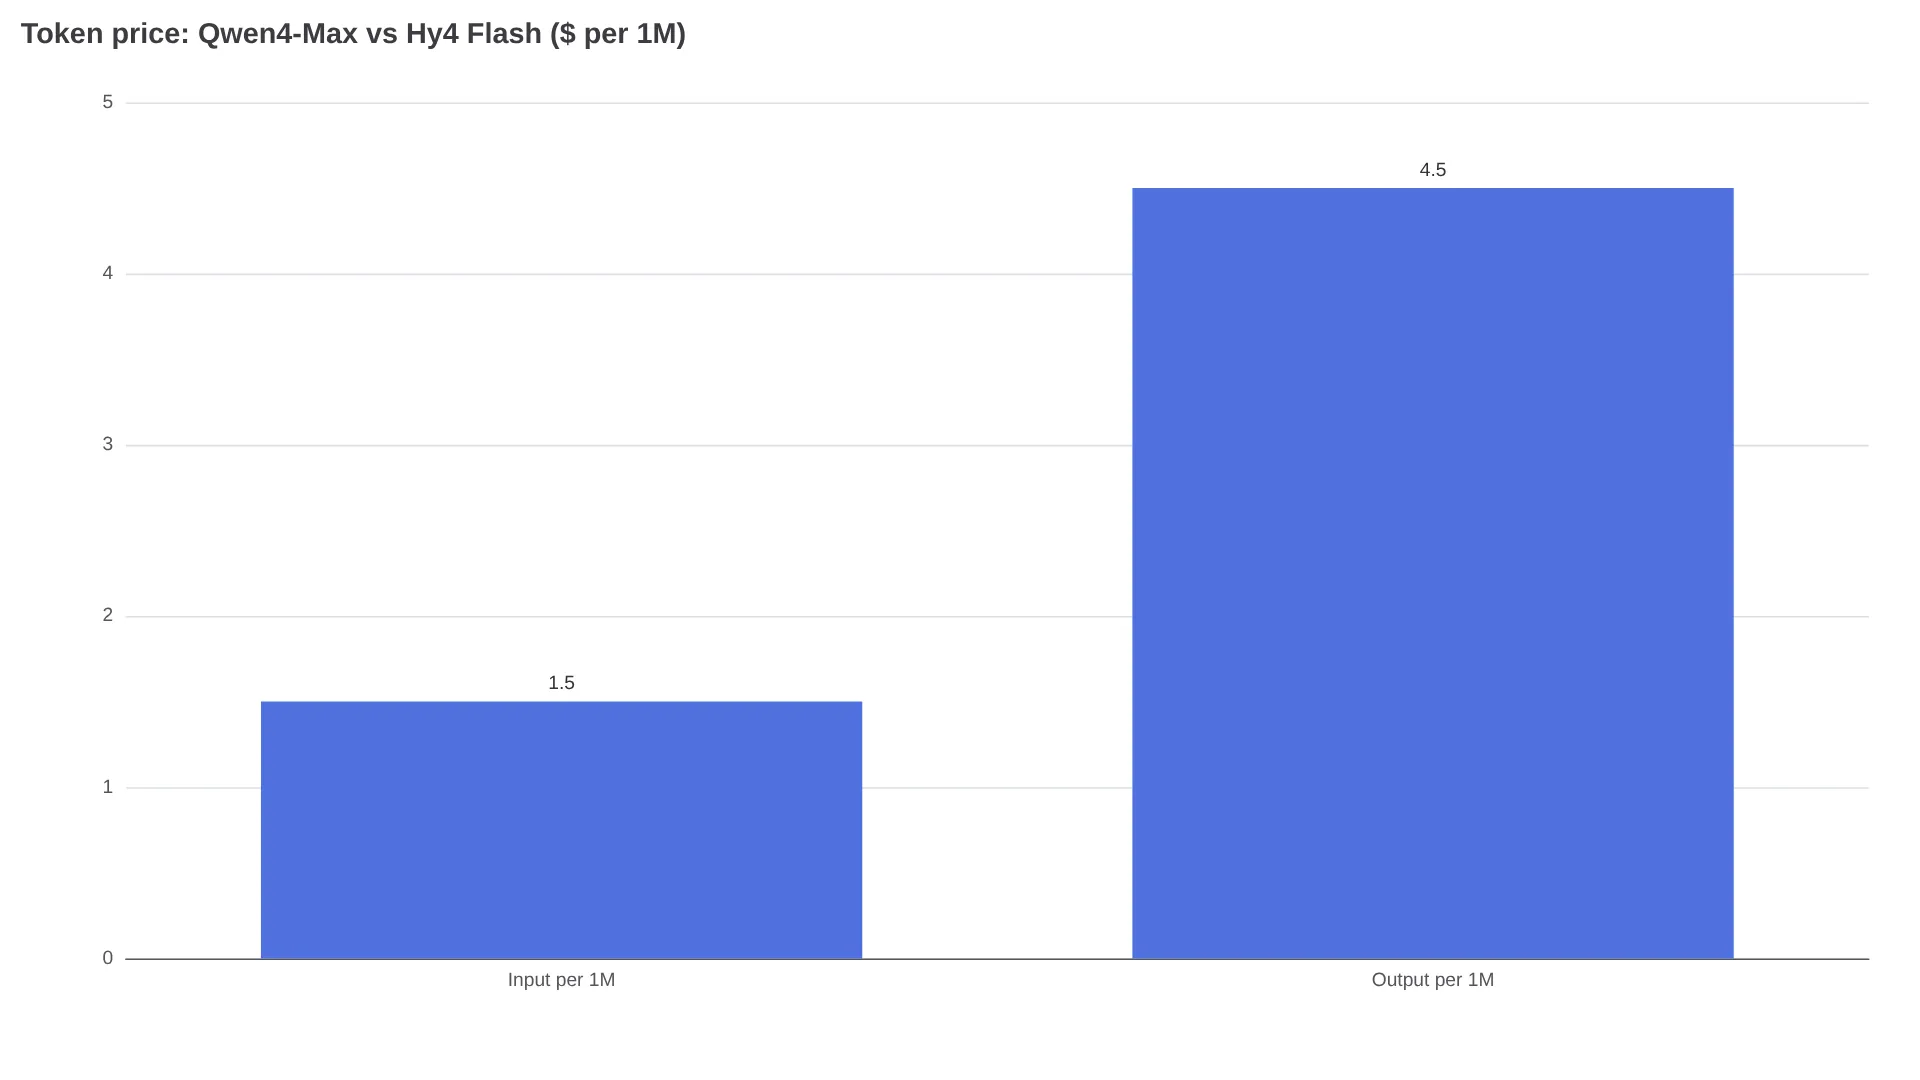
在高难度编程和工作流任务的引用基准中,Qwen4-Max 的表现领先 Hy4 Flash;但如果只看单次调用成本,Hy4 Flash 要便宜得多。QwenCloud 对 Qwen4-Max 的报价是每百万 Token 输入 $1.50、输出 $4.50,腾讯对 Hy4 Flash 的报价则为 $0.070 和 $0.281,输入侧约相差 21 倍、输出侧约相差 16 倍。不过,Agent 的最终账单并不只取决于标价:推理 Token、重试次数和缓存复用率往往更关键。本文将并列比较两者的 1M 上下文、2.4T 对 224B 的模型底座,以及厂商公布的单任务成本数据,再按实际工作负载给出选择建议。
先看标价:两款模型的 Token 成本
| 项目 | Qwen4-Max(新加坡 / 国际) | Hy4 Flash(TokenHub 国际) |
|---|---|---|
| 每 1M 输入 Token | $1.50 | $0.070 |
| 每 1M 输出 Token(含推理) | $4.50 | $0.281 |
| 每 1M 缓存输入读取 | $0.075 | $0.003 |
| 每 1M 显式缓存创建 | $1.875(5 分钟)/ $3.00(1 小时) | 未单独披露 |
| 0.5M 输入 + 0.5M 输出的混合成本 | $3.00 | ~$0.176 |
| 模型 ID | 通过 QwenCloud 使用 qwen4-max | 通过 Tencent 使用 Hy4 Flash |
以一次输入 60,000 Token、输出 4,000 Token 的 Agent 编程会话为例,差距会非常直观。Qwen4-Max 的输入成本为 $0.09、输出成本为 $0.018,单次尝试约 $0.108;Hy4 Flash 则是 $0.0042 加 $0.0011,单次约 $0.0053。在不计重试的前提下,Hy4 Flash 单次调用约便宜 20 倍。如果输入全部命中缓存,同样的 60k 输入在输出前仅需 $0.0045(Qwen4-Max)或 $0.00018(Hy4 Flash)。QwenCloud 将推理计入输出收费;Hy4 Flash 的输出价格为每百万 $0.281,因此压缩输出长度会直接减少计费 Token。
模型底座会怎样影响账单
Qwen4-Max 是一个 2.4T 参数的 MoE 模型,每个 Token 激活 71B 参数(Offloop、DataCamp);Hy4 Flash 则是 224B 参数的 LatentMoE 模型,每个 Token 激活 12B 参数,采用 4-bit 推理,并宣称生成速度超过 150 Token/秒(Tencent)。真正影响成本的是实际输出量:Qwen4-Max 的测试足迹达到 127M 输出 Token,而同类模型的中位数为 78.6M(DataCamp);Hy4 Flash 则宣称其后训练将平均输出长度减少了 50%(Tencent)。
你最终会按哪个价格付费
QwenCloud 新加坡区域的定价为输入 $1.50、输出 $4.50、缓存读取 $0.075;关闭思考时最大输入为 991,808 Token,开启思考时为 983,616 Token;关闭思考时输出上限为 131,072 Token,输入与输出合计上限为 262,144 Token(QwenCloud)。其他部署区域——弗吉尼亚、法兰克福、东京和香港——列出的价格为 $1.413 / $4.24 / $0.071(地区价格表见 Offloop)。
面向新加坡新注册按量付费账户的宣传中,提供了 100 万 Token 免费额度,具体条件适用,信息见 Xenospectrum。qwen4-max-preview 的 Token Plan 路径将于 2026 年 11 月 25 日退役,且从未覆盖生产后端(迁移说明)。
Hy4 Flash 的标价为 $0.070 / $0.281 / $0.003,而完整版旗舰 Hy4 的价格为 $0.834 / $2.501 / $0.042(Tencent)。截至 2026 年 11 月 30 日,TokenHub 的价格为半价,等效输入成本约 $0.035(Tencent)。可在 OpenRouter 查看可用性。更多信息见:Hy4 Flash pricing。
决定实际账单的三个放大器
第一是推理。推理 Token 与正常输出共用预算,并按输出价格计费。Qwen4-Max 默认使用 high,思考预算为 131,072 Token;也可选择 xhigh 或 low。根据 Offloop 对 Simon Willison 经 OpenRouter 进行的 SVG 测试的汇总,同一提示词下,high 使用了 6,362 Token,xhigh 则达到 26,295 Token,计费 Token 相差 4.1 倍。在思考模式下,将 max_completion_tokens 设为 10,000,意味着推理和最终回答合计最多只能使用 10,000 Token。
第二是冗长度和重试的叠加效应。阿里巴巴汇编、由 Offloop 引述的数据表明,Qwen4-Max 在每个基准任务中平均输出约 105,000 Token,低于 Qwen3.8-Max 的 171,000 Token,减少 39%,但依然远高于同类模型中位数。一项沙盒化 Reddit 基准测试涵盖 56 个任务、每项两次尝试,共 112 次尝试(讨论帖):Qwen4-Max Preview 有 64 次成功,DeepSeek V4.1 Flash 为 61 次;前者出现 16 次超时,后者为 4 次;每项任务耗时约 13 分钟和 7 分钟。一次超时后的重试,就是另一笔需要付费的请求。
“qwen 的 16 次超时,在 64 对 61 的结果中起了很大作用。” —— u/the_crooked_badger,r/DeepSeek thread
第三是缓存复用,长上下文 Agent 尤其受其影响。Qwen4-Max 的缓存读取价格为 $0.075,比常规输入低 95%;r/Qwen_AI 讨论帖中有用户报告,其缓存输入为 112M Token,未缓存输入为 14M Token。Hy4 Flash 的缓存读取价格 $0.003 还要低 25 倍,但当额外推理循环主导账单时,这项优势的重要性会下降。正如 @MarcosRGjr 所说:“别盯着每 Token 价格,Agent 是按任务收费的”(原帖)。
厂商声称的单任务成本,与外部数据怎么看
以下是厂商声明与外部代理指标的对照,并非经过验证的直接对决。
| 声明 | 数据 | 依据 |
|---|---|---|
| Alibaba Work360,Qwen4-Max 对比 Qwen3.8-Max(厂商内部数据,经 DataCamp 引述) | 每次尝试任务 $1.67 对 $4.43 | 721 字段套件,high 下 Token 量约少 35% |
| 阿里巴巴图表中的 AA 行,Qwen4-Max 对比 Qwen3.8-Max(厂商汇编,经 Offloop 引述) | 每个基准任务 $3.27 对 $10.02 | xhigh,输出 Token 为 105K 对 171K |
| Tencent WorkIndex,Hy4 Flash 对比完整版 Hy4(厂商内部数据,经 Tencent 和 breakdown 引述) | 每任务 ¥0.2 对 ¥5.7 | 8 组办公任务套件 |
| 腾讯盲测,Hy4 Flash 对比 Claude Haiku 5.5(厂商执行,经 Tencent 引述) | ¥0.26、2.79/4 对 ¥4.73、2.81/4 | 85 名用户、259 项任务、6.7 分钟对 6.8 分钟 |
Work360 给 Qwen4-Max 的评分是 52.69,高于 Qwen3.8-Max 的 47.74;Intelligence Index 从 34 升至 43,但仍落后于 Kimi K3.1 Pro 的 46 和 Opus 5.5 的 59(Offloop、LLM Leaderboard)。
厂商图表中复现的外部结果也为这些声明划定了边界。根据 LLM Leaderboard guide,Vals 关联测试测得 Qwen4-Max 得分为 63.20%,每次测试成本 $9.33;GPT-6.1 Sol 为 63.94%,成本 $3.61。Tencent 的图表显示,Terminal-Bench 4.0 中 Qwen4-Max 为 48.5%,Hy4 Flash 为 19.2%,完整版 Hy4 为 44.4%;ProgramBench 中则为 31.5 对 16.0(Offloop)。AutomationBench-AA 给出的 Qwen4-Max 成绩为 72.5%(DataCamp),而 Hy4 Flash 的自动化得分为 52.2(Tokenstrom)。
单次成功的期望成本,等于单次尝试成本除以成功概率。仅作示例:Qwen4-Max 为 $0.108 / 0.485 ≈ $0.22,Hy4 Flash 为 $0.0053 / 0.192 ≈ $0.028,约相差 8 倍。基准测试中的成功率并不等同于生产环境的重试率。按这些 Token 用量计算,Qwen4-Max 需要具备大约高 20 倍的成功概率,或带来等值的工具调用、延迟和修复成本节省,才能仅凭美元成本胜出。
按工作负载路由,再用 30 个任务回放验证
| Agent 类型 | 推荐默认模型 | 原因 |
|---|---|---|
| 高难度、长链路的编程和终端任务 | 使用 high 的 Qwen4-Max | 更高的成功率(48.5 对 19.2、31.5 对 16.0)可能足以覆盖溢价,尤其是在失败或修复成本高时 |
| 高频办公循环:幻灯片、文档、表格修复、计算机操作 | Hy4 Flash | WorkIndex 中每任务 ¥0.2 对 ¥5.7;与 Claude Haiku 5.5 基本持平(2.79 对 2.81),成本约为后者的十八分之一 |
| 缓存型流水线和批量抽取 | 默认 Hy4 Flash;回放证明质量节省后再选 Qwen4-Max | 针对自己的文档,对比 $0.003 和 $0.075 的缓存读取成本,以及后续修复成本 |
正式投入前,建议将你自己的 30 个任务分别在两款模型上回放。除了美元成本,也要记录每次成功对应的推理与输出 Token、工具调用、超时、人工修复,以及中位完成时间。
FAQ
Qwen4 Max API 每百万 Token 要多少钱?
QwenCloud 新加坡区域的价格为输入 $1.50、输出 $4.50、缓存读取 $0.075。其他区域为 $1.413 / $4.24 / $0.071。Hy4 Flash 的价格是输入 $0.070、输出 $0.281、缓存读取 $0.003。
推理 Token 或思考 Token 按输出收费吗?
Qwen4-Max 的思考 Token 按 $4.50 计费,并位于共享的 262,144 Token 预算内。Hy4 Flash 的输出按 $0.281 计费,因此缩短输出可以降低计费 Token 数。
实际可用的上下文上限是多少,而不只是宣传的 1M?
QwenCloud 标注:关闭思考时输入最多 991,808 Token,开启思考时最多 983,616 Token;关闭思考时输出最多 131,072 Token,输入与输出合计最多 262,144 Token。腾讯为 Hy4 Flash 标注了 1M 上下文。实际使用时应预留安全余量。
Qwen4-Max 和 Hy4 Flash,哪个完成一次 Agent 任务更便宜?
按单次尝试计,Hy4 Flash 约便宜 20 倍;腾讯称其单任务成本是完整版 Hy4 的二十分之一,并且在峰值定价下是 DeepSeek-V4.1-Flash-1017 的八分之一(Tencent)。按上文示例计算,它的单次预期成功成本仍约低 8 倍;但如果 Qwen4-Max 能显著减少失败和修复,其综合成本也可能更低。