 AIREITER
两款决策接口的标价都是每 100 万输入 token 0.10 美元,但同一份重复使用的策略文档,在不同平台上可能分别花掉 520 美元和 70 美元。OpenAI Decisions API 更适合带有重复上下文的智能体对话记录,Gemini Decisions API 则更适合音频、视频和包含 1,000 条规则的检查清单。
同样是 0.10 美元,账单却不一样
OpenAI Decisions API 和 Gemini Decisions API 对每 100 万个未缓存输入 token 都收取 0.10 美元,且不收取输出 token 费用。OpenAI Decisions API 于 2026 年 10 月 22 日在 gpt-6-luna 模型上正式 GA;Gemini Decisions API 则于 2026 年 11 月 11 日以 v1beta 版本、基于 gemini-decision-1 模型发布。到底谁更便宜,关键不在品牌,而在输入是否重复、以及输入属于哪种模态。
| 维度 | OpenAI Decisions API | Gemini Decisions API |
|---|---|---|
| 模型 | gpt-6-luna | gemini-decision-1 |
| 状态 | 自 2026 年 10 月 22 日起 GA(OpenAI 文档) | 自 2026 年 11 月 11 日起为预览版 v1beta(Google 公告) |
| 每次请求的问题数 | 1–400(OpenAI 文档) | 1–1,000(Google 公告) |
| 上下文窗口 | 超过 272K token 后,长上下文按 2 倍计费 | 262,144 token |
| 输入类型 | 文本、图片、input_json、对话与工具调用 | 文本、图片、音频、视频、PDF |
| 输出费用 | $0 | $0 |
| 缓存输入 | 每 100 万 token 0.01 美元,前缀至少 1,024 token | 不支持 |
| 免费层 | 未单独说明免费层 | AI Studio 提供,200 RPM / 50K TPM / 10K RPD |
| 已公布的延迟 | 约比 Responses API 快 10 倍 | 模型计算耗时 50–100 毫秒;处理 16K token 时端到端耗时 150–250 毫秒 |
| 企业能力 | ZDR、HIPAA、美国/欧盟区域处理(+10%) | 云端支持即将推出 |
一次请求具体怎么写
OpenAI Decisions API 使用 POST /v1/decisions,传入一个有序的问题数组,每个问题都可以设置可选的 name。Gemini Decisions API 则通过 client.decisions.create() 调用,使用开发者自定义 ID 作为键的映射。两边都支持三种问题类型,但名称和取值范围并不相同。
根据 OpenAI 指南,OpenAI 的问题类型包括:predicate(概率范围为 0 到 1)、choice(无序类别)和 score(2–10 个有序等级,并返回按概率加权的平均值)。根据 Google 公告,Gemini 的类型包括:noul(是/否,概率范围为 0.01 到 0.99)、choice(2–255 个选项)和 score(2–255 个等级,推荐 2–10 个)。两边同一请求中的问题彼此独立;如果要实现链式逻辑,就得交给应用代码处理,或再发起一次请求。
移植时最容易踩的三个坑
Gemini 会在评分前按字母顺序排列 choice 的键,因此名为 none_of_the_above 的兜底选项,可能会排在 shipping 前面(已有文档记录这一行为)。OpenAI 会在答案数组中返回问题的 name,Gemini 则返回以问题 ID 为键的映射。Gemini 的 noul 永远不会返回高于 0.99 的概率,所以设置 >0.99 的阈值永远不会触发。
拒答处理也不一样。根据 OpenAI 指南,OpenAI 可以只对某一个问题返回 refusal,同时继续回答其余问题。Gemini 遇到安全或禁止内容时,则会以 HTTP 400 拒绝整个请求,错误码可能包括 safety 和 prohibited_content。
“有件奇怪的事:看起来 Decisions 和普通文本生成似乎使用了不同的缓存与推理路径。”——u/Balance-,来自 r/OpenAI
如果两个接口都要支持,最好提前设计一层轻量适配器。统一问题 ID,重命名 Gemini 的键以避免字母排序带来的平局处理问题,同时将 Gemini 的阈值限制在 ≤0.99。
两边能接收什么,又会迫使你额外构建什么
Gemini Decisions API 可以在同一个共享输入中原生接收文本、图片、音频、视频和 PDF。OpenAI Decisions API 支持文本、图片、input_json、对话历史、函数调用和工具输出,但不支持文件或音频。两者的差异,决定了预处理流程是可以省掉,还是必须自己补上。
电话录音加账户元数据可以直接交给 Gemini,无需先转写;扫描版理赔 PDF 加损伤照片也不需要先做 OCR。带工具调用的智能体对话记录可以通过 call_id 匹配后原生交给 OpenAI,而交给 Gemini 时,则需要先把同一份记录展平成文本。OpenAI 还支持把图片放进问题的 instructions 中,用于候选项与参考项的比对。
两家厂商对图片 token 的计算方式也不同。在一次独立实测中(System Design Academy),一张 224×224 的鸡蛋照片,在 OpenAI 三个问题的请求中计为 523 个输入 token;在 Gemini 中,Low 模式估算为 390 个 token(其中图片占 257 个),Medium 模式为 663 个,High 模式为 1,223 个。按每 1,000 张图片计算,成本分别为 0.039 美元、0.066 美元和 0.122 美元。
延迟数据均来自厂商,不能直接当作 SLA。Google 称端到端耗时为 150–250 毫秒,从 1 个问题增加到 100 个问题、直到 16K token 时,延迟几乎保持不变。OpenAI 称其速度约为 Responses API 的 10 倍,但没有给出绝对数值。真实用户的反馈并不完全一致:
“速度和成本。输出几乎是即时的,而且成本只是零头。”——u/zyeus-guy,来自 r/OpenAI
在免费层测试 Gemini Decision 1:路由测试 30/30,延迟中位数约 0.24 秒,重复运行结果稳定;但当没有“其他”选项时,它会很有把握地选错类别。——r/GeminiAI 上的实测
把厂商公布的延迟当作测试中需要超越的上限,而不是生产环境 SLA。
100 万次请求到底要花多少钱
在两款 API 中,每次请求的共享输入只计费一次,增加问题只会多出指令 token。真正拉开账单差距的是跨请求重复输入:OpenAI 会缓存,Gemini 则按完整输入计费。
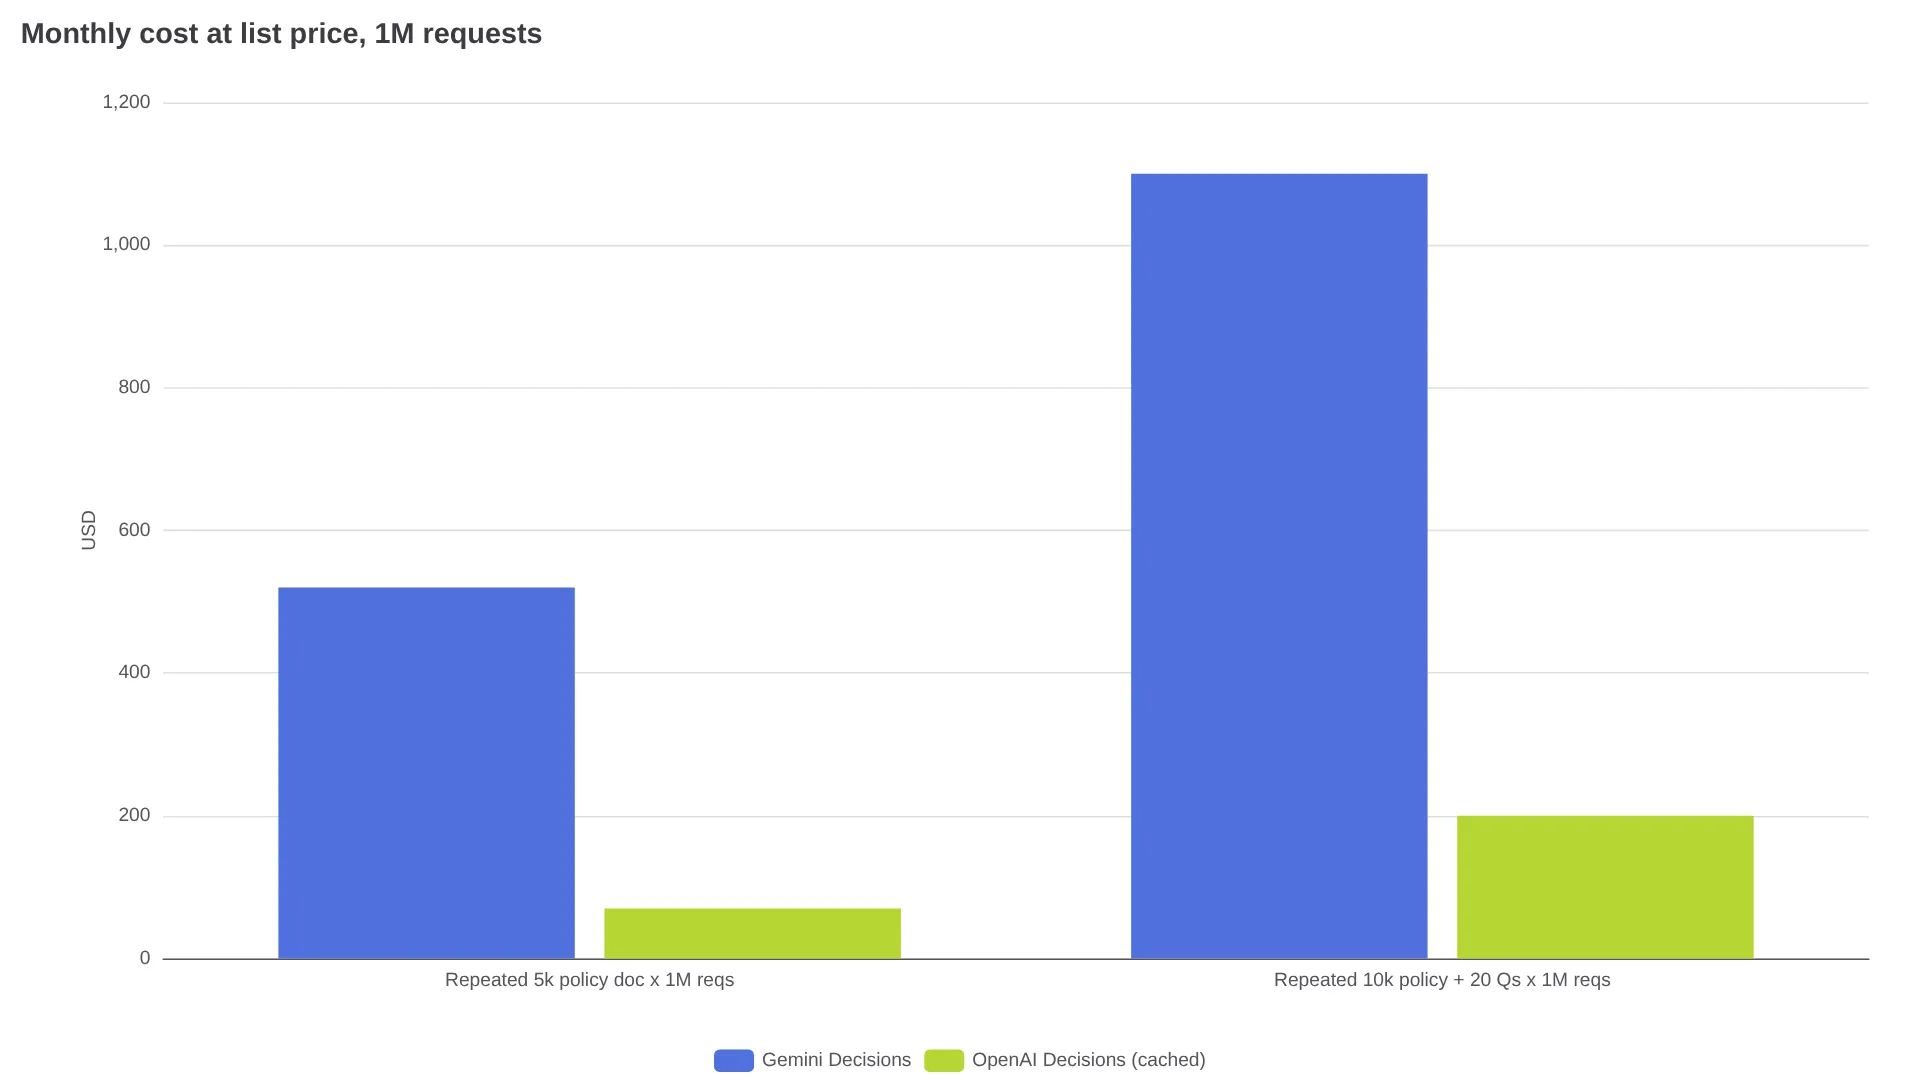
以下是按公开价格计算的示例,计算方式参考了 Apidog 和 BaristaLabs 发布的模式,并假设 OpenAI 在缓存写入收费之前已经命中缓存:
- 100 万张工单,每张都带有相同的 5,000-token 策略文档和 200 个新 token:Gemini 约 520 美元,OpenAI 使用缓存后约 70 美元。
- 100 万次请求,每次都带有相同的 10,000-token 策略文档,以及 20 个各约 50 token 的问题:Gemini 约 1,100 美元,OpenAI 使用缓存后约 200 美元,另加写入费用。
如果每次输入都不同,这个差距就会消失:一条没有可复用前缀、长度为 400 token 的消息,在两边都是每 100 万 token 0.10 美元。相比选择模型,批处理更重要:一条请求对一份 4,000-token 记录执行 20 项检查,每 1,000 份记录成本约 0.50 美元;拆成 20 个请求后,成本约为 8.10 美元。
长对话每轮都要重新读取历史内容,因此更能体现缓存价值。按模型估算,一个 30 轮、读取 124,680 个 token 的路由器,在 Gemini Decision 1 上且不使用缓存时,每 1,000 次聊天约花 12.47 美元;使用带缓存的聊天模型则约为 6.31 美元。
它返回的概率,真的值得信吗?
在 Google 公布、并由 AIToolsReview 汇总的表格中,Decision 1 在所有共同测试上都领先于 Luna:top-1 ECE 为 0.0250,Luna 为 0.0721,Jev 1.14 为 0.0494。JevBench 公开划分的成绩分别为:Decision 1 92.2%、Luna 90.9%、Jev 1.14 90.0%。整套测试的成本分别为:Decision 1 0.88 美元、Jev 0.68 美元、Luna 0.93 美元。
同一篇评测引用的 Artificial Analysis 独立汇总显示,Decision 1 的 Decision Index 为 66,与 Jev 1.14 并列第 9(共 18 个),比 Drex Max v1.1 低约 7 分。在 When2Call 测试中,Decision 1 为 75.2%,Jev 为 80.8%,Drex Max 为 94.6%;Decision 1 每 100 万任务成本为 345 美元、耗时 211 毫秒,而 Jev 成本为 156 美元、耗时 92 毫秒。
对于基于阈值的自动化,校准比表面准确率更重要。置信度为 0.90,意味着在实际部署分布中大约应有十分之九的结果正确。应使用 200–500 个已标注案例验证阈值,并按置信度区间统计准确率。
“置信度:Jev 风格的校准概率,并不是每个 OpenAI 兼容接口都会返回的。”——u/xapep,来自 r/LLMDevs
有两种失败模式反复出现。早期实践测试报告称,OpenAI 存在偏向第一个选项的问题(@NatashaTheRobot);上面的 Gemini 实测则显示,如果没有兜底选项,模型会选择“最不差”的类别,而不是主动弃权。解决办法包括加入 other 选项、单独设置范围检查 predicate、使用简短且彼此区分明显的描述,并在低于阈值时转人工审核。
上线前的生产检查清单
OpenAI 已经 GA,支持缓存、通过 GET /v1/organization/usage/decisions 查询用量,符合条件的客户可使用 ZDR 和 HIPAA,并支持美国/欧盟区域处理,价格上浮 10%。Gemini 目前仍是 v1beta,云端支持即将推出。两家厂商都列出了 OpenRouter、LangChain、Vercel 和 LiteLLM 等框架集成。
缓存规则会直接影响架构。OpenAI 可以复用至少 1,024 个 token 的共享输入前缀,问题内容不计入这个最低要求。Gemini 不支持上下文缓存、Batch、Flex 或 Priority 层级。免费层原型开发更适合 Gemini,但免费层内容可能会被用于改进 Google 产品,因此真实客户数据应放在付费密钥下。自动执行高风险操作前,先连续记录一周的置信度分布。
按工作负载选择,不要按品牌选择
如果你的场景是带工具调用、反复携带相同指令的智能体对话循环,优先考虑 OpenAI Decisions API。需要 ZDR、HIPAA 或欧盟数据驻留时,选择同样明确。
如果输入是通话录音、视频片段或扫描 PDF,并且需要执行数百项检查,优先考虑 Gemini Decisions API。原生处理音频、视频和 PDF,可以省掉转写与 OCR 环节;每次最多 1,000 个问题,也能覆盖超过 400 条的规则清单。预算限制为:每次请求内联数据 100 MB、每个 PDF 50 MB、外部 URL 15 MB。
对于少于 400 个问题的短文本且输入各不相同,两者按标价计算打平。可以先使用 Gemini 免费层和合成数据做原型,再用同一批 200–500 个已标注案例在两边重新测试,对比各置信度区间的准确率、p50/p95 延迟、每次请求 token 数和月度成本。
| 工作负载 | 选择 |
|---|---|
| 重复使用 5K–10K 策略文档,高 QPS | OpenAI Decisions API,缓存可节省 80% 以上 |
| 带工具调用历史的智能体路由、GPT-Live 语音 | OpenAI Decisions API |
| 音频 / 视频 / PDF 决策,规则数 >400 | Gemini Decisions API |
| 短文本、输入独特,问题数 <400 | 打平——选择现有技术栈 |
| 免费原型开发 | Gemini AI Studio,然后在付费环境重新评估 |
Gemini 比 OpenAI 便宜吗?
两者的标价都是每 100 万 token 0.10 美元,且不收取输出费用;面对重复的缓存上下文时 OpenAI 更划算,免费原型开发则是 Gemini 更占优势。
OpenAI 能读取音频、视频或 PDF 吗?
不能。OpenAI 只支持文本、图片、JSON 和工具调用对话;Gemini 可以原生处理音频、视频和 PDF。
每次请求最多能问多少个问题?
Gemini 支持 1–1,000 个问题,限制在 262,144 个 token 内;OpenAI 支持 1–400 个问题。
Gemini 已经适合生产环境了吗?
Gemini 目前是 v1beta,云端支持尚未到位;OpenAI 已 GA,并提供 ZDR、HIPAA 和区域处理。
还需要 Jev 或本地分类器吗?
Jev 的价格是每 100 万 token 0.042 美元,并在部分工具选择测试中领先;如果每个任务的成本是主要因素,就应该把它一起纳入基准测试。
低置信度结果该怎么处理?
根据标注数据设定阈值:高于阈值就自动执行,中间区间交给更大的模型,低于阈值则转人工审核,同时始终保留 other 选项。
相关阅读: