 AIREITER
按标准价格计算,一次包含 500 个 token 的路由判断只需 $0.00005。对高并发的前置筛选来说,OpenAI Decisions API 足够便宜;但这并不意味着它适合直接决定高风险动作——它返回的概率,仍然需要用你自己的标注数据进行校准。
费用按 token 计,不收单独的调用费
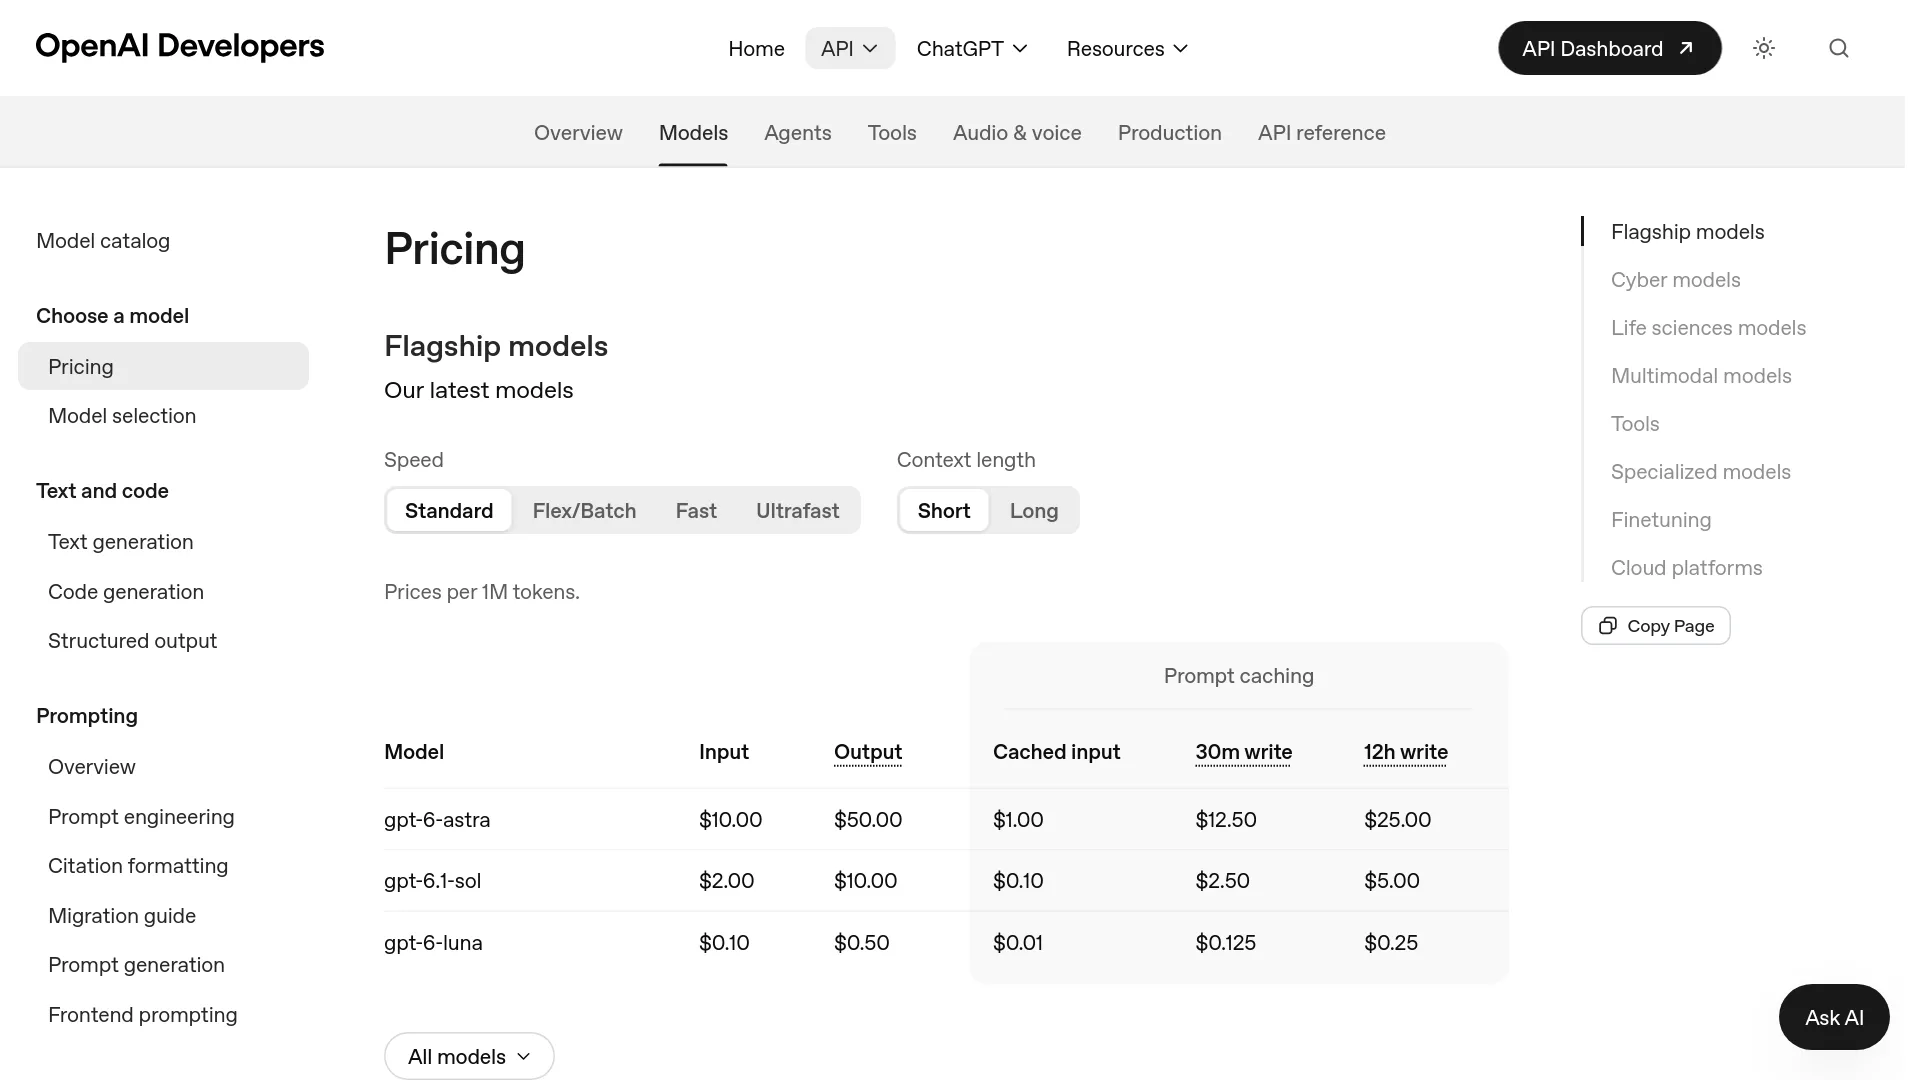
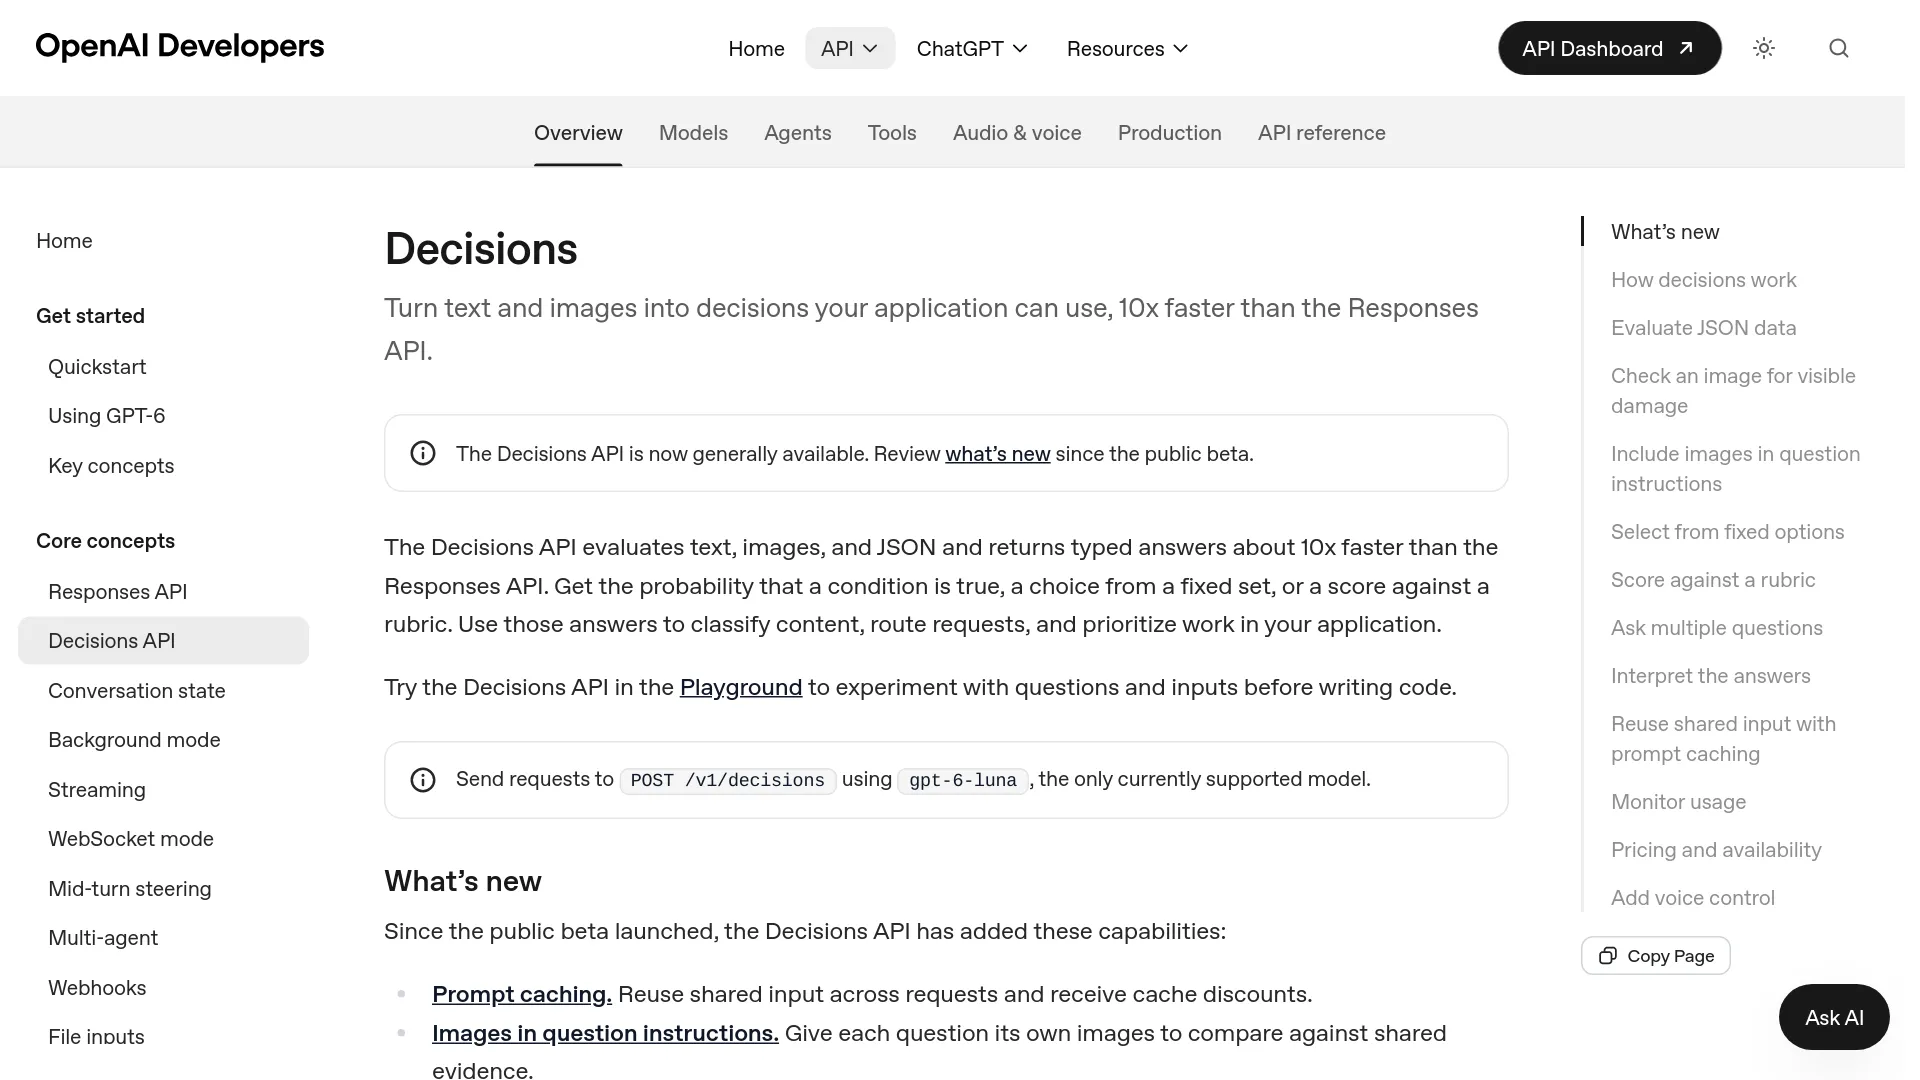
OpenAI Decisions API 的价格是每 100 万个未缓存输入 token 收费 $0.10,输出 token 免费。OpenAI 目前将该端点标记为正式可用(generally available),仅由 gpt-6-luna 驱动,并通过 当前 Decisions 指南中所示的 POST /v1/decisions 提供服务。
按目前公布的价格,没有额外的单请求费用。基本计算公式如下:
月度成本 = 请求数 × 平均计费输入 token 数 ÷ 1,000,000 × $0.10
每月 1 万、10 万和 100 万次请求要花多少钱
假设每次请求平均包含 500 个输入 token:
| 每月请求数 | 输入 token 数 | 标准输入成本 | 单次请求成本 |
|---|---|---|---|
| 10,000 | 5 million | $0.50 | $0.00005 |
| 100,000 | 50 million | $5.00 | $0.00005 |
| 1,000,000 | 500 million | $50.00 | $0.00005 |
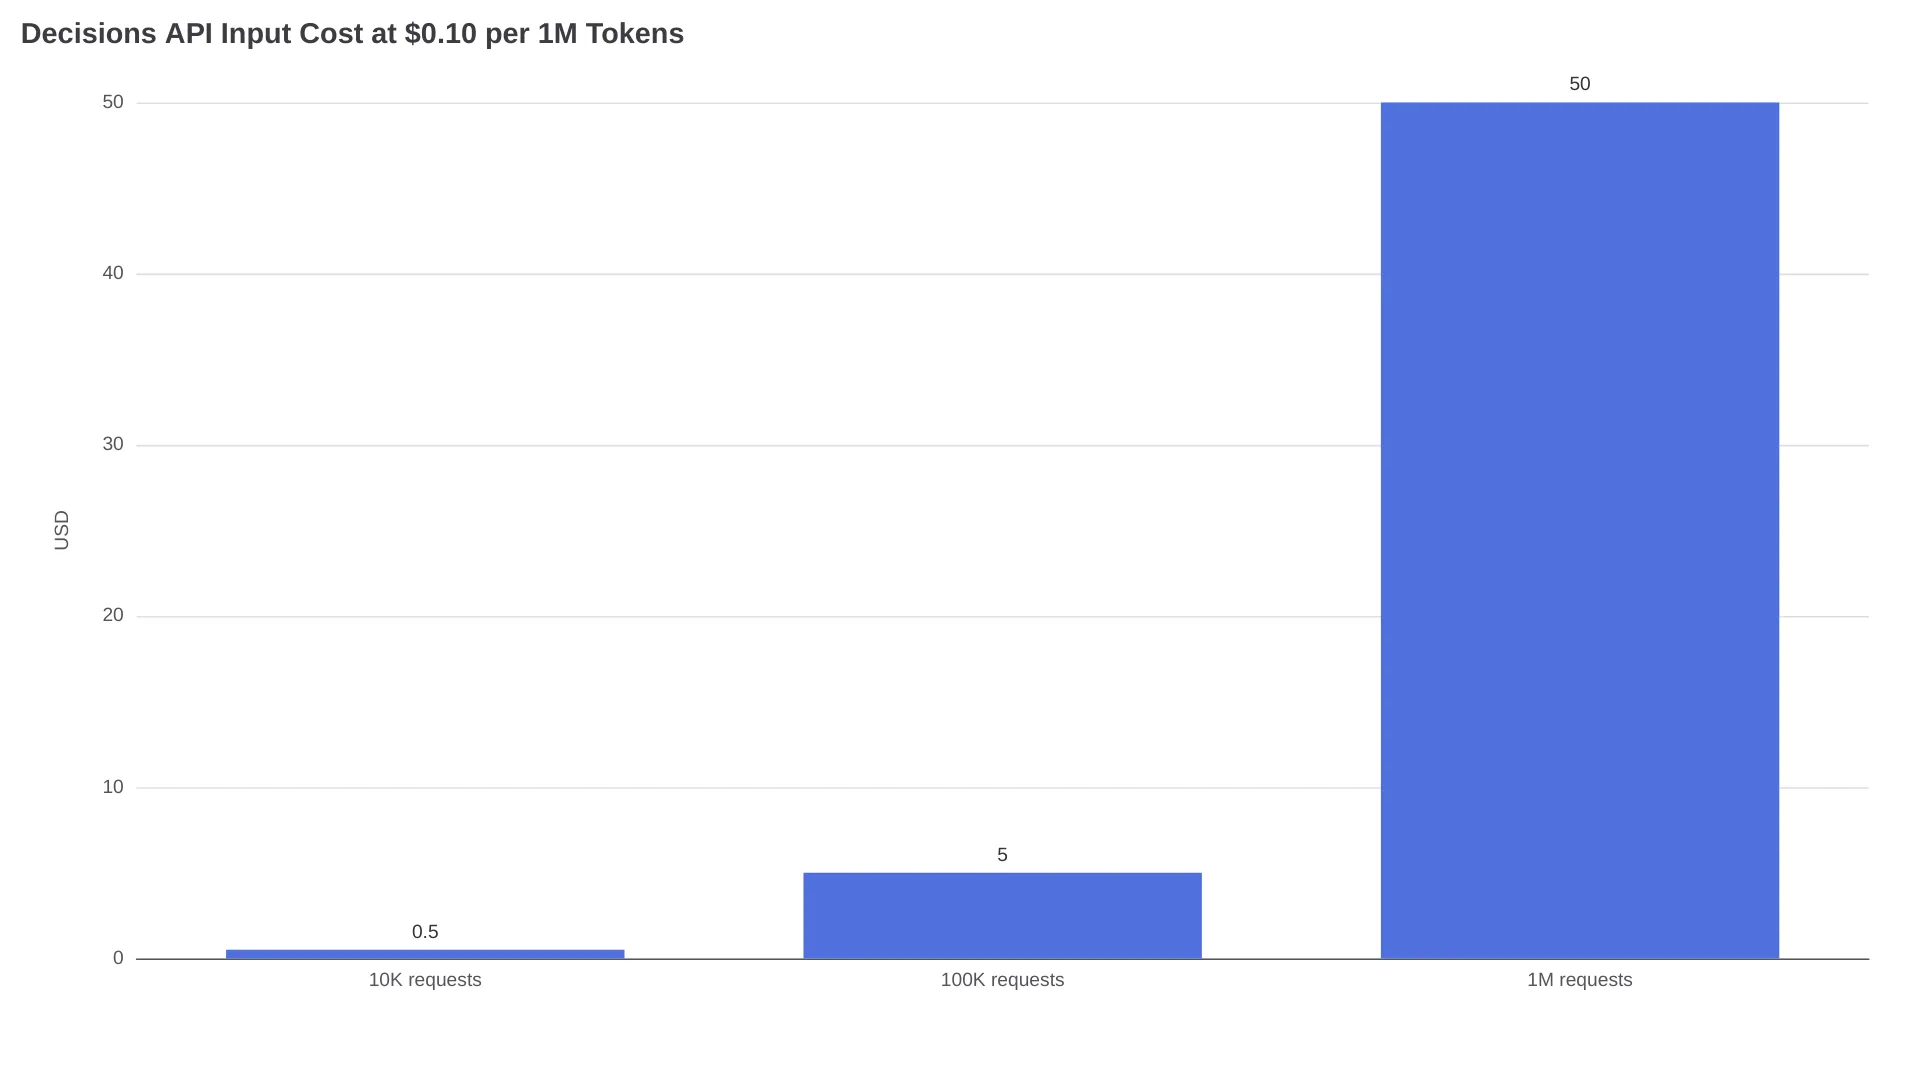
Predicate、choice 和 score 的输出不会产生额外的输出 token 费用。如果改用等价的 Responses JSON,则会按照模型的输出价格计费;OpenAI 价格表显示,标准 gpt-6-luna 输出价格为每百万 token $0.50。
缓存读取、写入、区域处理和长上下文
$0.10 只是最醒目的标准价格,并不是唯一可能的输入价格。当前指南说明,prompt cache 读取享受折扣,而缓存写入则使用 gpt-6-luna 的标准缓存写入价格。OpenAI 的价格表显示,标准 Luna 缓存输入为每百万 token $0.01,30 分钟缓存写入为$0.125,12 小时缓存写入则为每百万 token $0.25。
只有当可复用的共享输入前缀至少包含1,024 个 token时,缓存才会生效。问题内容不计入这一最低门槛,针对具体问题的图片也不属于可复用前缀。根据 prompt caching 章节,缓存读取和写入已经包含在 usage.input_tokens 中;再次加总会造成重复计算。
对于符合条件的新模型,区域端点或数据驻留端点可能增加10% 的费用。官方价格与可用性说明还提醒,长上下文可能适用额外倍率。如果你要部署合规相关工作负载,正式承诺前应查看实时价格表,因为这两类调整都可能改变原本简单的 $0.10 计算结果。
这个端点从设计上就很专一
Decisions API 会把证据转换成三种类型化结果之一。它是分类器和评分器,而不是一个更便宜的通用响应端点。
| 问题类型 | 返回结果 | 适合场景 | 不适合场景 |
|---|---|---|---|
predicate | 0 到 1 之间的概率 | 欺诈拦截、可见损伤检查、相关性过滤 | 需要给出文字理由的判断 |
choice | 一个指定选项、各选项概率和置信度 | 队列路由、文档分类、下一步动作 | 未知或动态生成的类别 |
score | 加权分数、各等级概率和置信度 | 严重程度、紧急程度、线索质量 | 提取姓名、日期或任意字段 |
一次 score 请求可以包含2 到 10 个有序等级。单个请求可以携带1 到 400 个问题,但只有相互独立的问题适合放在同一个请求中。如果第二个问题依赖第一个问题的答案,OpenAI 建议先拿到第一个答案,再发起第二次请求。
多个相互独立的问题可以复用同一份证据。例如,一张客服工单可以同时用于判断退款意图、分派给对应部门,并评估紧急程度,而不必把工单重复发送三次。根据 用量指南,num_model_requests统计的是请求数,而不是问题数。
公开测试版之后有哪些变化
当前的 What's new 列表显示,相比早期发布版本,主要限制已经发生了这些变化:
- 问题上限从200 个提高到 400 个。
- 共享输入现在支持 prompt caching。
- 输入支持原生 JSON、对话历史、函数调用记录,以及相匹配的工具输出。
- 图片可以使用公开的 HTTP/HTTPS URL 或内联 base64;
file_id、音频、文件和 item 引用仍不受支持。 - 组织级用量报告可通过
GET /v1/organization/usage/decisions获取;该接口需要带有api.usage.read权限的管理员密钥,并支持按项目、API key 或模型进行分组。
根据输出契约选择 Decisions 还是 Responses
如果应用代码已经明确规定了允许返回的答案形式,就用 Decisions API。如果需要模型组织信息、生成内容,则使用 Responses;如果需要模型选择工具并填充参数,则使用 function calling。
| 需求 | 默认选择 | 原因 |
|---|---|---|
| 带概率的“是/否”判断 | Decisions | 原生 predicate 输出,不产生生成答案费用 |
| 从已知路由中选择一个 | Decisions | 会返回每个选项的概率和整体置信度 |
| 按照有序标准进行分级 | Decisions | 原生支持加权分数和各等级分布 |
| 返回任意 JSON 字段 | Responses with Structured Outputs | Decisions 不支持自定义 JSON 输出 schema |
| 解释某个项目为何被拒绝 | Responses | Decisions 不会生成文字解释 |
| 选择工具并生成参数 | Function calling | Decisions 只选择答案,不会生成工具参数 |
如果有 100,000 次调用、每次包含 400 个输入 token,Decisions 的输入成本为 $4。假设等价的 Responses 调用每次生成 30 个输出 token,按照 Luna 公布的价格计算,输入成本为 $4,输出成本为 $1.50,合计 $5.50,且还未计入任何 reasoning token。最终选哪个端点,仍取决于应用是否需要生成字段或解释文本。
现在两个端点都支持折扣后的缓存读取。不要根据 prompt 长度估算命中情况,而应直接读取响应 usage 对象中的缓存命中 token 数。
便宜的错误,代价依然可能很高
低 token 账单并不会降低误批准、错误的内容审核动作或错误支付路由所带来的损失。OpenAI 的答案解读指南建议使用带标签的样本设置阈值,并分别衡量误报和漏报的代价。
开发者社区也提到了类似风险。在一个面向生产实践的决策 API Reddit 讨论帖中,u/Ctbhatia 写道:
“一个会说跳过的 gate,也比一个自信地猜错的 gate 好。” 来源:u/Ctbhatia on r/LLMDevs
API 返回的置信度和概率只是参考信号,并不代表 OpenAI 提供了公开的校准保证。在代表性数据上验证之前,不能因为某个结果的置信度是 0.90,就默认它有 90% 的概率正确。
OpenAI 在官方指南中称,Decisions 的速度约为 Responses 的10 倍,但没有公布 p50、p95、区域、负载大小或对比配置。正式制定延迟预算前,应在计划部署的区域进行基准测试。
上线前的关键步骤:校准、允许弃答,再自动化
- 从真实工作负载中建立带标签的数据集,覆盖模棱两可的案例和代价高昂的失败模式。
- 在这组数据上运行同样的问题,绘制不同阈值下的误报率和漏报率。
- 在应用代码中加入明确的弃答路径。低置信度或相互冲突的结果应进入人工审核,而不是被迫选择一条路线。
- 通过
GET /v1/organization/usage/decisions监控 token 用量和请求数,并在上线后抽样审查自动化结果。
部署选择对照表
对于 OpenAI 技术栈内已有的短文本、高并发、边界明确的评估任务,OpenAI Decisions API 是一个合适的默认选择。但仅凭价格低,并不足以成为迁移理由。
| 工作负载 | 建议 | 主要前提 |
|---|---|---|
| 客服或线索路由 | 使用 Decisions | 类别固定,并且有可用的标注样本 |
| 图片损伤筛查 | 试用 Decisions | 对图片准确率进行基准测试;现在已支持托管 URL |
| 长政策文本加短项目 | 同时测试两个端点 | 确认实际缓存命中 token 数和延迟 |
| 合规或破坏性操作 | 仅将 Decisions 用作 gate | 必须支持弃答、人工审核和非对称阈值 |
| 信息提取加解释 | 使用 Responses | 一次更丰富的调用可能避免再次发起生成请求 |
| 带参数的工具选择 | 使用 function calling | 输出契约能够直接对应具体动作 |
| 欧盟或受监管工作负载 | 考虑 Decisions | 确认资格、数据驻留要求和区域加价 |
OpenAI Decisions API 价格常见问题
Decisions API 按请求还是按 token 收费?
它按输入 token 收费,而不是按请求收费。标准未缓存输入目前为每百万 token $0.10,实际价格还要考虑缓存以及适用的区域或长上下文调整。
Decisions API 的输出 token 免费吗?
免费。官方 Decisions 指南明确说明,输出 token 不收费。
有免费额度吗?
OpenAI 当前的 Decisions 文档没有列出专门的免费层级。不过,账户余额或合同条款仍可能影响组织最终支付的金额。
Decisions API 支持 prompt caching 吗?
支持。长度至少为 1,024 个 token 的共享输入前缀可能符合缓存条件。OpenAI 默认会在共享输入末尾设置一个隐式断点。问题内容和针对具体问题的图片不属于这一可复用前缀。
Decisions 比 Responses API 便宜吗?
对于不需要生成文本的短文本、边界明确的分类任务,通常更便宜。但如果 Responses 只输出很少的内容,价格优势可能缩小;如果工作流还需要额外调用来完成提取或解释,优势甚至可能消失。
一次请求最多可以放多少个问题?
当前限制是 1 到 400 个问题。相互独立的问题可以共享输入;存在依赖关系的问题则需要分开发起请求。
支持图片吗?图片如何计费?
支持。Decisions 接受托管的 HTTP/HTTPS 图片 URL 和内联 base64 图片,图片输入会计入计费输入用量。file_id 图片引用不受支持。
区域处理会更贵吗?
可能会。OpenAI 的价格页面显示,对于符合条件的新模型,区域端点和数据驻留端点会增加 10% 的费用;部署前应确认目标区域的实时价格。