 AIREITER
Gemini 4 Carbon 不该成为默认模型。只有那些能持续跑一整晚、并从反复验证中获益的重型任务,才值得为它折腾:多智能体重构、基于 200 个视图构建文档,或从漏洞利用验证一路推进到补丁修复。Google 自己也表示,Gemini 4 Argon 依然是大多数软件工程和知识工作的理想选择;Carbon 面向的是最棘手的任务,同时也会消耗更多 token。
Gemini 4 Carbon 是建立在 Gemini 4 Argon 之上的前沿推理模型。Google 于 2026 年 10 月 28 日公布 Carbon,并在 2026 年 11 月 10 日正式全面上线。DeepMind 模型卡显示,其知识截止时间为 2026 年 3 月,输入与输出合计最高支持 100 万 token;可接收文本、文档、图像、音频和视频,输出为文本。
现在谁能用上 Carbon
Gemini 4 Carbon 的访问权限按渠道划分,普通消费者能用到的范围最窄。开发者可通过 Google AI Studio 的付费 Gemini API 层级使用,也可在 Android Studio 和企业版 Gemini 中使用。消费者则必须订阅 Google AI Ultra,才能在 Gemini 应用、搜索中的 AI Mode 以及 Google Antigravity 中使用 Carbon。科研人员可以申请 Antigravity 最高使用层级的六个月免费资格,经过验证的防御人员则可通过 Fairwind Program 申请。
Google AI Pro 订阅用户无法在消费端产品中使用 Carbon,这一限制在 r/GeminiAI 上线讨论帖中被反复提及。
“Ultra 才能用。Pro 上的 Argon 两个提示就没了。”——u/Nodayssoff,发表于 r/GeminiAI
已链接的上线资料没有说明固定的消费者配额、Pro 层级的开放日期,或各国是否同步可用。访问讨论帖和配额讨论帖中的用户反馈称,5 小时及每周额度几次提示就会耗尽;同一把密钥可能在一个入口可用、在 Antigravity 却被拦截;首日还出现过 An internal error has occurred 错误。把 Ultra 当作 Carbon 测试席位来预算,不要将其视为无限量使用资格。
Carbon 和 Argon 的核心差别
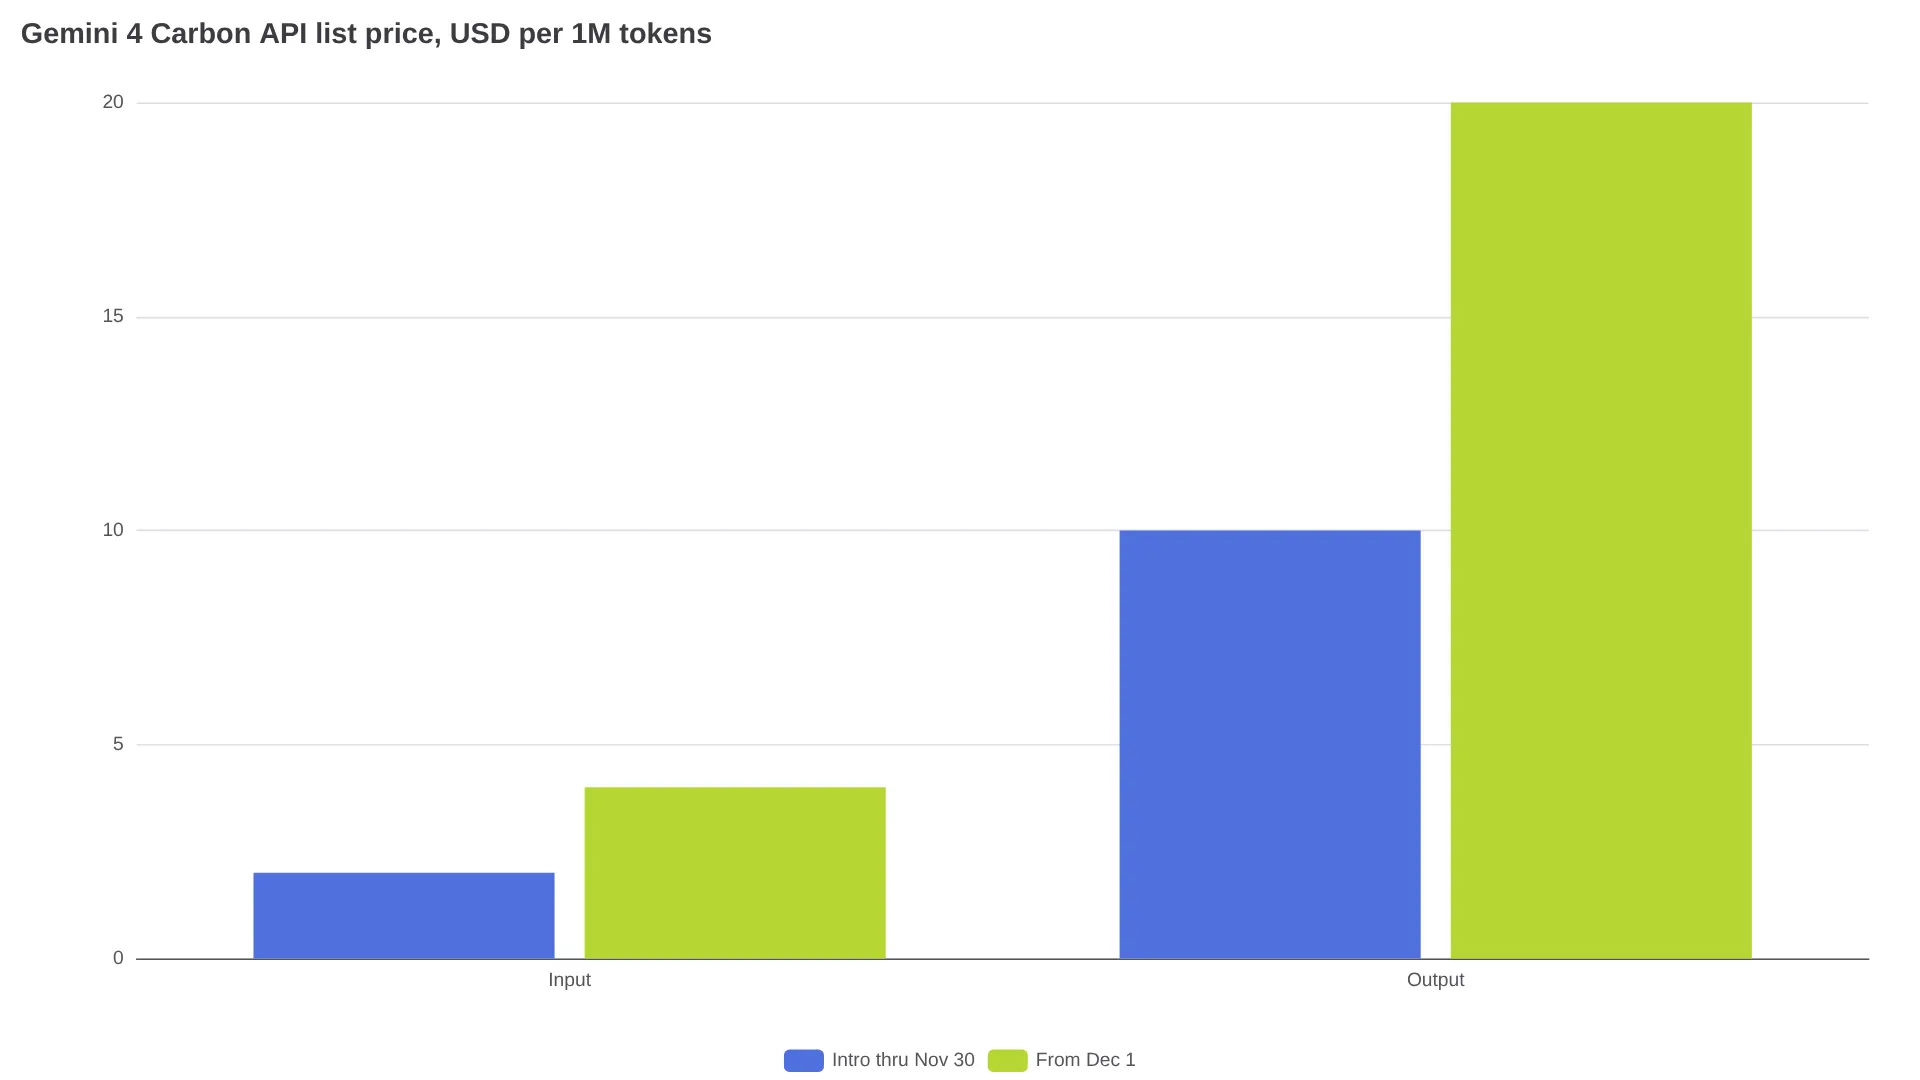
Gemini 4 Carbon 与 Gemini 4 Argon 的标价和上下文规模相同,真正拉开差距的是能力、延迟与 token 消耗倾向。
| 项目 | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| 定位 | 基于 Argon 构建,为高难度、长周期任务提供更强推理 | 基础前沿模型,常规工程任务的默认选择 |
| 全面上线 | 2026 年 11 月 10 日 | 根据 ToolColumn 对比,为 2026 年 10 月 13 日 |
| API 模型 ID | 调用时请在 AI Studio 中确认;上线公告未给出单独的稳定 ID | 根据 ToolColumn 对比,为 gemini-4-argon |
| API 标价,2026 年 11 月 30 日前的介绍期价格 | 每 100 万 token:输入 $2 / 输出 $10,缓存输入 $0.10 | 每 100 万 token:输入 $2 / 输出 $10,缓存输入 $0.10 |
| API 标价,自 2026 年 12 月 1 日起 | 每 100 万 token:输入 $4 / 输出 $20 | 每 100 万 token:输入 $4 / 输出 $20 |
| 上下文 | 输入 + 输出合计最高 100 万 token | 根据 ToolColumn 对比,为 1,048,576 token |
| 输入模态 | 文本、文档、图像、音频、视频 | 根据 Artificial Analysis,为文本、图像 |
| Artificial Analysis Intelligence Index v5.0.1 | 60 | 50 |
| 每项指数任务的加权成本 | $7.76 | $9.95 |
| 输出速度 | 82 tok/s | 68 tok/s |
| 首个回答 token 延迟 | 67.54 秒 | 40.02 秒 |
| 思考等级 | 可配置;等级越高,token 消耗越大 | 根据 ToolColumn 对比,提供 Low / Medium / High,默认 Medium |
价格来自 Google 的可用性公告;速度、延迟、单任务成本和模态差异来自 Artificial Analysis 的 Carbon vs Argon 对比。缓存输入可享标价 95% 折扣,按介绍期价格计算,即每 100 万 token 为 $0.10。
两者标价相同,但实际工作负载成本并不一样。Artificial Analysis 的记录显示,Carbon 每项加权 Intelligence Index 任务成本为 $7.76,低于 Argon 的 $9.95,尽管 Carbon 平均每项任务会多输出约 7,000 个 token。Carbon 完成加权任务平均需 24.9 分钟,Argon 则为 28.6 分钟;但 Carbon 等到首个回答 token 需要 67.54 秒,Argon 仅需 40.02 秒。换句话说,Carbon 持续干活更强,但起步响应更慢。
Carbon 真正领先的场景,以及不值得切换的地方
Google 公布了 17 项评测,下面列出部分 Carbon 对比 Argon 的结果。Gemini 4 Carbon 在 17 项中全部领先 Gemini 4 Argon,并在五模型整体对比中拿下 15 项第一。不过另外两项也值得注意:GPT-6 Astra 在 FrontierSWE 2 上以 65.5% 领先 Carbon 的 61.2%;Claude Opus 5.5 在 OSWorld-2.1 offline 上以 87.2% 领先 Carbon 的 81.5%。
| 工作负载 | 基准测试 | Carbon | Argon | 差距 |
|---|---|---|---|---|
| 智能体编程 | SWE-sweep | 9.6% | 4.3% | +5.3 个百分点 |
| 智能体编程 | Terminal-Bench 4.0 | 65.2% | 57.1% | +8.1 个百分点 |
| 智能体编程 | FrontierSWE 2 | 61.2% | 55.0% | +6.2 个百分点,但仍落后 Astra |
| 计算机操作 | Agents' Last Exam v1.1 | 77.4% | 69.0% | +8.4 个百分点 |
| 计算机操作 | OSWorld-2.1 offline | 81.5% | 74.7% | +6.8 个百分点,但仍落后 Opus 5.5 |
| 知识工作 | AutomationBench, Zapier | 53.9% | 51.3% | +2.6 个百分点 |
| 知识工作 | Vending-Bench 2 balance | $16,484 | $13,718 | 模拟余额 +$2,766 |
| 长上下文 | GraphWalks 256K-1M BFS F1 | 96.2% | 84.2% | +12.0 个百分点 |
| 科学 | Terminal-Bench-Science 0.1 | 64.8% | 52.9% | +11.9 个百分点 |
| 科学 | RiemannBench | 80.0% | 76.0% | +4.0 个百分点 |
| 网络安全 | ExploitGym | 54.8% | 42.0% | +12.8 个百分点 |
| 网络安全 | SEC-bench Pro | 88.2% | 83.4% | +4.8 个百分点 |
| 网络安全 | CWE-bench | 71.0% | 68.0% | +3.0 个百分点 |
以上数据均来自 2026 年 10 月的 DeepMind 模型卡表格。网络安全项目反映的是无护栏的 Fairwind 访问能力,并不代表标准产品行为。该模型卡还补充了 Chartography(72.5% vs 71.6%)、Vals Index(70.4% vs 69.2%)、AA Index v5.0(59 vs 50)以及 Blueprint-Bench 2 similarity(58.6% vs 54.4%),由此补全全部 17 项。
- 最硬核的技术任务:Carbon 的最大优势集中在漏洞利用验证、256K-1M 图检索、终端科学任务和多步骤终端编程。
- 常规知识工作:在图表阅读、通用评测和办公自动化上,差距收窄至 1-3 分。
- 诚实性与安全性:Google 在Carbon 发布文章中称,Carbon 在 375 项任务上的智能体诚实性通过率为 92%,Argon 为 70%;间接提示注入成功率为 0.0%,Argon 为 0.7%;无依据的陈述数量也大致减半。
Artificial Analysis 显示 Carbon 在 Intelligence Index 的全部九个组成项中领先,其中物理推理和开放仓库工程的优势尤其明显,例如 FrontierCode 2.0 为 40.6%,Argon 为 25.7%。Google 的可用性公告还单独宣称,Carbon 在 CursorBench 4.0、Perplexity WANDR 和 Zapier AutomationBench 上均排名第一,且单任务成本比排名第二的外部模型低超过 2 倍。
哪些任务交给 Carbon,哪些继续留在 Argon
如果验证循环本身足以回本,就该用 Gemini 4 Carbon。例如,Google 的可用性公告提到,基于 200 多个 PDF 工程图视图进行 10 轮过夜 Three.js 重建,以及多智能体 /swarm 物理项目构建,都是它适合的任务。下面这个社区作品规模更小,但很好地说明了这种模式。
“用 Gemini 4 Carbon 出门摸草。没有游戏引擎或 3D 库,我从零开始用 CUDA 和 C++ 做出了这片草地。里面有 5.2 万株草和野花;最后我还用 C++ 合成了风声,让同一阵风 [驱动音频]。”——@GlitterPixely,发表于 X
日常任务仍然留给 Gemini 4 Argon。Carbon 在图表阅读和办公自动化上的实测优势最小,因此单文件修改、标准 CRUD 工作、格式固定的电子表格,应先用 Argon。这样既能避开 Carbon 更慢的首 token 响应,也能控制更高的 token 消耗。短篇创作任务若开 High 思考等级,token 会很快烧掉;一份OpenRouter 用户报告提到,一篇 4,000 字符的故事在 High 下消耗了约 6,000 个思考 token。
实操上,先让新智能体以 Argon Medium 运行,验证提示词、配额和工具权限。只有那些失败的长尾任务才迁移到 Carbon:跨包迁移、跨子系统根因排查、包含工程图和表格的 100K+ token 文档集,以及 Fortify 式的扫描—分诊—修复闭环。Google 的可用性公告称,其内部测试中这一流程达到了 100% 扫描召回率和 95% 分诊精度。在 /swarm 中,让 Carbon 担任架构师、协调者和对抗式验证者,把并行工作区交给更轻量的模型。如果 Carbon 运行时反复出现内部错误,先换一个新会话重试,再考虑提高思考等级;首日讨论帖中的错误原因并不明确。
12 月 1 日后如何控制 Carbon 成本
API 标价在 12 月 1 日翻倍后,最有效的成本杠杆就是积极使用输入缓存。对于反复使用的代码仓库、工程图和工具输出,缓存输入可享 95% 折扣。
不要只按标价做预算。Carbon 在每项实测任务中会产生更多输出 token,因此无论使用哪一个模型,一个月 50M 输入 / 5M 输出的用量,按标价会从介绍期的 $150 翻倍到介绍期后的 $300,这还没计入 Carbon 额外的思考消耗。不过,Artificial Analysis 仍记录到 Carbon 完成单项 Intelligence Index 任务的加权成本更低,因为更少的重试和更快的持续吞吐抵消了 token 量。原则很简单:在 Carbon 领先 8-13 分的漏洞利用链和终端科学任务中使用 High;文档和 UI 打磨上领先仅 1-3 分时,则使用 Medium 或 Low。
如需查看更细的逐项计算,请参阅本站的 Gemini 4 Carbon API 定价评测。
Gemini 4 Carbon 常见问题
Google AI Pro 以后会有 Carbon 吗?
已链接的资料没有给出 Pro 的开放日期。继续使用 Argon,并把 Ultra 视为短期测试 Carbon 的席位。
哪个思考等级最影响账单?
Medium 用于验证提示词;High 留给漏洞利用链和终端科学这类有 8 分以上优势的任务。
Carbon 和 Argon 共用配额吗?
目前没有明确的共享配额文档。请按产品入口查看账户的实时限制;100 万指的是上下文容量,不是使用配额。
按工作类型直接选
| 如果你的工作是 | 建议 | 原因 |
|---|---|---|
| 本周交付,常规代码和文档 | Argon Medium | 差距只有 1-3 分,首 token 更快,消耗更低 |
| 持续数日的迁移,100K+ token 仓库加工程图 | Carbon,跑通后降至 Medium | 终端和长上下文任务领先 +8-12 分 |
| 扫描、分诊并修复开源漏洞 | 通过 Fairwind/API 使用 Carbon | 模型卡中 ExploitGym 领先 +12.8 分;安全代码率超过 Argon 的 2 倍 |
| 带图表的金融/法律文档智能体 | 先用 Argon,有争议的数字再用 Carbon | 根据可用性公告,Carbon 在 Multimodal Knowledge Agent 排名第 2,单任务成本比第一名低 6 倍;但 Argon 在 AutomationBench 上非常接近 |
| 每周额度紧张的 Ultra 订阅用户 | 日常用 Argon,Carbon 留给一次高难度运行 | 有用户称 Carbon 几次提示就会耗尽额度 |
Carbon 是应该按高难度任务临时调用的专家,而不是默认模型。日常队列交给 Argon;只有当验证循环和从漏洞利用到补丁的深度会决定结果时,Carbon 才配得上 12 月后的标价。