如果你的账单按 token 计算,Gemini 4 Neon API 的价格关键在于时间点:接下来 11 天里 Carbon 更便宜,而从 12 月 1 日起,Neon 会便宜 25%。Google 于 2026 年 11 月 18 日推出Gemini 4 Neon,定价为每 100 万输入 token $3、每 100 万输出 token $15,支持 1M token 上下文窗口,且没有免费层。
11 月 30 日的调价,是整个价格比较的分水岭
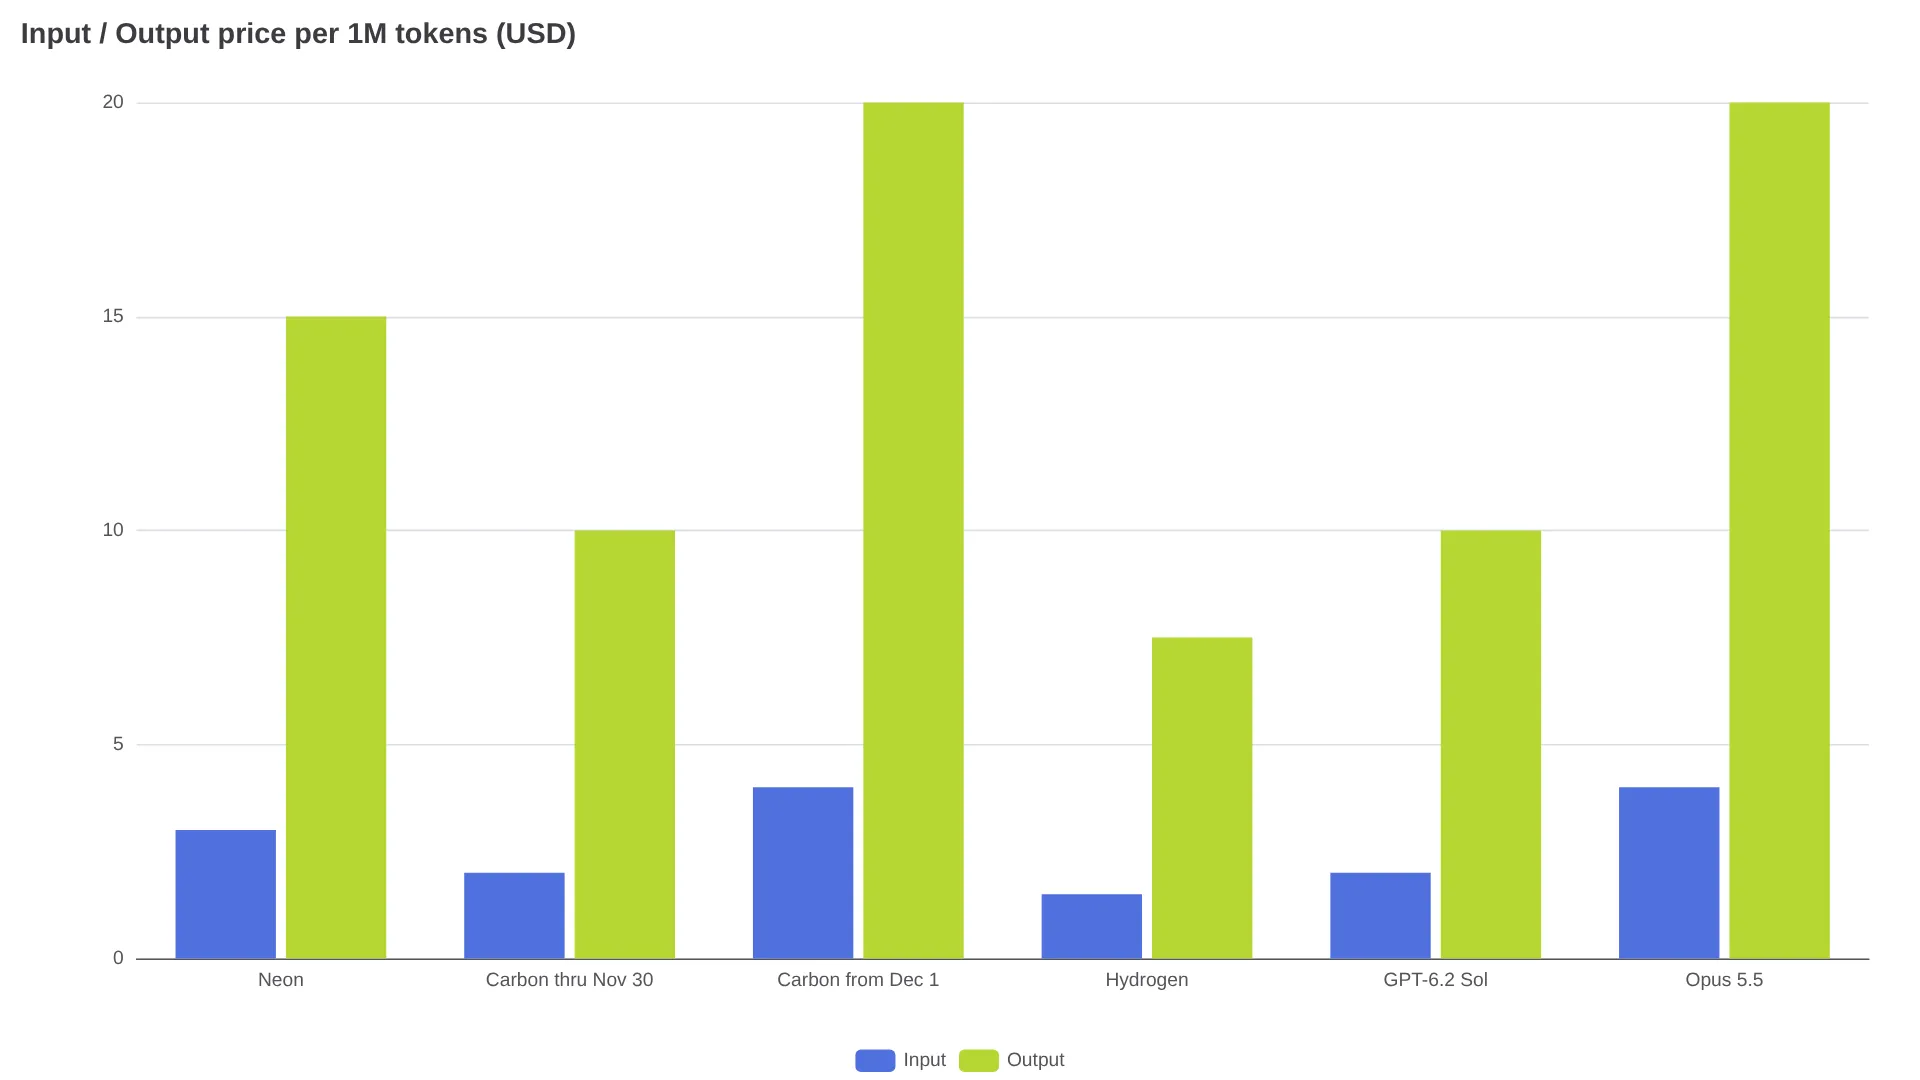
Gemini 4 Neon API 的价格不能脱离日期单独看。在 2026 年 11 月 30 日之前,Gemini 4 Carbon 处于促销价阶段,每 100 万 token 的输入/输出价格为 $2/$10;从 12 月 1 日起,Carbon 和 Argon 都会调整到 $4/$20。届时 Neon 的 $3/$15 价格将比 Carbon 低 25%(价格对比)。但在 11 月 30 日之前,按促销价计算,Neon 反而比 Carbon 贵 50%。
Google 更强调每项任务的成本:据其说法,在高思考级别下,Neon 的单任务成本比 Carbon 低 32%;在 xhigh 下,至少比未指明名称的竞品节省 36%(发布分析)。实际预算仍应以公开的 $3/$15 token 价格为准,因为这些单任务数据是 Google 自己报告的,且没有给出明确的对比基准。
Gemini 4 产品线中的 Neon,定位在哪里
Gemini 4 Neon 属于中间档:推理深度高于 Hydrogen,质量接近 Carbon,但执行速度更快,这是OpenRouter 对模型定位的描述。Carbon 曾是前沿编程场景的默认选择,Argon 是面向数学和科学任务的旗舰推理模型,而 Hydrogen 则是每 100 万 token $1.50/$7.50、适合大规模调用的主力型号(价格索引)。Neon 支持 low、medium、high、xhigh 四档推理级别,默认使用 high(供应商规格)。
根据Google 公告和发布拆解,Neon 上线时的可用情况如下:
| 入口 | Neon 访问方式 |
|---|---|
| Gemini API | 面向付费开发者,模型 ID 为 gemini-4-neon(模型目录) |
| AI Studio / Gemini app / Antigravity | 付费层,以及 Google AI Pro 和 Ultra |
Antigravity 中的 Neon 标签需要谨慎对待。Antigravity 讨论帖中的用户报告称,在部分会话里,编排器入口可能仍然解析到 Carbon 的系统提示词;其中一条回复直接概括为“它只是编排器,不是 Neon”(讨论帖)。在 Google 公布构建 ID 映射之前,计费时应以 API 模型 ID 为准,而不要只看 UI 标签。
$3/$15 这组价格到底包含什么
标准价格为每 100 万 token 收取 $3.00 输入、$15.00 输出,以及 $0.15 缓存输入(官方公告);整个 1,048,576-token 上下文窗口均采用这一费率(价格核查)。第三方索引列出的 Batch 为 $1.50/$7.50、Flex 为 $1.50/$7.50、Priority 为 $5.40/$27.00(见规格和供应商价格表)。不过,Neon 上线时 Google 的通用价格页面尚未公布 Batch、Flex、Priority 价格,因此在页面更新前,应按仅支持 Standard 来做预算(发布分析)。
通用计算公式:成本 = 新输入 token 数 / 1M × $3 + 缓存输入 token 数 / 1M × $0.15 + 包含思考 token 在内的输出 token 数 / 1M × $15。
- 思考 token 按输出计费。输出单价为 $15,几乎总会主导最终账单。
- 缓存仅支持隐式缓存,提示词至少需要 4,096 token;符合条件的缓存输入可享受 95% 折扣。不支持显式
cachedContents缓存,也不收取缓存写入费用。 - 同步输出上限为 65,536 token(规格)。需要更长输出时,必须使用后台执行。
短于 4,096 token 的提示词无法获得任何缓存优惠(价格参考)。因此,一个输入仅 1,200 token 的客服机器人根本用不上 $0.15 的缓存输入价格。
两个实际工作负载的成本模型
以下模型按固定 token 数计算,不包含重试,也不考虑推理长度变化。重点在输出占比。所有行都使用相同的缓存比例,并套用发布价格表中各模型自己的列表价格。
编程会话:50 次调用,每次 80,000 个输入 token,其中 90% 来自缓存;每次输出 2,500 个 token,包括思考 token。合计为:400,000 个新输入 token、3.6M 个缓存 token、125,000 个输出 token。
| 模型 | 会话成本 |
|---|---|
| Gemini 4 Neon $3/$15 | $3.62($1.20 新输入 + $0.54 缓存 + $1.88 输出 = $3.615) |
| Carbon,11 月 30 日前 $2/$10 | $2.41 |
| Carbon,12 月 1 日起 $4/$20 | $4.82 |
| Hydrogen $1.50/$7.50 | $1.81 |
| GPT-6.2 Sol $2/$10 | $2.41 |
大规模客服:每天 10,000 次对话,持续 30 天;每次对话 6,000 个输入 token,其中 75% 符合缓存条件,输出 500 个 token。合计为:450M 个新输入 token、1.35B 个缓存 token、150M 个输出 token。
| 模型 | 月度成本 |
|---|---|
| Gemini 4 Neon $3/$15 | $3,802.50(其中 $2,250 为输出成本) |
| Carbon,11 月 30 日前 $2/$10 | $2,535.00 |
| Carbon,12 月 1 日起 $4/$20 | $5,070.00 |
| Hydrogen $1.50/$7.50 | $1,901.25 |
| GPT-6.2 Sol $2/$10 | $2,535.00 |
按 token 价格计算,Neon 的成本是 Hydrogen 的 2 倍,比 $2/$10 的 Sol 贵 50%。因此,Neon 只有在用更少 token 或更少重试完成任务时,才可能在单任务成本上占优。相关基准数据——Intelligence Index 排名第 3、Coding Agent Index 排名第 1——均由厂商自行报告,不能证明其真实任务成本更低(基准汇总)。
Token 价格不等于你的使用配额
应用里的百分比,不能直接换算成 API 费用。一位 Pro 用户表示,在长上下文 Neon 会话中,每条消息的用量大约为 1-2%:
我也试着把已有的长上下文对话切换到 Neon,每条消息大约消耗 1-2%,看起来这个模型在 Pro 套餐上真的能用!——u/biblecrumble(讨论帖)
应用配额受五小时窗口、思考级别和工具调用影响;API 计费则会计算所有已处理 token,包括思考 token,此外每次 Search grounding 查询还会单独计费(发布分析)。API 项目应按上面表格中的美元成本做预算,订阅套餐的余量则要根据你自己在 high 和 xhigh 下的实际运行情况判断。
改一行模型 ID,再处理三个兼容性问题
从 Carbon、Argon 或 Hydrogen 迁移时,只需将模型 ID 改为 gemini-4-neon(发布分析)。不过,下面三个问题仍可能导致调用失败(发布分析):
- 显式设置
thinking_level。Neon 的默认值为 high。 - 移除
cached_content字段。Neon 不支持显式缓存。 - 移除
temperature、top_p、top_k。超出范围的值会返回 HTTP 400,其他值则会被忽略。
另外,将 max_output_tokens 调高至 65,536 附近;如果输出很长,则使用后台执行。
现在就切换,还是先把 Carbon 用到 11 月底
| 场景 | 选择 |
|---|---|
| 需要在 11 月 30 日前上线,并追求最大推理能力 | 继续使用 Carbon $2/$10,同时并行测试 Neon |
| 12 月上线生产环境智能体,需要长上下文 | Neon $3/$15 是列表价格上的候选方案——切换前先验证任务成功率和重试次数 |
| 高并发的简单聊天 | 继续使用 Hydrogen $1.50/$7.50;在这组模型中,只有它提供免费层(价格索引) |
| 当前列表价格最低的前沿模型 | GPT-6.2 Sol,价格为 $2/$10,前提是你的技术栈支持 OpenAI |
| 需要 Batch 的明确价格依据 | 先等等——Neon Batch 尚未公布 |
常见问题
Gemini 4 Neon API 多少钱?
每 100 万 token 的输入价格为 $3,输出价格为 $15,缓存输入价格为 $0.15,依据Google公布的信息。
上下文和输出上限是多少?
输入上限为 1,048,576 token;同步输出上限为 65,536 token。
有免费层吗?
没有。Neon 仅面向付费用户;Hydrogen 仍保留免费层。
Batch、Flex 或 Priority 可以使用吗?
Google 在上线时尚未公布这些价格;第三方页面列出的 Batch/Flex 为 $1.50/$7.50,Priority 为 $5.40/$27——正式做预算前请先确认。
缓存如何工作?
仅支持隐式缓存,最低 4,096 token;符合条件的缓存输入可享受 95% 折扣。
模型 ID 是什么?
gemini-4-neon。
Neon、Hydrogen 和 Carbon 该怎么选?
大规模低成本调用选 Hydrogen;11 月 30 日前追求最低前沿模型 token 价格选 Carbon;12 月 1 日起,如果需要高级推理,选 Neon——它比 Carbon 的 $4/$20 价格低 25%。
一次 2,000 个输入 token 加 500 个输出 token 的请求要多少钱?
按列表价格计算为 $0.0135,未计入缓存。思考 token 按输出计费。