单看标价,Astra 每百万输入/输出 token 为 $8/$40,Sol 则是 $2/$10,前者正好贵 4 倍。但实际账单没有这么简单:下文的 FrontierCode 单任务成本显示,Sol 完成常规编程的成本约为 Astra 的五分之一($1.29 对 $5.97);而在最强的垂直领域测试中,Astra 领先约 4—10 分。若一次高质量运行能省掉多次重试,这部分优势就可能值回票价。
OpenAI 怎么收费,在哪里可以使用
OpenAI 将 Astra 定位为攻克最棘手项目的模型,将 Sol 定位为日常工作模型(发布公告)。ChatGPT/Codex 套餐用量与 API 消费是两套独立的计量体系:套餐用量不会支付 API 调用,API 调用也不会扣减套餐额度。两款模型均支持 1,050,000 token 的上下文窗口,单次请求最多可包含 922,000 个输入 token 和 128,000 个输出 token;支持文本和图像输入,仅输出文本。在 Responses 和 Chat Completions APIs 中,对应的模型 ID 分别为 gpt-6.2-astra 与 gpt-6.2-sol。
以下为标准 API 价格,按每百万 token 计算:
| 模型 | 输入 | 缓存输入 | 缓存写入(30 分钟) | 输出 |
|---|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $10.00 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra(前代) | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol(前代) | $2.00 | $0.10 | $2.50 | $10.00 |
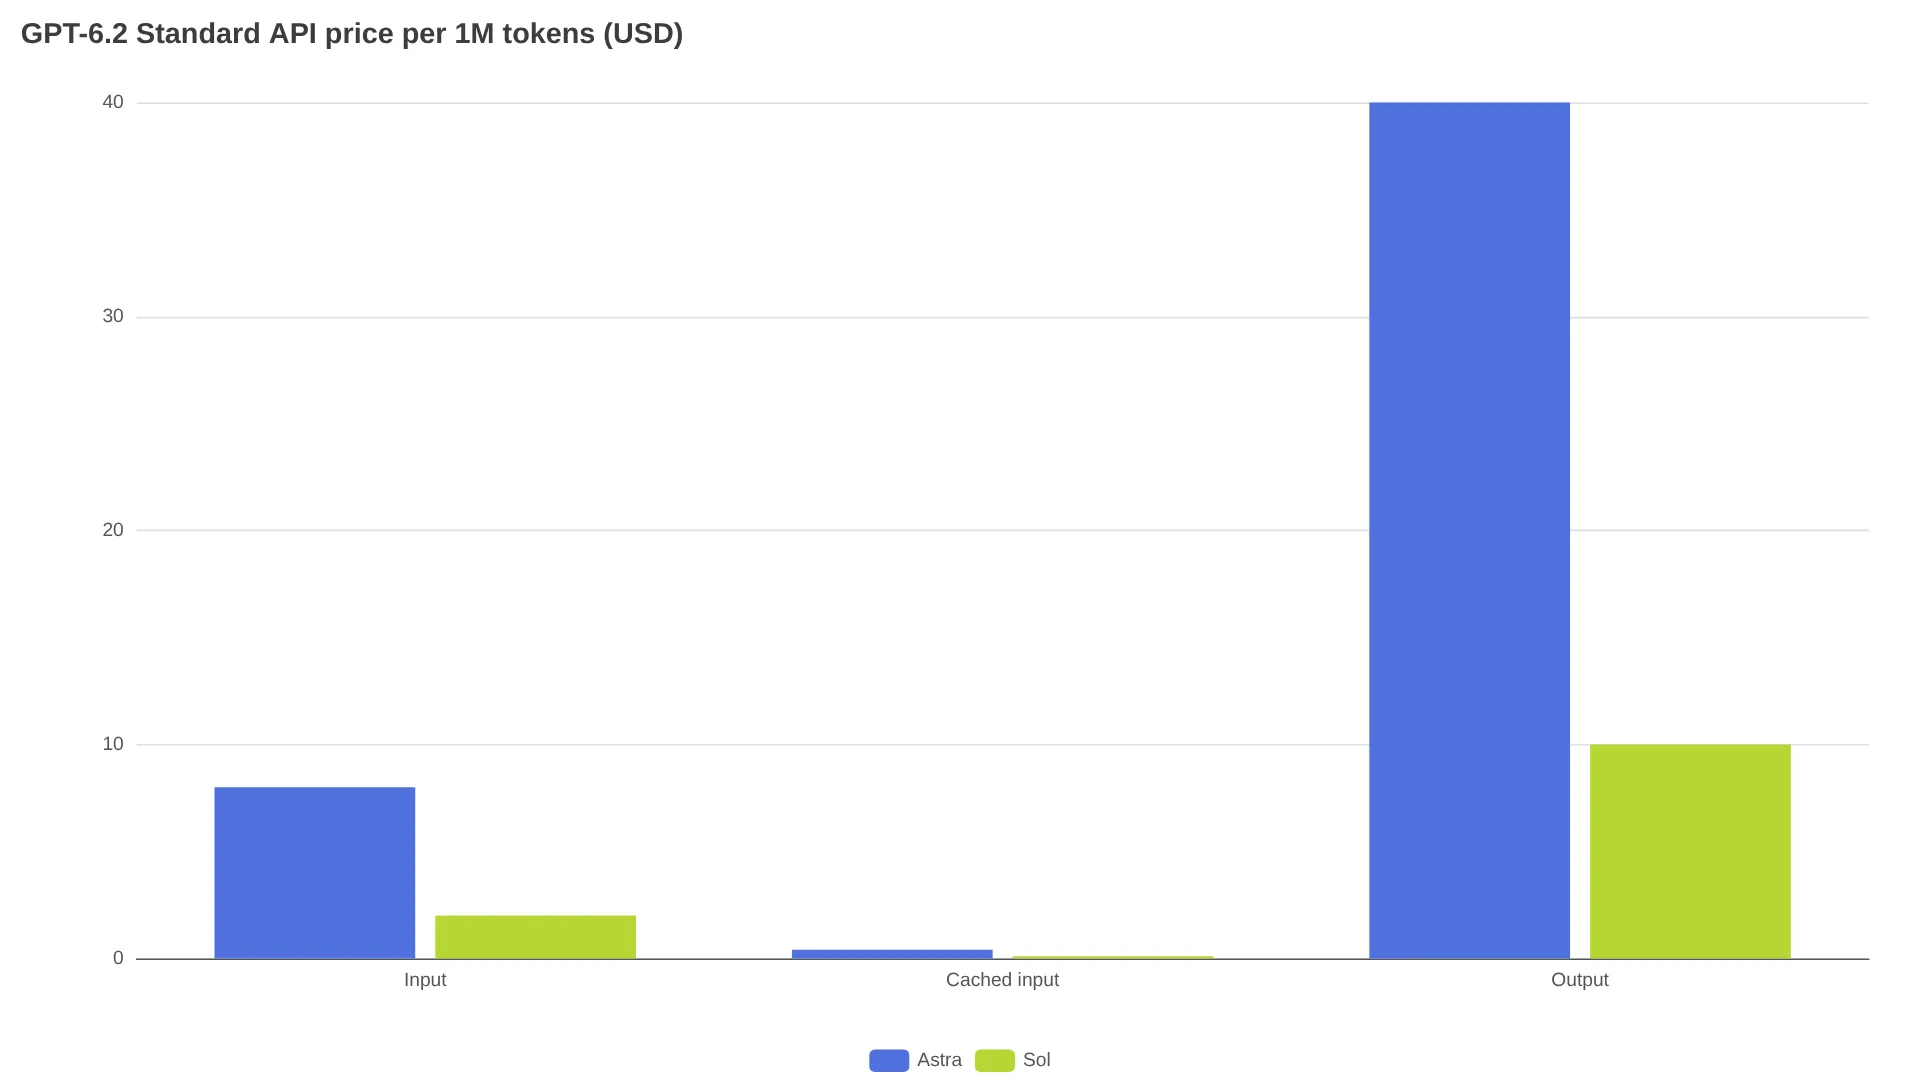
相比 GPT-6 Astra,Astra 的输入和输出价格低 20%,缓存输入价格低 60%;Sol 则沿用 GPT-6.1 Sol 的定价。两款模型于 2026 年 11 月 17 日发布时均已在 API 中全面可用。Batch 比 Standard 便宜 50%,后台处理窗口则比 Standard 低 30—40%(GenAI Brief 价格层级说明)。
真正拉开账单差距的 3 个因素
1. 写入缓存也要收费。读取缓存的价格仅为输入价格的 5%:Astra 为 $0.40,Sol 为 $0.10。根据 GenAI Brief 的费率表,写入缓存并保留 30 分钟的费用是输入价格的 1.25 倍,Astra 为 $10.00、Sol 为 $2.50;保留 12 小时则是输入价格的 2.5 倍。例如,缓存未命中后重新写入 108,000 个历史 token,仅这一项在 Astra 上就要 108,000 × $10/M = $1.08,在 Sol 上为 108,000 × $2.50/M = $0.27,尚未计入输出费用。
2. 输入超过 272,000 token,整次请求都会跳价。输入超过 272K token 后,输入单价翻倍:Astra 从 $8 升至 $16,Sol 从 $2 升至 $4;输出价格则升至 1.5 倍:Astra 从 $40 升至 $60,Sol 从 $10 升至 $15。在 GenAI Brief 的定价测试中,只是额外加入 20K 历史内容并越过这条线,就让 Astra 单轮成本从 $0.344 升至 $0.624:输入仅多了 7%,成本却跳涨 81%。应在达到 272K 之前摘要或截断历史;但如果这样改动了缓存前缀,也要为缓存未命中预留预算。
3. 速度层级会放大所有费用。Fast 的价格是 Standard 的 2 倍。根据 GenAI Brief 的层级规则和 OpenAI 的处理层级文档,Ultrafast 在 2027 年 2 月 28 日前为 Standard 的 3 倍,自 2027 年 3 月 1 日起升至 6 倍;该层级仅支持美国数据驻留,而 Standard/Fast/Batch 支持美国和欧盟。按 3 倍计,Astra 输出价格为 $120/M;按 6 倍计,则为 $240/M。
该看单任务成本,而不是 token 单价
在 token 数量相同的前提下,Astra 的成本是 Sol 的 4 倍。它只有在以下情况下才可能更划算:消耗更少 token、所需尝试次数更少,或能避免昂贵的人工修正。直接 API 成本的盈亏平衡点很明确:在相同 token 规模下,一次 Astra 尝试必须替代超过四次 Sol 尝试;或者将加权 token 用量削减约 75%,才会更有优势。
以下是已报告的任务成本。不同测试采用的基准、推理强度和成本计算方式并不相同,因此适合用来判断方向,正式决策前仍应使用自己的任务回放进行验证:
| 来源 / 工作负载 | Astra | Sol | 说明 |
|---|---|---|---|
| Artificial Analysis Intelligence Index,最高推理强度 | 62,$4.00/任务,10.4 分钟(GPT-6 Astra:57,$6.24) | 57,$1.01/任务,7.9 分钟 | Sol 以约六分之一的 $6.24 单任务成本,达到 GPT-6 Astra 的 57 分 |
| 通过 DataCamp 获取的 FrontierCode 2.0,最高推理强度 | 44.2%,$5.97/任务 | 43.8%,$1.29/任务 | 只差 0.4 分,单任务成本却约为 5 倍;从这组编程证据看,Astra 不够划算 |
| 通过 DataCamp 获取的 Harvey LAB-AA / SecureSWE / Terminal-Bench-Science | 15.0% / 65.7% / 77.1% | 11.1% / 55.6% / 68.0% | Astra 在这些任务上的差距最大;法律、安全代码和科学任务值得测试 Astra |
| 通过 DataCamp 获取的 BenchCAD 2.1 Core | 82.5% | 73.1% | 约 9 分的 CAD 差距,支持在 CAD 工作中测试 Astra |
| DataCamp 幻灯片重建,单次运行测试 | $0.22,4,968 个输出 token | $0.07,字体大小完全准确 | 这个模板化任务没有可见的质量差异,Sol 在成本上胜出 |
| DataCamp 汇总 OpenAI 数据的 Agents' Last Exam,Sol High 对比旧 Astra Max | — | Sol High:72.0%,$0.69/任务;GPT-6 Astra Max:73.1%,$8.99 | 在这一设置下,分数少约 1 分,成本却约为 1/13 |
用一个算对账的例子说明:若 Sol 每次尝试成本为 $0.10,3 次中成功 2 次,那么每个被接受结果的成本是 $0.15。此时,即使 Astra 每次尝试只要 $0.40,也无法仅靠更高成功率取胜。Astra 适合 Sol 成功率明显崩塌的场景,例如 Sol 5 次才成功 1 次,每个被接受结果成本为 $0.50;而 Astra 首次就成功,成本为 $0.40。OpenAI 表示,Astra 在 GDPval v2 上的输出 token 少 22%;这类厂商数据应仅作为方向性参考。
常规编码和高吞吐量 Agent 应先从 Sol 开始;法律、CAD 或长时间科学任务可以测试 Astra。只有在计入重试和人工修正后,total spend / accepted tasks 更低时,才应将流量路由到 Astra。
缓存前缀别乱动,否则就得为重算买单
在对话中途修改指令、工具、Schema 或此前输出,可能导致缓存失效,并触发 GPT-6.2 重新推理。
要尽可能保住前缀缓存命中率,可参考 GenAI Brief 集成说明和 OpenAI 模型文档:
- 不要重写开头消息;改为追加新的 developer message 或
configuration_update。 - 不要在对话中途直接替换工具列表;通过
additional_tools添加工具,或使用tool_choice/allowed_tools进行控制。 - 首次发送前,压缩较早的工具输出,并缩小图像尺寸。
- 在迁移生产流量前,借助 Prompt Cache Diagnostics 和 Responses 的
input_transformations(prefix_mismatch)排查问题。
Astra 与 Sol 的迁移检查清单
以下内容综合 EpiFive 的迁移指南、GenAI Brief 的集成规则,并对照了 OpenAI 模型对比文档:
- 将
model改为gpt-6.2-astra或gpt-6.2-sol。 - 从
reasoning.effort: medium(Responses)或reasoning_effort: medium(Chat Completions)开始。none会被拒绝;短延迟调用请使用low。 - 从请求中删除
temperature、top_p以及logprobs/top_logprobs。工具调用应迁移至 Responses API。 - 如果从 GPT-5.5 或更早版本迁移,用
prompt_cache_options.ttl: "30m"替换prompt_cache_retention,并将缓存写入费用纳入预算。 - 启用 Zero Data Retention 时,
store会被视为false;需要按顺序重新发送此前的输出项,包括加密的推理项。 - 每个模型回放 30 个短任务,记录通过率、重试次数、输出 token 和每个被接受结果的成本;另外测试一次前缀稳定的长 Agent 会话,以及一次修改前缀后的会话,记录缓存命中率和总任务成本。