当 Agent 接入数百个工具时,真正拖高上下文成本的往往不是工具数量,而是每个工具冗长的参数 Schema。Gemini API 的 Tool Retrieval 让模型保留全部工具的名称,却只在任务需要时再读取完整参数定义。不过这并非无条件省钱:每次检索都会多触发一次模型处理,若几乎每轮都要搜索,成本可能不降反升。
Google 于 2026 年 11 月 19 日宣布该功能进入预览阶段,目前仅可通过 Interactions API 使用。它新增了 tool_search 工具,以及 defer_loading: true 标记。被延迟加载的工具仍会把名称和描述放进上下文,但参数 JSON 不会预先占位。此功能没有单独收费,仍按标准输入、缓存输入和输出费率计费。
200 个工具为何还没调用就要吃掉 164,000 Token
决定提示词成本的并不只是工具总数,而是 Schema 的体积;工具目录足够大时,Schema 很容易反客为主,成为上下文的主要负担。
一篇对 Google 文档的独立技术拆解给出了直观示例:200 个工具的库中,每次请求只实际调用少数工具时,不延迟加载约为 164,000 输入 Token,启用 Tool Retrieval 后约为 23,650 Token。这只是该分析采用的整数化示意,并非基准测试;核心变化在于,不再为从未用到的 Schema 持续付费。
另一个问题是选择准确性。数十个相似 Schema 同时摆在上下文里,模型也就多了更多选错工具的机会。Google 将 Tool Retrieval 定位为同时降低 Token 负担、提升工具选择准确性的方案。不过官方没有公布准确率数据,因此后者更适合作为需要在自身任务上验证的假设。
Gemini Tool Retrieval 怎么跑:tool_search 与 defer_loading
配置本身很简洁:加入一项 tool_search 声明 {"type": "tool_search"},并在每个需要延迟加载的工具上设置 "defer_loading": true;完整请求结构可见文档拆解。模型依然能看到每个延迟工具的名称和描述。根据这篇 defer_loading 说明,若设置了 short_description,模型看到的就是它;否则会使用完整描述的第一句。
服务端模式的流程全部发生在一次请求内:
- 模型输出
tool_search_call,例如请求issue_refund。 - API 返回带有完整 Schema 的
tool_search_result。 - 模型随后输出真正的
function_call(Google 的退款示例使用order_id: "A-1042"、amount: 40,模型为gemini-4-hydrogen)。 - 你的代码执行该工具,并返回
function_result。
应完整记录 interaction.steps。如果加载了错误的工具,优先检查追踪记录里的名称或描述是否过于模糊。
服务端还是客户端:一次请求完成,还是多一次往返
| 模式 | 谁来搜索 | 需要构建的索引 | 额外往返次数 | 适用场景 |
|---|---|---|---|---|
| 服务端(默认) | Gemini | 无需构建——“无需自行构建或托管索引。” | 无,仍在同一请求中完成 | 大型、基本静态的工具库;整个 MCP 服务器 |
客户端("execution": "client") | 你的应用 | 自建注册表或 Embedding 索引 | 每次搜索一次 | 按用户授权、私有注册表、对话中途新增的工具 |
服务端检索不需要托管索引,并会在同一响应中完成;根据文档拆解,在 mcp_server 工具上设置 defer_loading: true,会延迟该服务器暴露的全部工具。
客户端模式下,使用带有 "execution": "client" 的 tool_search(示例名称为 search_tools,并要求一个必填的 query 字符串)。你的应用通过 function_result 返回匹配项,接着调用 client.interactions.create,并携带 previous_interaction_id。同一份拆解指出,每个请求只能有一个 tool_search,且两种模式不能混用。
若授权规则因用户而异,或集成会在对话中途出现,应选择客户端模式:据引用分析,服务端针对共享目录的一次搜索,本身不会执行按用户维度的权限过滤。该拆解还指出,客户端模式也支持在无需预先声明所有工具的情况下,于对话中途引入工具。
Gemini Tool Retrieval 的计费:先付 26 Token,之后再跑一次完整模型处理
正如 Google 在公告中所说:“Tool Retrieval has no separate charge.” 它不单独收费;但根据这篇Token 经济性拆解,仍有四项会被计量的成本:
tool_search会为每次请求增加一小段固定的输入 Token。- 引用分析估算,每条延迟工具的名称与描述约占 26 Token。
- 每一次服务端搜索都会基于当前上下文再运行一次模型处理;按该分析,它会通过
total_tool_use_tokens计费,成本大致等于提示词输入量扣除缓存命中部分。 - 一旦加载,Schema 会在后续整段对话中持续作为输入计费,且无法卸载。
| 工作负载(引用分析中的示意估算) | 不使用检索 | 使用检索 | 结论 |
|---|---|---|---|
| 200 个工具,每个任务只用少数工具 | ~164,000 Token | ~23,650 Token | 节省 |
| 10 个工具、30k 上下文、几乎每轮都搜索 | ~68,000 Token | ~92,830 Token | 成本更高 |
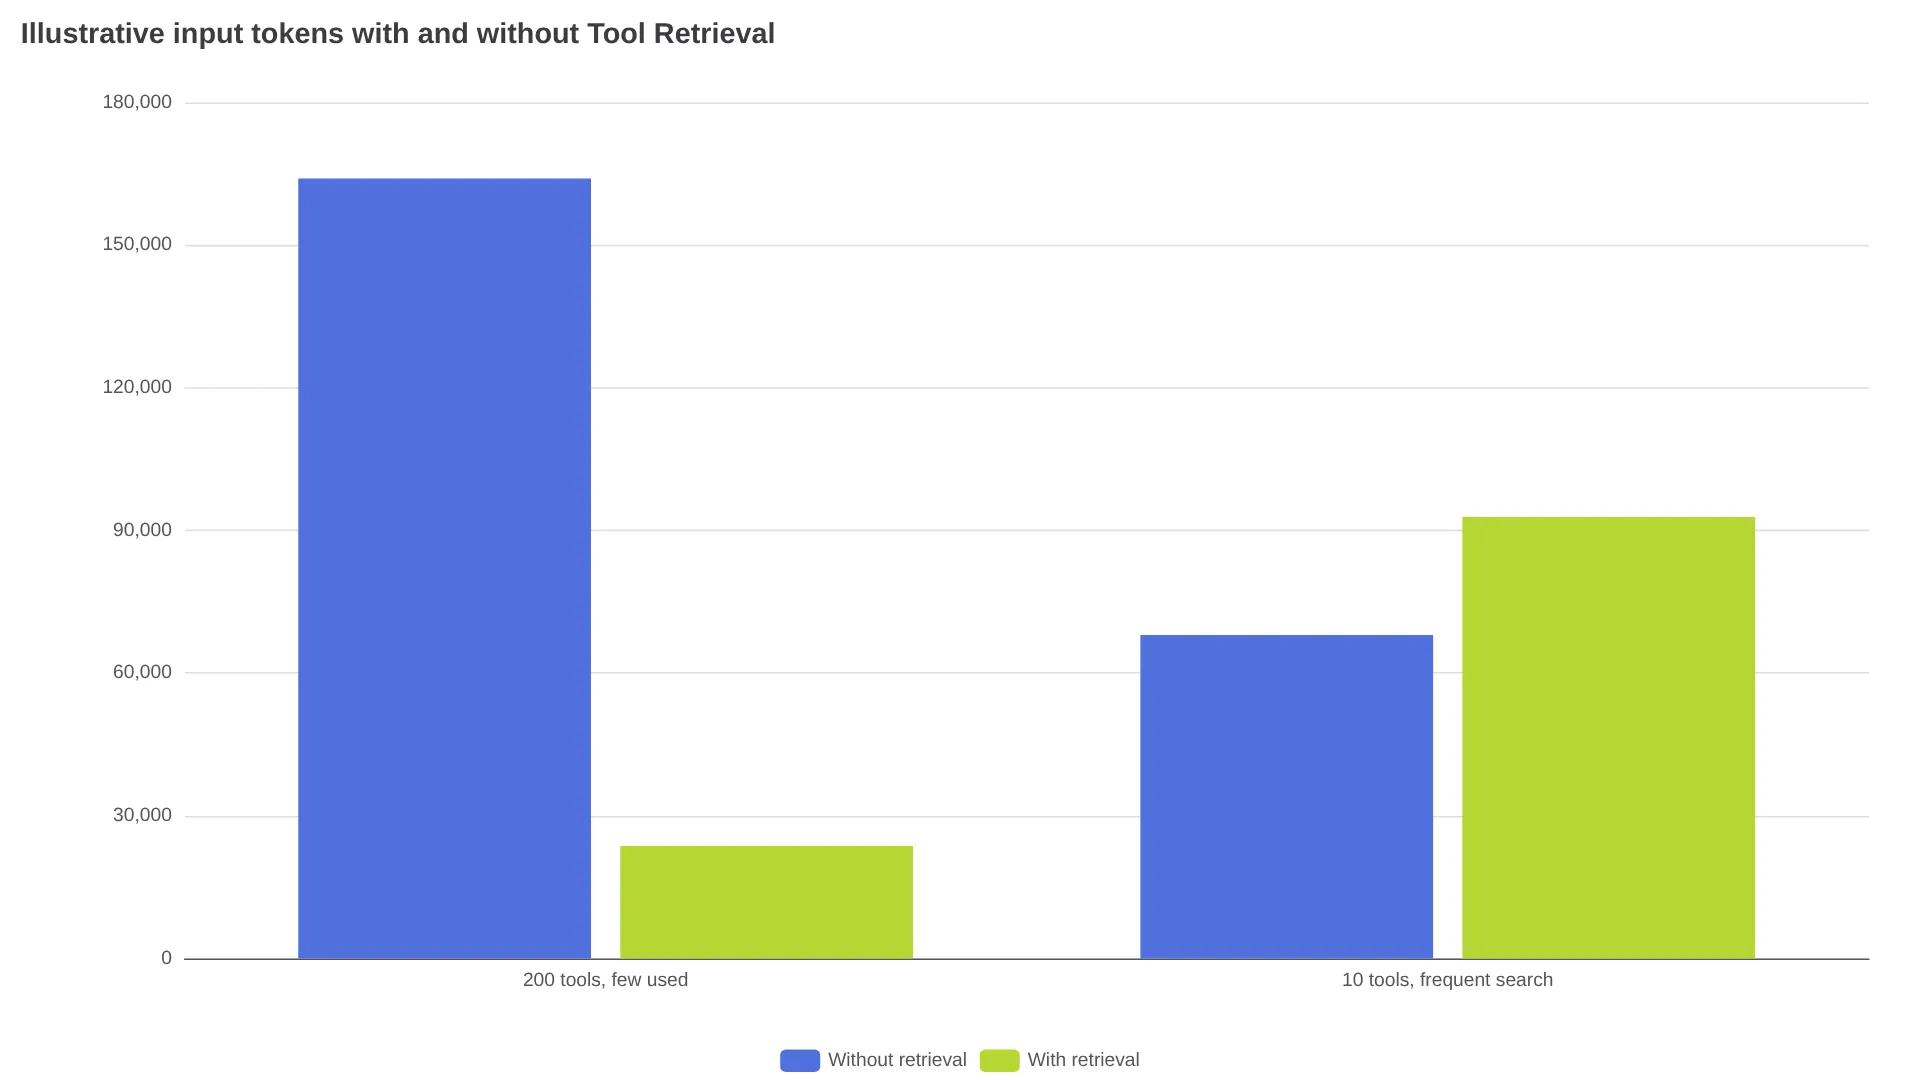
Google 在同一份公告中的建议很直接:“Measure it against your own traffic.”——应当用自己的真实流量来衡量。
“在服务端模式下……每次服务端搜索都会基于当前上下文额外运行一次模型处理……因此,大型工具库且每个任务只用少数工具时可能获益;工具库较小、对话很长且频繁搜索时,成本则可能更高。”——@tekroch
延迟加载可能让缓存前缀更稳定,但也可能使提示词低于缓存大小阈值;根据引用分析,除输入 Token 外,还应一并跟踪缓存命中率。
什么时候该延迟加载,什么时候该始终加载
工具库较小时,先基准测试静态加载;搜索频率和 Schema 大小比工具数量阈值更重要。对于大型目录、每个任务只用 1–3 个工具的场景,可在服务端延迟加载长尾工具,同时不延迟那些多数请求都会用到的高频工具。工具按用户授权,或会在聊天中途加入时,则应使用客户端模式,并为每次查询预留一次往返。
引用的实现说明列出了三个需要提前规避的故障点:
- 不要延迟加载系统指令或其他工具输出中点名提及的工具;模型可能未经搜索直接调用它,导致下一轮失败。
- 延迟函数在请求中仍必须提供完整的
parameters;只给名称和描述,可能返回空 Schema,无法调用。 - 无状态应用中,每一轮都要原样回传
tool_search_call、tool_search_result、签名以及完整的tools数组。
描述质量直接决定检索效果:模型在看到 Schema 前,只能依据名称和描述做选择。“按日期范围查询客户发票”容易被检索到;“发票助手”则容易和其他工具混淆。延迟加载不是安全边界——根据这篇安全性分析,延迟 MCP 工具的名称与描述依然会作为提示词输入可见,而已加载工具会以你授予的权限运行。
预览版目前还不具备什么
该功能仍处于预览阶段,仅限 Interactions API 的 v1beta 接口。不支持 generateContent;根据文档拆解,在不支持的模型上设置 defer_loading 会返回 HTTP 400。
当前支持的模型范围也比宣传标题更窄:公告称支持 Gemini 3.6 及以后版本,包括全部 Gemini 4 模型;但引用拆解称,在线文档目前列出的模型是 gemini-4-hydrogen、gemini-4-argon、gemini-3.8-flash 和 gemini-3.6-flash。不要想当然地认为同系列模型都可用,先在文档中确认你的具体模型。目前尚未公布 GA 日期。根据发布报道,Anthropic 已在 2025 年 11 月以 beta 形式推出相同的 defer_loading 思路;Google 的差异在于服务端 MCP 延迟加载和客户端模式。
| 你的工具库形态 | 建议模式 | 第一步 |
|---|---|---|
| 小型且稳定 | 静态加载 | 增加复杂性前,先测量 Schema Token |
| 50–200 个工具,每个任务只用少数工具 | 服务端延迟加载 | 延迟长尾工具,高频工具保持加载 |
| 按用户授权或聊天中途新增的工具 | 客户端检索 | 构建支持权限感知的搜索 |
| 每轮都会使用所有工具 | 静态加载 | 搜索开销很可能超过节省的成本 |
先只上线一部分长尾工具,再在完全相同的任务上,对比启用和不启用延迟加载时的输入 Token、total_tool_use_tokens、延迟和任务成功率。
常见问题
Tool Retrieval 支持 generateContent 吗?
不支持。它仅适用于 v1beta 上的 Interactions API。
哪些模型支持它?
公告称 Gemini 3.6 及以后版本、包括 Gemini 4 均支持;但引用拆解表示,在线文档当前将范围收窄到包括 gemini-4-hydrogen 和 gemini-3.6-flash 在内的模型。请针对你的具体模型查阅文档。
它会让我账单变高吗?
会。引用的示意工作负载中,10 个工具且几乎每轮都搜索时,Token 从 ~68,000 上升至 ~92,830。